各位朋友大家好,我是一言,继续更新 Spring AI 2.0 系列。
上一篇写的是 Structured Output,模型结果可以直接进入 Java 业务代码。这一篇接着解决一个很实际的问题:项目里的工具越来越多了,应该怎么办?
我给电商助手注册了 12 个工具:查订单、取消订单、申请退款、查库存、开发票、查优惠券、查积分......
用户只问了一个问题:
帮我查订单 A1024 的物流状态。
默认情况下,第一轮模型请求会带上全部 12 个工具:
text
[default] tools=[
  applyRefund, cancelOrder, createInvoice, queryCoupon,
  queryInventory, queryInvoice, queryLogistics,
  queryMemberPoints, queryOrder, queryProduct,
  queryRefund, reserveInventory
]
实际执行时,模型会挑选需要的工具。第一轮请求里,它会先看到这 12 个工具的定义。每份定义都包含工具名称、用途说明和输入参数的 JSON Schema。
拿 queryOrder 来说,实际生成的定义拆开以后是这样的:
json
{
  "name": "queryOrder",
  "description": "Query order shipping status, carrier and tracking number by order id",
  "inputSchema": {
    "type": "object",
    "properties": {
      "orderId": {
        "type": "string",
        "description": "Order id, for example A1024"
      }
    },
    "required": ["orderId"],
    "additionalProperties": false
  }
}
一个工具已经有这么多内容了。12 个工具全部放进去,模型收到的远远超过 12 个方法名。
工具少的时候问题不大。接入几个 MCP Server 以后,几十个工具一起进入请求,输入 Token 会增加,模型选工具也会更费劲。
Spring AI 2.0.1 官方文档给了一个更大的场景:多个服务聚合以后,很容易出现 50 多个工具,工具定义可能占用 55,000 多个 Token。面对 30 多个名称相近的工具时,模型选择的准确率也会下降。
Spring AI 2.0 给出的解决方案叫 Tool Search:先找工具,再把找到的工具交给模型。
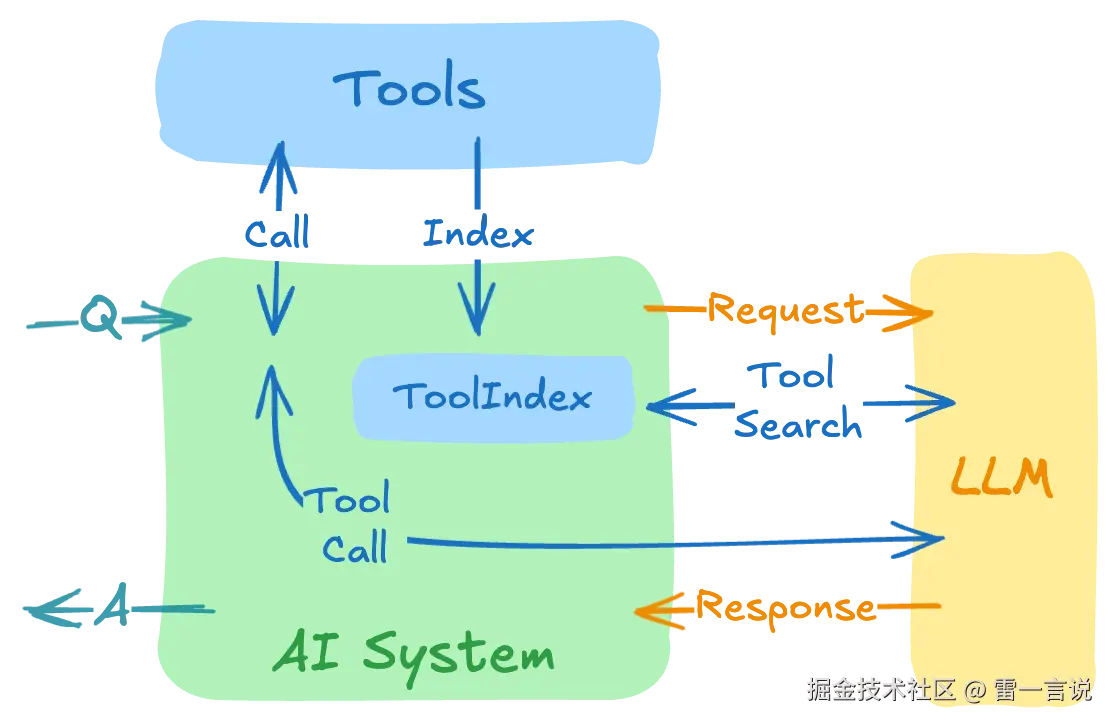
下面使用 Java 21、Spring Boot 4.0.8 和 Spring AI 2.0.1 跑一遍。
Tool Search 做了什么
用了 Tool Search 以后,我又拿同一个问题试了一次:
text
[tool-search] round #1 tools=[toolSearchTool]
[tool-search] round #2 tools=[queryOrder, toolSearchTool]
[tool-search] search result=["queryOrder"]
[tool] queryOrder(A1024)
[tool-search] round #3 tools=[queryOrder, toolSearchTool]
[tool-search] order result="Order A1024 is SHIPPED via SF Express, tracking number SF1234567890"
[answer] 订单 A1024 已发货,承运商是顺丰,运单号 SF1234567890。
我再把每一轮工具定义中 name、description 和 inputSchema 的字符数统计出来:
| 模型请求 | 携带的工具 | 定义字符数 |
|---|---|---|
| 默认方式第 1 轮 | 12 个业务工具 | 3783 |
| Tool Search 第 1 轮 | toolSearchTool |
1055 |
| Tool Search 第 2 轮 | toolSearchTool、queryOrder |
1407 |
这里统计的是字符数,不能直接换算成模型 Token。它能说明一个问题:当前查询用不到的退款、库存和发票等工具定义,已经从模型请求中移走了。
Spring 官方也做过一组 28 个工具的初步手工测试。Lucene 方案的总 Token 用量下降了 34%---64%,节省主要来自 Prompt Token。测试只跑了少量轮次,这组数字用来观察方向更合适。
第一轮只有一个内置工具 toolSearchTool。模型先查找"查询订单物流状态"需要什么能力,索引返回 queryOrder。下一轮请求才会加入 queryOrder 的完整定义,接着执行 Java 方法并生成答案。
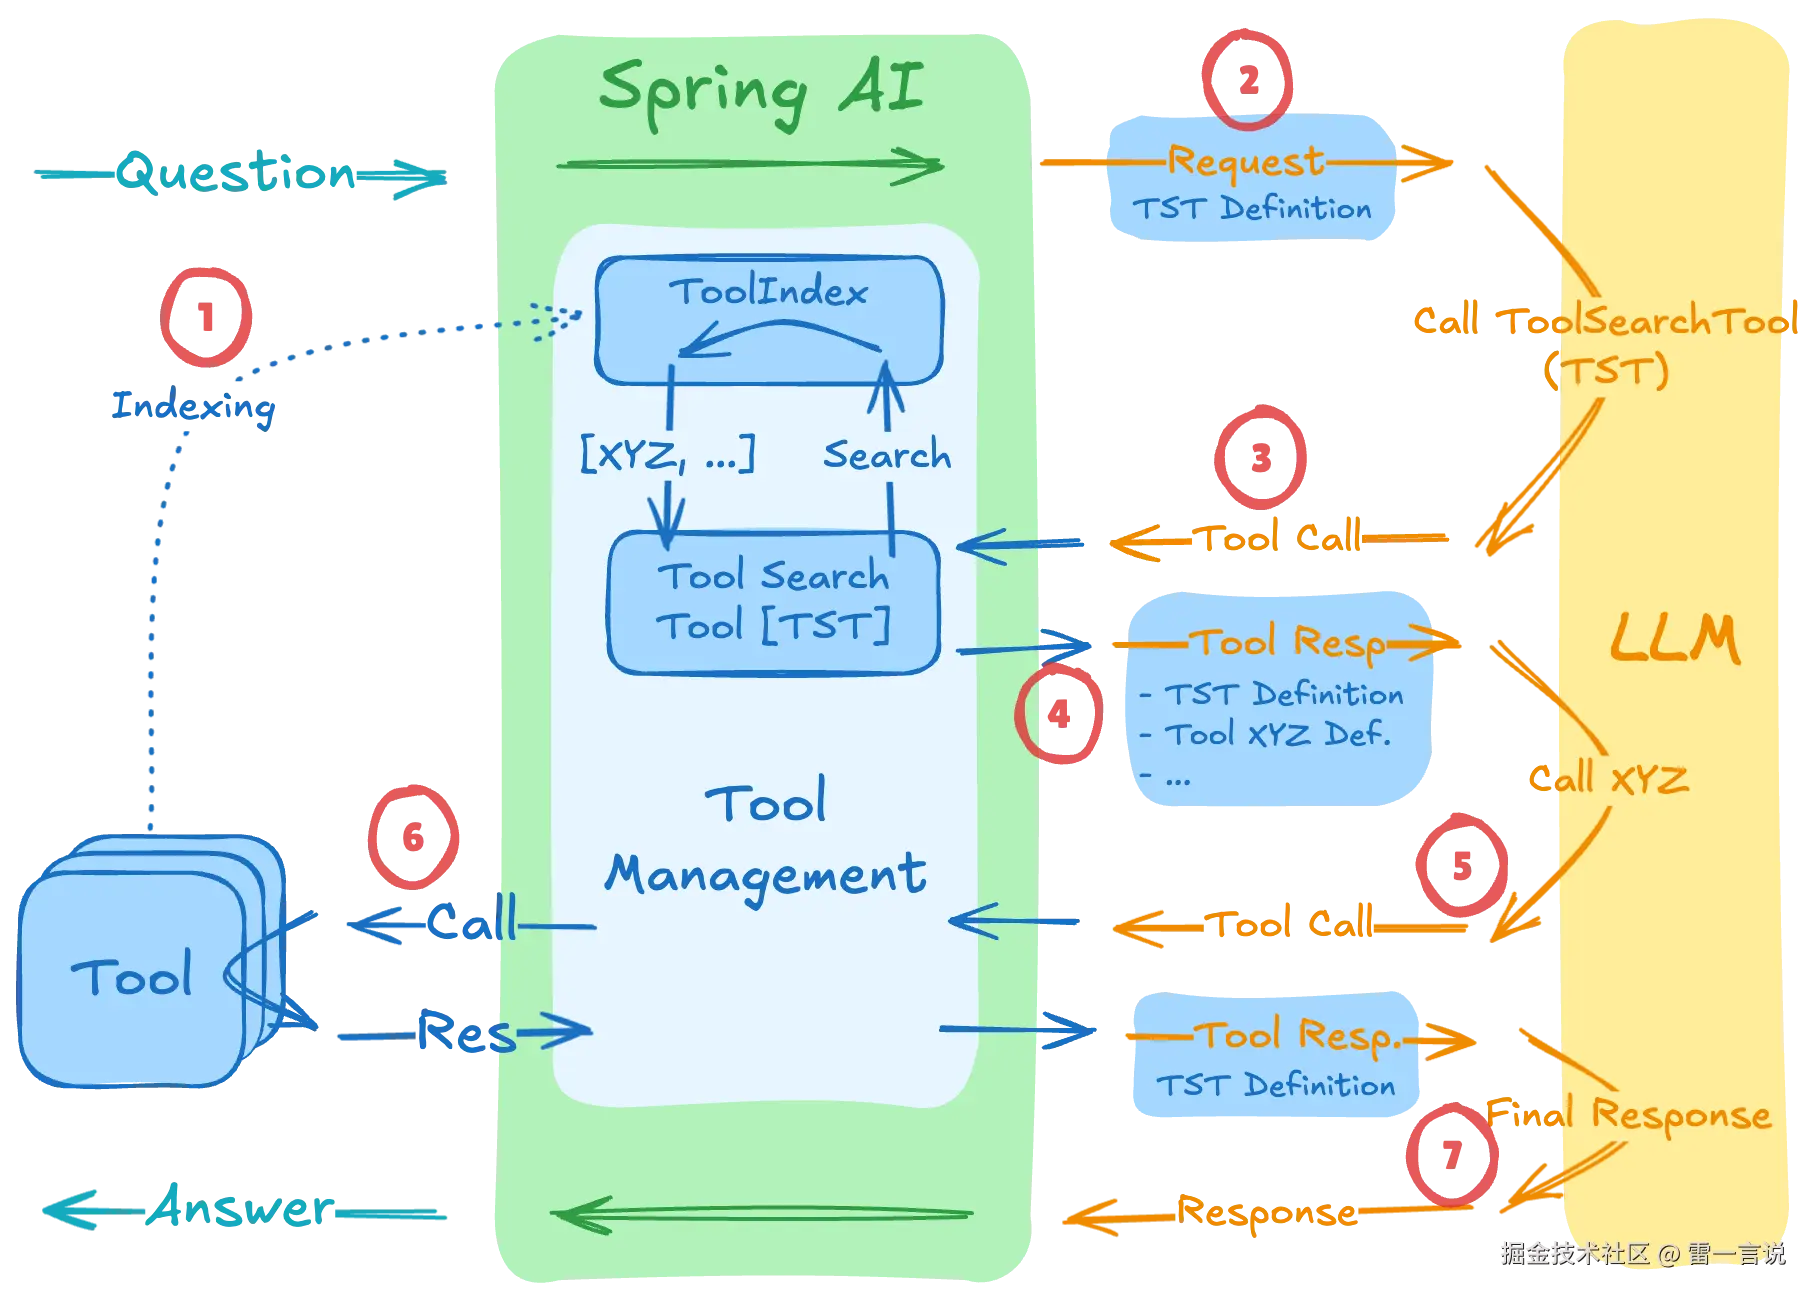
可以把这套机制概括成一句话:
工具留在索引里,相关定义再进模型请求。
先把 Starter 加进来
Spring AI 2.0.1 可以直接使用自动配置:
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-tool-search-advisor</artifactId>
</dependency>
这次先用 Lucene 做关键词检索:
properties
spring.ai.chat.client.tool-search-advisor.enabled=true
spring.ai.chat.client.tool-search-advisor.tool-index-type=lucene
enabled=true 会启用 ToolSearchToolCallingAdvisor,并替换默认的 Tool Calling advisor。原来的工具注册方式不用修改:
java
@Component
public class CommerceTools {

    @Tool(name = "queryOrder",
            description = "Query order shipping status, carrier and tracking number by order id")
    public String queryOrder(
            @ToolParam(description = "Order id, for example A1024") String orderId) {
        return "Order %s is SHIPPED via SF Express, tracking number SF1234567890"
                .formatted(orderId);
    }

    // cancelOrder、applyRefund、queryInventory ...
}
继续用 defaultTools() 注册:
java
@Bean
ChatClient chatClient(ChatClient.Builder builder, CommerceTools tools) {
    return builder
            .defaultTools(tools)
            .build();
}
sessionId 这一行不能少
调用的时候,要给 advisor 一个会话 ID:
java
String answer = chatClient.prompt()
        .user("帮我查订单 A1024 的物流状态")
        .advisors(a -> a.param(
                ChatMemory.CONVERSATION_ID,
                "order-session-1"))
        .call()
        .content();
Tool Search 会根据会话创建工具索引,并记录本轮已经找到的工具。默认的会话键就是 ChatMemory.CONVERSATION_ID。
我把这一行删掉以后,2.0.1 会直接抛出 IllegalArgumentException。即使没有接 Chat Memory,也要传一个稳定的业务会话 ID,比如当前对话 ID 或请求链路 ID。
工具搜不到,先改 description
这篇使用 Lucene 检索工具名称和描述。搜索结果准不准,和 @Tool 怎么写有直接关系。
这样的描述没有多少区分度:
java
@Tool(description = "处理订单")
public String queryOrder(String orderId) { ... }
换成具体的动作、对象和参数:
java
@Tool(description = "Query order shipping status, carrier and tracking number by order id")
public String queryOrder(String orderId) { ... }
我做了一组 Lucene 对照。工具名和搜索词保持一致,只修改 description:
text
search query: query order shipping status
description: Process business request
result: []

description: Query order shipping status, carrier and tracking number by order id
result: [queryOrder]
模糊描述没有达到 Lucene 的命中阈值,具体描述返回了 queryOrder。
工具多了以后,下面这样的命名很容易添乱:
text
handle
process
execute
我会把工具说明写得像接口说明,至少说清三件事:
- 做什么动作;
- 操作什么对象;
- 需要什么关键参数。
比如 queryOrder 负责订单和发货状态,queryLogistics 负责运单轨迹。两段描述要把这层边界写出来,搜索结果才容易区分。
三种索引,我会这样选
Spring AI 2.0.1 提供了三种索引:
regex:默认方案,按照工具名模式匹配,适合命名规则非常统一的工具;lucene:关键词检索,无需 Embedding 模型,普通业务项目可以从这里开始;vector:语义检索,需要VectorStore,适合用户说法和工具描述差异较大的场景。
这篇选择 Lucene,原因很简单:依赖少,搜索结果也容易排查。先把工具名称和描述写清楚,通常比一开始就接向量库更重要。
最后再记一句:工具留在索引里,相关定义再进模型请求。
下一篇继续写 Chat Memory:多轮对话里,Spring AI 到底替我们记了什么。