重新理解 RankMixer:扩参为什么有效,又为什么划算?
RankMixer 的优势在于,扩大模型后能够继续提高推荐精度,同时将新增计算的资源成本控制在可接受的范围内。 它的结构使更多参数能够带来效果收益;参数扩展增加了计算需求,更大的计算任务与相应的执行设计又让 GPU 算力得到更充分利用。论文的扩展实验与生产部署展示了这两方面的改善。RankMixer,第 4.3、4.6 节
我们的目标是提高预测精度,模型扩展是实现这一目标的手段。理解 MFU 的提升,需要先回答:旧模型为什么难以通过扩参继续提高效果,RankMixer 为什么能够做到,以及新增计算需要付出多少资源成本。
1. 旧模型扩展的两道障碍
第一道障碍是扩参的效果收益有限。 增加参数并不保证学到更有效的特征交互。如果结构不适合推荐数据,扩参后的效果可能提升有限,甚至下降。
第二道障碍是扩参的资源代价过高。 有些扩展确实改善了预测,但在既定请求量和延迟要求下,需要增加过多机器资源,收益不足以覆盖成本。参数量和 FLOPs 相近的模型,也可能因数据搬运、矩阵形状与执行组织不同,产生不同的实际成本。
因此,值得采用的扩展方案需要同时满足两个条件:新增参数能够改善推荐效果,新增计算能够以可接受的成本完成。RankMixer 的结构设计与硬件执行应围绕这两个问题分析。
2. RankMixer 为什么能从更多参数中获益
2.1 独立建模与跨特征交互
推荐模型同时处理用户、物品、统计和行为序列等异质特征。RankMixer 作者认为,将不同特征空间集中到同一交互模块中,可能让高频或强信号主导学习,削弱其他特征的作用。其设计将特征子空间的独立建模与跨子空间交互结合起来:
- 语义特征分组:将相关 embedding 组织为数量适当、宽度对齐的 token,避免逐特征切分造成大量过小的计算。
- 独立 per-token FFN:为各 token 分配独立参数,增加容量,让不同 token 可以学习不同的变换。
- 多头 token mixing:将每个 token 分块,再跨 token 重组,使后续 FFN 接收到来自多个原 token 的信息。
token mixing 本身是无参数重组,主要学习计算位于 FFN。多层交替执行,使各 token 的独立变换能够结合跨特征信息。这是理解其扩展能力的结构线索,是否有效则由扩展实验和消融检验。RankMixer,第 3.2---3.3 节
2.2 扩展曲线验证新增容量的价值
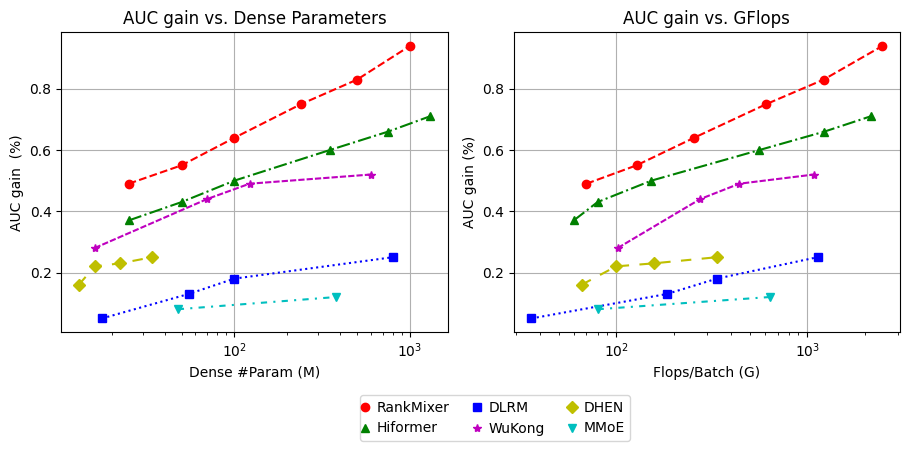
图 1:原论文图 2。左图比较参数量与 Finish AUC 增幅,右图比较训练 FLOPs 与增幅。横轴为对数坐标,参数统计不包含稀疏 embedding。
这两张图分别回答:模型能否从更多参数中获益,以及这些收益需要多少模型计算。论文在测试范围内观察到,RankMixer 的效果随参数和计算量增加继续提升。RankMixer,第 4.3 节
原论文表 1 中的部分结果也能说明结构差异:
| 离线模型 | 参数量 | 训练 FLOPs/Batch | Finish AUC 增幅 | Skip AUC 增幅 |
|---|---|---|---|---|
| DLRM-MLP-100M | 95M | 185G | +0.15% | +0.15% |
| RankMixer-100M | 107M | 233G | +0.64% | +0.86% |
| RankMixer-1B | 1.1B | 2.1T | +0.95% | +1.25% |
注:AUC 增幅均相对于 DLRM-MLP-8.7M,沿用原文百分比口径;FLOPs 对应 batch=512 的训练计算,非单请求推理量。RankMixer,第 4.1.2、4.2 节及表 1
在相近的一亿参数规模下,直接扩大 MLP 的效果收益较小,RankMixer 获得了更大的提升;继续扩展到约十一亿参数后,RankMixer 的预测指标进一步改善。它展示了一条能够从更大容量中获得收益的扩展路径。
结构消融提供了补充证据:移除 token mixing 或将独立 FFN 改为共享 FFN,都会使 AUC 下降。其中,共享 FFN 的改动也涉及容量变化,不能将下降全部归因于参数隔离。RankMixer,第 4.4 节及表 2---3
这些证据首先说明扩参具有建模价值。 至于能否承受扩参后的执行成本,还需要结合实际硬件利用率分析。
3. 更多计算为什么能提高 MFU
3.1 计算量增长可以快于耗时增长
旧模型 MFU 低,表明单位硬件时间内完成的模型计算较少。某些执行阶段可能主要消耗在数据供给或调度上,计算单元没有充分工作。扩大模型后,如果新增计算能够利用这部分算力,执行时间就不必随 FLOPs 等比例增加,MFU 也会提高。
设约定执行范围内的模型运算量为 \(F\),实际耗时为 \(t\),同型号 GPU 数为 \(G\),对应精度的单卡峰值算力为 \(P_{\mathrm{peak}}\)。总峰值算力为 \(P_{\Sigma}=GP_{\mathrm{peak}}\),则:
\\\mathrm{MFU}=\\frac{F}{tP_{\\Sigma}}. \\
比较扩展前后:
\\\frac{\\mathrm{MFU}_{\\mathrm{new}}}{\\mathrm{MFU}_{\\mathrm{old}}} = \\frac{F_{\\mathrm{new}}/F_{\\mathrm{old}}} {(t_{\\mathrm{new}}/t_{\\mathrm{old}}) (P_{\\Sigma,\\mathrm{new}}/P_{\\Sigma,\\mathrm{old}})}. \\
固定硬件和精度时,计算量增长快于耗时,MFU 就提高。若通过增加机器或改变精度承载更大模型,还要将总峰值算力的变化计入分母。
因此,扩参后的 MFU 提升要看新增计算相对于耗时和资源投入增长了多少。低 MFU 提示存在利用不足,但能否承载更多计算,要结合具体的供数和执行条件判断。训练与推理的运算计数、计时范围应分别保持一致;下文生产表沿用论文的 MFU 口径。
3.2 FFN 扩宽与批量执行
参数扩展会同时改变工作量和矩阵形状。RankMixer 的主要稠密计算位于 FFN,增加宽度可以形成更大的矩阵计算任务;合适的 batch 和形状有助于数据复用、分块与并行执行。
设输入为 \(B\) 个样本、每样本 \(T\) 个 token,token 宽度为 \(d\),FFN 隐藏宽度为 \(h\)。独立 FFN 的一次投影可以组织为:
\\[T,B,d\ @\ T,d,h\ \longrightarrow\ T,B,h. \]
这里有 \(T\) 组使用不同权重的矩阵乘法。批量或融合执行可以统一安排这些工作,减少逐 token 的零碎调用。单组矩阵是否足够高效,仍取决于 batch、宽度和底层实现;只增加 token 组数,不保证提高每组计算的数据复用程度。
论文第 4.6 节将大 GEMM、并行 per-token FFN 的融合,以及读写和调度开销的减少,作为其部署效率的解释。它们帮助更大的模型计算在硬件上高效完成。RankMixer,第 4.6 节
3.3 扩大模型后的计算、访存与存储成本
扩大模型会同时增加运算、数据读写和存储需求。判断新增计算的资源成本,需要分别分析这三类需求:
| 需求 | 扩大 RankMixer 后需要检查的变化 |
|---|---|
| 计算量 \(F\) | 实际执行的 FFN 运算怎样增加,矩阵形状是否更适合硬件 |
| 搬运量 \(D\) | 权重、激活、token 重排和中间结果的读写怎样增长 |
| 存储需求 \(S\) | 参数和激活是否限制 batch、分块与并行度 |
其中,\(D\) 是所考察存储层级的读写字节数,\(S\) 是执行时在该层级需要同时保存的数据量。算术强度 \(I=F/D\) 描述每搬运一字节对应多少计算。如果计算量比搬运量增长得快,算术强度就会提高;数据复用、融合和低精度也可能减少搬运成本。实际性能还取决于任务规模和执行组织。
模型变大也可能显著增加权重读取和激活存储。例如,权重读取占主导的小 batch 场景,扩宽可能使计算与读取近似同比增长。因此,需要从实际执行确认搬运成本,不能预先认定它只增加一点。
如果现有资源无法满足延迟要求,可以评估扩容及其成本。增加副本主要分摊请求、减少排队;模型分片可能帮助容纳或加速单次执行,但会引入通信。新增资源应与效果收益一起评价,MFU 也要按扩容后的总峰值重新计算。
4. 论文怎样体现效果与成本的改善
论文生产对照的旧模型为 OnlineBase-16M,由 DLRM 与 DCN 组合而成;新模型为 RankMixer-1B。参数量采用论文的 Dense-Param 口径,不包含稀疏 embedding。
| 生产部署指标 | OnlineBase-16M | RankMixer-1B |
|---|---|---|
| 参数量 | 15.8M | 1.1B |
| FLOPs | 107G | 2106G |
| MFU | 4.47% | 44.57% |
| 精度 | FP32 | FP16 |
| 延迟 | 14.5 ms | 14.3 ms |
注:FLOPs 保留原论文表 6 的统计口径,不换算成单样本或单请求量。RankMixer,第 4.6 节及表 6
这组结果中,参数量增加约 70 倍,计算量增加约 20 倍,MFU 提高约 10 倍。论文还将 FP32 改为 FP16,并按其硬件口径计入约 2 倍峰值算力。更高的利用率与峰值算力共同承载了新增计算,延迟基本保持。这里的精度收益取决于具体硬件与计算路径。
参数量与每次计算量之间的关系同样重要。表中参数增长快于 FLOPs 增长;论文还讨论了 Sparse-MoE,通过选择性激活专家来扩大容量、控制计算。总参数量不能直接等同于每次全部激活的参数量。RankMixer,第 3.4---3.5、4.6 节
这是一组同时改变结构、规模、实现与精度的整体部署对照,无法单独量化每项改动的贡献。作者报告对应系统未增加服务成本;结合线上 A/B 实验,抖音主站活跃天数约提升 0.29%,使用时长约提升 1.08%。这些结果将模型扩展与实际业务收益联系起来。RankMixer,摘要及第 4.7 节
迁移到自己的系统时,应在既定请求压力和延迟要求下,比较扩展前后的预测效果与资源成本。效果---参数曲线判断结构能否从更大容量中获益,效果---FLOPs 曲线判断新增模型计算是否有效,实际部署则回答这些效果收益是否值得付出相应资源。
附录:传统算子与执行实验
A. 传统交互模块的执行特征
以下对照用于理解执行条件。令输入宽度为 \(n\),低秩维度为 \(r\):
| 模块 | 主要工作 | 执行特点 |
|---|---|---|
| 原始 DCN | \(B,n@n,1\),再做逐元素乘加 | 窄投影的运算量小,逐元素处理的复用较少 |
| DCNv2,全矩阵 | \(B,n@n,n\),再做逐元素乘加 | 可以形成宽 GEMM,效率取决于 batch、形状与实现 |
| DCNv2,低秩 | \(n\to r\to n\) 两次投影 | 减少运算量,但窄维度与中间读写可能影响耗时 |
| DeepFM | FM 的归约、逐元素运算与 DNN | FM 与 DNN 的运算特征不同,需看各阶段时间占比 |
| RankMixer | token 重组与独立 FFN | 主要稠密工作位于 FFN,批量和融合组织影响效率 |
全矩阵 DCNv2 同样可以高效执行;模型是否值得扩展,还要看增加参数后的效果收益。DCN、DCNv2、DeepFM
B. 交互主干的执行对照
环境为 RTX 4060 Laptop、PyTorch 2.5.1+cu121、FP16。测量范围为随机输入的三层交互主干前向,batch=256,总输入宽度为 2048;Mixer 使用 8 个宽度为 256 的 token,FFN 隐藏宽度为 1024,采用 ReLU、无 MoE。预热 10 次,每组计时 30 次,重复 3 组取中位数。
| 被测主干 | 矩阵运算量,GFLOPs | 前向耗时,ms | 矩阵计算吞吐,TFLOP/s |
|---|---|---|---|
| 原始 DCN | 0.003146 | 0.310 | 0.010 |
| DCNv2,rank=32 | 0.201327 | 0.309 | 0.651 |
| DCNv2,全矩阵 | 6.442451 | 0.331 | 19.471 |
| Mixer,逐 token 循环 | 6.442451 | 2.394 | 2.691 |
| Mixer,批量 bmm | 6.442451 | 0.745 | 8.642 |
注:吞吐的分子只统计矩阵乘法,耗时包含被测主干的辅助操作。这是主干矩阵计算吞吐,不是完整模型 MFU。
同一 Mixer 从循环改为 bmm 后约加速 3.21 倍,说明执行组织会影响相同数学工作的完成时间。全矩阵 DCNv2 在这组形状下比教学 Mixer 更快,也说明宽 GEMM 并非 RankMixer 独有的优势。随机输入实验不评价扩参后的预测效果,现有记录也不足以完成真实访存或 Tensor Core 利用率归因。