哈喽,大家好
我是阿星👋🏻上一篇讲的是WorkBuddy做科普视频Skill:中文解说配音字幕全包
这一篇讲我真正每天在做的事:
基于WorkBuddy+flashV4低成本完成口播视频动效包装,比opus基于cc少点细腻但可以出品小白可上手。下面这条就是👇
除了人物有点变形了模糊了声音需要再调整下,基本没毛病。
我把整套流程拆成了 5 步:选题、脚本、拍摄、包装、封面和发布。
每一步我都实际跑过一遍,踩过的坑也一起写在里面。
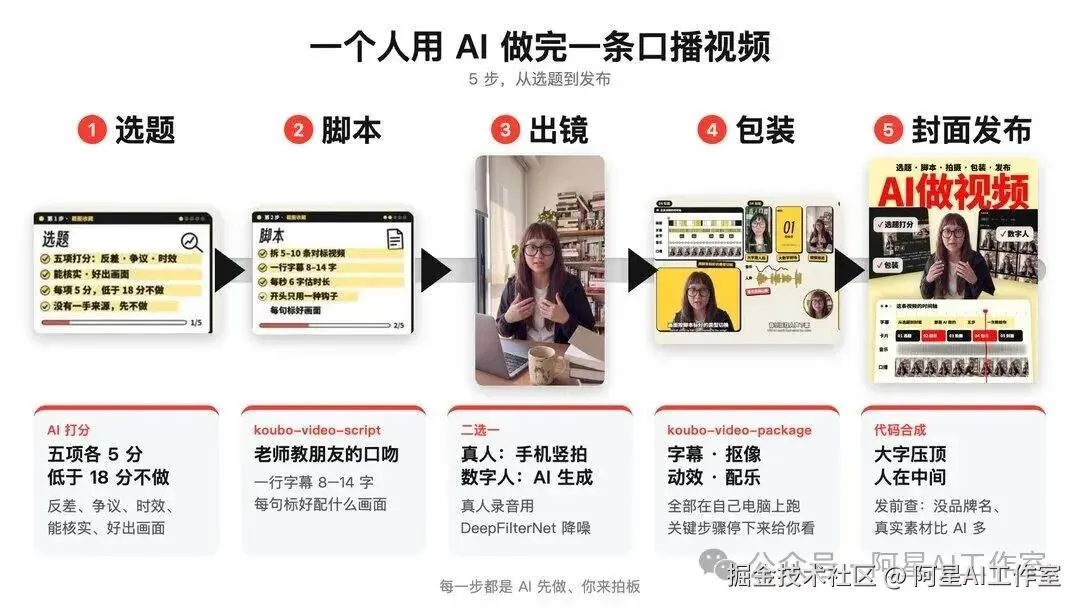
skill 都已经开源,第一次用时按提示填上你自己的设定就行:
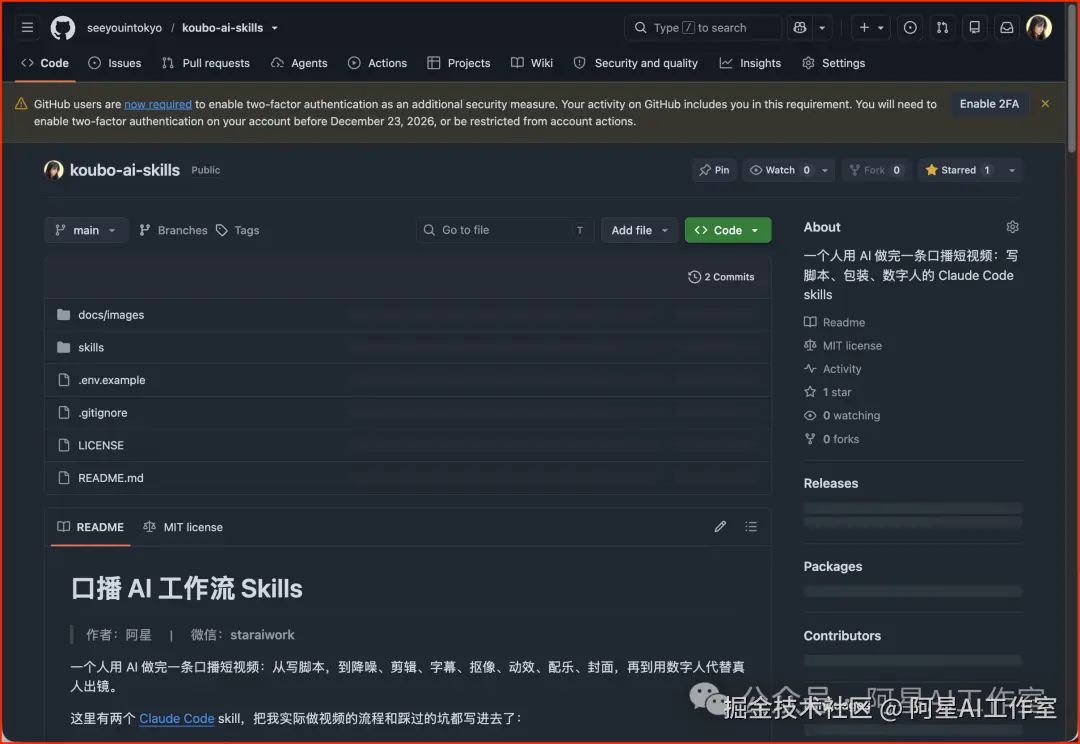
github.com/seeyouintokyo/koubo-ai-skills
你用什么工具运行这个skills是可以替换的,你用workbuddy或cc都行的。
给大家一个效果最好的参考,但是不是必须照着这个做: LibTV mcp 搭工作流,seedance 定人, minimax 声音, wan对口型, opus 底模 Astra封面。
这些模型都是可以替换的,但是流程是不变的。
所以下面是详细过程,我建议你认认真真看一遍,否则skills如果遇到问题你可能会不知道从哪里调整。
01
脚本
- 先找 5 到 10 条你想学的视频
我找了 5 位作者、13 条视频,全丢进一个文件夹。
尽量覆盖你以后要做的类型,比如我平时做口播,也做教程和榜单。
它会给你抽帧分析的,不用你操心。
不用懂剪辑术语,直接让它拆。
这个提示词发给你的ai,它就可以帮你拆解对标视频的包装:
...Prompt
这个文件夹里是我想学的视频。请逐条拆解:
-
抽帧看版式,看人在画面里占多大、什么时候变化
-
读字幕,整理脚本结构和开头写法
-
统计切镜节奏和屏幕文字出现的频率
-
分清哪些是可以学的做法,哪些是别人的个人标识,不能照抄
先给结论,不要改任何文件。
- 别问哪个好看,要问哪个适合你
别人的视频都好看,但不一定适合你。拆完以后,把你平时做什么内容告诉它,让它帮你判断。但是,你不可能说所有类型定的视频都用同一种风格吧?我最后没有选一种画幅,而是定了一套视觉、三种模式
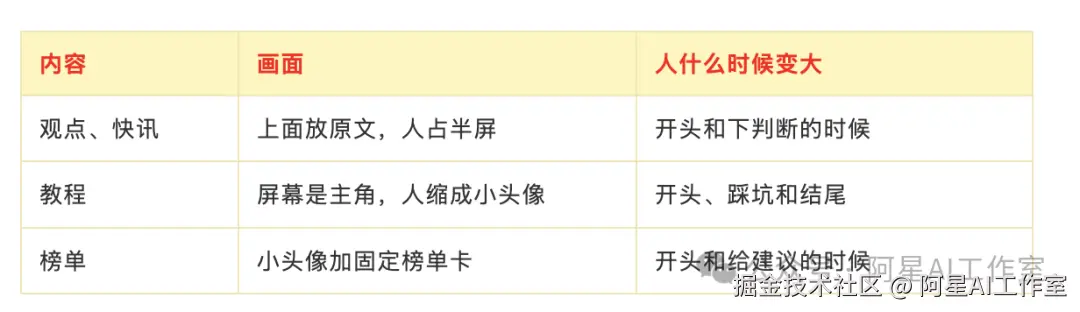
三种模式用同一套字幕、颜色和头像框,这样换内容也能认出是你。而且这样就不至于说每个题材的包装都长得一样了。
- 把脚本规则写下来
文章写给眼睛,脚本要写给嘴和画面,所以我单独做了一份视频脚本 skill。最重要的就 4 条:
最好都是短句子,一行字幕 8 到 14 个字,一行一口气;
按每秒 6 个字估算时长,写完一定念一遍;
开头只用一种钩子,比如先亮结果;
每一句都标好画面:人是全屏、半屏还是小头像。
然后跟它定好输出模式就可以了,每个人用脚本的习惯不一样。比如我自己就会要求口播文案要单独给我一版以因为我要粘贴到提词器上。所以到时候你想要啥格式的文件现在就要说清楚。
...Prompt
根据刚才拆解的视频,再结合我已有的写作风格,帮我沉淀一份视频脚本 skill。
要求:
-
分别给出口播、教程、榜单的脚本结构
-
总结开头的写法,只提炼结构,不抄原句
-
没有亲手做过的事不能写成实测
-
输出表格:秒数、口播、画面类型、素材、证据来源
02
拍摄
真人出镜的话:手机竖拍,念错了只重说那一句
真人出镜就用手机竖拍,人离镜头远一点,后面包装才有空间切半屏、小头像。念错了不用从头录,停一下,把那一句重说一遍就行,后面让 AI 把重说的部分剪掉。
像下面这个图的距离👇,就是离镜头太远了。职场情况下你最多占画面的2/3不能再多了。否则剪辑包装的东西都不知道往哪放。
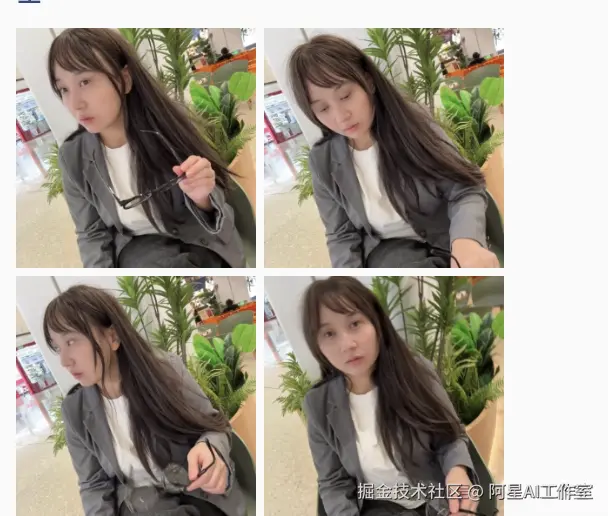
录完先降噪。千万别用 ffmpeg 自带的降噪,效果很差。 我后来换成 DeepFilterNet,在本地跑,音频不用上传,人声也基本没变。降噪完一定自己听一遍再往下做。
不想出镜的话:做个数字人
因为上个月LibTV我还剩点积分,所以我奢侈了,我换成了数字人:
声音是克隆的我,人是用我真实照片生成的我。整条流程是这样的👇
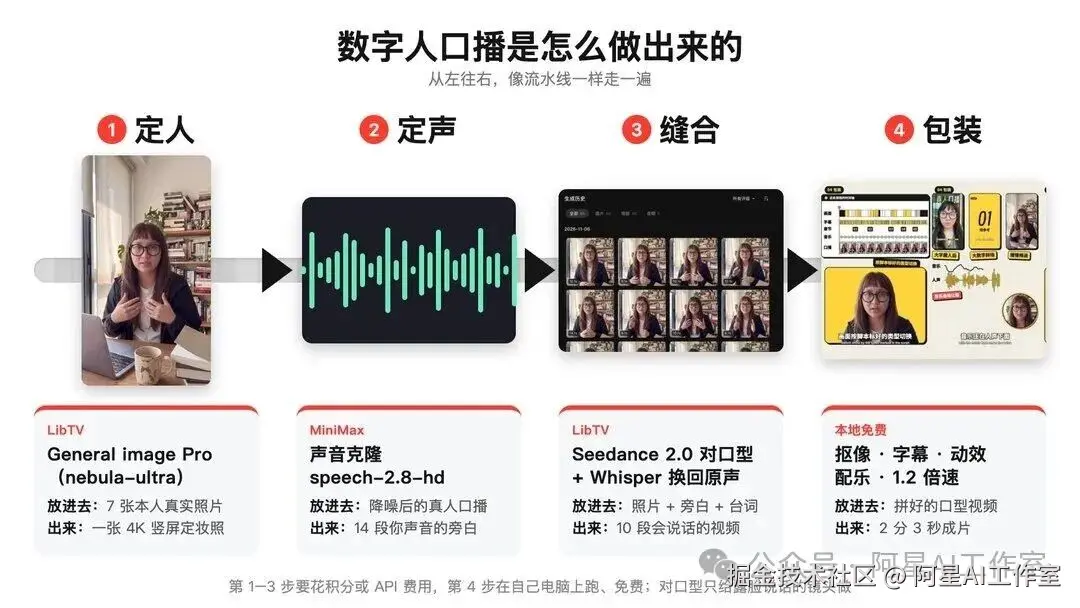
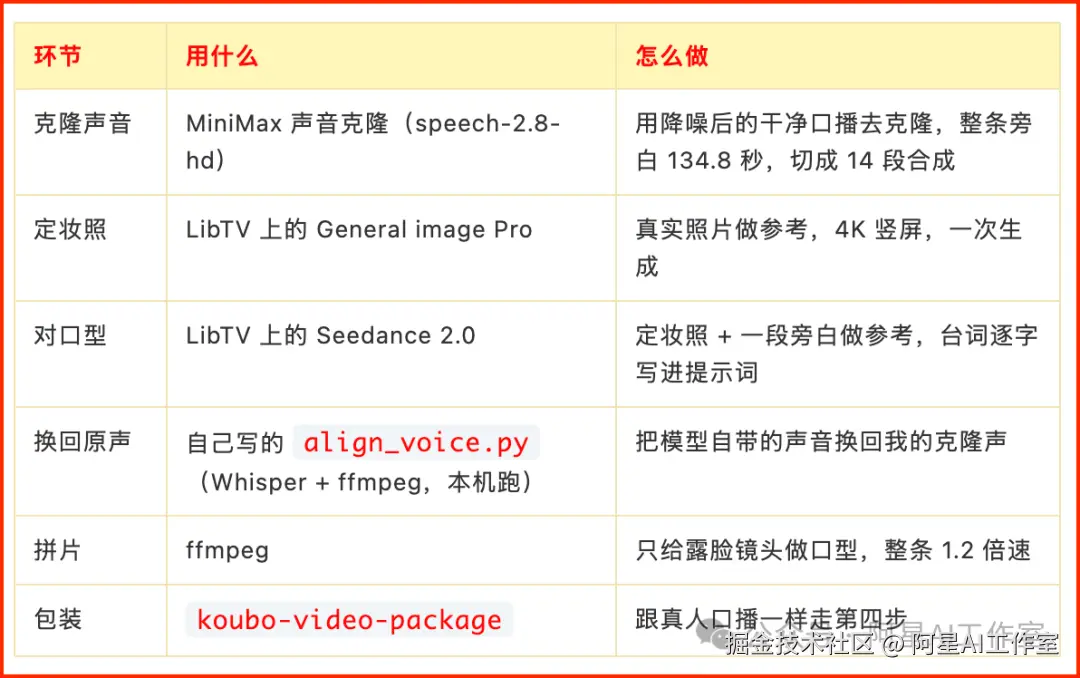
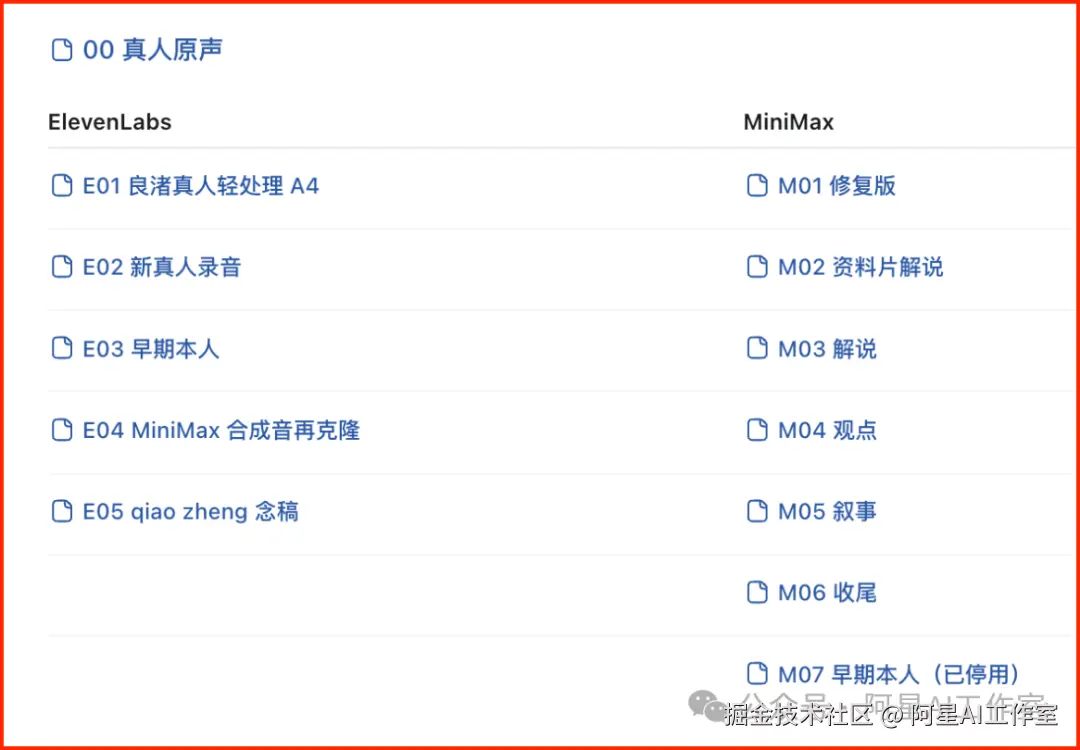
声音: 用降噪后的干净口播去克隆,至少 30 秒。而且你要多让minimax给你克隆几版,比如解说,观点,叙事。
否则就会像我开头给的示范视频一样重音不稳。我问了桥比特老师咋做的,他给的截图。
照片: 准备 10 张左右自己的真实照片,我实际用了 7 张(LibTV 最多收 7 张),4K 竖屏一次生成。这一步我踩的坑最多,直接说结论:
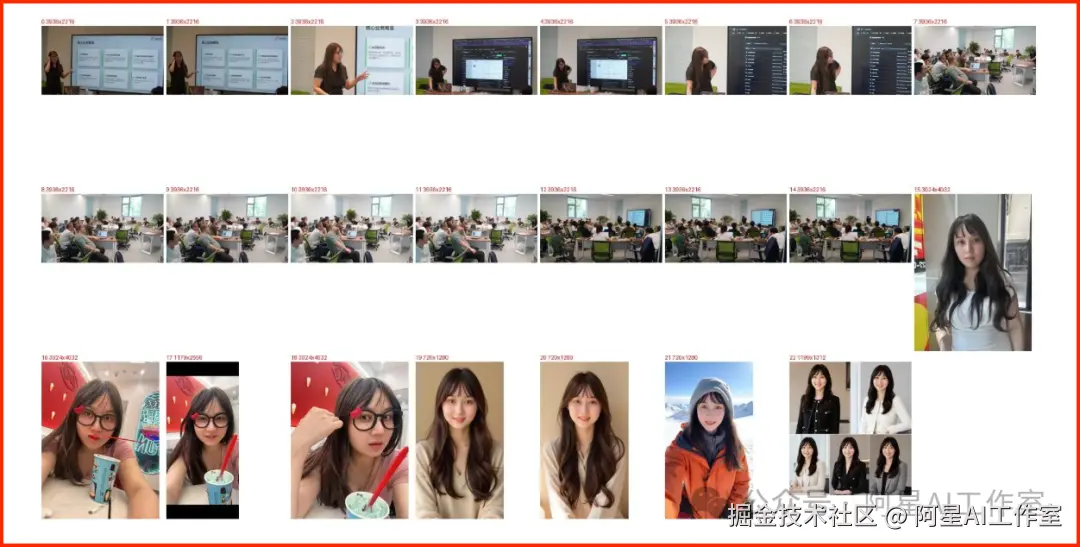
参考图只用真实照片。 拿 AI 写真当参考,脸会被带偏,因为参考图本身就不是我。
别在生成图上反复改。 越改越糊。有问题就从真实原图重新生成。
身体稍微侧一点,手在胸前自然比划。 上身坐直就好。发型也要写死,不然模型会自己改。
背景简单最真实。不要用纯白! 书房或纯色墙、白天自然光,比夜景霓虹房间更像真人。道具要有个人痕迹,纯白马克杯一看就是 AI,我换成了手绘猫咪马克杯。
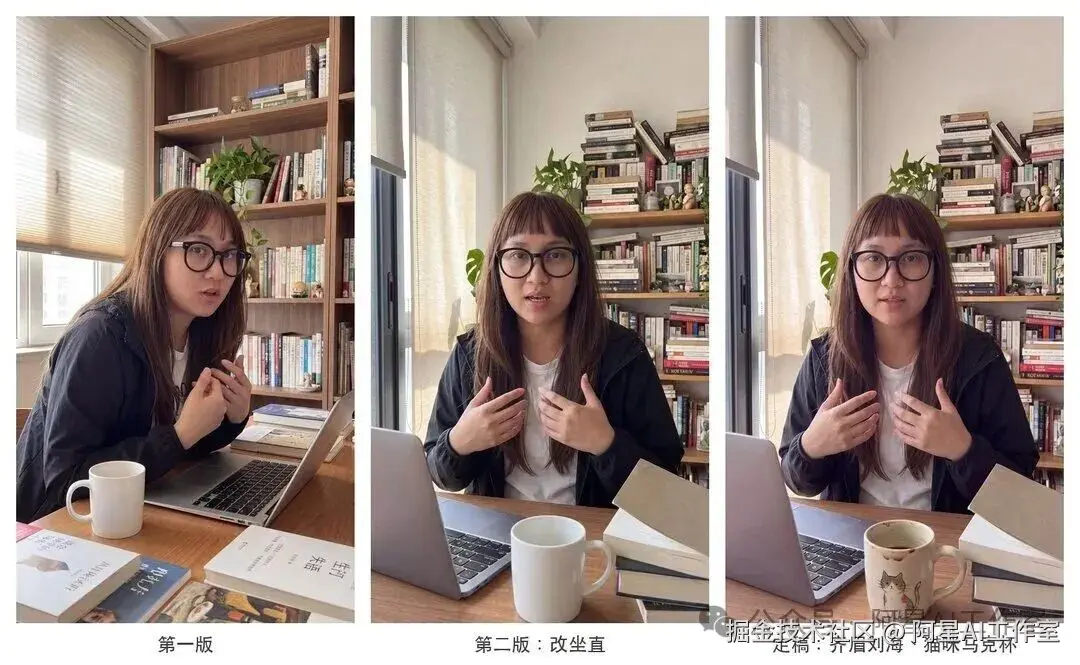
定妆照三版:第一版 → 改坐直 → 定稿(齐眉刘海、猫咪马克杯)
对口型: 我在 LibTV 上用的是 Seedance 2.0,定妆照加一段旁白做参考。有个坑一定要注意:如果只给音频参考,它会自己改台词,所以台词要逐字写进提示词里。
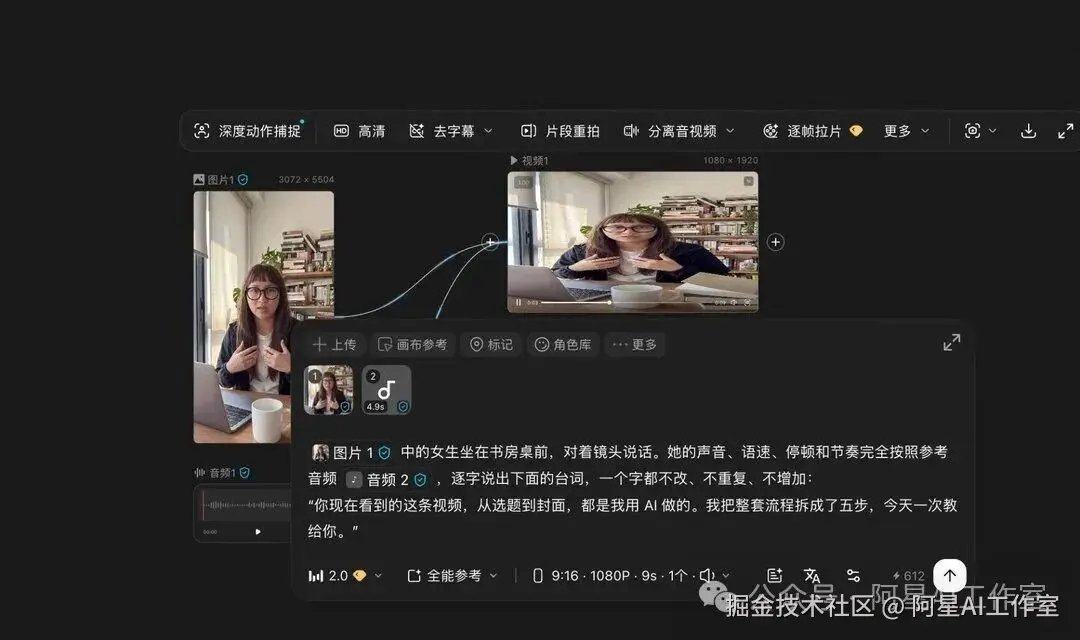
生成画布:定妆照 + 一段音频做参考,台词逐字写进提示词
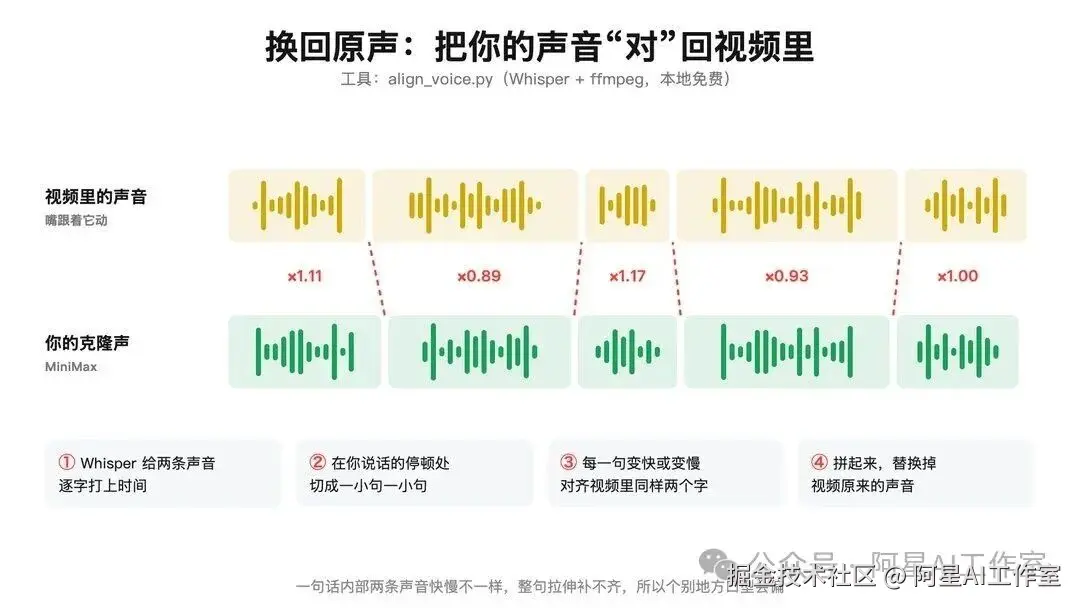
换回原声: Seedance 生成出来的声音不像我。因为音频只被它当成音色参考,声音是它重新生成的。所以我写了个小工具,用 Whisper 给两条声音逐字打时间,在停顿处切开,每一小句变速对齐,再把声音换成我的克隆声。说实话,换完以后有的地方稍微有点对不上,大部分是对得上的。
🎬
省钱: 对口型按秒收费,所以只给露脸说话的镜头做口型。14 段旁白里,8 段全屏、半屏做了 1080p 对口型;小头像用定妆照静帧加闪动光圈;讲操作的镜头干脆不出人。拼完整条加速 1.2 倍,画面和声音一起加速,口型不会错位。
三个能对口型的模型,区别在于嘴是被你的声音带着动,还是模型自己编的:
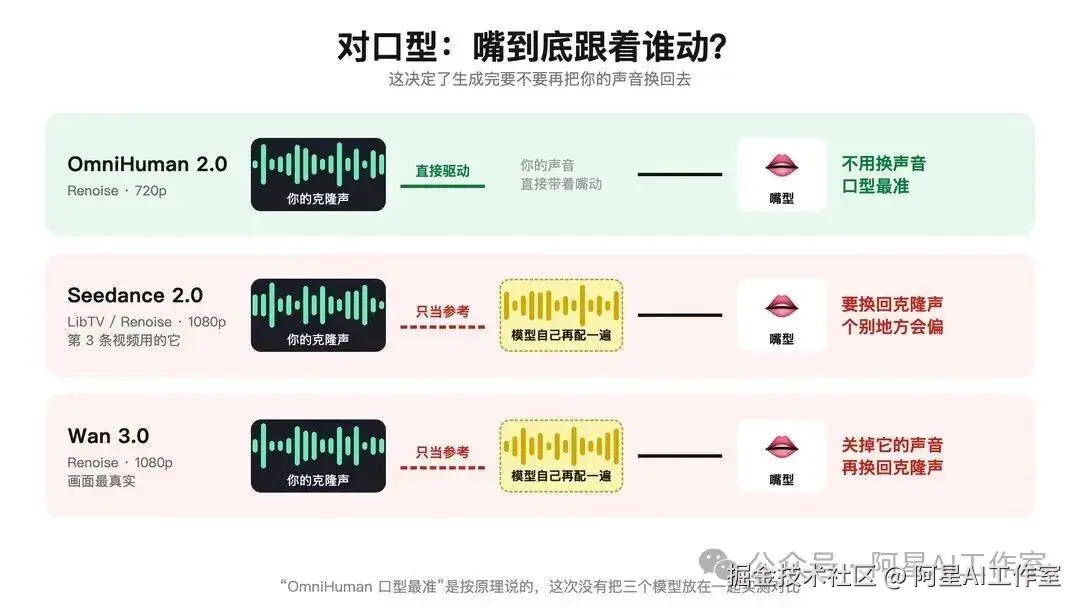
| 模型 | 嘴怎么动 | 要不要换声音 |
|---|---|---|
| OmniHuman 2.0 | 由你的配音直接驱动,视频长度等于配音长度 | 不用 |
| Wan 3.0 | 配音只当参考,嘴是模型自己生成的 | 要关掉自带声音,换成克隆声,可能偏 |
| Seedance 2.0(这次用的) | 模型自己编一条声音,嘴跟着它动 | 要,按字对齐,个别地方会偏 |
按原理说 OmniHuman 2.0 的口型应该最准,但这次我没拿它和 Seedance 做对比实测,下一条我会先试它。
03
包装
素材准备好以后,把下面这段发给 AI:
...Prompt
这是我的口播原片,请按我们定好的风格包装:
-
先转写,核对我实际说了什么,不要按稿子猜
-
专业降噪,给我对比文件确认后再继续
-
剪掉重说、口误和过长的气口
-
校对字幕,按内容切换半屏、小头像和榜单卡
-
素材里出现别人的画面,一律模糊处理
-
先给我看关键画面,确认后再渲染完整视频
包装的规矩就这几条:
1、画面按脚本标好的类型切换,讲观点人占半屏,讲操作人缩成小头像。
2、重点句用大字藏在人身后,章节之间用大数字转场。
3、画面一直保持缓慢推进,别停住。音效少而准,音乐压在人声下面。
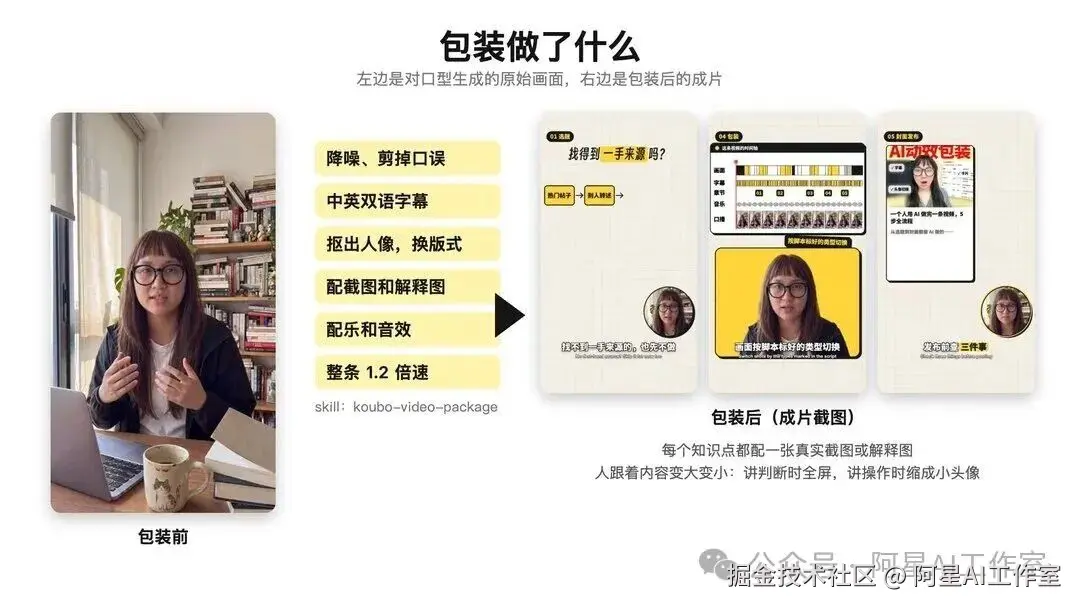
我第一条真人口播包装出来是这样的👇 52 秒。
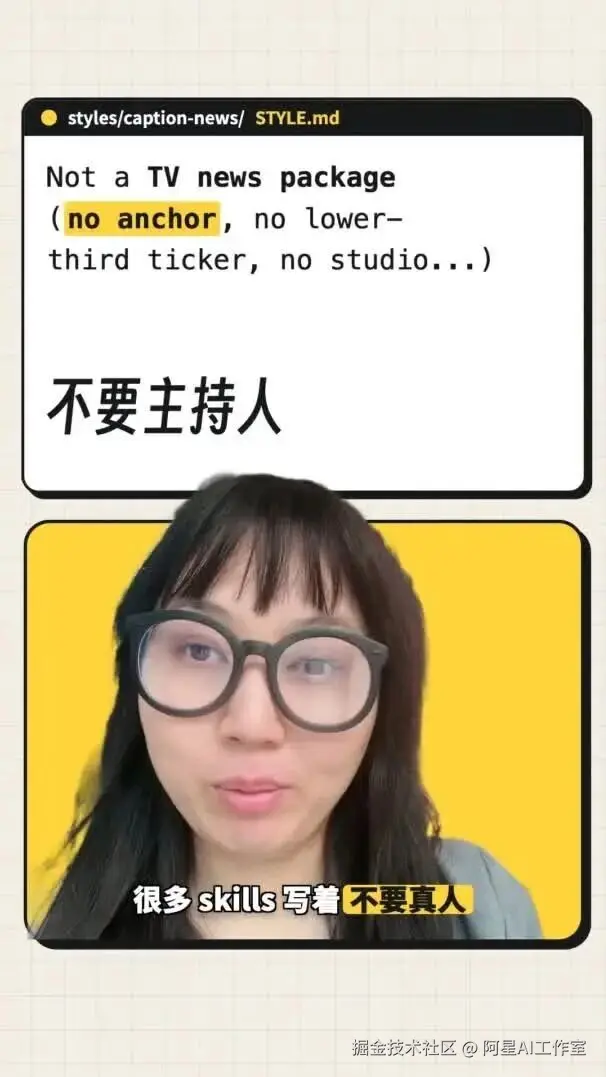
第一版动效太平。 我第一版觉得还可以,但没有对标视频那种大开大合的感觉。一查发现,画面整体的变化量其实差不多,问题是元素落位以后就不动了。直接这么跟它说:
...Prompt
这版动效太平。请对比我的参考视频,告诉我差在哪里,
再按这几个方向加强:大字进场、字藏人后、转场、持续运动、音效。
先给我看关键帧,确认后再渲染。
数字人那条我又改了四版,下面这几条是改出来的经验:
抖动只抖素材,不抖人。 卡点抖动加在截图和图表上,人和房间只保留缓慢推进。
停顿不超过 1.5 秒,而且每次都要动。 每一步结尾的清单卡,入场方式都不一样,逐条打勾,静止的停顿会显得冷清。
截图要大。因为截图是我们的真实素材,所有的视频需要以真实素材优先。 宽度约占画面 90%,必要时把人缩成小头像,把画面让给素材。
每个知识点都要有画面。随口播实时变化的解释图(比如雷达图)最好用。
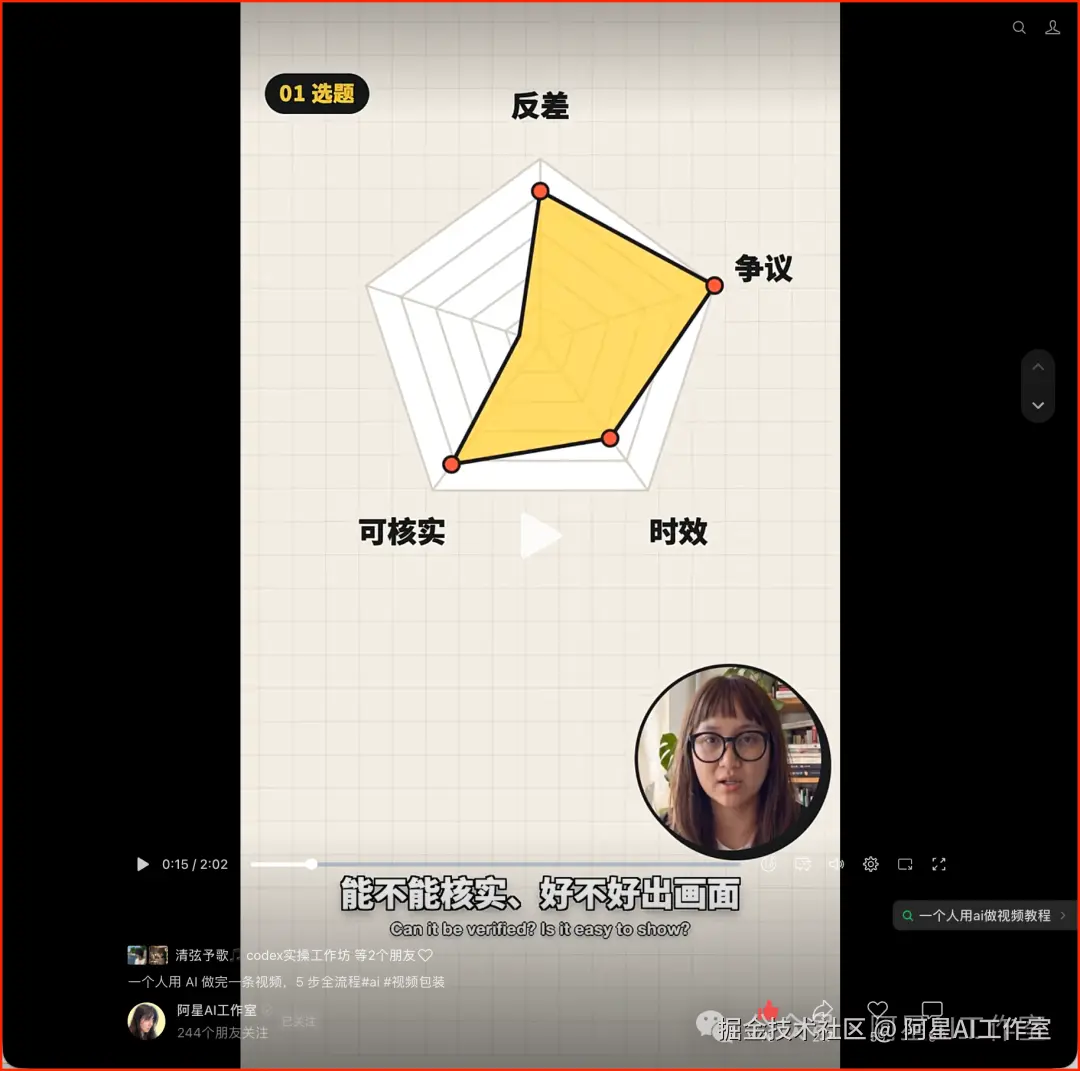
真实内容不能少于 AI 内容。
这是小红书的规矩他们不支持太AI的内容,牢记!
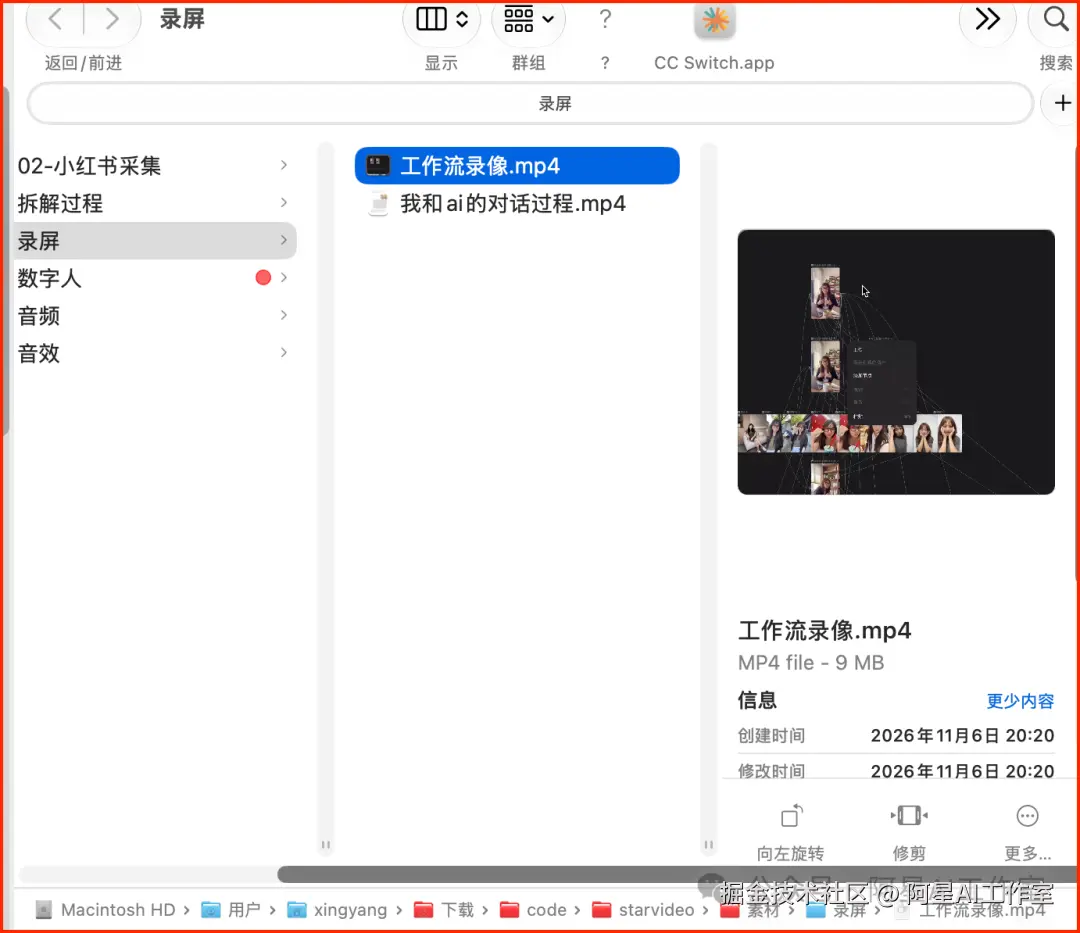
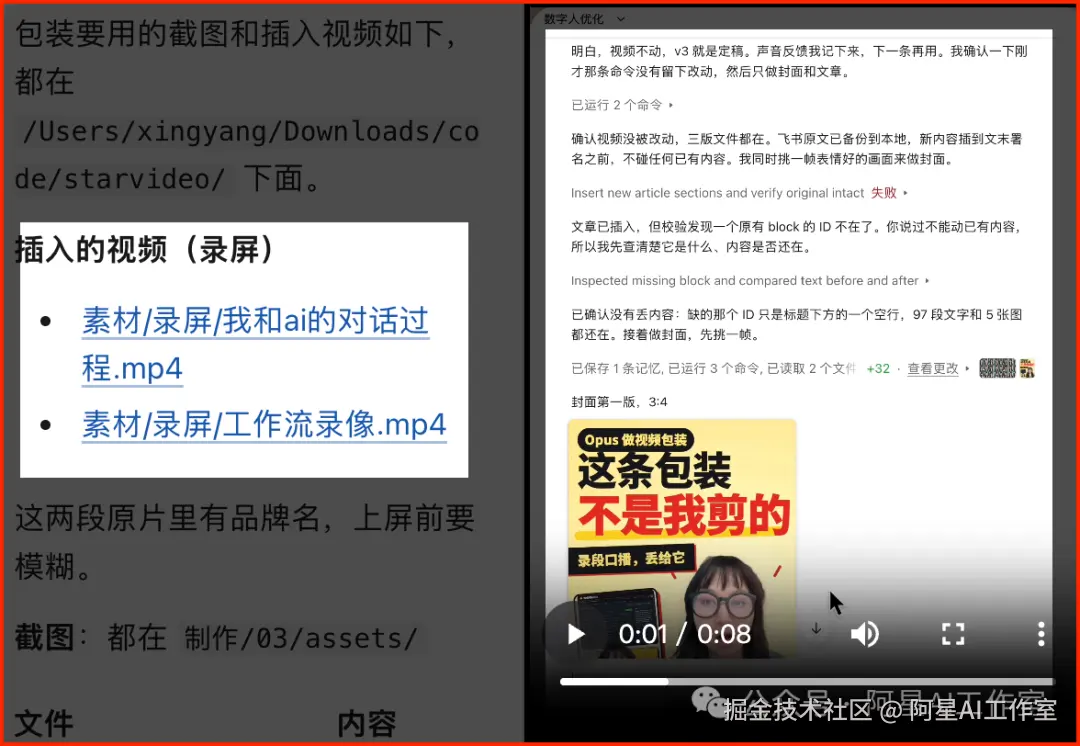
所以我把自己的对话录屏、流程录屏、分镜样帧都放了进去来增加真实性。
比如你可以插入录像素材👇
对话过程素材👇也可以放。
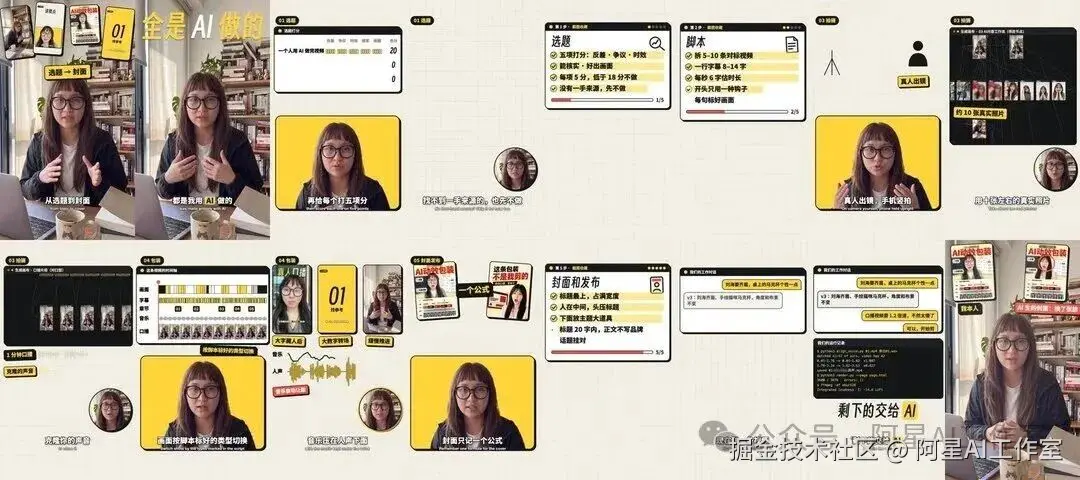
剪辑时自查用的分镜样帧
另外两个小坑:字幕一定要校对,
转写会把"半屏"听成"半平"之类的。
04
封面和发布
封面只记一个公式,并且封面上的素材最好是真的,尽量用这条视频的真实内容,比如时间轴、生成画布,不要用假界面:**
**
标题放最上面,占满宽度;
人在中间,头压住标题;
下面放一个和主题有关的大道具。
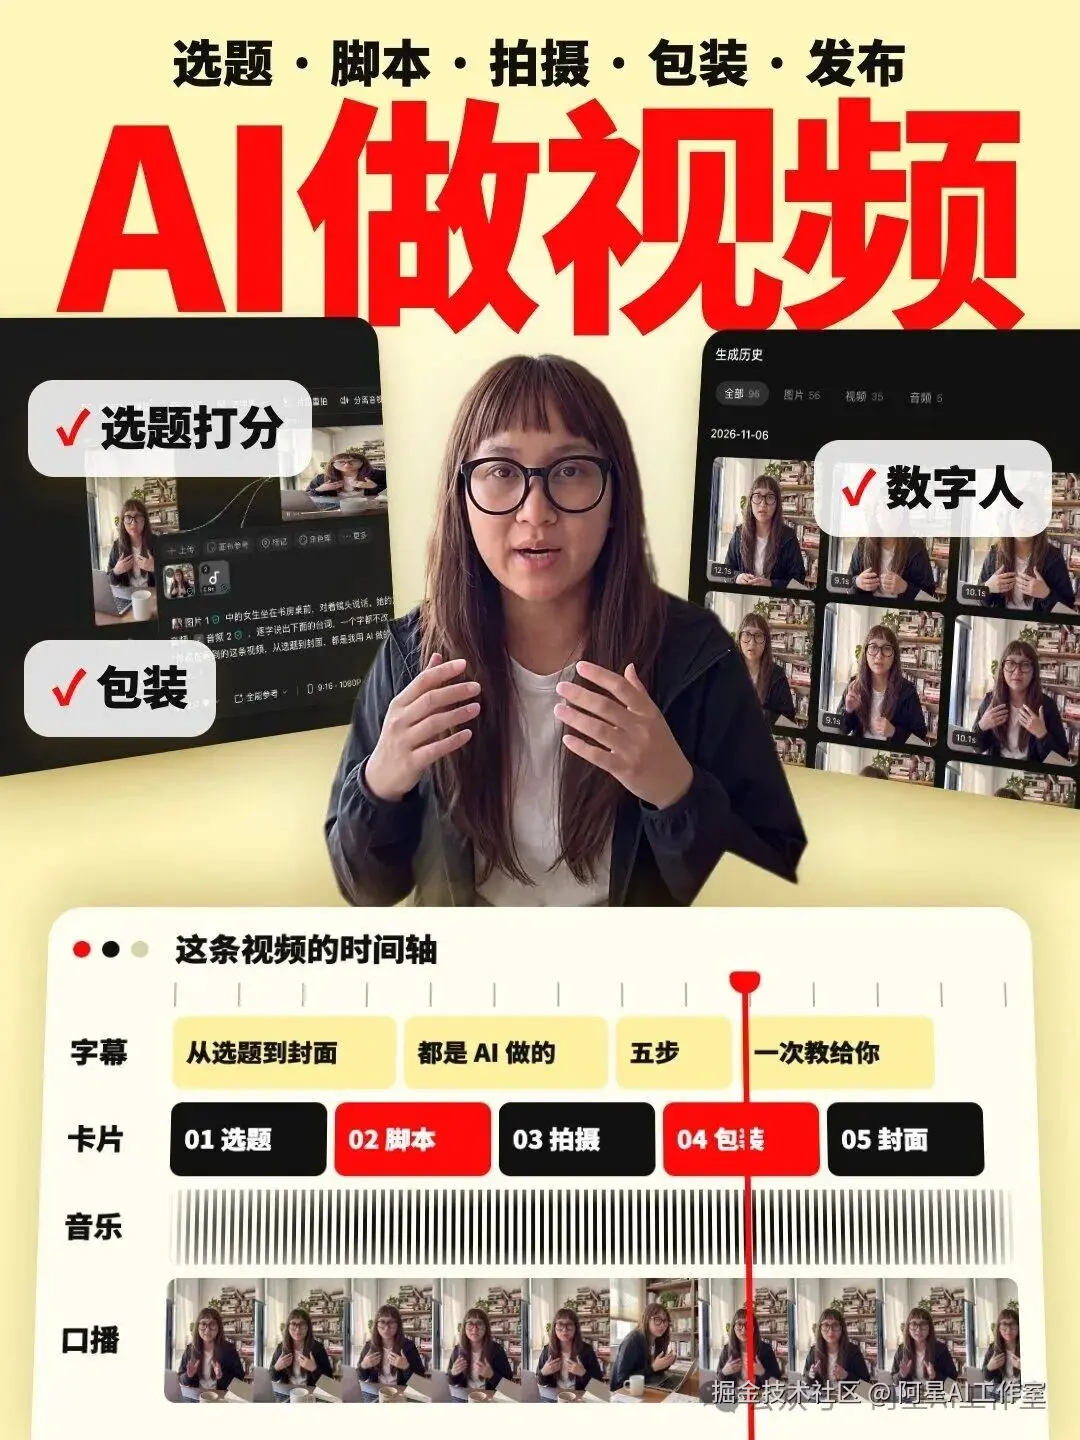
这条视频的封面:标题压顶,人在中间,下面放真实的剪辑时间轴
发布前还需要检查正文,特别是小红书对:
-
标题 20 字以内;
-
正文不写品牌名;
-
话题挂对,活动的话题和截止日期再确认一遍。
最后
这 5 步都沉淀成了 skill
搭完以后,我让它把做法沉淀成了两个 skill:
| skill | 管什么 |
|---|---|
| koubo-video-script | 写口播脚本,覆盖快讯观点、工具教程、榜单盘点三种类型,每句标好画面类型 |
| koubo-video-package | 包装口播原片:拆对标视频、降噪、剪气口和重说、校字幕、人物抠像、版式切换、动效、配乐、封面 |
skill 都已经开源,第一次用时按提示填上你自己的设定就行:
github.com/seeyouintokyo/koubo-ai-skills
现在做一条视频,我只需要录口播、提要求,剩下的交给 AI。当然,每一步你都要自己看一遍,哪里假、哪里不对,AI 不一定发现得了。
ok,我是阿星(戳快速了解我)
更多 AI 应用
我们下期再见👋