从网页上复制一段代码,粘进编辑器,缩进整齐、括号成对,运行时却报 SyntaxError。
删掉那一行重新敲一遍,同样的内容又能跑。问题往往不在代码逻辑,而在你看不见的字符。
我把 10 种常见的隐形字符逐个塞进最小的 Python 程序,在 4 个位置上各测一次,一共 40 组。
结果:30 组直接编译不过,剩下 10 组能编译,但字符串的值已经变了。
顺带用同一套脚本扫了一个真实项目,1459 个文本文件里,28 个文件开头带 BOM,正文中间夹着 156 处隐形字符。
这篇文章给你三样东西:一张隐形字符对照表、40 组实测结果、一个可以直接跑的检测脚本。
为什么复制粘贴会带进看不见的字符
网页、Word、聊天窗口里的空格,不一定是键盘上那个半角空格。
中文输入法下按空格出来的是全角空格,网页排版喜欢用不换行空格防止断行,前端代码里还有零宽空格用来控制断行位置。
这些字符在屏幕上几乎和普通空格一样,但它们是不同的码位、不同的字节。
我先把这 10 个字符的编码搞清楚。
| 字符 | 名字 | UTF-8 字节 | 存成 GBK |
|---|---|---|---|
| U+00A0 | 不换行空格 NBSP | C2 A0,2 字节 |
报错 |
| U+3000 | 全角空格 | E3 80 80,3 字节 |
A1 A1,2 字节 |
| U+200B | 零宽空格 ZWSP | E2 80 8B,3 字节 |
报错 |
| U+200D | 零宽连字 ZWJ | E2 80 8D,3 字节 |
报错 |
| U+FEFF | 零宽不换行空格,也就是 BOM | EF BB BF,3 字节 |
报错 |
| U+2060 | 单词连接符 | E2 81 A0,3 字节 |
报错 |
| U+2028 | 行分隔符 | E2 80 A8,3 字节 |
报错 |
| U+200E | 从左到右标记 | E2 80 8E,3 字节 |
报错 |
| U+FF0C | 全角逗号 | EF BC 8C,3 字节 |
A3 AC,2 字节 |
| U+2013 | 短破折号 | E2 80 93,3 字节 |
A8 43,2 字节 |
表里最右边一列是我原来没想到的:10 个字符里有 6 个根本存不进 GBK。
只要文件里混进一个零宽空格,另存为 GBK 就会抛 UnicodeEncodeError: illegal multibyte sequence,而且报错位置不一定指向那一行。
复现命令:
bash
python evidence/invisible_lab.py encode40 组实验:插在哪儿报错,插在哪儿不报错
光知道码位还不够,得知道它在什么位置会炸。
我写了 4 个插入位置,每个字符都试一遍:缩进处、标识符中间、运算符旁边、字符串里。
然后交给 Python 的 compile() 判断能不能过。40 组用例之间不换一个字,只换插入位置。
| 字符 | 缩进处 | 标识符中 | 运算符旁 | 字符串里 |
|---|---|---|---|---|
| U+00A0 不换行空格 | 报错 | 报错 | 报错 | 通过 |
| U+3000 全角空格 | 报错 | 报错 | 报错 | 通过 |
| U+200B 零宽空格 | 报错 | 报错 | 报错 | 通过 |
| U+200D 零宽连字 | 报错 | 报错 | 报错 | 通过 |
| U+FEFF BOM | 报错 | 报错 | 报错 | 通过 |
| U+2060 单词连接符 | 报错 | 报错 | 报错 | 通过 |
| U+2028 行分隔符 | 报错 | 报错 | 报错 | 通过 |
| U+200E 从左到右标记 | 报错 | 报错 | 报错 | 通过 |
| U+FF0C 全角逗号 | 报错 | 报错 | 报错 | 通过 |
| U+2013 短破折号 | 报错 | 报错 | 报错 | 通过 |
30 组报错,10 组通过,通过的 10 组全都落在字符串里。
这个分布很说明问题:隐形字符只要不在字符串里,Python 一律不放过;进了字符串,它就成了数据的一部分,编译器没有理由拦你。
报错信息分两类,措辞不一样,看懂了能省不少排查时间。
javascript
SyntaxError: invalid non-printable character U+200B
SyntaxError: invalid character ',' (U+FF0C)
第一类是"不可打印字符",8 个零宽类的字符都归它管。
第二类是"无效字符",全角标点和短破折号走这条,报错里会把那个字符原样印出来。
我一开始盯着屏幕上那一行找不到任何异常,因为报错里的 , 和键盘敲出来的 , 在这个字号下几乎一样宽。
复现命令:
bash
python evidence/invisible_lab.py break
python evidence/summarize.py
JSON 里的隐形字符更阴:不报错,只是查不到
代码文件至少有编译器兜底,配置文件就没这么好运了。
我拿同一份 JSON 试了 5 种污染方式,3 种直接抛异常,2 种解析成功但数据已经不对。
| 污染方式 | 结果 |
|---|---|
| 文件开头有 BOM | JSONDecodeError: Unexpected UTF-8 BOM (decode using utf-8-sig) |
| 用全角逗号当分隔符 | JSONDecodeError: Expecting ',' delimiter |
| 冒号换成 U+2028 | JSONDecodeError: Expecting value |
| key 里混进零宽空格 | 解析成功,key 变成 na\u200bme |
| 字符串值里混进不换行空格 | 解析成功,"ok" 长度 2,"o\u00a0k" 长度 3 |
前三种还好,堆栈直接告诉你哪一行哪一列。
后两种才是真有杀伤力的:配置文件能加载,程序能启动,然后你拿 data["name"] 取不到值,或者两个"看起来一样"的字符串比对永远不相等。
我特意验证了一遍:{"name": "ok"} 和 {"name": "o\u00a0k"} 都能解析成功,两个 name 字段的长度分别是 2 和 3。
复现命令:
bash
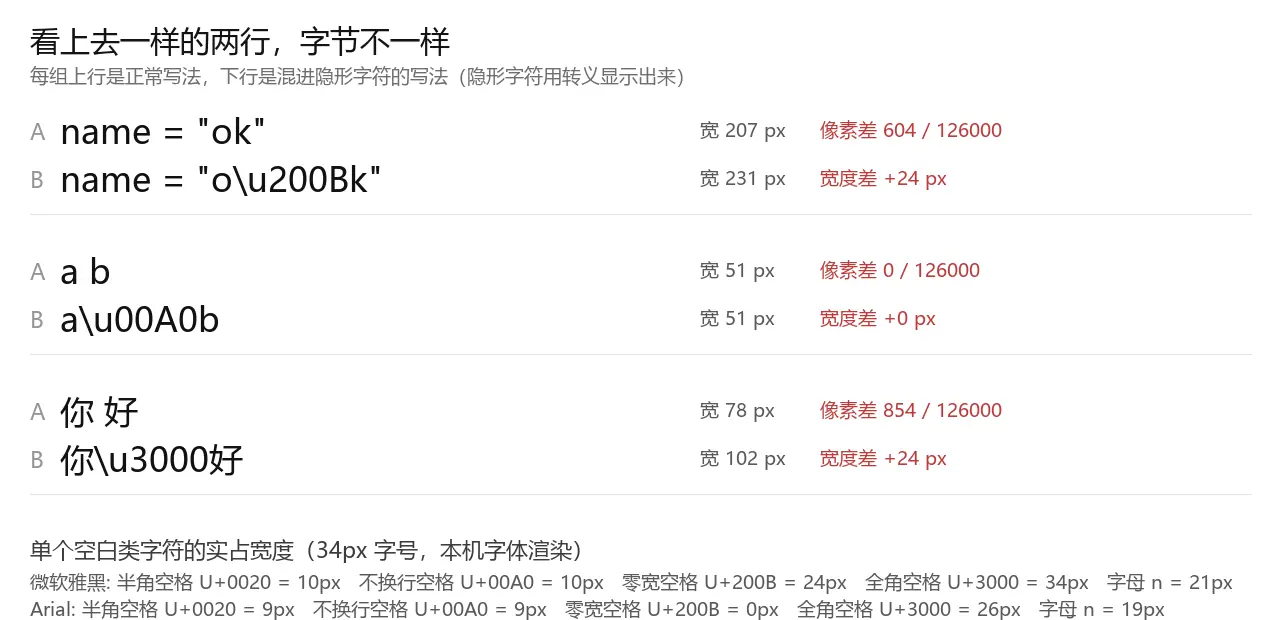
python evidence/invisible_lab.py json逐像素验证:真的完全看不出来
"看不见"这句话不能凭感觉说,我用 Pillow 把它渲染出来逐像素比了一次。
做法是把两行文字画到同一尺寸的白色画布上,转成灰度做差,逐像素统计差值大于 8 的点。
| 对照 | 两行宽度 | 差异像素 |
|---|---|---|
a b 对比 a + 不换行空格 + b |
51px 对 51px | 0 / 126000 |
name = "ok" 对比中间插零宽空格 |
207px 对 231px | 604 / 126000 |
你 好 对比 全角空格版的 你 好 |
78px 对 102px | 854 / 126000 |
不换行空格那一组是 0 个像素不同,宽度也一样。这是真正意义上的"肉眼无法分辨"。
零宽空格那一组反而差出 24 像素,这个结果和我的预期相反,所以我单独测了单个字符的占宽。
| 字符 | 微软雅黑 34px | Arial 34px |
|---|---|---|
| 半角空格 U+0020 | 10px | 9px |
| 不换行空格 U+00A0 | 10px | 9px |
| 零宽空格 U+200B | 24px | 0px |
| 全角空格 U+3000 | 34px | 26px |
同一个零宽空格,在 Arial 下宽度是 0,在微软雅黑下占了 24px。
"零宽"描述的是字符属性,最终占多宽还要看字体里有没有为它准备字形。这一条如果不实测,很容易写成错的结论。
复现命令:
bash
python evidence/render_compare.py拿一个真实项目扫一遍:1459 个文件里的 156 处
实验环境里的字符是我自己造出来的,我想知道真实项目里到底会混进多少。
于是写了个扫描器,对当前项目下所有文本文件逐字符检查,把码位、行列号和前后 30 个字符的上下文都打出来。
结果:1459 个文本文件,28 个文件开头带 BOM,正文中间夹着 156 处隐形字符。
按码位分布是:全角空格 67 处、零宽连字 28 处、不换行空格 27 处、零宽空格 20 处、BOM 9 处,剩下的是几个方向标记。
分类统计里有个细节值得说:正文里的隐形字符有 74 处在代码文件里,42 处在文档里。
挑几个真实的例子。
一份中文说明文档的标题行前面混进了 BOM 的字节,在编辑器里只表现为"这个标题前面好像多了点空"。
一份 Python 脚本里写着 lstrip("\ufeff"),源码里就是那个真的隐形字符。功能是对的,但读代码的人永远看不出来那对引号里到底装了什么,写成 "\ufeff" 转义才可读。
还有一处正则表达式,字符类里明明白白用了全角空格,那是有意为之,用来看住中文标点。
所以扫描结果必须看一眼上下文再动手,全角空格在中文正文里常常是有意的缩进,一把全删会把排版搞乱。
复现命令:
bash
python evidence/scan_where.py <项目目录>怎么查、怎么修,以及不能乱清的地方
检测和清理我都写进同一套脚本了,先扫再修,修完复验。
检测器逐字符比对码位表,命中就报行列号、码位和 Unicode 名字,行列号是为了让你能直接跳过去看。
修复用 str.translate 做映射:全角空格和不换行空格换成半角空格,行分隔符换成换行符,零宽空格、零宽连字、单词连接符直接删掉。
我拿一段故意弄脏的代码测了一遍,内容是 4 处隐形字符加一个全角逗号。
清理前它在 Python 里编不过,清理后隐形字符剩余 0 处,compile() 通过。
读文件那一侧也有个固定动作:带 BOM 的 JSON 用 encoding="utf-8" 打开就会抛异常,换成 encoding="utf-8-sig" 立刻正常。同一个文件,只差三个参数。
下面这几类不能无脑清。
- 中文正文里的全角空格往往是刻意的缩进,删了排版会变。
- emoji 家族的零宽连字是有意义的连接符。
👨👩👧👦这个家庭 emoji 实际由 4 个 emoji 加 3 个零宽连字拼成,Python 长度是 7;把零宽连字删掉就散成 4 个独立的人。 - 肤色修饰符同理,
👍🏻是两个码位,不是两个字符拼错。
复现命令:
bash
python evidence/invisible_lab.py fix
python evidence/emoji_zwj.py
三个我一开始想错的地方
第一个:以为"零宽"就是占 0 像素。实测下来它取决于字体,微软雅黑给了它 24px。
第二个:以为编译器一定能拦住隐形字符。字符串里的 10 组全部通过编译,值却变了,这种错误只在运行时以"数据对不上"的形式出现。
第三个:以为这类字符都来自复制粘贴。扫描发现 28 个文件开头的 BOM 里,有 8 个是 PowerShell 脚本,而在这类脚本里 BOM 是必须保留的,去掉反而会让脚本读错中文。
体会
隐形字符这类问题,排查成本几乎全在"看不见"上。人眼比对两个字符串、两次 diff、两份配置,凭肉眼是比不出来的,必须让脚本打出码位。
我这次最有用的一步不是写修复脚本,而是先做那张 40 组的位置对照表。它明确告诉我:报错一定发生在字符串之外,字符串之内只会静默出错。
排查方向因此完全不同。字符串外的报错去看缩进和标识符,字符串内的不一致去比码位和长度。
另一个体会是:结论要落在自己机器上的数字上。同一段文字,字体不同、编辑器不同、语言不同,表现都不一样。我一开始按"零宽空格宽度为 0"去写,实测两次之后才改成"要看字体"。
下一步
我打算把检测器接进提交前的钩子,任何包含零宽字符或 BOM 的文本文件先拦一次,人工确认再放行。
扫描器还缺一块:现在只覆盖文本文件,没检查超长单行和二进制文件里被夹带的字符。
本文的全部脚本和原始输出都在文章目录的 evidence/ 下,逐字符扫描、位置对照、JSON 用例、逐像素比对、真实仓库扫描各一份,都可以直接对着自己的项目跑一遍。