摘要
一份 3 页 A4 的 PDF 按 216 DPI 渲染成三张 1786×2526 的图,每张图再存成 PNG、JPG、WebP 和调色板 PNG 等九种格式。PNG 只在图表页比三档 JPG 都小,到了密排小字的文字页反倒比质量 92 的 JPG 还大 5%。两页的白底都在八成上下而胜负正好相反。这篇从 JPG 的 8×8 块和 PNG 的行过滤两头拆原因。图表页九成以上的 8×8 块是纯色而文字页只有 75.5%。中文笔画交叉的块在质量 75 下要丢掉一截高频系数,振铃就出在这些块里。PNG 那边的 DEFLATE 吃的是重复,过滤后零字节多并不等于压得小。最后是编码器压缩级别这个常被忽略的变量,同一份像素只换压缩级别体积就能差 1.8 倍。
版本声明
数据来自 2026-11-13 的实测。环境是一台 Apple 芯片 Mac 和桌面浏览器,每种存法各跑一次。渲染用 poppler 按 216 DPI 出白底图,编码用 Pillow 和 pngquant。8×8 块统计、行过滤和单块手算是几段 numpy 小脚本。浏览器那一侧的数字取自图映 PDF 转图片默认 216 DPI 档的导出文件。样张是一份自制 PDF,文字页和图表页的内容全部自制。照片页那张湖山风景来自 Wikimedia Commons 的 CC0 图片,作者 Bonnie Moreland。
适用边界
结论只对这一份样张成立。它是软件直接导出的 PDF,页面不铺底色。样张里没有扫描件、手写稿和印刷用的 CMYK 稿。文字页排了五档字号的中文正文、两档英文和一张细线表格。换成大字号或稀疏排版的页面时胜负可能翻过来。文中的「白底被染灰」是自定口径。PSNR 也只反映平均误差,两者都不等于肉眼观感。凡是标了「推断」的地方都没有验证过。
文章目录
一 PDF 转图片存 PNG 为什么有时比 JPG 小
- 计划里的判断只在图表页成立
- 白底都占八成胜负却相反
- 浏览器导出的两页都是 PNG 更大 二 JPG 为什么会在文字边缘产生振铃
- 纯色块在 JPG 里几乎没有误差
- 一道竖笔只需要 7 个系数
- 斜笔在质量 75 下只剩 29 个系数
- 染灰只出现在带笔画的块里
- 图表页的染灰过半来自色度采样 三 PNG 的行过滤和 DEFLATE 为什么偏爱纯色
- 文字页过半的行和上一行相同
- 整页纯白的 PNG 也要 17507 字节
- 文字页不过滤反而压得最小
- 照片页才用得上行过滤 四 三类页面的体积怎么对上这两套机制
- 九种存法放进一张表
- 图表页九成以上的块是纯色
- 文字页白像素更多纯色块反而更少
- 照片页是 DCT 的主场
- 调色板和 WebP 无损又改了一遍账 五 编码器力度怎么改写 PNG 体积
- 同一份像素换压缩级别体积差 1.8 倍
- 浏览器导出偏弱只是推断 六 PDF 渲染链路里按页选格式怎么落地
- 纯色块占比比白底比例更能分开三页
- 要无损先试 WebP 无损
- 要 JPG 就把质量和色度一起定 七 适用边界与风险提示 八 测量方法自身的坑
- 染灰有三套口径不能混着比
- 白像素和白底不是一回事
- 行过滤实验没算 PNG 文件头
- 单块手算只是按定义的示意 九 还没解决的问题 参考资料
一 PDF 转图片存 PNG 为什么有时比 JPG 小
计划里的判断只在图表页成立
做文档预览的人多半听过一句经验话:文字页转图片要存 PNG。理由是大面积纯色让 JPG 的 DCT 吃亏,PNG 反而更小。这句话的毛病在于它把画质和体积两件事绑在了一起。画质上 PNG 稳赢,因为它是无损的。体积上要看页面长什么样,也要看两边的编码器各自用了多大力气。
这次的样张自制,A4 一共 3 页。第 1 页是文字页,排着 10.5、9、7.5、6、5 磅五档中文正文。正文下面跟着 7 磅和 5 磅两档英文,还有一张用 0.3 pt 细线画的表格。第 2 页是图表页,画了矢量柱状图、折线和饼图并配上 6 到 7.5 磅的小字。第 3 页是照片页,放了一张大照片和一块局部图再配 8 磅文字。三页都用 poppler 按 216 DPI 渲染成白底的 1786×2526 位图,同一份像素再交给 Pillow 存成各种格式。
先看图表页。三档 JPG 从质量 75 到 92 依次是 178,232、201,943、233,599 字节,PNG 只有 127,051 字节。PNG 比三档都小,连质量 75 的 JPG 都是它的 1.40 倍。文字页就不是这样了。PNG 是 838,404 字节而质量 92 的 JPG 只有 796,608 字节。PNG 反倒大了 5%,和质量 85、75 相比差得更多。照片页没有悬念,PNG 的 2,431,138 字节是质量 92 的 JPG 550,440 字节的 4.4 倍。那句经验话在这份样张上只对了三分之一。
白底都占八成胜负却相反
按 1/4 缩图统计颜色时,文字页大约 447 种颜色、白底占 81%。图表页大约 2117 种颜色、白底占 82%。照片页大约 26914 种颜色、白底只占 49%。文字页颜色更少而白底比例又和图表页几乎一样。照「纯色越多 PNG 越占便宜」的说法,它本该是 PNG 赢得最轻松的一页。
结果它偏偏是 PNG 输掉的那一页。这个反差是整篇的起点。白底占比只描述了白色有多少,并没有描述白色是怎么分布的。JPG 在意的是有多少个 8×8 块里混进了笔画。PNG 在意的是一行像素能不能在前面找到一模一样的片段。两种编码器各看各的分布,而这两种分布在文字页和图表页上差得很远。后面几章就是把它一点点量出来。
浏览器导出的两页都是 PNG 更大
只看自己写的 Pillow 管线还不够,因为产品里的导出走的是另一套编码器。我用的是图映 ImgIng imging.cn/ 的 PDF 转图片,环境是电脑浏览器加默认的 216 DPI 档,三页各导出一次 PNG、JPG 和 WebP。导出的像素同样是 1786×2526。文字页 PNG 是 881,244 字节而 JPG 是 818,045 字节。图表页 PNG 是 228,983 字节而 JPG 是 194,664 字节。照片页 PNG 的 3,658,462 字节是 JPG 476,565 字节的 7.7 倍。
这份样张上文字页和图表页都是 PNG 更大,连 Pillow 里 PNG 稳赢的图表页也翻了过来。浏览器导出的图表页 PNG 是 Pillow 那份的 1.8 倍。两份像素出自不同的渲染器,本来不能精确相比。可差这么多很难只靠渲染器解释。编码器这条线索留到第五章再说,先把两套编码机制本身讲清楚。
二 JPG 为什么会在文字边缘产生振铃
纯色块在 JPG 里几乎没有误差
JPG 的有损压缩分几步走。第一步把 RGB 转成一个亮度分量和两个色度分量。色度通常再横竖各减半,也就是常说的 4:2:0。然后每个分量切成 8×8 的块,每块做一次二维 DCT 得到 64 个频率系数。左上角那个是代表整块平均亮度的直流分量,越往右下频率越高。接着每个系数除以量化表里对应的步长再取整,这是唯一真正丢信息的一步。最后按之字形扫描,用游程编码压掉成串的零再走霍夫曼编码。
一个纯白的 8×8 块里 64 个像素完全一样。DCT 之后只有直流分量不为零而 63 个交流系数全是零。量化碰不到零,所以这样的块几乎没有误差。在文字页上按块统计时,纯色块解码后的平均亮度误差按 0 到 255 计只有 0.003。图表页是 0.035 而照片页是 0.011。纯色块在画质上并没有吃亏。「大面积纯色让 DCT 吃亏」要是成立,亏的也不在画质上。第三章会看到它亏在字节数上。
一道竖笔只需要 7 个系数
真正亏画质的是带边缘的块。笔画的边是一个从 255 跳到 0 的台阶,台阶在频域里要一长串频率才描述得了。量化表右下角的步长很大,高频系数一除就成了零。反变换回来只剩一组截断的余弦波叠加,台阶两侧就会冒出过冲和下冲。这就是振铃。它在白底上表现为笔画周围的一圈灰色毛边,彩色字周围还会带上杂色。
为了看清这个过程,可以按 JPEG 的定义手算几个 8×8 亮度块。这里只做 DCT、量化和反变换三步。量化表用标准亮度表按质量缩放,不含色度和熵编码。下面这段跑出来的数只是用来解释机制的示意。本章后面几节的统计数都来自真实编码的文件。
python
# 按 JPEG 定义手算 8x8 亮度块:只做 DCT、量化、反变换,不含色度和熵编码
import numpy as np
Q50 = np.array([16,11,10,16,24,40,51,61, 12,12,14,19,26,58,60,55, 14,13,16,24,40,57,69,56,
                14,17,22,29,51,87,80,62, 18,22,37,56,68,109,103,77, 24,35,55,64,81,104,113,92,
                49,64,78,87,103,121,120,101, 72,92,95,98,112,100,103,99]).reshape(8, 8)
k = np.arange(8)
C = np.sqrt(2 / 8) * np.cos((2 * k[None, :] + 1) * k[:, None] * np.pi / 16); C[0] /= np.sqrt(2)
yy, xx = np.mgrid[0:8, 0:8]
shapes = {
    "竖笔": np.where((xx >= 2) & (xx <= 3), 0.0, 255.0),
    "十字": np.where(((xx >= 2) & (xx <= 3)) | ((yy >= 5) & (yy <= 6)), 0.0, 255.0),
    "斜笔": np.clip(np.abs(xx - yy * 0.6 - 1.5) * 170 - 85, 0, 255),   # 带抗锯齿灰阶
}
for name, block in shapes.items():
    coef = np.einsum("ij,jk,lk->il", C, block - 128, C)
    line = f"{name}  原始非零系数 {int((np.abs(coef) > 1e-6).sum())}/64"
    for q in (75, 92):
        table = np.clip((Q50 * (200 - 2 * q) + 50) // 100, 1, 255)
        kept = np.round(coef / table)
        back = np.clip(np.round(np.einsum("ji,jk,kl->il", C, kept * table, C) + 128), 0, 255)
        bad = int(((np.abs(back - block) > 8) & (block == 255)).sum())
        line += f" | q{q} 留下 {int((kept != 0).sum())} 个,白像素偏差>8 的 {bad}/{int((block == 255).sum())},最大偏差 {int(np.abs(back - block).max())}"
print(line)竖笔 原始非零系数 7/64 | q75 留下 7 个,白像素偏差>8 的 0/48,最大偏差 4 | q92 留下 7 个,白像素偏差>8 的 0/48,最大偏差 1
十字 原始非零系数 42/64 | q75 留下 32 个,白像素偏差>8 的 7/36,最大偏差 16 | q92 留下 40 个,白像素偏差>8 的 0/36,最大偏差 8
斜笔 原始非零系数 60/64 | q75 留下 29 个,白像素偏差>8 的 2/32,最大偏差 15 | q92 留下 44 个,白像素偏差>8 的 0/32,最大偏差 7代码说明:C 是 8 点 DCT-II 的正交矩阵,两次 einsum 分别是正变换和反变换。质量缩放用的是 IJG 的公式,质量 50 以上时缩放比例是 200 减两倍质量。质量 75 对应标准表的 50% 而质量 92 对应 16%。三种块都在第 3、4 列附近画黑,其余像素是 255 的白。
只看竖笔这一个块的话,结果会让人意外。一道 2 像素宽的竖笔在质量 75 下最大偏差只有 4,白像素一个都没有染灰。看系数就明白了。竖笔只在水平方向有变化,垂直方向的每一行都一样。能量全落在第一行的水平频率上,64 个系数里只有 7 个不为零。量化表第一行在质量 75 下是 8、6、5、8、12、20、26、31,步长都不大。这 7 个系数全部活了下来。单靠这个块解释不了文字页在质量 75 下成片的染灰。
斜笔在质量 75 下只剩 29 个系数
补上十字和斜笔两个块以后情况就变了。十字是一横一竖交叉,水平和垂直两个方向同时有台阶。它的能量摊到了 42 个系数上,有一部分落进右下角的高频区。质量 75 时留下 32 个而丢了 10 个。36 个白像素里有 7 个偏差超过 8,最大偏差 16。斜笔带了抗锯齿灰阶,有 60 个系数不为零。质量 75 只给它留下 29 个,丢掉了一半多。
质量 92 时两个块都没有白像素超过 8 级。十字留下 40 个系数而斜笔留下 44 个,最大偏差分别是 8 和 7。中文正文的一个字里横竖交叉和撇捺斜出几乎是常态。字号一小,几道笔画就挤进了同一个 8×8 块。拿竖笔去推文字页的振铃会严重低估,真实页面上大量的块长得更像十字和斜笔。不过这三个块是照想象画出来的。真实字形里哪一类块各有多少,这一轮没有统计。
染灰只出现在带笔画的块里
手算只能说明机制,下一步要拿真实编码的文件按块统计。脚本读入 poppler 渲染的 PNG 当原图,再读入同一份像素存出来的 JPG 和 WebP。整张图按 8×8 网格切块。块里 64 个像素 RGB 完全相同的算纯色块,其余的算带边缘的块。然后分两类块统计平均亮度误差,以及原本纯白的像素里有多少被染灰。这里的染灰是指任一通道偏差超过 8 级,不限离笔画多远。
python
# 按 8x8 块统计:块里有没有笔画,JPG 的误差落在哪类块里
import sys
import numpy as np
from PIL import Image

def luma(a):
    return 0.299 * a[..., 0] + 0.587 * a[..., 1] + 0.114 * a[..., 2]

src = np.asarray(Image.open(sys.argv[1]).convert("RGB")).astype(np.int16)
h, w = (src.shape[0] // 8) * 8, (src.shape[1] // 8) * 8
src = src[:h, :w]
blk = src.reshape(h // 8, 8, w // 8, 8, 3)
flat = (blk.max(axis=(1, 3)) == blk.min(axis=(1, 3))).all(axis=-1)   # 块内 64 个像素完全同色
white_px = (src == 255).all(axis=-1)
print(f"{sys.argv[1].split('/')[-1]}  白像素 {white_px.mean():.1%}  纯色块 {flat.mean():.1%}  带边缘的块 {1 - flat.mean():.1%}")
for path in sys.argv[2:]:
    dec = np.asarray(Image.open(path).convert("RGB")).astype(np.int16)[:h, :w]
    err = np.abs(luma(dec) - luma(src)).reshape(h // 8, 8, w // 8, 8)
    stained = (np.abs(dec - src).max(axis=-1) > 8) & white_px
    st = stained.reshape(h // 8, 8, w // 8, 8).sum(axis=(1, 3))
    wp = white_px.reshape(h // 8, 8, w // 8, 8).sum(axis=(1, 3))
    print(f"  {path.split('/')[-1]:<18} 平均亮度误差 纯色块 {err.mean(axis=(1, 3))[flat].mean():.3f}"
          f" / 边缘块 {err.mean(axis=(1, 3))[~flat].mean():.3f}"
          f"   白像素被染灰 纯色块 {st[flat].sum() / max(wp[flat].sum(), 1):.2%}"
          f" / 边缘块 {st[~flat].sum() / wp[~flat].sum():.2%}")
erlang
文字页-PNG.png  白像素 92.1%  纯色块 75.5%  带边缘的块 24.5%
  文字页-JPGq75.jpg     平均亮度误差 纯色块 0.003 / 边缘块 3.811   白像素被染灰 纯色块 0.01% / 边缘块 11.24%
  文字页-JPGq92.jpg     平均亮度误差 纯色块 0.001 / 边缘块 1.359   白像素被染灰 纯色块 0.00% / 边缘块 0.50%
  文字页-WebPq75.webp   平均亮度误差 纯色块 0.008 / 边缘块 2.063   白像素被染灰 纯色块 0.00% / 边缘块 2.61%
图表页-PNG.png  白像素 84.2%  纯色块 93.0%  带边缘的块 7.0%
  图表页-JPGq75.jpg     平均亮度误差 纯色块 0.035 / 边缘块 2.879   白像素被染灰 纯色块 0.09% / 边缘块 24.44%
  图表页-JPGq92.jpg     平均亮度误差 纯色块 0.022 / 边缘块 1.318   白像素被染灰 纯色块 0.01% / 边缘块 12.70%
  图表页-WebPq75.webp   平均亮度误差 纯色块 0.071 / 边缘块 2.036   白像素被染灰 纯色块 0.02% / 边缘块 15.23%
照片页-PNG.png  白像素 50.8%  纯色块 48.0%  带边缘的块 52.0%
  照片页-JPGq75.jpg     平均亮度误差 纯色块 0.011 / 边缘块 1.814   白像素被染灰 纯色块 0.00% / 边缘块 9.87%
  照片页-JPGq92.jpg     平均亮度误差 纯色块 0.006 / 边缘块 1.085   白像素被染灰 纯色块 0.00% / 边缘块 0.24%
  照片页-WebPq75.webp   平均亮度误差 纯色块 0.013 / 边缘块 1.930   白像素被染灰 纯色块 0.00% / 边缘块 2.31%
代码说明:1786 不是 8 的倍数,脚本把右边和下边不足 8 像素的一条截掉了。那里在三页上都是页边空白。纯色块的判据很严,要求 64 个像素的三个通道完全相等。抗锯齿留下的一个浅灰像素就能让整块变成边缘块。luma 用的是 BT.601 的亮度系数,和 JPG 内部的 YCbCr 转换一致。染灰比例的分母是这一类块里原本纯白的像素数。
三页的规律完全一致。纯色块里的染灰比例全部在 0.1% 以下,误差几乎都集中在带边缘的块里。文字页质量 75 时边缘块的平均亮度误差是 3.811 而纯色块只有 0.003,差了上千倍。这和 JPG 的结构对得上。每个块独立量化,振铃只能在块内扩散而过不了块的边界。笔画离隔壁的纯白块再近也染不到隔壁。
照这个结构,JPG 在一页上的画质损失大致取决于两个因子。第一个因子是带边缘的块有多少,文字页是 24.5% 而图表页是 7.0%。第二个因子是每个边缘块里丢了多少系数,这由量化表的松紧和块里笔画的形状一起决定。文字页在第一个因子上是图表页的 3.5 倍,第二个因子上又全是交叉笔画。两头都不利。
图表页的染灰过半来自色度采样
图表页的数有一处不对劲。质量 92 时它的边缘块染灰还有 12.70%,文字页同质量只有 0.50%。图表页的边缘是彩色柱子和彩色折线的边,嫌疑落在色度采样上。4:2:0 把色度分辨率横竖各砍一半。彩色边缘的色度会被抹到相邻像素上,白底上就多出一圈带颜色的晕。
验证这件事只需要换一个参数。同一页在同样的质量 75 下用 Pillow 分别存成 4:2:0 和 4:4:4,再统计离非白像素 1 到 3 像素以内的白像素有多少被染灰。图表页 4:2:0 时是 26.71% 而 4:4:4 时降到 12.17%,过半的染灰来自色度采样。文字页几乎没有区别,两个数是 11.24% 和 11.14%。文字页的笔画基本是黑的,色度里本来就没多少东西可丢。它的振铃主要在亮度上。
4:4:4 的代价是体积。图表页从 178,232 字节涨到 256,372 字节,多了 44%。这已经是同一页 PNG 127,051 字节的 2.0 倍。图表页想用 JPG 把彩色边缘存干净的话,体积上就彻底比不过 PNG 了。顺带一提,4:2:0 那份的字节数和九种格式表里质量 75 的 JPG 一字节不差。可见 Pillow 在这个质量下默认用的就是 4:2:0。WebP 的有损模式按规范只支持 4:2:0,而图表页 WebP 质量 75 的染灰也比文字页高。方向和这个解释一致,只是 WebP 这一侧没法做 4:4:4 的对照。
三 PNG 的行过滤和 DEFLATE 为什么偏爱纯色
文字页过半的行和上一行相同
PNG 的压缩分两步。第一步是行过滤,每一行像素前面加一个字节标明这一行用了哪种过滤。过滤一共五种,分别是不过滤、减左边、减上边、减左上平均和 Paeth 预测。过滤只是把像素换成和邻居的差值,本身并不压缩。它的目的是让数据里出现更多的零和重复。第二步是把过滤后的整个字节流交给 DEFLATE,也就是 zip 里那一套。DEFLATE 先用 LZ77 在最近 32 KB 里找重复片段,再做霍夫曼编码。
两步加起来,PNG 喜欢的是能在前面找到一模一样的片段。一整行白色用减上边过滤后全是零,不过滤也是一长串 0xFF。这两种 DEFLATE 都能用很少的比特带过。为了看清三页上的行结构,下面这段把 PNG 的五种过滤自己实现了一遍再用 zlib 的 9 级压缩算体积。
python
# PNG 行过滤 + DEFLATE:整行重复有多少,过滤后 0 字节占多少,压出来多大
import sys, zlib
import numpy as np
from PIL import Image

img = np.asarray(Image.open(sys.argv[1]).convert("RGB")).astype(np.int16)
H, W, _ = img.shape
rows = img.reshape(H, W * 3)
prev = np.vstack([np.zeros((1, W * 3), np.int16), rows[:-1]])
left = np.hstack([np.zeros((H, 3), np.int16), rows[:, :-3]])
upleft = np.hstack([np.zeros((H, 3), np.int16), prev[:, :-3]])
p = left + prev - upleft
pa, pb, pc = abs(p - left), abs(p - prev), abs(p - upleft)
paeth = np.where((pa <= pb) & (pa <= pc), left, np.where(pb <= pc, prev, upleft))
cands = {0: rows, 1: rows - left, 2: rows - prev, 3: rows - (left + prev) // 2, 4: rows - paeth}
cands = {k: (v % 256).astype(np.uint8) for k, v in cands.items()}

def pack(ftype_per_row):
    out = bytearray()
    for y, t in enumerate(ftype_per_row):
        out.append(t); out += cands[t][y].tobytes()
    return bytes(out)

score = np.stack([np.minimum(cands[k], 256 - cands[k].astype(np.int16)).sum(axis=1) for k in range(5)])
adaptive = score.argmin(axis=0)                      # libpng 的「最小绝对和」启发式
same_as_above = (rows == prev).all(axis=1)[1:].mean()
blank = (rows == 255).all(axis=1).mean()
print(f"{sys.argv[1].split('/')[-1]}  全白行 {blank:.1%}  与上一行完全相同 {same_as_above:.1%}")
for name, ft in [("不过滤", [0] * H), ("全用 Up", [2] * H), ("逐行自选", adaptive)]:
    raw = pack(ft)
    zeros = raw.count(0) / len(raw)
    print(f"  {name:<6} 过滤后 0 字节 {zeros:.1%}  DEFLATE-9 {len(zlib.compress(raw, 9)):>9,} 字节")
erlang
文字页-PNG.png  全白行 49.0%  与上一行完全相同 54.4%
  不过滤    过滤后 0 字节 1.4%  DEFLATE-9   664,995 字节
  全用 Up  过滤后 0 字节 91.6%  DEFLATE-9   797,303 字节
  逐行自选   过滤后 0 字节 90.3%  DEFLATE-9   724,940 字节
图表页-PNG.png  全白行 40.1%  与上一行完全相同 51.9%
  不过滤    过滤后 0 字节 0.3%  DEFLATE-9   115,107 字节
  全用 Up  过滤后 0 字节 98.7%  DEFLATE-9   131,663 字节
  逐行自选   过滤后 0 字节 99.1%  DEFLATE-9   124,974 字节
照片页-PNG.png  全白行 25.6%  与上一行完全相同 25.3%
  不过滤    过滤后 0 字节 0.2%  DEFLATE-9 3,125,927 字节
  全用 Up  过滤后 0 字节 64.3%  DEFLATE-9 2,475,748 字节
  逐行自选   过滤后 0 字节 66.6%  DEFLATE-9 2,440,964 字节
代码说明:五种过滤都按 PNG 规范的定义写,差值对 256 取模。Paeth 预测器直接用原始像素,因为无损编码里原始像素和解码像素相同。「逐行自选」照的是 libpng 文档里常用的那条启发式。它把每种过滤后的字节当有符号数取绝对值求和,再挑和最小的那种。体积只算过滤后数据流经 zlib 压缩的结果,不含 PNG 文件头和分块校验。每行 1786 个像素乘 3 个通道一共是 5358 字节。
文字页有 49.0% 的行是全白的,54.4% 的行和上一行完全一样。多出来的 5.4 个百分点是上下几行完全一样的非白行。推断多半是表格竖线和长竖笔经过的那些行,这一轮没有逐行核对。图表页全白行只有 40.1%,和上一行相同的比例是 51.9% 也比文字页略低。单看行结构文字页并不吃亏,它的整行重复甚至更多一些。
整页纯白的 PNG 也要 17507 字节
两页的空白行都过半,差距就出在剩下那一半有内容的行上。不过先插一件事,它回答了纯色到底让 DCT 吃了什么亏。一张 1786×2526 的纯白页存成几种格式时体积是这样的。PNG 开 optimize 是 17,507 字节。JPG 质量 75 是 71,411 字节,质量 92 也是 71,411 字节,两者一字节不差。WebP 质量 75 是 8,116 字节,WebP 无损只有 236 字节。
JPG 两档质量一样大的原因前面讲过。纯白块只有直流分量而交流系数全是零,量化表怎么缩放都碰不到它们。可就算全是零,每个块也要编一个直流差值和一个块结束标记。这张纯白页按 8×8 亮度块算一共有 70,784 个块。71,411 字节摊下来每块大约 8 比特,这里面还算进了色度块的份。JPG 没有「这一大片都一样所以整片跳过」的手段,块再空也要逐块交代一遍。这才是 DCT 在大面积纯色上真正吃的亏。它亏在字节上而不在画质上。
PNG 这边也有底价。DEFLATE 一次匹配最多复制 258 字节,这是 RFC 1951 定死的上限。哪怕是一串全零的数据,压缩率也有天花板。这张纯白页过滤前大约有 1353 万字节,压到 17,507 字节时压缩比是七百多倍。WebP 无损只要 236 字节。它的 LZ77 匹配长度上限高得多,还带着颜色缓存和预测模式。整页一个颜色对它来说几乎是零成本。这个 236 字节到第四章还会用上。
文字页不过滤反而压得最小
回到有内容的行。这里出现了这次实测里最意外的一组数。文字页上减上边过滤让 91.6% 的字节变成了零,压出来却是 797,303 字节。完全不过滤时零字节只有 1.4%,压出来反而只有 664,995 字节。后者小了 13 万多字节。逐行自选的启发式压出来是 724,940 字节,夹在两者中间。图表页也是同样的顺序,不过滤的 115,107 字节最小。
这组数第一眼看上去像是代码写错了。可五种过滤都是照规范逐条写的,不过滤那一路更是什么都没动。能想通的只有一半。DEFLATE 并不关心数据里有多少个零,它关心的是能不能找到长的重复片段。同一字号和同一字体的笔画在原始像素里会反复出现一模一样的片段,比如同样粗细的竖笔和同样的横笔。不过滤时这些片段原样留在字节流里,LZ77 能在 32 KB 窗口里把它们一个个匹配上。减上边之后每个像素都变成了和正上方那一行的差。同一个字形片段出现在不同位置时上方邻居并不一样,差值也就不一样。原本可以复用的片段就这样被打散了。零确实多了,可零之间夹着的非零字节变得更难匹配。
这个解释是推断,LZ77 实际匹配到了什么这一轮没有逐个去数。最小绝对和这条启发式本来就只是一个代理指标。它追求的是差值小而 DEFLATE 要的是重复多。两者在照片上大体一致,在合成图像上就会分岔。PNG 规范讲过滤方式选择时也提过,调色板图像和低位深图像一般不过滤更好。这份样张是真彩图。照规范的默认建议会走自适应过滤,正好落进这个坑里。
还有一个对照值得记下。Pillow 开 optimize 存的文字页 PNG 是 838,404 字节。自写实现不过滤压出来是 664,995 字节,两者差了 173,409 字节。PNG 文件头和分块校验加起来不过几百字节。差出来的这部分大半应该在过滤策略上。Pillow 默认怎么选过滤这一轮没有查源码,所以「大半应该」只能说到这一步。
照片页才用得上行过滤
照片页的顺序完全反过来。不过滤的 3,125,927 字节最大。减上边是 2,475,748 字节,逐行自选的 2,440,964 字节最小。照片是连续色调,相邻像素的值接近但几乎从不完全相同。原始字节里很难找到长重复,而差值都集中在零附近。这正是行过滤设计时瞄准的场景。过滤后零字节从 0.2% 升到了 66.6%,DEFLATE 也确实压得更好。
三页放在一起看,行过滤在照片上帮了大忙而在合成的文字和图表上帮了倒忙。这和「PNG 适合图形不适合照片」的老说法并不矛盾。PNG 适合图形靠的是 DEFLATE 在原始像素里找重复,过滤在这件事上没出什么力。
四 三类页面的体积怎么对上这两套机制
九种存法放进一张表
两套机制拆完以后,再回头看完整的体积表。下面这张图是同一份 216 DPI 渲染结果在三类页面上的编码体积和 PSNR,PSNR 以真彩 PNG 为基准。
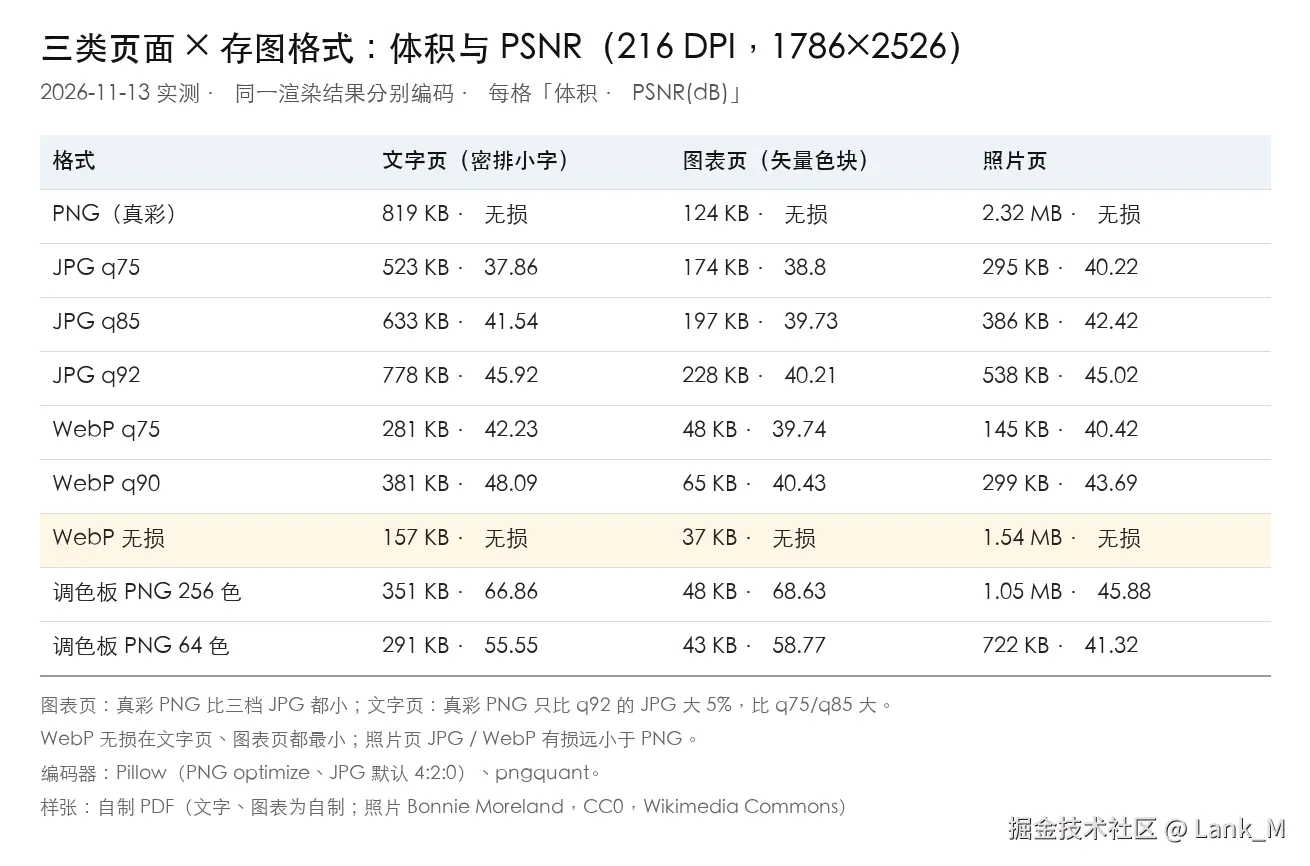
这张图要看什么:表里一共九行,WebP 无损那一行有底色高亮。它在文字页是 157 KB、在图表页是 37 KB,是这两页九种存法里最小的。图表页那一列里 PNG 真彩是 124 KB,比下面三档 JPG 的 174、197、228 KB 都小。文字页那一列里 PNG 真彩是 819 KB,比质量 92 的 JPG 778 KB 大。照片页那一列里 JPG 和有损 WebP 都在几百 KB,PNG 真彩是 2.32 MB。图下的署名写着样张自制,照片作者 Bonnie Moreland 按 CC0 许可发布在 Wikimedia Commons 上。
表里的 KB 按 1024 字节折算并和正文里的字节数一一对应,比如文字页 PNG 的 838,404 字节就是 819 KB。下面几节拿前两章的机制去解释这张表的三列。
图表页九成以上的块是纯色
图表页 93.0% 的 8×8 块是纯色。这些块并不怎么亏 JPG 的画质,可每一块都要交代一遍。纯白块每块大约要 8 比特。剩下 7.0% 的边缘块是柱子、折线和饼图的边。按块统计的那套口径,它们在质量 75 下染灰 24.44%。换成色度采样那一节的口径去对比 4:2:0 和 4:4:4,过半的染灰能归到色度采样上。JPG 在这一页的处境很尴尬。大部分字节花在了没有信息的纯色块上,剩下的字节又不够把彩色边缘存干净。质量 92 比质量 75 多花了 55,367 字节,PSNR 却只从 38.80 升到 40.21 dB,比文字页同档的 45.92 dB 低得多。
PNG 在这一页占了结构上的便宜。柱子是一长段同色像素,同一根柱子连续几百行都一样。饼图的扇区也是成片的同色。这些东西在原始字节里本来就是长重复,LZ77 一抓就是一大片。页面上那大约 2117 种颜色大多出现在柱子和饼图的抗锯齿边上。颜色的种类看着多,占的像素却很少。PNG 的 127,051 字节因此比三档 JPG 都小。
文字页白像素更多纯色块反而更少
文字页是这篇里最有意思的一页。按像素数算的话它的纯白像素占 92.1%,比图表页的 84.2% 还高。按 8×8 块算的话它的纯色块只有 75.5%,比图表页低了 17.5 个百分点。原因并不复杂。五档小字号的中文密密地排满了半页。每个字只有几十个像素高而笔画很细,字和字之间的空隙还不到一个块宽。白像素虽然多却被笔画切得很碎,大部分落进了带笔画的块里。
这对两边的影响是对称的。JPG 那边有 24.5% 的块要编码一堆交流系数。这些块又是第二章说的那种十字和斜笔的块。系数多而且高频多,怎么都压不下去。PNG 那边有内容的行里是一个个字形。同一个字不一定在相近的位置重复出现。字形片段的重复是有的,但远不如图表页的柱子那样成片。两边都得为每一道笔画边缘付钱,比的只是谁付得少。质量 92 的 JPG 付了 796,608 字节,换来 45.92 dB,按笔画旁白底那套口径染灰 0.40%。PNG 付了 838,404 字节换来无损。JPG 拿 5% 的体积优势换掉了一点几乎看不出的误差。「PNG 反而更大」说的就是这件事。
颜色数在这里没有预测力。文字页大约 447 种颜色,比图表页少了将近五分之四。它的颜色只有白色、黑色和两者之间的一圈抗锯齿灰。每个字的边缘都有这一圈灰,而灰的位置几乎从不重复。颜色少并不代表重复多。
照片页是 DCT 的主场
照片页大约有 26914 种颜色。48.0% 的纯色块基本都是页边空白,其余全是照片。照片的能量集中在低频,量化掉高频系数时人眼几乎察觉不到。这正是 DCT 设计时瞄准的东西。质量 92 的 JPG 是 550,440 字节、45.02 dB,PNG 是它的 4.4 倍。质量 75 的 JPG 是 302,318 字节,PNG 是它的 8.0 倍。
照片页上 PNG 的难处也正是第三章讲的那一条。原始字节里找不到长重复,只能靠行过滤把差值压到零附近再交给 DEFLATE。这能省下一截,但离 DCT 还差得远。256 色调色板 PNG 能压到 1,105,849 字节、45.88 dB,体积还是质量 92 的 JPG 的 2.0 倍。WebP 无损的 1,612,642 字节也翻不了盘。
调色板和 WebP 无损又改了一遍账
讲到这里会发现「PNG 还是 JPG」其实是一个过窄的问题。表里还有两类存法又把前面的结论改了一遍。调色板 PNG 先把颜色量化到 256 色以内。每个像素只存一个字节的索引,然后再走过滤和 DEFLATE。文字页 256 色是 359,391 字节、66.86 dB。它比质量 75 的 JPG 535,729 字节小三分之一,PSNR 却高出将近 30 dB。图表页 256 色是 49,019 字节、68.63 dB。这两页的颜色本来就少。量化到 256 色几乎不损失什么,体积却一下子省掉一半多。
WebP 无损更进一步。文字页 161,212 字节和图表页 37,390 字节都是九种存法里最小的,比 256 色调色板 PNG 还小。在文字页上它只有真彩 PNG 的 19%。WebP 无损的规范里有空间预测、颜色缓存、更长的 LZ77 匹配和二维距离编码这些手段。第三章那张纯白页只要 236 字节,就是这些手段叠在一起的结果。在文字页上哪一项贡献最大,这一轮没有拆开看。
五 编码器力度怎么改写 PNG 体积
同一份像素换压缩级别体积差 1.8 倍
回到第一章留下的那条线索。浏览器导出的 PNG 为什么比 Pillow 存的大那么多?办法是把那份导出 PNG 的像素原样读进来,一个像素都不改只换压缩参数重新存。
python
# 同一份像素不改,只换 PNG 的压缩力度
import io, os, sys
from PIL import Image

for path in sys.argv[1:]:
    page = Image.open(path); page.load()
    print(f"{os.path.basename(path)}  原文件 {os.path.getsize(path):,} 字节")
    for label, kw in [("level 1", {"compress_level": 1}),
                      ("level 6", {"compress_level": 6}),
                      ("optimize", {"optimize": True})]:
        buf = io.BytesIO(); page.save(buf, "PNG", **kw)
print(f" {label:<9} {len(buf.getvalue()):>10,} 字节")sample3p-page-001.png 原文件 881,244 字节
level 1 1,091,203 字节
level 6 594,417 字节
optimize 602,883 字节
sample3p-page-002.png 原文件 228,983 字节
level 1 306,565 字节
level 6 128,831 字节
optimize 125,175 字节代码说明:compress_level 对应 zlib 的压缩级别。1 最快而 9 最强,Pillow 默认用 6。optimize 会把级别拉到 9 再做一些额外尝试。图读进来是什么模式就按什么模式存回去,像素和尺寸都不动。输出里 001 是文字页而 002 是图表页。
同一份文字页像素用级别 1 存出来是 1,091,203 字节,用级别 6 存出来是 594,417 字节。前者是后者的 1.8 倍。浏览器导出的原文件 881,244 字节正好夹在两者之间。用级别 6 重存时体积比原文件小了 33%。用 optimize 重存是 602,883 字节,也小了 32%。这时它就比同一款工具导出的 JPG 818,045 字节更小了。图表页也一样,原文件 228,983 字节用 optimize 重存后是 125,175 字节。体积小了 45%,同样比它的 JPG 194,664 字节小。
这里还有个小意外。文字页上 optimize 反而比默认的级别 6 大了 8,466 字节,到图表页上 optimize 才更小。「开到最强就一定最小」在 DEFLATE 上并不总成立。这和第三章不过滤更小的现象可能是同一类事,都是启发式在合成图像上失灵。这一点只看到了两页,没有往下追。
浏览器导出偏弱只是推断
浏览器导出的 PNG 落在级别 1 和级别 6 之间,最直接的解释是导出时用了比较轻的压缩设置。这是推断。导出走的是哪个编码器、开了什么参数,从文件本身是看不出来的。PDF 转图片这条链路的实现,这一轮没有去核实。
有一条公开的事实可以作旁证。浏览器 canvas 的 toBlob 和 toDataURL 只给有损格式留了质量参数,PNG 的压缩级别和过滤方式都没有开放给网页。网页应用直接用 canvas 导出 PNG 时压缩力度由浏览器自己定,网页这一侧调不了。想要更小的 PNG 就得在网页里另带一个编码器,或者事后再过一遍压缩工具。这款工具走的是哪条路,从导出文件上看不出来。
这件事对「PNG 和 JPG 谁小」的影响很大。Pillow 管线里图表页 PNG 赢了,浏览器导出里同一页 PNG 却输了。两个结论出自两种编码器组合,拿哪一个推到格式本身都不对。比较两种格式的体积时,至少要同时报出 PNG 的压缩级别以及 JPG 的质量档和色度采样。
六 PDF 渲染链路里按页选格式怎么落地
纯色块占比比白底比例更能分开三页
要在渲染之后和编码之前自动给每一页选格式的话,最先想到的判据多半是白底比例或颜色数。这份样张上这两个判据都会把文字页和图表页归成一类。颜色数甚至会给出相反的结论,因为文字页颜色更少而 PNG 却输了。
8×8 纯色块占比能把三页分开,图表页 93.0%、文字页 75.5%、照片页 48.0%。它直接对应 JPG 要编码的边缘块数量。算起来也不贵,一页 1786×2526 的图只需要一次 reshape 加一次比较。这个判据只在三页上看过。多少以上该选 PNG 的阈值靠三个点定不出来,至少要换一批真实文档再看分布。
还有一种更直接的做法是同一页两种格式各编一次再留下小的那个。代价是每页多一次编码。这一轮没有计时,值不值得要看文档页数和机器。
要无损先试 WebP 无损
下游要无损的场景比如文档存档、要放大看小字的预览,这份样张给出的答案很明确。文字页和图表页都是 WebP 无损最小,分别是 161,212 和 37,390 字节。照片页 WebP 无损是 1,612,642 字节,仍然太大。这类页应该退到有损格式上去。
下游只认 PNG 的话可以按这个顺序往下试。先换强一点的压缩级别,文字页上 Pillow 级别 6 就比浏览器导出小了 33%。再试调色板量化,文字页和图表页量化到 256 色后 PSNR 还在 66 dB 以上而体积省掉一半多。最后可以把「不过滤」加进过滤策略的候选里。这份样张的文字页上它比自适应过滤小约 6 万字节,比全用减上边小 13 万多字节。这一条只在自写的过滤实现上看到过,现成的 PNG 优化工具没有拿来对照。
还有一点。这类图很多时候最后是给人看的。转完以后放大看一眼小字和字体是不是原样,比任何体积数字都可靠。这个习惯对哪种格式和哪个工具都适用。
要 JPG 就把质量和色度一起定
下游只吃 JPG 的话,质量和色度采样要一起定。文字页质量 75 时有 11.69% 的笔画旁白底被染灰,质量 85 降到 4.86% 而质量 92 只有 0.40%。图表页对应的是 10.13%、4.22% 和 0.70%。这两组属于另一套染灰口径,第八章会讲它和前两套的区别。文字页用质量 92 的 JPG 时体积比真彩 PNG 小 5%,毛边基本看不见。
彩色图表页要另说。在 4:2:0 下质量再高,彩色边缘也会带色晕。换成 4:4:4 能把染灰压下去一半多,可体积已经是 PNG 的 2.0 倍。这种页面要么接受色晕,要么干脆别用 JPG。
在浏览器里做这件事还有一个限制。canvas 导出 JPG 时只能给质量而不能指定色度采样,用什么采样由浏览器自己决定。要控制 4:4:4 同样得另带编码器。这一条是照接口定义说的,各家浏览器实际用的采样方式这一轮没有测。
浏览器里能用的 PDF 转图片工具,这里只看了图映这一款的导出文件。它在电脑浏览器上使用,清晰度有 144、216、300 DPI 三档并默认 216。它可以导出单页、全部页面或者拼成一张长图。216 DPI 拼出来的长图是 1786×7578,正好是三页 2526 的高度相加而没有缩小。这次抓网络请求时 13 次处理前后都没有出现带文件的请求。它给了 PNG、JPG 和 WebP 三种格式。照这篇的结论,文字页和图表页可以优先选 WebP。下游不认 WebP 时选 JPG,照片页选 JPG 或 WebP。
七 适用边界与风险提示
所有体积和画质的数只来自一份 3 页 A4 样张和一台 Apple 芯片 Mac,每种存法各跑一次。页面内容对体积的影响非常大。换一份字更大、排得更松的文字页时纯色块占比会上去,PNG 就可能赢。换成扫描件的话页面上全是纸张底纹和噪点。纯色块几乎为零,情况会更接近照片页。这几种页面这一轮都没有测。
编码器也是变量。JPG 一侧用的是 Pillow 自带的编码器,没有试 mozjpeg 这类带网格量化优化的编码器。同样质量号下它们的体积和振铃都可能不一样。不同编码器对「质量 75」的定义也不完全相同,拿质量号跨编码器比较本来就不严谨。PNG 一侧没有试 oxipng 和 zopflipng 这类会穷举过滤策略的工具。
渲染器同样会影响结果。poppler、浏览器里的 PDF 引擎和桌面软件各有各的抗锯齿和字体光栅化方式。抗锯齿灰阶的分布一变,PNG 的重复度和 JPG 的边缘块都会跟着变。导出的图再发到聊天软件或内容平台会不会被二次压缩,这一轮没有测。
格式兼容性要单独看。WebP 在主流浏览器里早就能用,可一些上传入口、办公软件和打印流程不一定接受。选 WebP 之前要先确认下游。
八 测量方法自身的坑
染灰有三套口径不能混着比
文中一共出现了三套「白底被染灰」的统计。第一套是第六章引用的 11.69%、4.86%、0.40% 那一组。它在全页范围里看原本纯白且离笔画 1 到 3 像素的背景像素,统计编码后偏差超过 8 级的占比。第二套是第二章按块统计的那一组,只看块里原本纯白的像素而不限离笔画多远。第三套是色度采样那一节用的,统计离任何非白像素 1 到 3 像素以内的白像素。
三套口径对笔画的定义和统计范围都不同,数字不能放在一起比。文字页质量 75 时第二套和第三套碰巧都是 11.24%。这只是巧合,并不说明两者是一回事。图表页上就看得出差别,第一套是 10.13% 而第三套是 26.71%。推断差别主要在于彩色柱子算不算笔画。只认深色像素为笔画时,彩色边缘旁边的白像素大多进不了统计范围。第一套的实现细节这里不展开。三套都是自定指标,阈值 8 级也是拍出来的。它们只适合在同一套口径里做相对比较。
第三套的实现里还有一个小毛病。离非白像素的距离是用 np.roll 平移掩码算出来的,平移会从图像另一边绕回来。这份样张四周都是页边空白。绕回来的全是白像素,对结果应该没有影响。换一份满版出血的页面时就得改成补边。
白像素和白底不是一回事
第一章的白底 81% 和 82% 来自 1/4 缩图,判据是三个通道都不低于 250。第二章的白像素 92.1% 和 84.2% 来自原尺寸,判据是三个通道都等于 255。文字页两个数差了 11 个百分点,图表页只差 2 个。推断是缩图时细笔画被平均到了周围的白像素上,一大片白像素就被拉到了 250 以下。密排小字的页面受影响最大。这也正是「文字页的白被笔画切得很碎」的另一个侧面。颜色数 447、2117 和 26914 也是在 1/4 缩图上数的,换成原尺寸会多出很多抗锯齿颜色。这组颜色数还出自另一款渲染器的图,用 poppler 渲染的图再数一遍是 443、2163 和 26938,量级没变。
行过滤实验没算 PNG 文件头
第三章自写的过滤实验只算了过滤后数据流经 zlib 压缩的体积。真正的 PNG 文件还要加上签名、IHDR、IDAT 分块的长度和校验以及 IEND。这些合起来只有几百字节,相对几十万字节可以忽略。拿 664,995 和 Pillow 的 838,404 比是公平的,拿 115,107 和 Pillow 图表页的 127,051 比也大体公平。但 Pillow 内部的 zlib 策略参数可能不同,比如窗口大小或内存级别。那样的话这个差就不全是过滤策略造成的。这一点没有排除。
另外 Pillow 存的 PNG 和 WebP 都来自 poppler 渲染的白底图,而浏览器导出的 PNG 出自另一套渲染和编码。第五章拿导出文件重存时基准换成了导出的像素。第一章、第四章的数和第五章的数基准不同,不能直接相减。
单块手算只是按定义的示意
第二章的三个 8×8 块是照着笔画的样子画出来的,并不是从真实字形里截的。量化表用的是标准亮度表加 IJG 的缩放公式。Pillow 编码时用的应该也是这一套,但没有逐项核对。手算只有亮度,没有色度采样也没有熵编码。它只回答丢了多少系数和偏差多大,不回答多少字节。这一节的作用是把机制讲清楚,结论都以真实编码文件上的块统计为准。
九 还没解决的问题
文字页上不过滤比全用减上边小 13 万字节,比自适应过滤小约 6 万字节。第三章给的解释是字形片段在原始像素里重复而减上边之后被打散。这个解释说得通,可 LZ77 实际匹配到多少长片段并没有去数。它仍然是推断。
浏览器导出的 PNG 为什么落在级别 1 和级别 6 之间,只能从文件推断是压缩偏轻。导出用的是什么编码器和什么参数都没有核实。
纯色块占比当格式判据时阈值定不出来。图表页是 93.0% 而文字页是 75.5%,PNG 的胜负切在两者之间的某处。这个切点可能是 80%,也可能和字号、字体、抗锯齿方式都有关。要回答它需要一批真实文档,一份自制样张是不够的。
WebP 无损在文字页上比调色板 PNG 还小一半多。规范里有好几种可能的手段,具体哪一种贡献最大还没有拆。WebP 有损在彩色边缘上的色晕也没有对照组,因为它按规范就不支持 4:4:4。
参考资料
- ITU-T T.81(JPEG 标准)中离散余弦变换、量化与之字形扫描的部分;IJG libjpeg 里按质量号缩放标准量化表的公式,质量 50 以上时缩放比例为 200 减两倍质量。
- W3C 的 PNG 规范中五种行过滤与过滤方式选择的章节,规范建议调色板图像和低位深图像通常不过滤。
- RFC 1951(DEFLATE),规定 LZ77 匹配长度上限为 258 字节、回溯窗口为 32 KB。
- RFC 9649(WebP 图像格式),有损部分采用 4:2:0 色度采样,无损部分包含空间预测、颜色缓存与 LZ77 回溯。
- WHATWG HTML 标准中 canvas 的 toBlob 与 toDataURL 接口,质量参数只对有损格式生效。
- 样张为自制的 3 页 A4 PDF;照片页的照片来自 Wikimedia Commons 的 CC0 图片,作者 Bonnie Moreland。
- 本文所有体积、PSNR 与染灰数据来自 2026-11-13 的一轮实测,每种存法各跑一次。