最佳解决方案是手动下载并安装 nltk 数据。这里是详细步骤,确保每一步都能正确执行:
步骤 1: 手动下载 stopwords 数据集
下载 stopwords 数据集:
打开浏览器,访问以下链接下载 stopwords 数据集:
stopwords.zip
解压缩 stopwords.zip 文件:
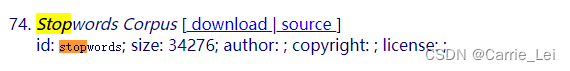
将下载的 stopwords.zip 文件解压到一个文件夹中。
步骤 2: 找到 nltk 数据目录
如果你不确定 nltk 数据目录在哪里,可以使用以下代码来查看可能的路径:
python
import nltk
print(nltk.data.path)
典型路径可能包括:
C:\Users\<你的用户名>\AppData\Roaming\nltk_data
C:\nltk_data
D:\nltk_data
步骤 3: 将 stopwords 数据集放置在 nltk 数据目录中
导航到 nltk 数据目录:
使用文件资源管理器,导航到你找到的 nltk_data 目录。如果不存在,可以创建它。
创建 corpora 目录:
如果 nltk_data 目录中没有 corpora 文件夹,请手动创建一个。
复制 stopwords 文件夹:
将解压后的 stopwords 文件夹复制到 nltk_data/corpora 目录中。
最终目录结构应该如下所示:
scss
nltk_data
└── corpora
    └── stopwords
        ├── english
        ├── french
        ├── german
        └── ... (其他语言的停用词)
步骤 4: 配置 nltk 数据路径并测试
你可以在代码中手动添加 nltk_data 路径,以确保 nltk 能够找到数据:
python
import nltk
from nltk.corpus import stopwords
如果需要的话,手动指定数据路径
nltk.data.path.append('C:\\nltk_data') # 请将路径替换为你的实际路径
加载停用词
stop_words = set(stopwords.words('chinese'))
print(stop_words)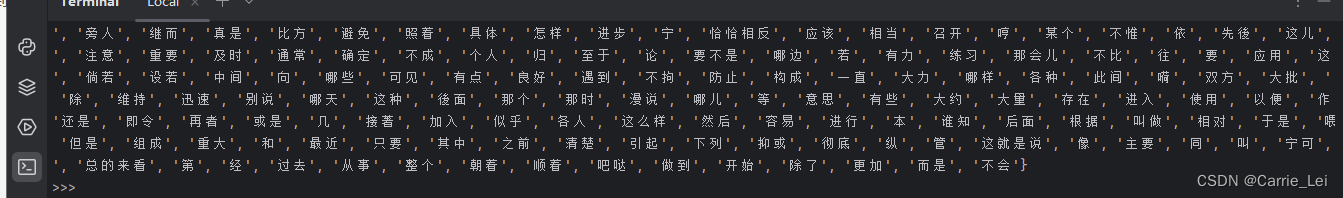
通过以上步骤,你应该可以手动下载并配置 nltk 的数据目录,从而避免网络下载的错误。如果你依然遇到问题,请确保路径和目录结构正确无误。