文章目录
在redis使用过程中,常常遇到以下问题:
- 如何设置Redis键的过期时间?
- 设置完一个键的过期时间后,到了这个时间,这个键还能获取到么?假如获取不到那这个键还占据着内存吗?
- 如何设置Redis的内存大小?当内存满了之后,Redis有哪些内存淘汰策略?我们又该如何选择?
小面就具体聊一聊redis的删除策略和内存淘汰机制
删除策略
设置过期时间的常用命令
Redis提供了四个命令来设置过期时间(生存时间)。
EXPIRE:表示将键 key 的生存时间设置为 ttl 秒。PEXPIRE:表示将键 key 的生存时间设置为 ttl 毫秒。EXPIREAT:表示将键 key 的生存时间设置为 timestamp 所指定的秒数时间戳。PEXPIREAT:表示将键 key 的生存时间设置为 timestamp 所指定的毫秒数时间戳。
在Redis内部实现中,前面三个设置过期时间的命令最后都会转换成最后一个PEXPIREAT 命令来完成。
另外:
PERSIST:表示将key的过期时间移除。TTL:以秒的单位返回键 key 的剩余生存时间。PTTL:以毫秒的单位返回键 key 的剩余生存时间。
过期删除策略
在Redis内部,每当我们设置一个键的过期时间时,Redis就会将该键带上过期时间存放到一个过期字典中。当我们查询一个键时,Redis便首先检查该键是否存在过期字典中,如果存在,那就获取其过期时间。然后将过期时间和当前系统时间进行比对,比系统时间大,那就没有过期;反之判定该键过期
通常删除某个key,我们有如下三种方式进行处理。
- 定时删除:在设置某个key 的过期时间同时,我们创建一个定时器,让定时器在该过期时间到来时,立即执行对其进行删除的操作。
- 惰性删除:设置该key 过期时间后,我们不去管它,当需要该key时,我们在检查其是否过期,如果过期,我们就删掉它,反之返回该key
- 定期删除:每隔一段时间,我们就对一些key进行检查,删除里面过期的key。
Redis的过期删除策略就是:惰性删除和定期删除两种策略配合使用;
惰性删除 :Redis的惰性删除策略由 db.c/expireIfNeeded 函数实现,所有键读写命令执行之前都会调用expireIfNeeded 函数对其进行检查,如果过期,则删除该键,然后执行键不存在的操作;未过期则不作操作,继续执行原有的命令。
定期删除 :由redis.c/activeExpireCycle 函数实现,函数以一定的频率运行,每次运行时,都从一定数量的数据库中取出一定数量的随机键进行检查,并删除其中的过期键。
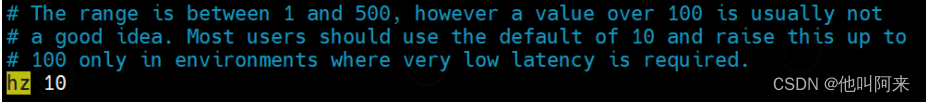
注意:并不是一次运行就检查所有的库,所有的键,而是随机检查一定数量的键。定期删除函数的运行频率,在Redis2.6版本中,规定每秒运行10次,大概100ms运行一次。在Redis2.8版本后,可以通过修改配置文件redis.conf 的 hz 选项来调整这个次数。
内存淘汰
Redis 缓存使用内存来保存数据,避免业务应用从后端数据库中读取数据,可以提升应用的响应速度。
为了保证较高的性价比,缓存的空间容量必然要小于后端数据库的数据总量。不过,内存大小毕竟有限,随着要缓存的数据量越来越大,有限的缓存空间不可避免地会被写满。此时,该怎么办呢?
解决这个问题就涉及到缓存系统的一个重要机制,即缓存数据的淘汰机制。简单来说,数据淘汰机制包括两步:第一,根据一定的策略,筛选出对应用访问来说"不重要"的数据;第二,将这些数据从缓存中删除,为新来的数据腾出空间。
相关设置
设置Redis最大内存
在配置文件redis.conf 中,可以通过参数 maxmemory 来设定最大内存:
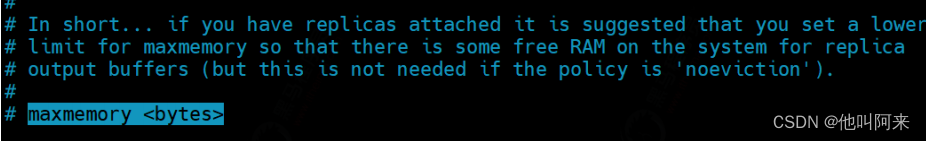
不设定该参数默认是无限制的,但是通常会设定其为物理内存的四分之三
设置淘汰方式
当现有内存大于 maxmemory 时,便会触发redis主动淘汰内存方式,通过设置 maxmemory-policy 有如下几种淘汰方式:
volatile-lru:设置了过期时间的key使用LRU算法淘汰;allkeys-lru:所有key使用LRU算法淘汰;volatile-lfu:设置了过期时间的key使用LFU算法淘汰;allkeys-lfu:所有key使用LFU算法淘汰;volatile-random:设置了过期时间的key使用随机淘汰;allkeys-random:所有key使用随机淘汰;volatile-ttl:设置了过期时间的key根据过期时间淘汰,越早过期越早淘汰;noeviction:默认策略,当内存达到设置的最大值时,所有申请内存的操作都会报错(如set,lpush等),只读操作如get命令可以正常执行;
在缓存的内存淘汰策略中有FIFO、LRU、LFU三种常用算法,其中LRU和LFU是Redis在使用的。
LRU算法
LRU 算法的全称是 Least Recently Used,从名字上就可以看出,这是按照最近最少使用的原则来筛选数据,最不常用的数据会被筛选出来,而最近频繁使用的数据会留在缓存中。
LRU 算法的全称是 Least Recently Used,从名字上就可以看出,这是按照最近最少使用的原则来筛选数据,最不常用的数据会被筛选出来,而最近频繁使用的数据会留在缓存中。
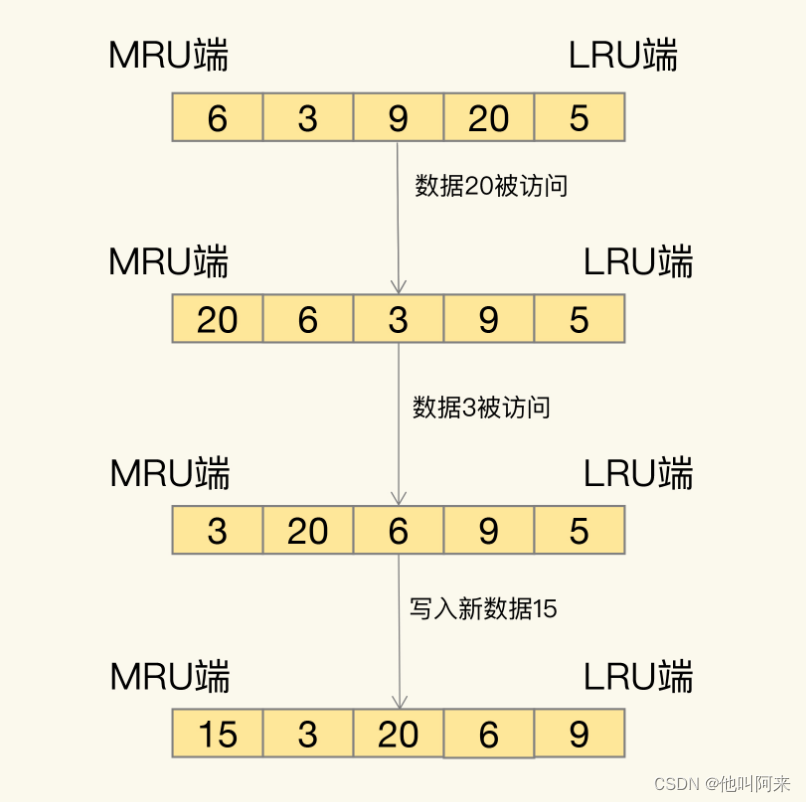
现在有数据 6、3、9、20、5。如果数据 20 和 3 被先后访问,它们都会从现有的链表位置移到 MRU 端,而链表中在它们之前的数据则相应地往后移一位。因为,LRU 算法选择删除数据时,都是从 LRU 端开始,所以把刚刚被访问的数据移到 MRU 端,就可以让它们尽可能地留在缓存中。
如果有一个新数据 15 要被写入缓存,但此时已经没有缓存空间了,也就是链表没有空余位置了,那么,LRU 算法做两件事:
1、数据15是刚被访问的,所以他会被放到MRU端
2、算法把LRU端的数据5从缓冲中删除
LRU 算法在实际实现时,需要用链表管理所有的缓存数据,这会带来额外的空间开销。而且,当有数据被访问时,需要在链表上把该数据移动到 MRU 端,如果有大量数据被访问,就会带来很多链表移动操作,会很耗时,进而会降低 Redis 缓存性能。所以,在 Redis 中,LRU 算法被做了简化,以减轻数据淘汰对缓存性能的影响。
具体来说,Redis 默认会记录每个数据的最近一次访问的时间戳(由键值对数据结构RedisObject 中的 lru 字段记录)。然后,Redis 在决定淘汰的数据时,第一次会随机选出N 个数据,把它们作为一个候选集合。接下来,Redis 会比较这 N 个数据的 lru 字段,把lru 字段值最小的数据从缓存中淘汰出去。
Redis 提供了一个配置参数 maxmemory-samples,这个参数就是 Redis 选出的数据个数N。例如,我们执行如下命令,可以让 Redis 选出 100 个数据作为候选数据集:
java
CONFIG SET maxmemory-samples 100当需要再次淘汰数据时,Redis 需要挑选数据进入第一次淘汰时创建的候选集合。这儿的挑选标准是:能进入候选集合的数据的 lru 字段值必须小于候选集合中最小的 lru 值。当有新数据进入候选数据集后,如果候选数据集中的数据个数达到了 maxmemory-samples,Redis 就把候选数据集中 lru 字段值最小的数据淘汰出去。这样一来,Redis 缓存不用为所有的数据维护一个大链表,也不用在每次数据访问时都移动链表项,提升了缓存的性能。
但在LRU算法下,如果一个热点数据最近很少访问,而非热点数据近期访问了,就会误把热点数据淘汰而留下了非热点数据,因此在Redis4.x中新增了LFU算法。
LFU
LFU(Least Frequently Used)表示最不经常使用,它是根据数据的历史访问频率来淘汰数据,其核心思想是"如果数据过去被访问多次,那么将来被访问的频率也更高"。
LFU 缓存策略是在 LRU 策略基础上,为每个数据增加了一个计数器,来统计这个数据的访问次数。当使用 LFU 策略筛选淘汰数据时,首先会根据数据的访问次数进行筛选,把访问次数最低的数据淘汰出缓存。如果两个数据的访问次数相同,LFU 策略再比较这两个数的访问时效性,把距离上一次访问时间更久的数据淘汰出缓存。
和那些被频繁访问的数据相比,扫描式单次查询的数据因为不会被再次访问,所以它们的访问次数不会再增加。因此,LFU 策略会优先把这些访问次数低的数据淘汰出缓存。
那么,LFU 策略具体又是如何实现的呢?
上面可以直到,redis 在实现 LRU 策略时使用了两个近似方法:
- Redis 是用 RedisObject 结构来保存数据的,RedisObject 结构中设置了一个 lru 字段,用来记录数据的访问时间戳;
- Redis 并没有为所有的数据维护一个全局的链表,而是通过随机采样方式,选取一定数量(例如 10 个)的数据放入候选集合,后续在候选集合中根据 lru 字段值的大小进行筛选。
在此基础上,Redis在实现LFU策略的时候,只是把原来24bit大小的lru字段,又进一步拆分成了两部分:
- ldt值:lru字段的前16bit,表示数据的访问时间戳
- counter值:lru字段的后8bit,表示数据的访问次数
总结以下:当LFU帅选数据时,Redis会在候选集合中,根据数据lru字段后的8bit选择访问次数最少的数据进行淘汰,当访问数据相同时,在跟进lru字段的前16bit值大小,选择访问时间最久远的数据进行淘汰。
总结
Redis过期删除策略是采用惰性删除和定期删除这两种方式组合进行的,惰性删除能够保证过期的数据我们在获取时一定获取不到,而定期删除设置合适的频率,则可以保证无效的数据及时得到释放,而不会一直占用内存数据。
但是我们说Redis是部署在物理机上的,内存不可能无限扩充的,当内存达到我们设定的界限后,便自动触发Redis内存淘汰策略,而具体的策略方式要根据实际业务情况进行选取。