Js逆向爬虫基础篇

这里写自定义目录标题

  • 逆向技巧
    • 断点
    • [一 、请求入口定位](#一 、请求入口定位)
      • [1. 关键字搜索](#1. 关键字搜索)
      • [2. 请求堆栈](#2. 请求堆栈)
      • [3. hook](#3. hook)
      • [4. JSON.stringify](#4. JSON.stringify)
    • 二、响应入口定位:
      • [1. 关键字搜索](#1. 关键字搜索)
      • [2. hook](#2. hook)
      • [3. JSON.parse](#3. JSON.parse)

逆向技巧

断点

  1. 普通断点

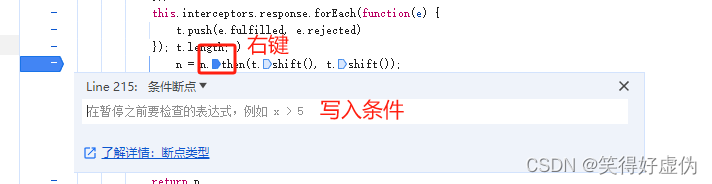
  2. 条件断点

  3. 日志断点

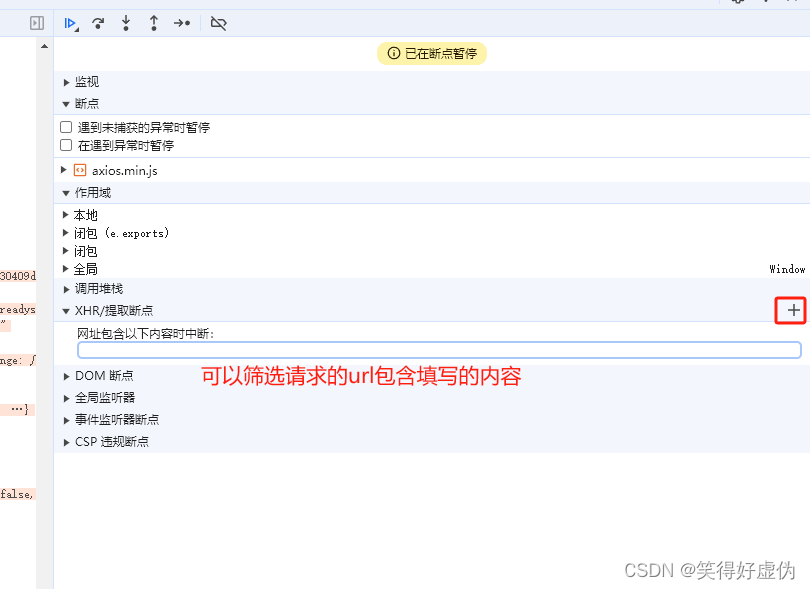
  4. XHR断点

一 、请求入口定位

1. 关键字搜索

复制代码
	 key关键字
	 方法关键字: encrypt  decrypt
   . headers关键字
	 路径关键字
		 interceptors:
		      interceptors.request.use(fn1)
		      interceptors.request.use(fn2)
		      interceptors.response.use(fn3)
		      interceptors.response.use(fn3)
		      n = n.then(t.shift(), t.shift());

2. 请求堆栈

3. hook

4. JSON.stringify

二、响应入口定位:

1. 关键字搜索

2. hook

3. JSON.parse

相关推荐
禹凕1 小时前
机器学习之Selenium(Machina Learning about Selenium)
爬虫·python·selenium·测试工具·机器学习
梅雅达编程笔记7 小时前
02_BeautifulSoup网页数据提取
开发语言·爬虫·python·beautifulsoup·数据采集
零域码客10 小时前
零基础Python爬虫入门:从HTTP协议到 requests + BeautifulSoup 实战
爬虫·python·http
TomEval10 小时前
【测AI】第05篇:Python 爬虫进阶 —— 动态页面爬取与 Scrapy 框架
人工智能·爬虫·python·scrapy·自动化
老王生涯1 天前
针对cloudflare防护的爬虫策略——CDP
爬虫·cloudflare·cdp·反爬
禹凕1 天前
机器学习之数据清洗(Machine Learning about Data Cleaning)
人工智能·爬虫·python·机器学习·数据挖掘
数据狐(Datafox)1 天前
淘宝商品详情API实战:多语言代购商城自动同步数据完整方案
开发语言·前端·数据库·爬虫·json
梅孔立8 天前
Fiddler 工具安装抓包 教程 https
爬虫
feasibility.8 天前
MediaCrawler媒体采集平台安装与使用
爬虫·抖音·小红书·微博·bili
Patrick在香港9 天前
Claude 工具调用返回空:8 次失败里只有 1 次状态码不对,其余全带 200
爬虫·python·api·claude·香港