Reids数据类型指的是value的类型,key都是字符串
redis-server:启动redis服务
redis-cli:进入redis交互式终端
常用的key的操作
redis的命令和参数不区分大小写 ,key和value区分
-
查看当前库所有的key
shellkeys * -
判断某个key是否存在
redisexists key -
查看key是什么类型
shelltype key -
删除指定的key
shelldel key -
非阻塞删除,仅将key从keyspace元数据中删除,真正的删除会在后续异步中操作
shellunlink key -
查看key还有多少秒到期,-1表示永不过期,-2表示已经过去,未过期则显示对应的秒数
shellttl key -
设置过期时间-秒
shellexpire key 秒 -
将当前数据库的key移动到指定的库中,0~15,redis默认16个库,默认使用的0号库
shellmove 要移动的key 索引 -
切换数据库,0-15,默认是0
shellselect 数据库索引 -
查看当前数据库的key的数量
shelldbsize -
清空当前库
shellflushdb -
清空全部库
shellflushall -
获取指定类型的帮助信息
shellhelp @string
字符串String
string是redis最基本的类型,一个key对应一个value,一个value最多可以是512M,string类型是二进制安全的,可以包含任何数据,包括jpg图片或者序列化对象
基本使用
使用set设置string类型的key和value
shell
set key value [NX|XX] [GET] [EX seconds|PX milliseconds|EXAT unix-time-seconds|PXAT unix-time-milliseconds|KEEPTTL]除了key和value,其他为可选参数
-
[NX|XX]shell# NX:键不存在的时候设置键和值 127.0.0.1:6379> set k1 v1 nx OK 127.0.0.1:6379> set k1 v1 nx (nil)shell# XX:键存在的时候设置值 127.0.0.1:6379> set k1 val1 xx OK 127.0.0.1:6379> set k2 val1 xx (nil) -
GET
shell# 先返回旧的值,然后设置新的值,如果key不存在,则返回的时候是nil 127.0.0.1:6379> set k1 v1 OK 127.0.0.1:6379> set k1 v2 get "v1" 127.0.0.1:6379> get k1 "v2" -
EX seconds\|PX milliseconds\|EXAT unix-time-seconds\|PXAT unix-time-milliseconds\|KEEPTTL
shell# EX seconds 以秒为单位设置过期时间 set k1 v1 ex 10shell# PX milliseconds:以毫秒为单位设置过期时间 set k1 v1 px 10000shell# EXAT timestamp:设置以秒为单位的UNIX时间戳所对应的时间为过期时间 set k1 v1 exat 1734686421 #秒级的过期时间戳shell# PXAT milliseconds-timestamp:设置以毫秒为单位的UNIX时间戳所对应的时间为过期时间 set k1 v1 pxat 1734686421000 #毫秒级的过期时间戳shell# KEEPTTL:保留设置前指定键的生存时间 # 一个已存在的key只要进行set,就会覆盖掉之前设置的过期时间,KEEPTTL可以继续继承之前的过期时间 127.0.0.1:6379> set k1 v1 ex 100 OK 127.0.0.1:6379> ttl k1 (integer) 98 127.0.0.1:6379> set k1 v2 keepttl OK 127.0.0.1:6379> ttl k1 (integer) 83
批量操作
-
MSET批量进行key-value的设置shell127.0.0.1:6379> mset k1 v1 k2 v2 k3 v3 OK -
MGET批量进行获取操作shell127.0.0.1:6379> mget k1 k2 k3 1) "v1" 2) "v2" 3) "v3" -
MSETNX:批量进行key-value的设置,只有key都不存在时数据会设置成功shell127.0.0.1:6379> mset k1 v1 k2 v2 OK 127.0.0.1:6379> msetnx k2 v2 k3 v3 (integer) 0 127.0.0.1:6379> msetnx k3 v3 k4 v4 (integer) 1
获取和修改指定区间范围内的值
-
getrange key start end:获取指定key的值的指定下标范围的数据,如果下标范围是0和-1,就是获取全部shell127.0.0.1:6379> set k1 k123456 OK 127.0.0.1:6379> getrange k1 0 3 "k123" -
setrange key offset value:用指定的字符串覆盖指定key中字符串值的一部分,`offset表示从哪个位置开始覆盖shell127.0.0.1:6379> set k1 v12345678 OK 127.0.0.1:6379> setrange k1 3 a # 根据新的value覆盖指定value位置的数据 (integer) 9 127.0.0.1:6379> get k1 "v12a45678" 127.0.0.1:6379> setrange k1 3 hhhhhhhhh # 根据新的value覆盖指定value位置的数据 (integer) 12 127.0.0.1:6379> get k1 "v12hhhhhhhhh"
数值增减
只有value是纯数字的时候才可以操作增减
-
INCR:自增,每次自增1shell127.0.0.1:6379> set k1 10 OK 127.0.0.1:6379> incr k1 (integer) 11 127.0.0.1:6379> incr k1 (integer) 12 127.0.0.1:6379> get k1 "12" -
incrby key increment:增加指定的数值shell127.0.0.1:6379> set k1 10 OK 127.0.0.1:6379> incrby k1 100 # 给k1加100 (integer) 110 127.0.0.1:6379> get k1 "110" -
DECR:自减shell127.0.0.1:6379> set k1 10 OK 127.0.0.1:6379> decr k1 (integer) 9 -
DECRBY key decrement:减少指定的数值shell127.0.0.1:6379> set k1 10 OK 127.0.0.1:6379> decrby k1 5 (integer) 5
获取字符串长度和内容追加
STRLEN获取字符串长度,APPEND用于在字符串后面追加数据
shell
127.0.0.1:6379> set k1  a12345
OK
127.0.0.1:6379> strlen k1 #获取长度
(integer) 6
127.0.0.1:6379> append k1 6 #追加
(integer) 7
127.0.0.1:6379> get k1
"a123456"
setnx和setex
下面两个命令的重要使用场景就是分布式锁的实现,这里只有基本使用,不涉及分布式锁的实现
-
setnx key value:当key不存在的时候,设置key-value,相当于set后面设置nx选项参数shellsetnx k1 v1 -
setex key seconds value:设置键值对并且同时设置过期时间的命令,相当于set后面设置ex选项参数shellsetex k1 10 v1
getset
先获取旧值,再设置新值,相当于set命令后加get选项参数
shell
127.0.0.1:6379> set k1 100
OK
127.0.0.1:6379> getset k1 aaa
"100"
127.0.0.1:6379> get k1
"aaa"
列表List
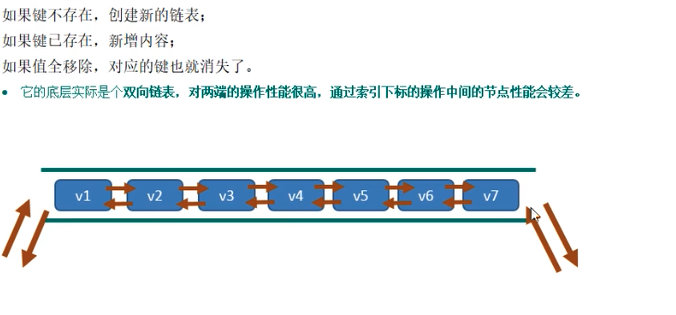
列表是在简单的字符串列表,按照插入顺序排序,可以添加元素到列表头部或者尾部,最多可以保存2^32-1个元素(超40亿),单key多value,且value可以重复
-
lpush:从左侧插入元素shelllpush list1 1 2 3 -
rpush:从右侧插入元素shellrpush list1 1 2 3 -
lrange key start stop:从左侧开始根据下标取值shelllrange list1 0 -1 -
lpop:弹出最左侧的元素,弹出的元素从原列表消失lpop list1 -
rpop:弹出最右侧的元素,弹出的元素从原列表消失shellrpop list1 -
lindex key index:按照索引下标(从左到右)根据获取元素shelllindex list1 0 -
llen:获取列表中元素的个数shellllen list1 -
lrem key count element:从左到右删除对应列表中指定数量的指定value的元素shell127.0.0.1:6379> lpush list1 v1 v2 v1 v3 v4 v5 (integer) 6 127.0.0.1:6379> lrem list1 2 v1 #从左到右,删除元素是v1的两个值 (integer) 2shell127.0.0.1:6379> lpush list2 v1 v1 v1 v2 v3 (integer) 5 127.0.0.1:6379> lrem list2 0 v1 # 0 代表删除元全部指定的值 (integer) 3 -
ltrim key start stop:截取指定范围的值后再赋值原列表shell127.0.0.1:6379> rpush list3 1 2 3 4 5 (integer) 5 127.0.0.1:6379> ltrim list3 0 2 OK 127.0.0.1:6379> lrange list3 0 -1 1) "1" 2) "2" 3) "3" -
rpoplpush source destination:移除列表(source)最后一个元素,将该元素添加到另一个列表(destination)并返回shell127.0.0.1:6379> lpush i1 1 2 3 4 5 6 7 (integer) 7 127.0.0.1:6379> lpush i2 a b c (integer) 3 127.0.0.1:6379> rpoplpush i1 i2 "1" 127.0.0.1:6379> lrange i1 0 -1 1) "7" 2) "6" 3) "5" 4) "4" 5) "3" 6) "2" 127.0.0.1:6379> lrange i2 0 -1 1) "1" 2) "c" 3) "b" 4) "a" -
lset key index element:将指定数组集合的下标位置值替换成新值shell127.0.0.1:6379> lrange i1 0 -1 1) "7" 2) "6" 3) "5" 4) "4" 5) "3" 6) "2" 127.0.0.1:6379> lset i1 3 n OK 127.0.0.1:6379> lrange i1 0 -1 1) "7" 2) "6" 3) "5" 4) "n" 5) "3" 6) "2" -
linsert key BEFORE|AFTER pivot element:从左侧开始在指定下标之前/之后插入新的值shell127.0.0.1:6379> lrange list 0 -1 1) "5" 2) "4" 3) "3" 4) "2" 5) "1" 127.0.0.1:6379> linsert list before 2 a #从左侧开始,在指定下标之前插入新的值 (integer) 6 127.0.0.1:6379> lrange list 0 -1 1) "5" 2) "4" 3) "3" 4) "a" 5) "2" 6) "1" 127.0.0.1:6379> linsert list after 2 b (integer) 7 127.0.0.1:6379> lrange list 0 -1 # 从左侧开始,在指定下标之后插入新的值 1) "5" 2) "4" 3) "3" 4) "a" 5) "2" 6) "b" 7) "1"
哈希表Hash
hash是一个string类型的field(字段)和value(值)的映射表,kv模式不变,但是V是一个键值对,特别适用于存储对象,每个hash可以存储2^32-1个元素(超40亿)键值对
shell
127.0.0.1:6379> hset user:1 id 1 name 23  age 26  # 设置key为user:1的哈希结构
(integer) 3
127.0.0.1:6379> hget user:1 id # 获取key为user:1 的 里面id字段的值
"1"
127.0.0.1:6379> hget user:1 name # 获取key为user:1 的 里面name字段的值
"23"
shell
 # 当前版本hmset和hset功能一样
 # 老版本应该是hset设置value只能一次设置一个字段,hmset设置多个字段
127.0.0.1:6379> hmset user:2 name 2 age 3
OK
127.0.0.1:6379> hmget user:2 name age  # 批量获取
1) "2"
2) "3"
shell
127.0.0.1:6379> hgetall user:1  #获取指定key的全部字段和值
1) "id"
2) "1"
3) "name"
4) "23"
5) "age"
6) "26"
127.0.0.1:6379> hdel user:1 name  # 删除指定key里面的指定数据
(integer) 1
shell
127.0.0.1:6379> hexists user:1 id  # 判断指定key里面某个字段是否存在
(integer) 1
127.0.0.1:6379> hkeys user:1  # 获取指定key所有字段
1) "id"
2) "age"
127.0.0.1:6379> hvalues user:1 # 获取指定key所有字段的值
1) "1"
2) "26"
shell
127.0.0.1:6379> hset user:5 age 20  score 99.5
(integer) 2
127.0.0.1:6379> hincrby user:5 age 2  # 对整数的值+2
(integer) 22
127.0.0.1:6379> hincrbyfloat user:5 score 0.5 # 对小数的值进行增加0.5
"100"
127.0.0.1:6379> hsetnx user5 k1 v1 # 当指定key里面指定字段不存在的时候生效
(integer) 1
集合Set
Set 是 String 类型的无序集合。集合成员是唯一的,这就意味着集合中不能出现重复的数据,集合对象的编码可以是 intset 或者 hashtable,集合是通过哈希表实现的,所以添加,删除,查找的复杂度都是 O(1),集合中最大的成员数为 2^32 - 1 (4294967295, 每个集合可存储40多亿个成员),单key多value,且value不能重复
shell
127.0.0.1:6379> sadd set1 1 2 3 2 4 5 6 # 向key为set1的集合添加对应元素,如果有重复的值不会添加
(integer) 6
127.0.0.1:6379> SMEMBERS set1 # 遍历集合中的所有元素
1) "1"
2) "2"
3) "3"
4) "4"
5) "5"
6) "6"
shell
127.0.0.1:6379> sismember set1 3 # 查看集合中是否存在3 存在是1 不存在是0
(integer) 1
127.0.0.1:6379> sismember set1 10
(integer) 0
shell
127.0.0.1:6379> srem set1  2 # 删除集合里值是2的元素
(integer) 1
shell
127.0.0.1:6379> scard set1 # 获取集合元素个数
(integer) 5
shell
127.0.0.1:6379> srandmember set1  2 # 从集合里随机弹出2个元素,元素不会删除
1) "5"
2) "1"
127.0.0.1:6379> spop set1 2 # 从集合里随机弹出2个元素,元素会删除
1) "4"
2) "5"
shell
127.0.0.1:6379> sadd set2 1 2 3 4 5 6
(integer) 6
127.0.0.1:6379> sadd set3 7 8 9
(integer) 3
127.0.0.1:6379> smove set2 set3 6  # 将set2里面值是6的元素赋值给set3
(integer) 1
127.0.0.1:6379> smembers set3
1) "6"
2) "7"
3) "8"
4) "9"
127.0.0.1:6379> smembers set2
1) "1"
2) "2"
3) "3"
4) "4"
5) "5"
shell
#差集运算-属于A集合但是不属于B集合的元素构成的集合
127.0.0.1:6379> sadd set3 1 2 3 a b
(integer) 5
127.0.0.1:6379> sadd set4 2 3 4 b c
(integer) 5
127.0.0.1:6379> sdiff set3 set4
1) "1"
2) "a"
shell
#并集运算-属于A或者属于B的元素构成的集合
127.0.0.1:6379> sunion set3 set4
1) "1"
2) "2"
3) "3"
4) "a"
5) "b"
6) "4"
7) "c"
shell
#交集运算-属于A同时也属于B的共同拥有的元素构成的集合
127.0.0.1:6379> sadd set1 1 2 3 a b c
(integer) 6
127.0.0.1:6379> sadd set2 2 3 4 b c d
(integer) 6
127.0.0.1:6379> sinter set1 set2
1) "2"
2) "3"
3) "b"
4) "c"
shell
#交集运算-不返回结果集,返回结果的基数,返回由所有给定集合的交集产生的集合的基数
# 两个key  set1 和set2 交集去重后的结果数
127.0.0.1:6379> sintercard 2 set1 set2
(integer) 4
有序集合Zset
zset 和 set 一样也是string类型元素的集合,且不允许重复的成员,不同的是每个元素都会关联一个double类型的分数,redis正是通过分数来为集合中的成员进行从小到大的排序,zset的成员是唯一的,但分数(score)却可以重复,zset集合是通过哈希表实现的,所以添加,删除,查找的复杂度都是 O(1)。 集合中最大的成员数为 2^32 - 1
zadd key [NX|XX] [GT|LT] [CH] [INCR] score member [score member ...]
shell
127.0.0.1:6379> zadd zset1 100 k1 200 k2 300 k3  # zadd key 分数 key  分数 key
(integer) 3
127.0.0.1:6379> zrange zset1 0 -1  # 不带分数遍历所有元素
1) "k1"
2) "k2"
3) "k3"
127.0.0.1:6379> zrange zset1 0 -1 withscores #带分数遍历所有元素
1) "k1"
2) "100"
3) "k2"
4) "200"
5) "k3"
6) "300"
zrevrange key start stop [WITHSCORES]
shell
# 反转集合,按照元素分数从大到小的顺序返回索引从start到stop之间的所有元素
127.0.0.1:6379> zrevrange zset1 0 -1 withscores
1) "k3"
2) "300"
3) "k2"
4) "200"
5) "k1"
6) "100"
127.0.0.1:6379> zrevrange zset1 0 -1
1) "k3"
2) "k2"
3) "k1"
zrangebyscore key min max [WITHSCORES] [LIMIT offset count]
shell
#获取指定分数范围的元素
127.0.0.1:6379> zrangebyscore zset1 100 200 withscores
1) "k1"
2) "100"
3) "k2"
4) "200"
127.0.0.1:6379> zrangebyscore zset1 (100 200 withscores # (表示不包含,相当于大于100 小于等于200
1) "k2"
2) "200"
127.0.0.1:6379> zrangebyscore zset1 (100 300 withscores limit 0 1 #limit限制范围
1) "k2"
2) "200"
shell
127.0.0.1:6379> zscore zset1 k1 #获取指定元素的分数
"100
shell
127.0.0.1:6379> zcard zset1 # 获取元素的数量
(integer) 3
shell
# zrem key member [member ...]
127.0.0.1:6379> zrem zset1 k1  #删除指定元素
(integer) 1
shell
# zincrby key increment member 增加某个元素的分数
127.0.0.1:6379> zincrby zset1 3 k2
"203"
shell
#  zcount key min max 获取指定分数范围内的元素个数
127.0.0.1:6379> zcount zset1 100 300
(integer) 2
shell
# zmpop numkeys key [key ...] MIN|MAX [COUNT count]
# 从键名列表中的第一个和非空排序集中弹出一个或多个元素,成员分数对
127.0.0.1:6379> zadd set1 100 one 200 two 300 three
(integer) 3
# key的数量 1个,从set1中,弹出最小的一个(也可以是多个),弹出后从zset移除
127.0.0.1:6379> zmpop 1 set1 min count 1
1) "set1"
2) 1) 1) "one"
      2) "100"

# key的数量 1个,从set1中,弹出最大的一个,弹出后从zset移除
127.0.0.1:6379> zmpop 1 set1 max count 1
1) "set1"
2) 1) 1) "three"
      2) "300"
shell
# zrank key member [WITHSCORE] 通过元素名获取下标值
127.0.0.1:6379> zrank zset1 k3
(integer) 1
shell
# zrevrank key member [WITHSCORE]  通过元素名逆序获得下标值
127.0.0.1:6379> zrevrank zset1 k3
(integer) 0
位图 bitmap
由0和1状态表现的二进制位的bit数组
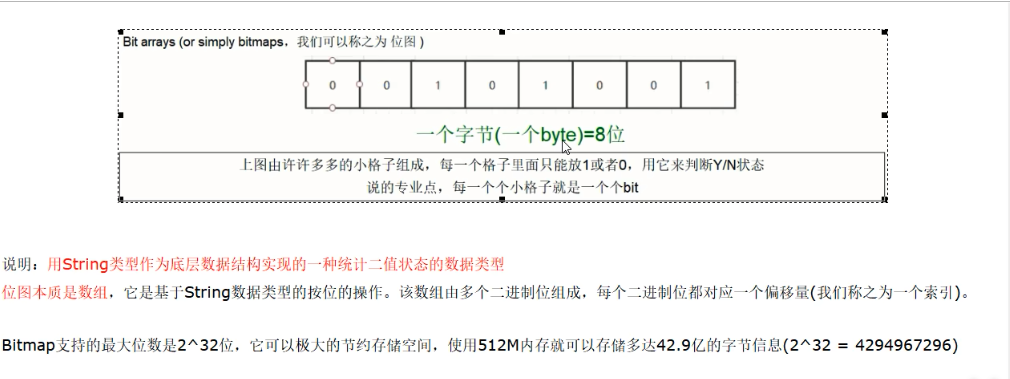
shell
# setbit key offset value  设置位图对应偏移量位置的值(只能是0和1)
127.0.0.1:6379> setbit k1 0 1
(integer) 0
127.0.0.1:6379> setbit k1 1 1
(integer) 0
127.0.0.1:6379> setbit k1 2 0
(integer) 0
127.0.0.1:6379> type k1 # bitmap的底层是string类型
string
shell
# getbit key offset 获取指定偏移量的值
127.0.0.1:6379> getbit k1 0
(integer) 1
shell
# 统计占用多少字节数,不是字符串长度而是占据几个字节,超过8位后自己按照8位一组一byte再扩容
127.0.0.1:6379> strlen k1
(integer) 1
shell
# bitcount key [start end [BYTE|BIT]] 全部key里包含1的有多少个
127.0.0.1:6379> bitcount u1 0 -1
(integer) 2
shell
# bitop AND|OR|XOR|NOT destkey key [key ...]
# 可以对一个或多个二进制位序列进行位运算操作。这些位运算包括AND、OR、XOR(异或)和NOT


# 偏移量对应用户id
127.0.0.1:6379> setbit login_one 1 1
(integer) 0
127.0.0.1:6379> setbit login_one 2 1
(integer) 0
127.0.0.1:6379> setbit login_one 3 1
(integer) 0
127.0.0.1:6379> setbit login_one 4 0
127.0.0.1:6379> setbit login_t 1 1
(integer) 0
127.0.0.1:6379> setbit login_t 2 0
(integer) 0
127.0.0.1:6379> setbit login_t 3 1
(integer) 0
127.0.0.1:6379>
# 筛选两天都登录的用户
127.0.0.1:6379> bitop AND login_sum login_one login_t # login_sum是计算后的数据位图
(integer) 1
127.0.0.1:6379> getbit login_sum 1  # 查看用户1是否两天都登录
(integer) 1
127.0.0.1:6379> getbit login_sum 2  # 查看用户2是否两天都登录
(integer) 0
基数统计 HyperLogLog
HyperLogLog 是用来做基数统计的算法,HyperLogLog 的优点是,在输入元素的数量或者体积非常非常大时,计算基数所需的空间总是固定且是很小的。
在 Redis 里面,每个 HyperLogLog 键只需要花费 12 KB 内存,就可以计算接近 2^64 个不同元素的基 数。这和计算基数时,元素越多耗费内存就越多的集合形成鲜明对比。
因为 HyperLogLog 只会根据输入元素来计算基数,而不会储存输入元素本身,所以 HyperLogLog 不能像集合那样,返回输入的各个元素
HyperLogLog 的优点是,在输入元素的数量或者体积非常非常大时,计算基数所需的空间总是固定的、并且是很小的。在Redis里面,每个 HyperLogLog键只需要花费12KB内存,就可以计算接近2^64个不同元素的基数。这和计算基数时,元素越多耗费
内存就越多的集合形成鲜明对比。
但是,因为HyperLogLog只会根据输入元素来计算基数,而不会储存输入元素本身,所以HyperLogLog不能像集合那样,返回输入的各个元素
shell
127.0.0.1:6379> pfadd h1101  1 2 2 3 4 5 6 7  # 添加元素
(integer) 1
127.0.0.1:6379> pfadd h1102   3 4 5 6 7 8 9 10
(integer) 1
127.0.0.1:6379> pfcount h1101  # 去重后的元素个数
(integer) 7
127.0.0.1:6379> pfmerge result h1101 h1102   #将多个HyperLogLog合并成一个
OK
127.0.0.1:6379> pfcount result # 合并去重后的元素个数
(integer) 10
地理空间 GEO
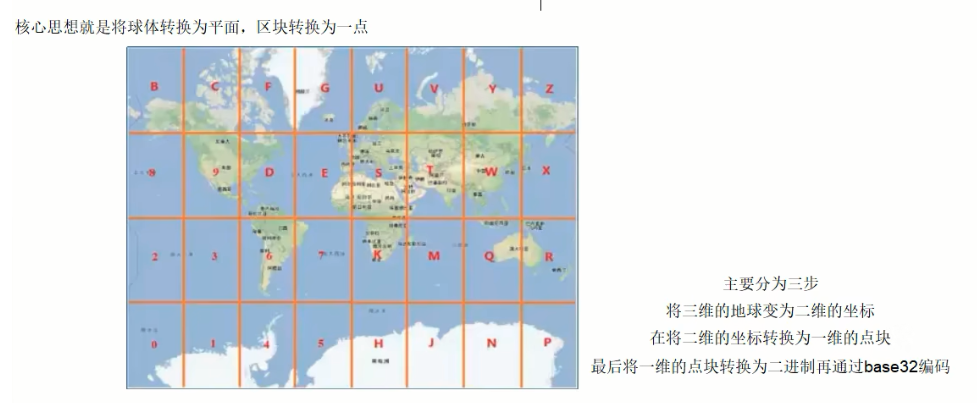
主要用于存储地理位置信息,并对存储的信息进行操作,包括添加地理位置的坐标、获取地理位置的坐标、计算两个位置之间的距离,根据用户给定的经纬度坐标来获取指定范围内的地理位置集合
shell
# geoadd key [NX|XX] [CH] longitude latitude member [longitude latitude member ...]
# geoadd用于存储指定的地理空间位置,可以存储一个或多个经度(longitude)纬度(latitude) 位置名称(member)
127.0.0.1:6379> geoadd beijing 116.333585 0.008944 "清华" 116.317547   39.99887   "北大"
(integer) 2
shell
127.0.0.1:6379> type beijing  # 底层是zset结构
zset
127.0.0.1:6379> zrange beijing 0 -1  #遍历所有
1) "\xe6\xb8\x85\xe5\x8d\x8e"
2) "\xe5\x8c\x97\xe5\xa4\xa7"
# 中文乱码问题:启动的时候 使用 redis-cli -a 111111 --raw解决中文乱码问题
127.0.0.1:6379> zrange beijing 0 -1 withscores
清华
3976420988276928
北大
4069880723579868
shell
# geopos key [member [member ...]] 返回经纬度坐标
127.0.0.1:6379> geopos beijing "清华"  "北大"
116.33358746767044067
0.00894376361072347
116.31754785776138306
39.99886942521209932
127.0.0.1:6379>
shell
# geodist key member1 member2 [M | KM | FT | MI ] 计算两个位置之间的距离
127.0.0.1:6379> geodist beijing  "清华"  "北大"
4447931.7663 # 默认是米,根据选项参数设定单位
shell
# georadius key longitude latitude radius M|KM|FT|MI [WITHCOORD] [WITHDIST] [WITHHASH] [COUNT count [ANY]] [ASC|DESC] [STORE key|STOREDIST key]

# 以给定的经纬度为中心,返回与中心的距离不超过给定最大距离的所有元素位置,WITHDIST: 在返回位置元素的同时, 将位置元素与中心之间的距离也一并返回。 距离的单位和用户给定的范围单位保持一致。 WITHCOORD: 将位置元素的经度和维度也一并返回。 WITHHASH:以 52 位有符号整数的形式, 返回位置元素经过原始 geohash 编码的有序集合分值。 这个选项主要用于底层应用或者调试,实际中的作用并不大 COUNT 限定返回的记录数

127.0.0.1:6379> georadius beijing 116.319769 39.976546 100 km withcoord withhash count 10 desc
北大
4069880723579868
116.31754785776138306
39.99886942521209932
shell
# georadiusbymember key member radius M|KM|FT|MI [WITHCOORD] [WITHDIST] [WITHHASH] [COUNT count [ANY]] [ASC|DESC] [STORE key|STOREDIST key]
# 和georadius类似,区别是不需要提供具体的经纬度,而是提供成员
127.0.0.1:6379> georadiusbymember beijing "清华" 100 km withcoord withhash count 10 desc
清华
3976420988276928
116.33358746767044067
0.00894376361072347
流 Stream
基本理论
主要用于消息队列(MQ,Message Queue),Redis 本身是有一个 Redis 发布订阅 (pub/sub) 来实现消息队列的功能,但它有个缺点就是消息无法持久化,如果出现网络断开、Redis 宕机等,消息就会被丢弃。
简单来说发布订阅 (pub/sub) 可以分发消息,但无法记录历史消息。而 Redis Stream 提供了消息的持久化和主备复制功能,可以让任何客户端访问任何时刻的数据,并且能记住每一个客户端的访问位置,还能保证消息不丢失
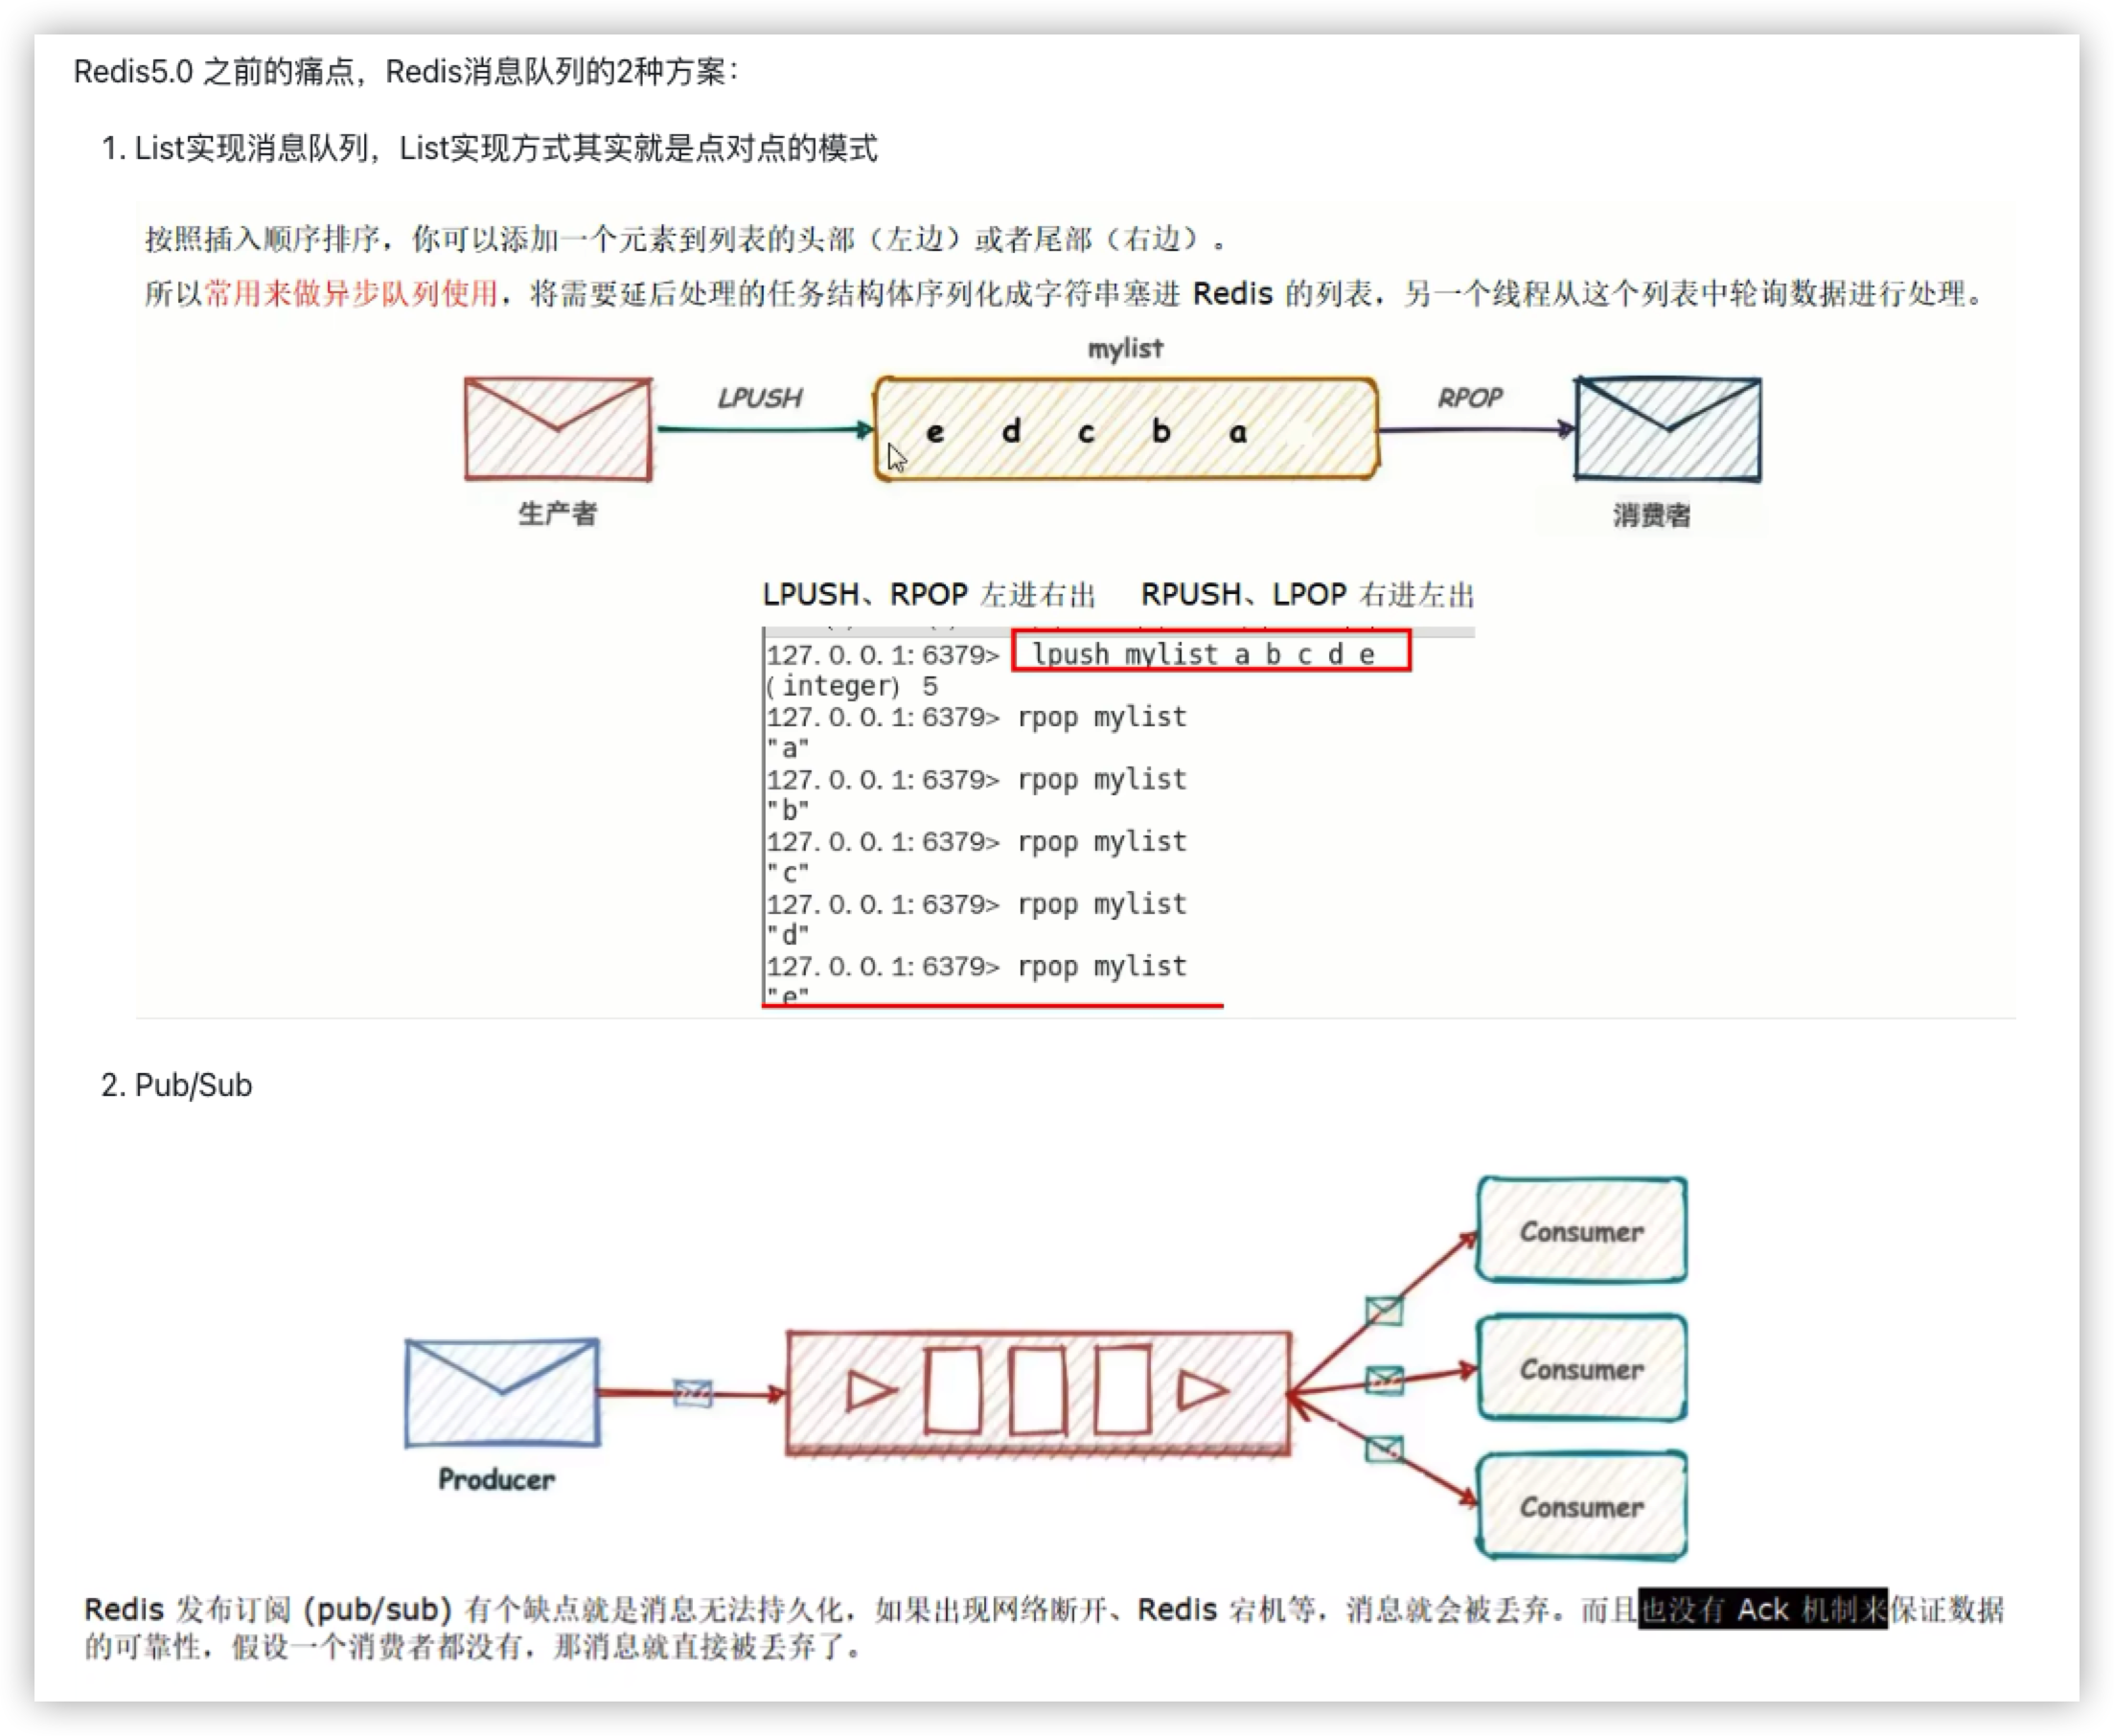
Redis5.0版本新增了一个更强大的数据结构---Strea,Stream流就是Redis版的MQ消息中间件+阻塞队列,支持消息的持久化,支持自动生成全局唯一id,支持ack确认消息的模式、消防组模式等等,让消息队列更加稳定和可靠
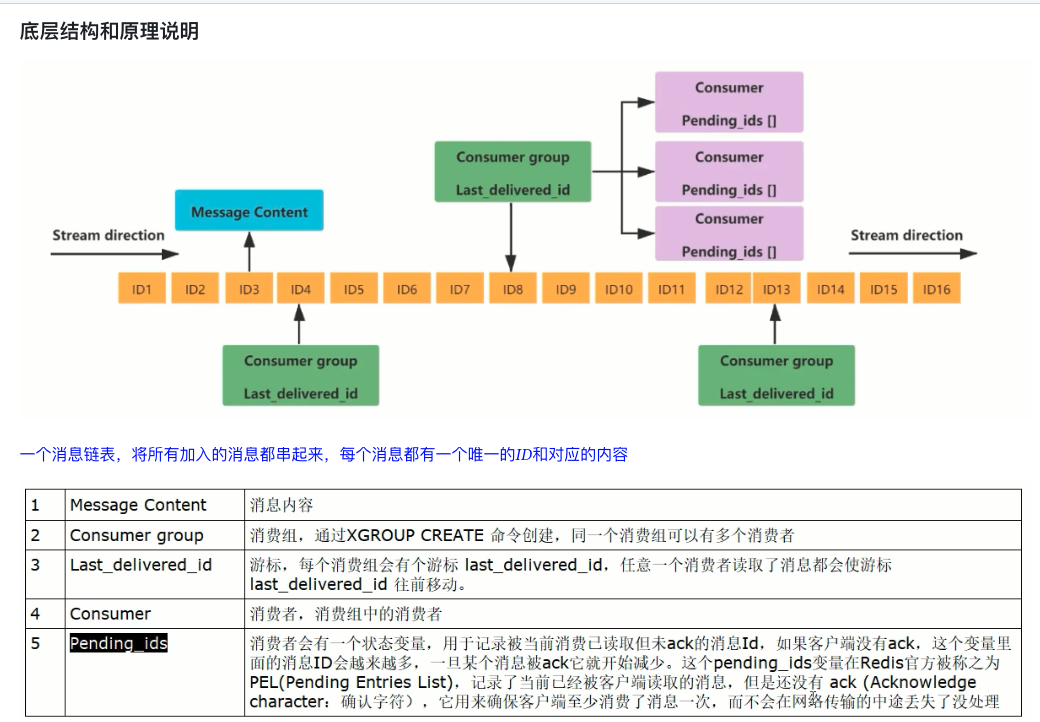
队列相关
xadd key [NOMKSTREAM][MAXLEN|MINID [=|~] threshold[LIMIT count]] *|id field value [field value ...]
shell
# xadd用于向Stream队列中添加消息,如果队列不存在,则会新建一个Stream队列
# 添加消息到队列末尾,消息id必须要比上个id大
# 默认用星号(*)表示自动生成id
127.0.0.1:6379> xadd mystream * k1 v1 k2 v2
1735024146774-0 # 生成的消息id 毫秒级时间戳-该毫秒内产生的第1条消息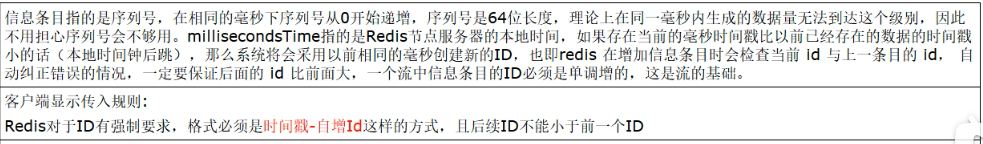
xrange key start end [COUNT count]
shell
# 获取消息列表,可以指定范围,忽略删除的消息
# start是开始知,-代表最小值,end是结束值,+代表最大值,count表示最多获取多少个值
127.0.0.1:6379> xrange mystream - +
1735024146774-0
k1
v1
k2
v2
1735024367169-0
k1
v1
k2
v2
1735024368361-0
k1
v1
k2
v2
1735024370474-0
k1
v1
k2
v2
xrevrange key end start [COUNT count]
shell
# 按反转顺数输出
127.0.0.1:6379> xrevrange mystream + 1
1735024370474-0
k1
v1
k2
v2
1735024368361-0
k1
v1
k2
v2
1735024367169-0
k1
v1
k2
v2
1735024146774-0
k1
v1
k2
v2
xdel key id [id ...]
shell
# 删除指定消息
127.0.0.1:6379> xdel mystream 1735024146774-0
1
xlen key
shell
# 获取消息队列长度
127.0.0.1:6379> xlen mystream
3
xtrim key MAXLEN|MINID [=|~] threshold [LIMIT count]
shell
# 对Stream的长度进行截图,如果超长会进行截取
# maxlen 允许的最大长度可对流进行修剪限制长度
# minid 允许的最小id,从某个id值开始,比它小的值将会被抛弃
127.0.0.1:6379> xtrim mystream maxlen 2
1
127.0.0.1:6379> xtrim mystream minid 1735024367169-0
0
xread [COUNT count] [BLOCK milliseconds] STREAMS key [key ...] id [id ...]

shell
# 用于获取消息(阻塞/非阻塞),只会返回大于指定id的消息
# coutbn最多读取多少条消息
# block是否以阻塞的方式读取,默认不阻塞,如果milliseconds是0,则表示永远阻塞

# 非阻塞
127.0.0.1:6379> xread count 2 streams st 0-0
st
1735025452891-0
k1
v1
1735025456072-0
k2
v2

# 使用block阻塞指定时间,直到读取到满足$的id
127.0.0.1:6379> xread count 2  block 10011 streams st $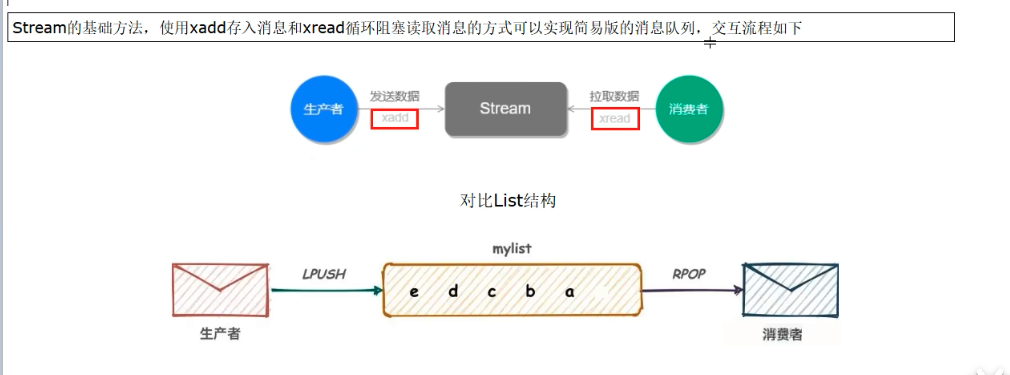
消费组相关
xgroup create key group id|$ [MKSTREAM] [ENTRIESREAD entries-read]
shell
# 创建消费组

# 根据mystream创建消费组
127.0.0.1:6379> xgroup create  mystream group1 $ # $表示从尾部开始消费
OK
127.0.0.1:6379> xgroup create  mystream group2 0 # 0表示从头部开始消费
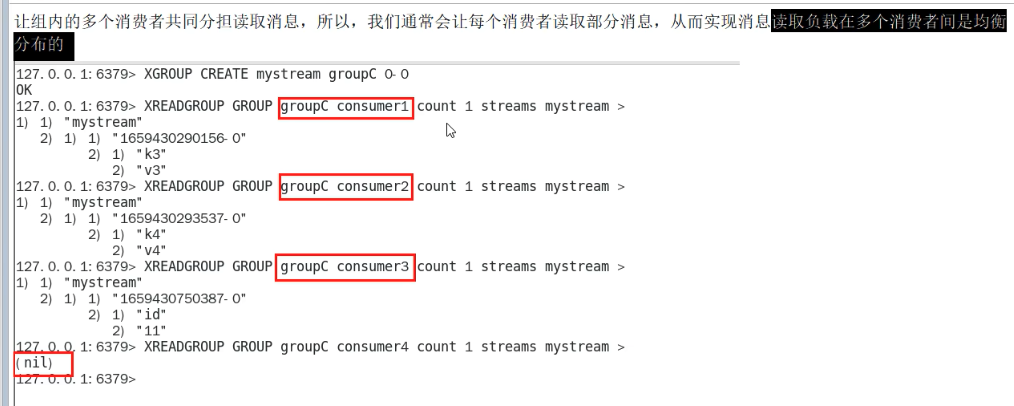
xreadgroup GROUP group consumer [COUNT count] [BLOCK milliseconds] [NOACK] STREAMS key [key ...] id [id ...]读取消费组
shell
# > 表示从第一条尚未被消费的消息开始读取
127.0.0.1:6379> xreadgroup group group2 consumer1 streams mystream >
mystream
1735027370532-0
k1
v1
k2
v2
1735027377812-0
k2
v2
k3
v3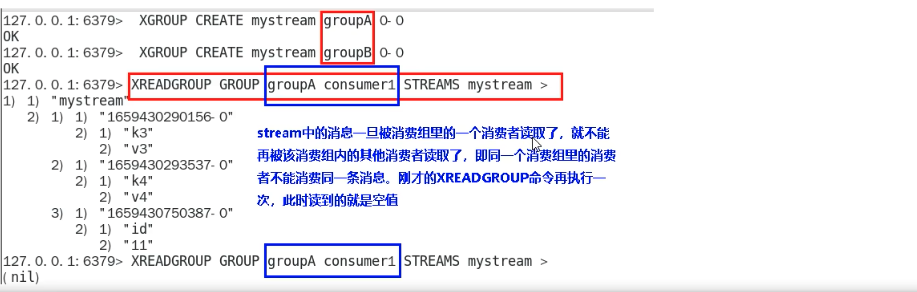
不同组的消费者可以消费同一条消息
ack机制
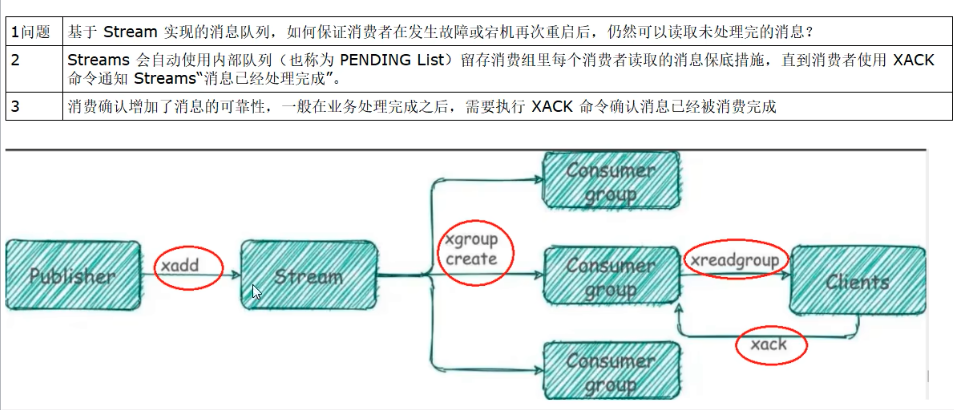
xpending key group [[IDLE min-idle-time] start end count [consumer]]
shell
# 获取消息组已经读取但是没确认的消息
127.0.0.1:6379> xpending mystream group2
2
1735027370532-0
1735027377812-0
consumer1
2
# 读了两条消息,消费者是consumer1
shell
# 查看指定消费者读取的消息
127.0.0.1:6379> xpending mystream group2 - + 10 consumer1
1735027370532-0
consumer1
767478
1
1735027377812-0
consumer1
767478
1
xack key group id [id ...]
shell
# 向消息队列确认消息处理已完成
127.0.0.1:6379> xack mystream  group2 1735028533963-0
1
xinfo stream key [FULL [COUNT count]]
shell
# 用于打印Stream\Consumer\Group的详细信息
127.0.0.1:6379> xinfo stream mystream
length
3
radix-tree-keys
1
radix-tree-nodes
2
last-generated-id
1735028533963-0
max-deleted-entry-id
0-0
entries-added
3
recorded-first-entry-id
1735027370532-0
groups
2
first-entry
1735027370532-0
k1
v1
k2
v2
last-entry
1735028533963-0
kk
vv
位域 bitfield
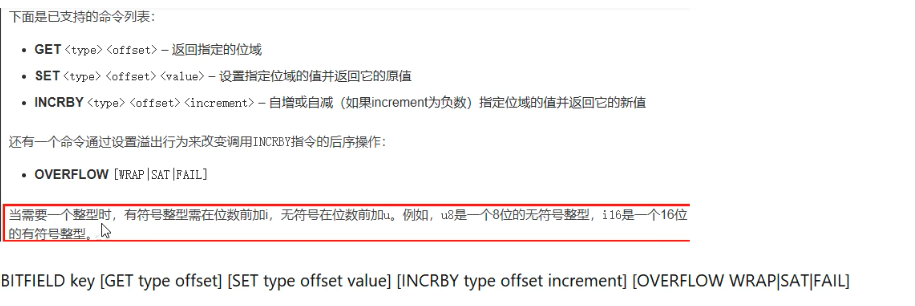
通过bitfield命令可以一次性操作多个比特位域(指的是连续的多个比特位),它会执行一系列操作并返回一个响应数组,这个数组中的元素对应参数列表中的相应操作的执行结果,说白了就是通过bitfield命令我们可以一次性对多个比特位域进行操作
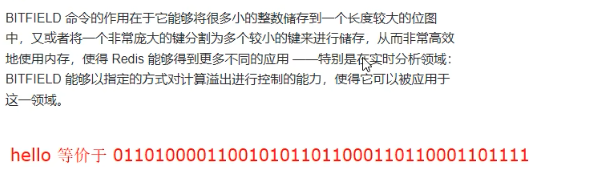
将一个redis字符串看作是一个由二进制位组成的数组并能对变长位宽和任意没有字节对齐的指定整型位域进行寻址和修改
Ascii码表:https://ascii.org.cn
shell
127.0.0.1:6379> set fieldkey hello
OK
127.0.0.1:6379> bitfield fieldkey get i8 0
104  # ASCII码表 10进制104 就是字母h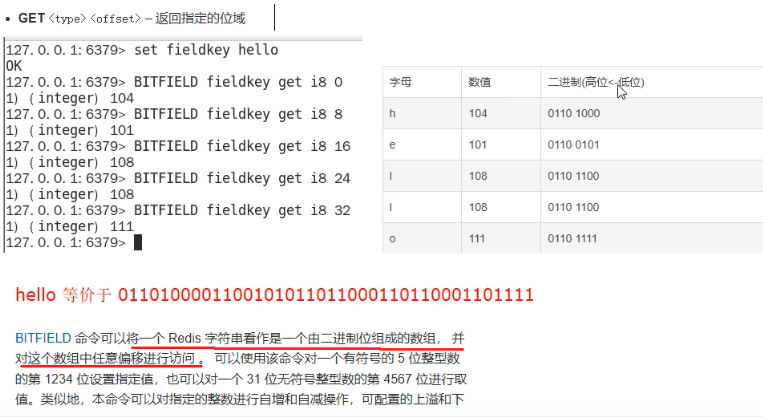
shell
# set 设置指定位域的值并返回它的原值
127.0.0.1:6379> bitfield fieldkey set i8 8 120
101
127.0.0.1:6379> get fieldkey
hxllo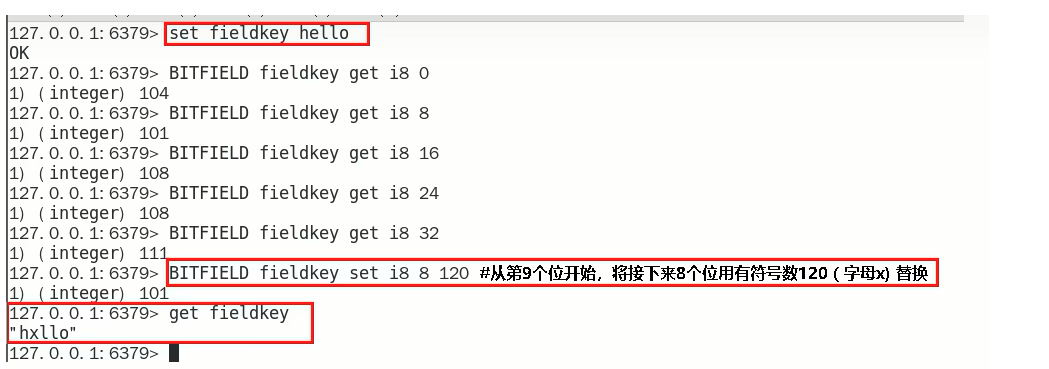
BITFIELD key [INCRBY type offset increment]
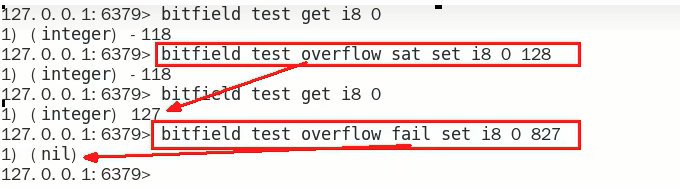
如果偏移量后面的值发生溢出(大于127),redis对此也有对应的溢出控制,默认情况下,INCRBY使用WRAP参数
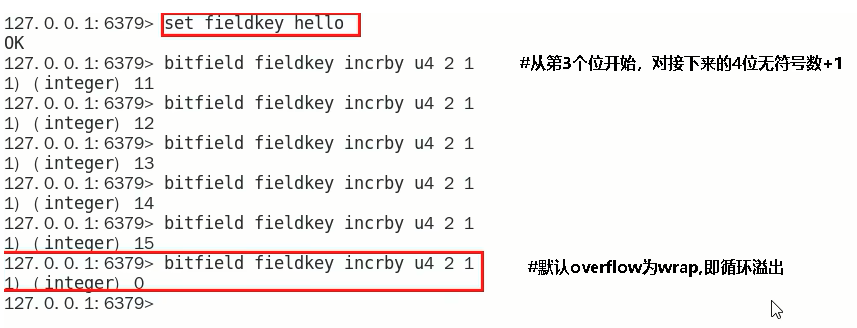
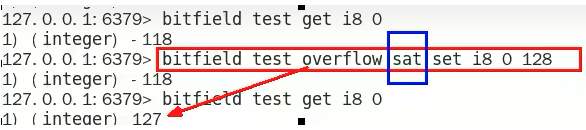
溢出控制:OVERFLOW [WRAP|SAT|FAIL]
WRAP:使用回绕(wrap around)方法处理有符号整数和无符号整数溢出情况
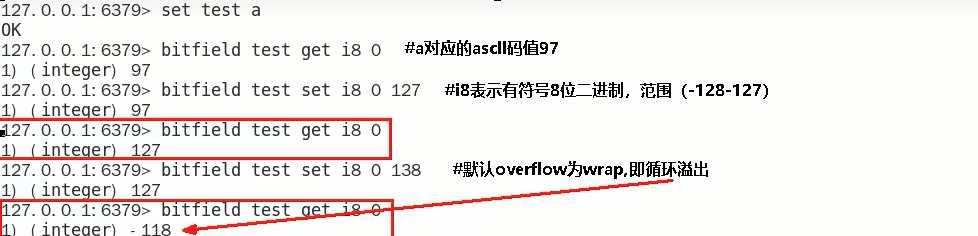
SAT:使用饱和计算(saturation arithmetic)方法处理溢出,下溢计算的结果为最小的整数值,而上溢计算的结果为最大的整数值
fail:命令将拒绝执行那些会导致上溢或者下溢情况出现的计算,并向用户返回空值表示计算未被执行