在日常工作中,我们常常会遇到PDF文档和图纸中的文字无法直接复制粘贴的问题,尤其是那些文字呈现为打散线条或扫描图片形式的文件,给我们的工作带来诸多不便。不过别担心,PDF快速看图软件的"提取文字"功能(基于OCR技术)就能轻松解决这个难题,下面就为大家详细介绍其使用教程。
一、准备工作
- 确认软件已升级到v3.11.0.35或更高版本
软件下载链接:https://pdf.everdrawing.com/?from=CSDN
打开软件后,界面如图所示:


二、打开PDF文件
打开一张包含文字内容的PDF格式的图纸,例如"结构施工图设计总说明.pdf",在PDF快速看图软件中显示如下:

三、缩放图纸
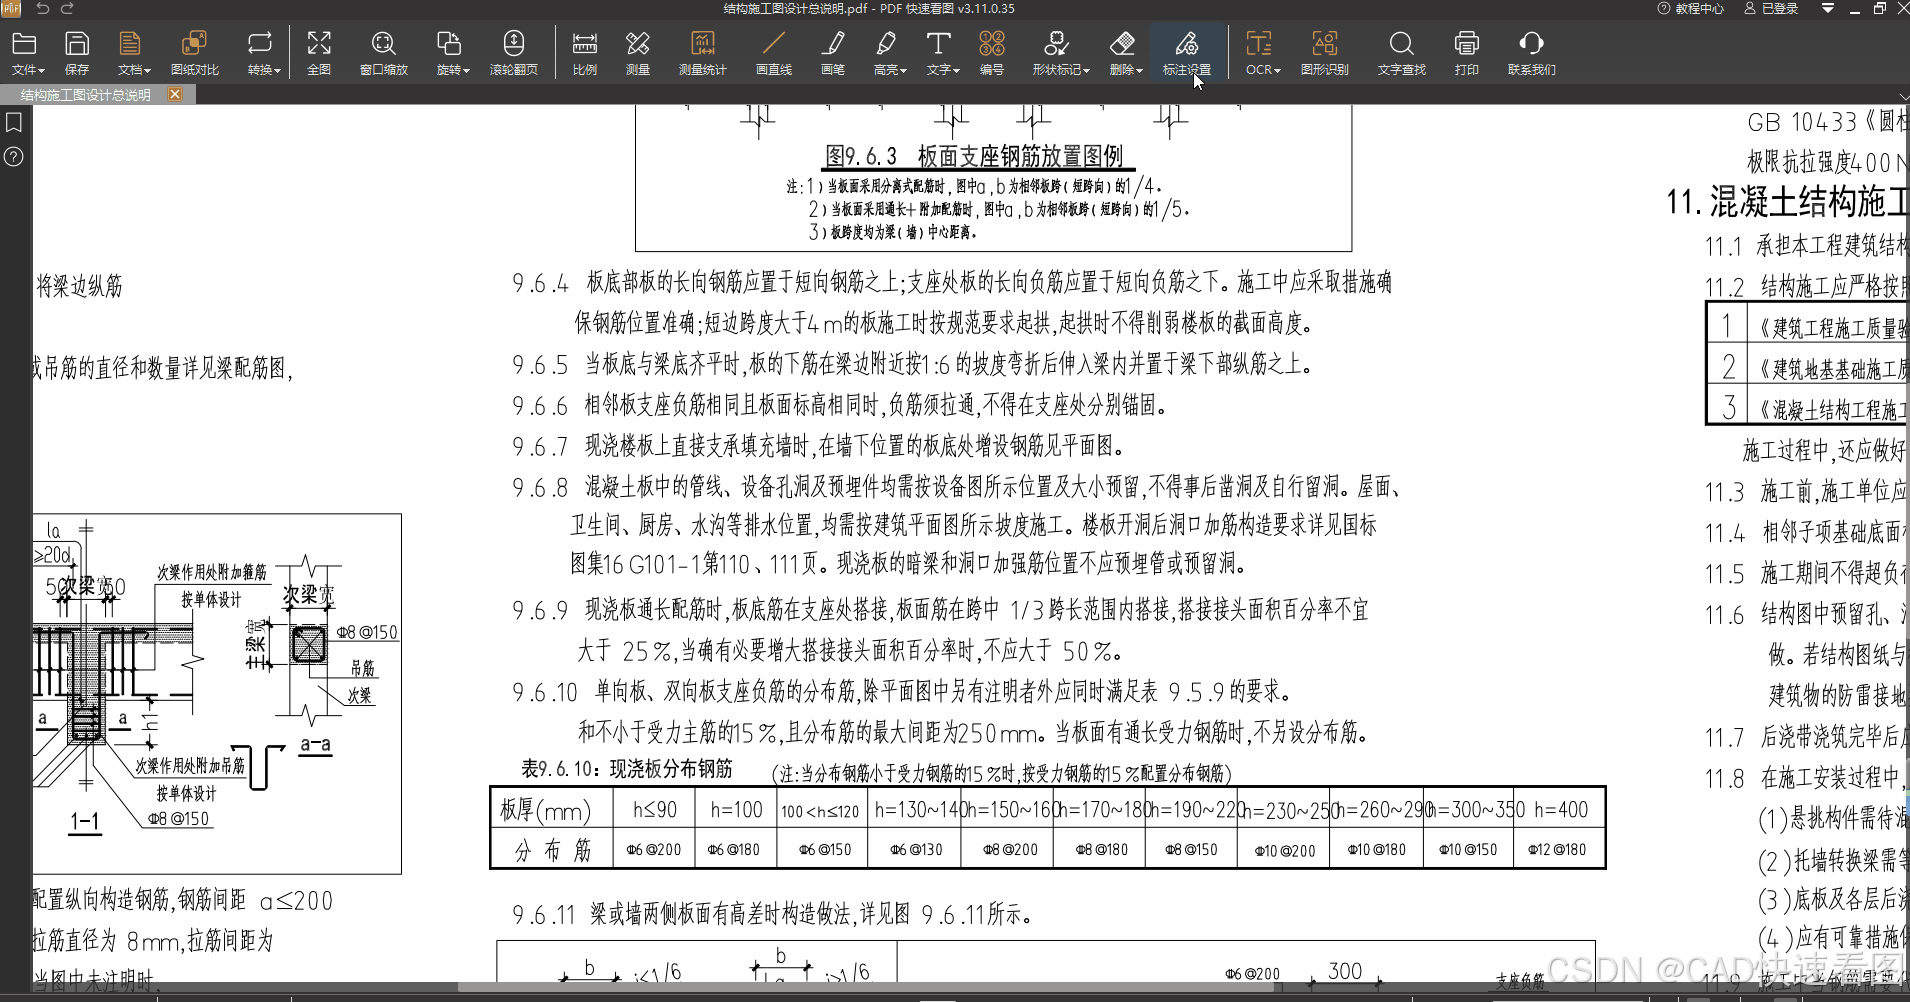
找到待提取文字,将图纸缩放至合适大小(按Ctrl键滑动滚轮缩放,或使用窗口缩放功能),确保待提取文字清晰显示。比如我们要提取关于板配筋的文字说明,调整后效果如下:

四、进入提取文字状态
点击菜单栏的「OCR--提取文字」功能按钮(或按快捷键T),进入提取文字状态。此时会出现"框选提取文档中的中文和英文文字"的提示,界面变为:

五、框选文字
框选待提取文字,框选结束即开始进行文字识别。需注意,框选文字时要完整,不完整的文字将无法识别;同时尽量不要框选图纸元素,否则会对提取文字造成干扰;并且每次只能提取一列文字,多列文字请分别提取。例如框选板配筋相关文字:


六、核对文字
片刻后即可显示提取文字结果,对照着原始图纸,核对提取出的文字,可直接在提取文字结果弹窗中进行修改。如发现错误可及时更正,确保提取内容准确无误。

七、复制文字
点击「复制所有文字」按钮,即可将提取出的文字粘贴到其他文本软件中,方便后续使用。至此,利用PDF快速看图软件进行PDF提取文字(OCR)的操作就完成了。

整体教程动图GIF:
注意事项:
-
软件虽支持在较小视图下使用「提取文字」功能,但为保证框选文字边界准确,建议将待提取文字缩放至合适大小,以提高文字提取准确率。
-
框选文字时需完整,不完整文字无法识别;尽量不框选图纸元素;每次只提取一列文字。
-
提取文字过多可能需等待,选择小范围识别更快。「提取文字」功能默认快捷键为T,也可在快捷键设置中自定义。目前识别语言仅支持简体中文和英文,其他语言暂不支持。