网络请求:
https://www.baidu.com url------统一资源定位符
请求过程:
客户端,指web浏览器向服务器发送请求
请求:请求网址(request url);请求方法(request methods);请求头(request header);请求体(request body)
爬虫:
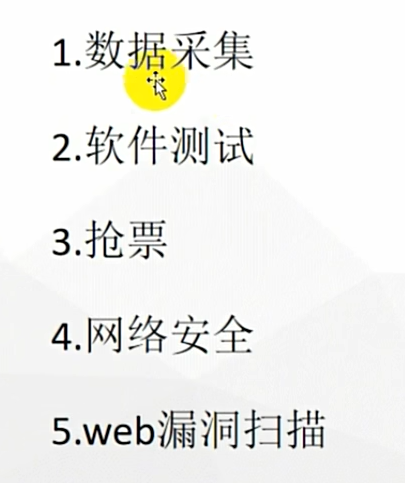
 作用:
爬虫分类:爬取网站数量:通用爬虫与聚焦爬虫*
获取数据的目的:功能性爬虫,数据增量爬虫

网络请求:
https://www.baidu.com url------统一资源定位符
请求过程:
客户端,指web浏览器向服务器发送请求
请求:请求网址(request url);请求方法(request methods);请求头(request header);请求体(request body)
爬虫:
作用:
爬虫分类:爬取网站数量:通用爬虫与聚焦爬虫*
获取数据的目的:功能性爬虫,数据增量爬虫