目录
前置知识:
URL
我们把数据给别人,别人把数据给我们,不是在做IO嘛~! -> 上网的所有行为都是在做IO
软件方面说:应用层进程,根据协议,做两个进程之间的通信
硬件方面说:在体系结构之间做IO
图片,视频,音频,文本等等 都是资源。
我们使用IP地址来定位全网中的唯一一台机器(网络),使用路径在这台机器中定位唯一一个资源(系统),
访问网络中的资源,IP和端口号都是必须的!
如果我们第一次看这个URL,发现他和Linux的路径分隔符是十分相似的。
这个机器上的这个路径下的某个文件发送给客户端,客户端通过浏览器解析渲染。
比如下面的这两URL
CSDN_专业开发者社区_已接入DeepSeekR1满血版 https://www.csdn.net/?spm=1011.2415.3001.4476那为什么这个链接中没有端口号呢?
因为我们使用的Google浏览器只要知道了我们访问时候使用的协议,会为我们做缺省端口的填写。
其中呢,这一部分是
? 问号之前是我们要请求的资源,后面的是我们传递给的参数,key=value的格式,如果是若个参数,使用&符号将他们级联起来
URL中的 / 不一定是根目录,他其实叫做web根目录,两者不一定是同一个。
URL的URLENCODE和URLDECODE
URLENCODE

转化成像%3A这样的字符,为什么要转?避免特殊字符和原本的URL冲突,进而导致URL解析失败。
服务器收到这样的URL串,再将其URLDECODE解析成原本的字符。
HTTP协议的宏观格式
HTTP是应用层协议,是基于TCP协议的
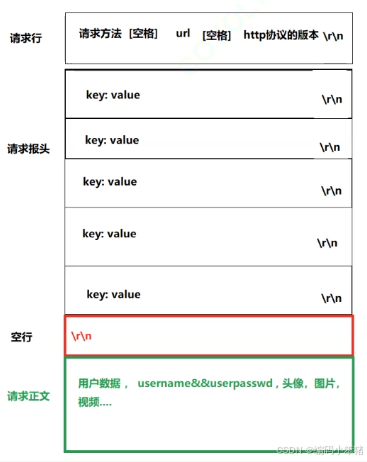
协议是一个结构化的数据,最终就是一个类
如何保证报文是完整的?怎么做序列,反序列化的?
将请求报文(请求头 + 请求报文)作为一个长字符串,字符串以\r\n分割
一直按行读,直到读到空行,就知道了请求头 + 请求报文就读完了
请求正文怎么确定读取完整了?
在请求报头中有一个Context-Length:xxx\r\n
按行作为分隔符 自己做 序列和反序列化
http协议是一个独立协议,不想依赖任何库
http的响应与请求格式基本一致,在响应行中多了个状态码和状态描述,这一部分比如就是
状态码:404 状态描述:Not Found