如果本文章看不懂可以看看上一篇文章,加强自己的基础:爬虫自动化工具:DrissionPage-CSDN博客
案例解析:
前提:我们以ChromiumPage为主,写代码工具使用Pycharm(python环境3.9-3.10)
- 我们要使用浏览器开发者工具(F12)进行对标签的查找,找到之后最好在终端进行搜索,确保标签只有一个在进行代码的编写
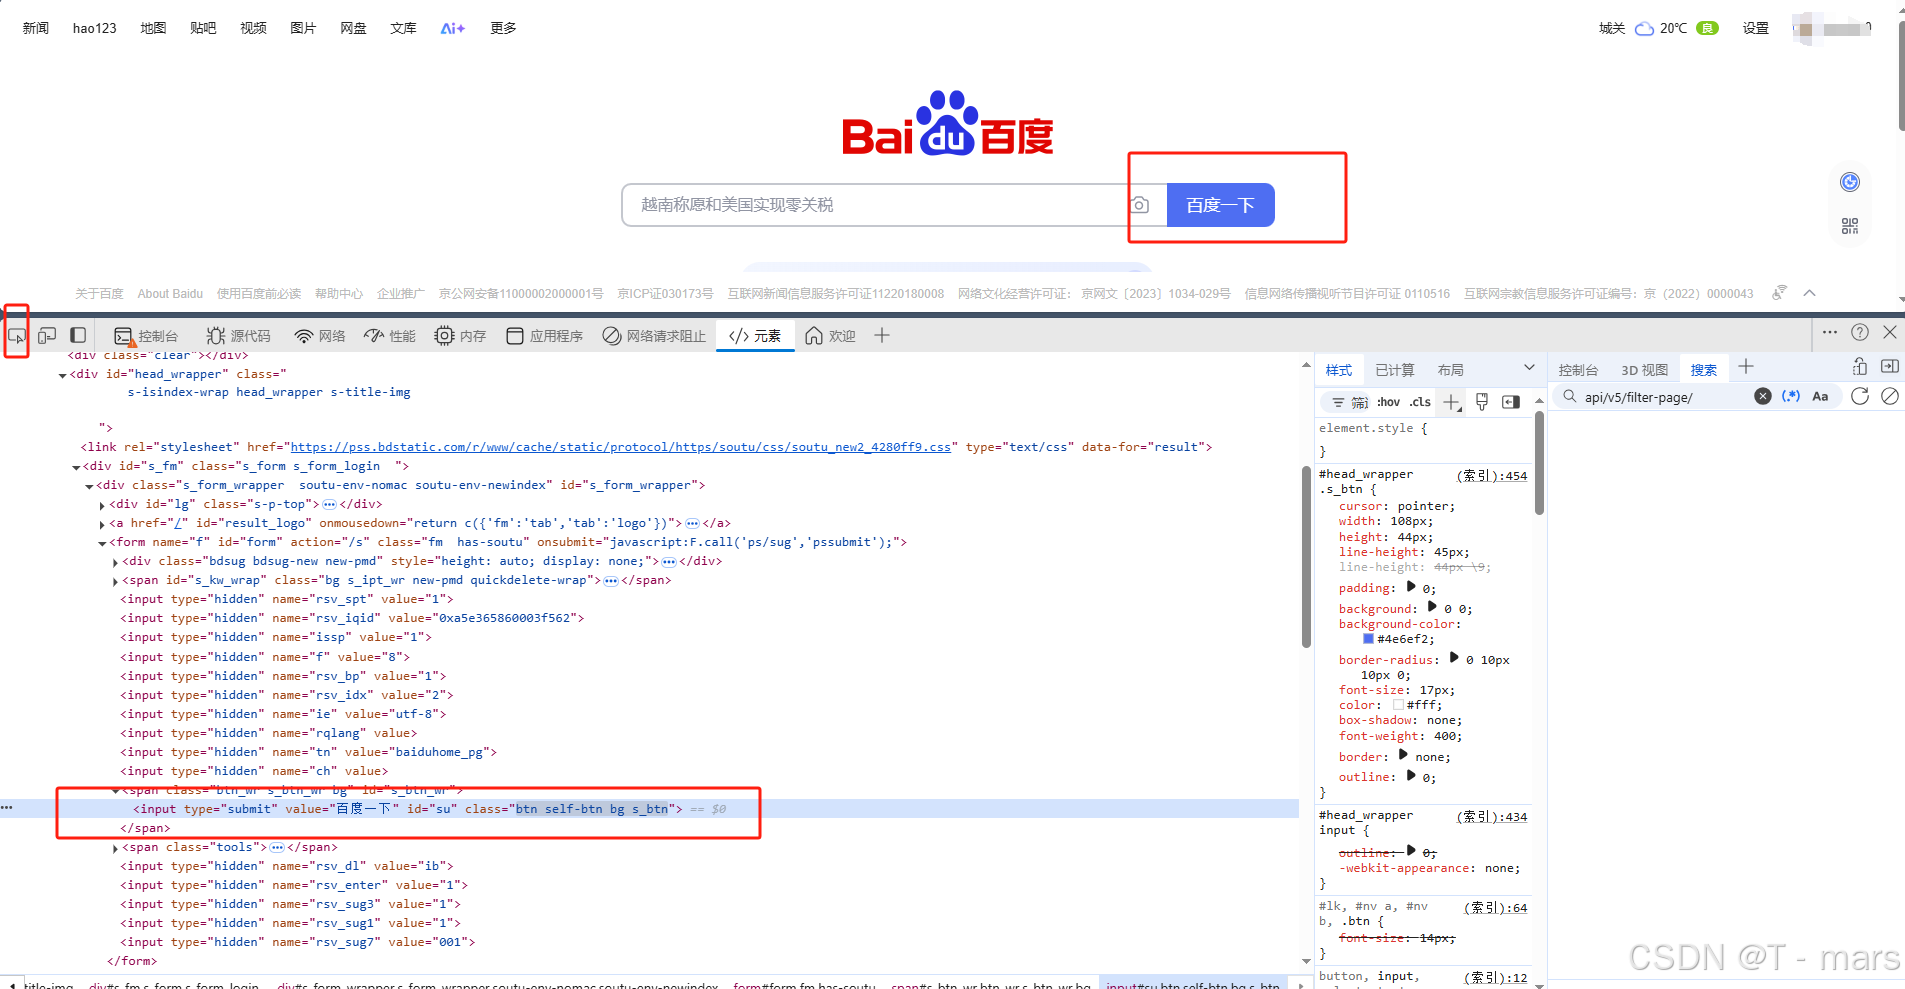
1. 百度案例(https://www.baidu.com/ )
(1) 案例一:
python
from DissionPage import ChromiumPage,ChromiumOptions


# 先创建一个实例化对象
co = ChromiumOptions()
co.headless(False)
# 1、设置无头模式:co.headless(True)
# 2、设置无痕模式:co.incognito(True)
# 3、设置访客模式:co.set_argument('--guest')
# 4、设置请求头user-agent:co.set_user_agent()
# 5、设置指定端口号:co.set_local_port(7890)
# 6、设置代理:co.set_proxy('http://localhost:2222')

page = ChromiumPage(co)
url = "https://www.baidu.com"
page.get(url)
page.wait.load_start() # 等待页面加载完成


# 点击百度搜索框输入美女,并点击搜索
page.ele("css:#kw").input("美女")
page.ele("css:#su").click()

print(page.html)
(2)案例二:
python
from DrissionPage import ChromiumPage


# 先实例化一个对象
cp = ChromiumPage()
cp.get('https://www.baidu.com/')

cp.ele("#kw").input("IP地址") # 定位到搜索框并填充数据
cp.wait.load_start() # 等待页面加载完成(像人的操作)
cp.ele("#su").click()  # 找到搜索按钮并点击搜索


# 我们可以对其网址进行监听
cp.listen.start('qifu-api.baidubce.com/ip/local/geo/v1/district')

res = cp.listen.wait()  # 等待并获取一个数据包
print(res.url)  # 输出数据包url
print(res.response.headers)  # 输出响应头
print(res.response.statusText)  # 输出响应状态码
print(res.response.body)  # 输出响应内容
2. 招聘平台的爬取
注意:学习为主,不要大量爬取数据,妨碍网站的运行,造成法律问题,需本人自己承担
python
import time

from DrissionPage import ChromiumPage, ChromiumOptions
import pandas as pd


# 先实例化一个对象
co = ChromiumOptions().auto_port()
page = ChromiumPage(co)

# 首先我们进行监听动作
page.listen.start('/wapi/zpgeek/search/joblist.json')
page.get('https://www.zhipin.com/beijing/?seoRefer=index')


# 输入我们要查找的岗位
page.ele('.ipt-search').input('网络安全\n')
res = page.listen.wait()

try:
    time.sleep(1)
    cha = page.ele('.icon-close')
    print("cha:::", cha)
    cha.click()
except Exception as e:

    joblist = res.response.body['zpData']['jobList']
    for i in range(5):
        btn = page.ele('.ui-icon-arrow-right')
        _a = btn.parent().attr('class')
        time.sleep(2)
        if _a == '':
            page.scroll.to_bottom()
            page.wait(2)
            btn.click()
            res = page.listen.wait()
            joblist += res.response.body['zpData']['jobList']
            print(joblist)
        else:
            print('已获取全部职位信息')
            break

    df = pd.DataFrame(joblist)
    df.to_excel('boss.xlsx', index=False)
    page.quit()