当我们和大模型聊天时,需要先将人类的自然语言转为 token,再输入到大模型中,大模型计算完成之后,再将结果进行逆转换,形成自然语言返回给用户。
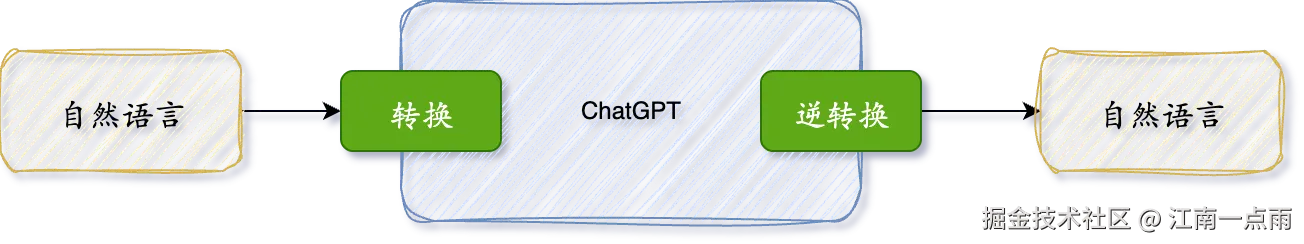
那么在转换的过程中,自然语言到底被转成什么了呢?
一 什么是 Token
如果玩过 Elasticsearch 的小伙伴,有可能会把这个按照中文分词去理解,但是这两个其实还是不一样。
在大模型中,Token(词元) 是文本处理的最小单位,相当于计算机理解人类语言的"基础砖块"。它可以是单词、子词、字符或标点符号,具体取决于模型的分词策略。
大模型中的 token 有如下几种常见的不同形式
- 单词级 Token:一个单词就是一个 Token,如"Hello world" 拆解为 "Hello", "world",但是这样有一个缺点,那就是无法处理新词(比如"Blockchain"可能不在词汇表)。
- 子词级 Token:这是目前的主流方式,这种方案将长词拆解为常见片段,平衡效率与覆盖。比如英文"jumped" 拆解为 "jump", "ed"("ed"表示过去式);再比如中文"人工智能" 拆解为 "人工", "智能",这种方案的优势在于可拼凑生僻词,减少词汇表大小。
- 字符级 Token:这种方案将每个字母/汉字单独处理,如"Cat" 拆解为 "C","a","t",这个方案的缺点是序列过长,计算效率低(中文"你好"需拆成 2 个 Token)。
- 特殊Token:这个是模型内置功能符号,比如 CLS 表示句子开头(BERT);~~ 表示生成终止信号(GPT)等。
二 Tokenizer
将用户输入的自然语言转为 Token 的过程就是 Tokenizer。
2.1 BPE
Byte Pair Encoding(BPE)是一种广泛应用于自然语言处理(NLP)的子词分词算法,最初用于数据压缩,后由 Sennrich 等人(2016 年)引入 NLP 领域,用于解决传统分词方法的局限性。
传统分词方法存在几个问题:一个是词汇表庞大,易出现未登录词(OOV)问题;还有一个是序列过长,丢失语义信息。
2.1.1 OOV 问题
OOV问题(Out-Of-Vocabulary Problem) 是自然语言处理(NLP)中因词表覆盖不足导致的核心挑战。当模型在测试或推理阶段遇到未出现在训练词表中的词时,即触发 OOV 问题。
出现 OOV 问题的原因是因为词表(Vocabulary)是模型训练前预设的、包含所有可识别词的集合(比如 BERT 词表含 30,000 个子词),但是对于一些人名、品牌名、科技术语、低频次甚至一些拼写错误的词,常常在预设词表中查询不到,进而就会触发 OOV 问题。
通过子词分词可以在一定程度上消除 OOV 问题。
比如输入一个 OOV 词: "unbreakable",这个词会被拆解为 "un", "break", "able",而这三个子词全部在词表内,OOV 被消除。
OOV 问题是 NLP 模型泛化能力的核心瓶颈。子词分词(BPE/WordPiece)通过将 OOV 词分解为可管理的语义单元,成为当前最有效的解决方案。然而,其对未见过词根的新词(如全新创造的品牌名)仍存在局限。
2.1.2 序列过长&语义丢失问题
序列过长的问题
假设有这样一个句子 "Natural language processing is fascinating."
字符级分词结果(按字母和空格拆分):
'N','a','t','u','r','a','l',' ','l','a','n','g','u','a','g','e',' ','p','r','o','c','e','s','s','i','n','g',' ','i','s',' ','f','a','s','c','i','n','a','t','i','n','g','.'
序列长度:43 个单元
子词分词(BPE)结果(示例词表假设):
"Natural", " language", " process", "ing", " is", " fascin", "ating", "."
序列长度:8 个单元
很明显,字符级分词结果存在这样一些问题:
- 计算效率低:字符级序列长度是子词分词的 5 倍以上。模型(如 RNN/Transformer)需处理更长的输入序列,计算量(时间和内存)急剧增加。
- 长程依赖难捕捉:字符序列中,单词内部的多个字符需经过多个计算步骤才能组合成有意义的信息(如将 "f","a","s","c","i","n" 整合为 "fascin"),模型更难学习词内结构之间的关系。
丢失语义信息的问题
字符级分词缺乏对语义单元(词根/词缀)的识别能力,因此会导致三方面的问题,我们分别来看。
1 无法表达基本语义单元
比如单词 "unhappiness"。
- 字符级表示:'u','n','h','a','p','p','i','n','e','s','s'
这样表示之后,存在的问题就是语义单元被拆散,比如:
- 前缀 "un-"(表否定) → 拆为 "u" + "n"
- 词根 "happy" → 拆为 "h","a","p","p","i"(失去 "pp" 双写特征)
- 后缀 "-ness"(表名词) → 拆为 "n","e","s","s"
但是如果使用子词表示(BPE),那就是 "un", "happi", "ness"
这样表示的优势就很明显了:
- "un" 明确表示否定含义
- "happi" 保留词根语义(与 "happy" 关联)
- "ness" 明确定义名词属性
2 无法利用跨单词的共享语义
比如现在有一组相关词 "play", "player", "playing"
如果用字符级表示,那么结果就是:
- "play" → 'p','l','a','y'
- "player" → 'p','l','a','y','e','r'
- "playing" → 'p','l','a','y','i','n','g'
这样的问题很明显,模型无法从字符中直接识别共享语义单元 "play"(需从头学习三个独立序列的关联)。
但是如果使用子词表示(BPE),结果就是:
- "play" → "play"
- "player" → "play", "er"
- "playing" → "play", "ing"
这样通过共享子词 "play" 就能直接传递核心语义,模型只需学习后缀变化("er" 表人, "ing" 表进行时)。
3 数字/专名等关键信息被割裂
比如有个地址 "Room 205B"
如果是字符级表示:'R','o','o','m',' ','2','0','5','B'
这样就导致房间号 "205B" 被拆为无意义的数字串,模型难以重建其整体含义(如 "205B" 可能代表特定楼层和区域)。
但是如果用子词表示:"Room", " 205", "B" 或 "Room", " 205B"(取决于词表)
这样 "205B" 作为整体保留,携带完整语义信息。
总结一下就是字符级分词是语义表达的"碎片化"过程,而 BPE 等子词方法通过保留具有实际语义的子词单元(如词根、常用后缀、常见数字组合),在序列长度和语义完整性之间取得了平衡,成为现代 NLP 模型的更优选择。
2.2 Byte-level BPE
Byte-level BPE(字节级字节对编码)是传统 BPE(Byte Pair Encoding)的一种改进变体,核心区别在于操作的基本单位从字符(Character)降级到字节(Byte)。这一改动带来了多语言兼容性、更强的泛化能力等优势,但也牺牲了部分可读性。
2.2.1 传统 BPE 存在的问题
现在我们使用的大模型基本上都支持多语言,甚至包括很多 emoji 和特殊符号,但是传统的 BPE 依赖字符编码,无法处理多语言混合文本。
传统 BPE 以字符为基本单位,但不同语言的字符编码方式不同(如中文是 Unicode 多字节字符,英文是 ASCII 单字节字符)。
举个简单的例子,中文"你好"在 UTF-8 中占 6 字节(\xe4\xbd\xa0\xe5\xa5\xbd),但 BPE 可能直接拆成两个汉字 "你", "好",无法处理字节级别的合并,如果训练语料只有英文,遇到中文、emoji(🚀)或特殊符号(∑)时,BPE 可能无法正确拆分,导致 OOV(未登录词)问题。
同时传统 BPE 在处理一些特殊字符如数学公式、拼写错误的词时,可能会被当作未知字符,进而导致信息丢失。
2.2.2 Byte-Level BPE 解决了哪些问题?
Byte-Level BPE 在处理时先将所有文本转为 UTF-8 字节序列(每个字符 1~4 字节),并且将初始词表固定为 256 个字节(0x00-0xFF),不受语言影响。
这样改进之后,就可以支持任意语言(中文、日文、阿拉伯语、emoji、代码等),并且统一处理所有文本,无需为不同语言调整词表。
Byte-Level BPE 能够天然解决 OOV 问题,即使遇到训练数据中未出现的词(如新造词"栓Q"),Byte-Level BPE 也能拆解为字节组合:
"栓Q" → UTF-8 字节 \xe6\xa0\x93\x51 → 可拆分为 \xe6\xa0\x93("栓") + \x51("Q")。
如果使用传统 BPE,那么当"栓"不在训练词表中,BPE 可能直接标记为 ,而 Byte-Level BPE 仍能保留部分信息。
同时,Byte-Level BPE 初始词表仅 256 个字节,远小于 BPE 的数千个字符(如中文 BPE 词表可能包含 5000+ 汉字),这样训练时内存占用更低,适合大规模语料。并且对于代码、数学公式甚至连二进制数据理论上也能处理了。
2.2.3 Byte-Level BPE 的局限性
虽然 Byte-Level BPE 解决了 BPE 的许多问题,但仍有一些缺点:
- 可读性差:生成的 token 是字节序列(如 \xe4\xbd\xa0 代表"你"),调试困难。
- 序列长度可能变长:1 个汉字在 UTF-8 占 3 字节,所以中文文本的 token 数量可能是 BPE 的 3 倍。
- 控制字符问题:部分字节(如 0x00~0x1F)对应不可见字符(如换行符、制表符),可能干扰模型。
三 词表训练过程
那么 Byte Pair Encoding(BPE)的词表是怎么得到的呢?
词表训练是一个数据驱动的迭代合并过程,通过统计语料中的高频字符/子词组合逐步构建。
具体训练步骤是这样:
首先我们需要有一个初始词表,这个初始词表是语料中所有唯一字符的集合,如果是英文,那么就是 {a, b, ..., z, A, ..., Z, 0, ..., 9, !, , ...}(约100+个token);如果是中文,那么就是所有出现的汉字 + 符号(可能数千个)。
接下来我们就开始训练。
- 初始化词表,将每个词拆分为字符 + 词尾标记:例如:"low" → "l", "o", "w", ""( 标记词边界,避免跨词合并)。
- 统计符号对出现的频率:遍历语料,统计所有相邻符号对的出现次数。比如有如下语料:"low", "lower", "newest"
- ("l", "o") 出现 2 次(来自 low 和 lower)
- ("e", "w") 出现 1 次(来自 newest)
- 其他组合类似统计。
- 合并最高频符号对:选择频率最高的符号对,将其合并为新子词,并更新词表。例如:合并("l", "o") → "lo",新增"lo"到词表。
- 循环执行Step 2-3,直到:
- 达到预设词表大小(如 10,000 次合并)。
- 或无法继续合并(所有符号对频率 = 1)。
这样就得到最终词表:初始字符 + 所有合并生成的子词。
下面松哥再通过一个例子,和小伙伴们演示一下上面的过程。
首先假设我们有如下语料:"low", "low", "low", "newer", "newer", "newest", "newest", "newest", "newest" ("low"出现3次,"newer"出现2次,"newest"出现4次)。
训练过程如下:
- 初始词表:{l, o, w, e, r, s, t, n, }
- 第 1 轮合并:
- 最高频对:("e", "s")(出现 4 次,来自 newest)
- 合并为 "es" → 词表新增 "es"。
- 更新语料:"newest" → "n", "e", "w", "es", "t", ""
- 第 2 轮合并:
- 最高频对:("es", "t")(出现 4 次)
- 合并为 "est" → 词表新增 "est"。
- 第 3 轮 合并:
- 最高频对:("est","")(出现 4 次)
- 合并为 "est" → 词表新增 "est"。
- 第 4 轮合并:
- 最高频对:("l", "o")(出现 3 次)
- 合并为 "lo" → 词表新增 "lo"。
- 终止条件:假设总合并次数为 4,那么经过上述合并之后,得到最终词表:{l, o, w, e, r, s, t, n, , es, est,est, lo}
Byte-Level BPE 词表训练
这个和前面的训练过程类似,区别主要是以下方面:
- 初始单位:文本转为 UTF-8 字节序列(256 种可能值),例如:"你" →
\xe4\xbd\xa0(3字节)。 - 合并对象:统计高频字节对(如
\xbd\xa0)。 - 词表扩展:从字节逐步合并为多字节 token(如
\xe4\xbd→\xe4\xbd\xa0)。