目录
[2、页框 VS 页](#2、页框 VS 页)
[六、进程 vs 线程](#六、进程 vs 线程)
一、线程概念
1、定义
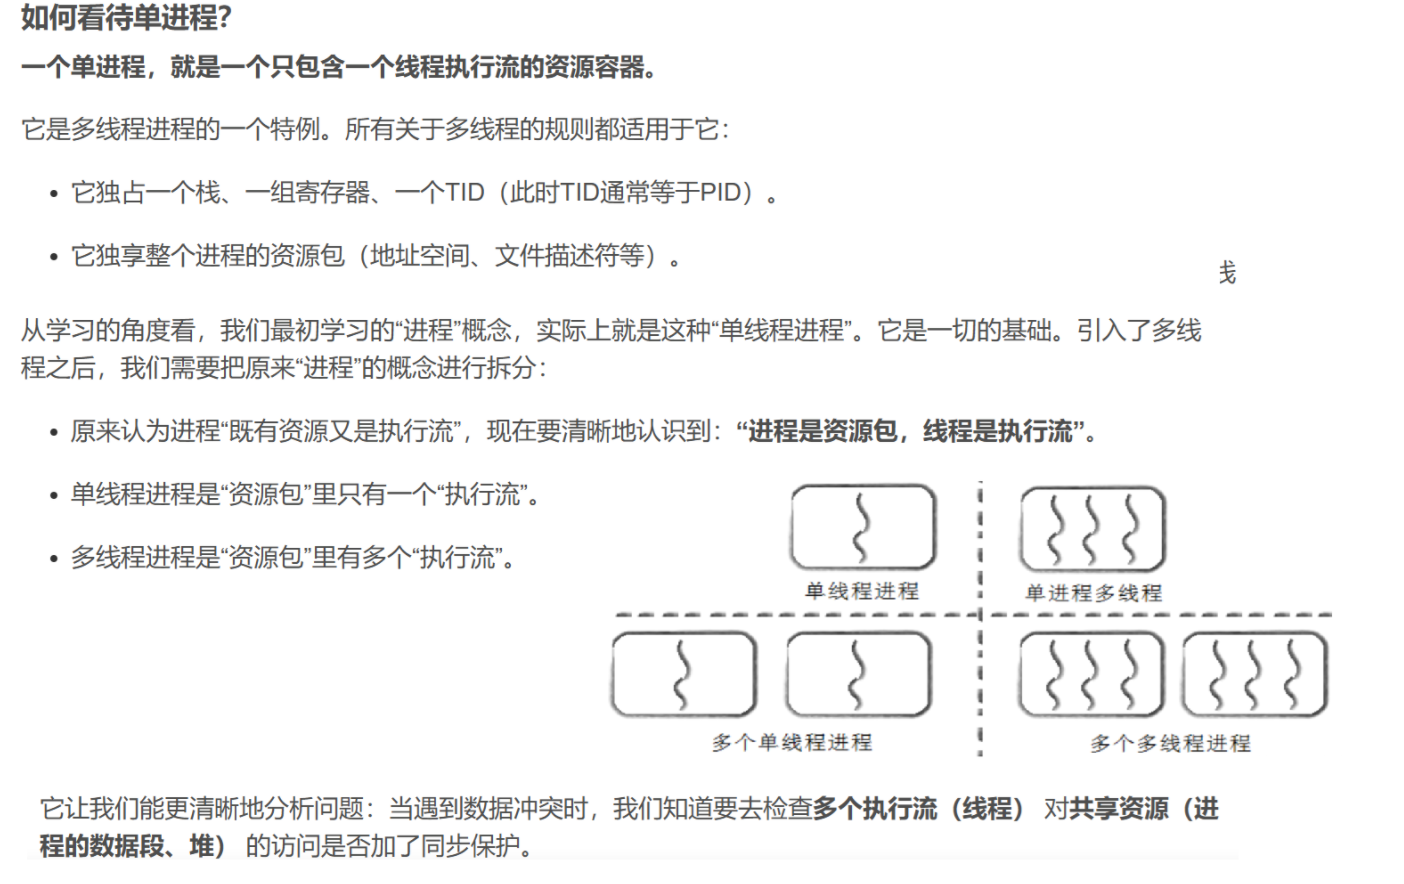
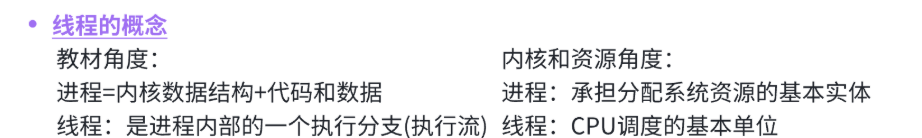
在操作系统中,进程与线程一直是我们非常关注的话题,它们共同构建了程序的执行环境,前面我们已经介绍了进程,今天我们要了解的就是线程,在此之前,我们就得先谈谈进程与线程的区别:
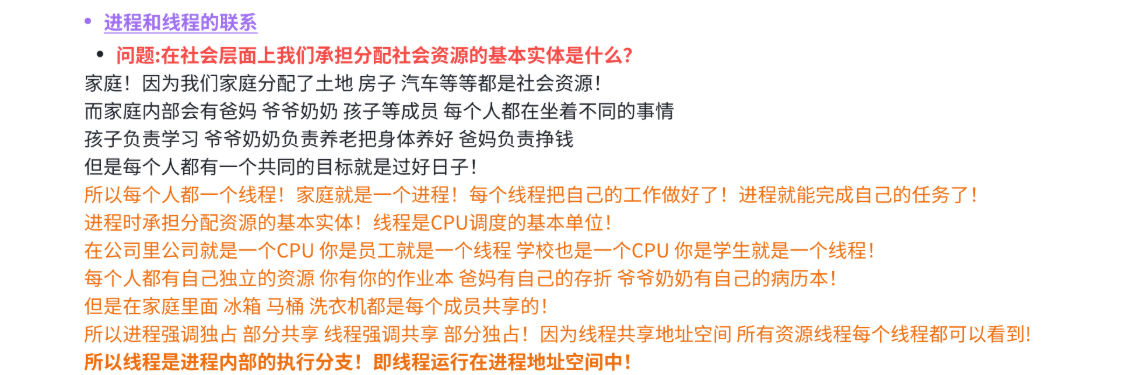
- 进程:进程是程序的一次执行实例。它是操作系统资源分配的基本单位。每个进程都有自己的内存空间、进程地址空间,文件描述符表、全局变量等系统资源。
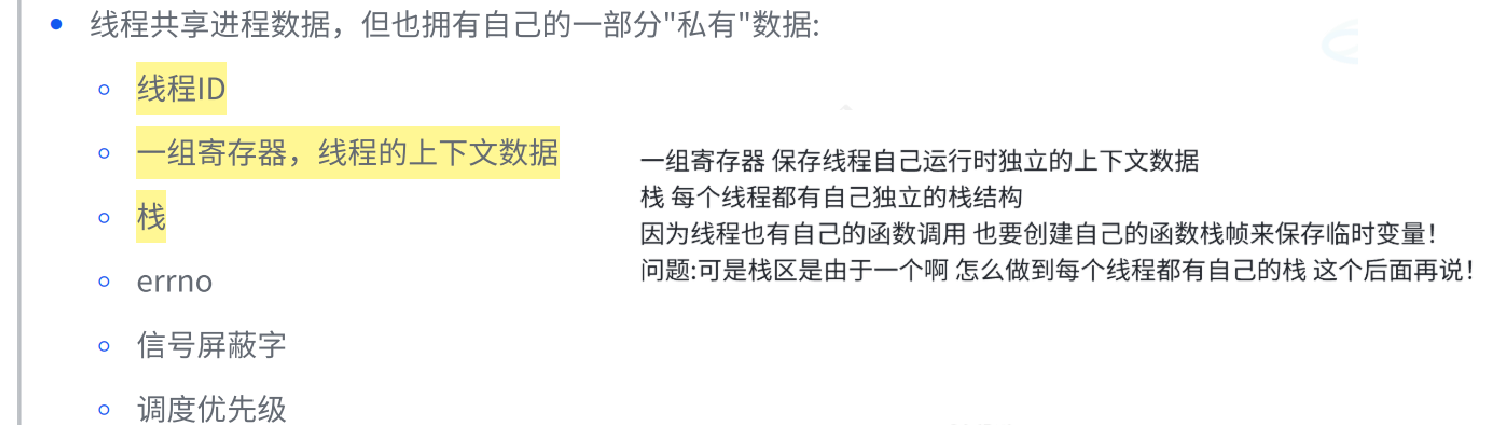
- 线程:线程是进程中的一个执行单元。一个进程可以包含多个线程,它们共享进程的资源(如内存、进程地址空间,文件描述符表等),但每个线程有自己独立的寄存器(存储上下文)、栈(保存临时数据)和程序计数器(记录指令执行位置),errno(错误码) 等。
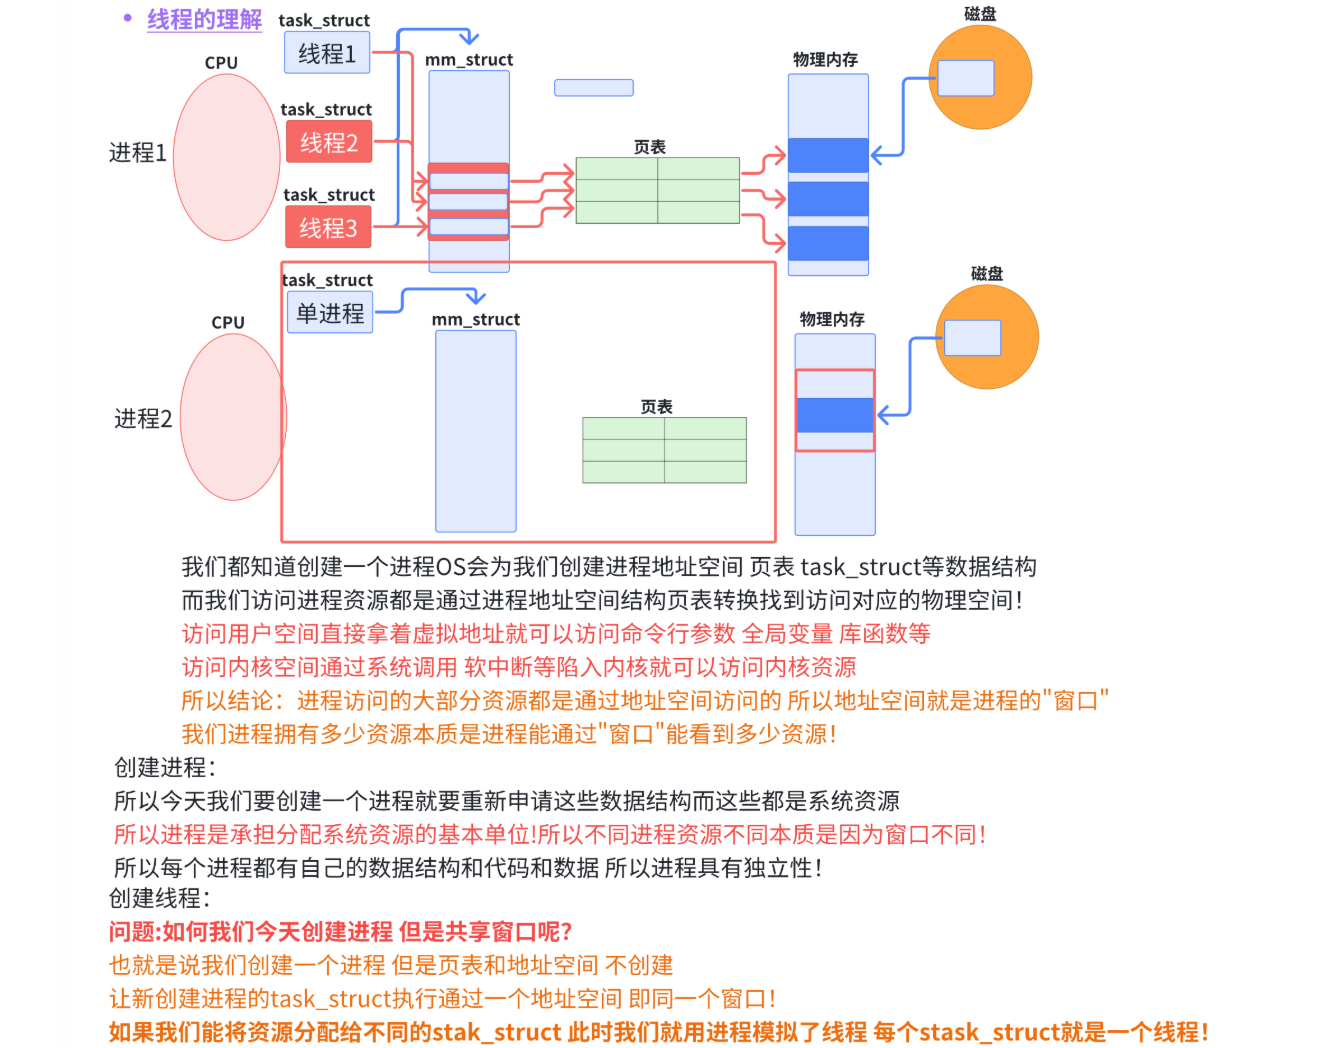
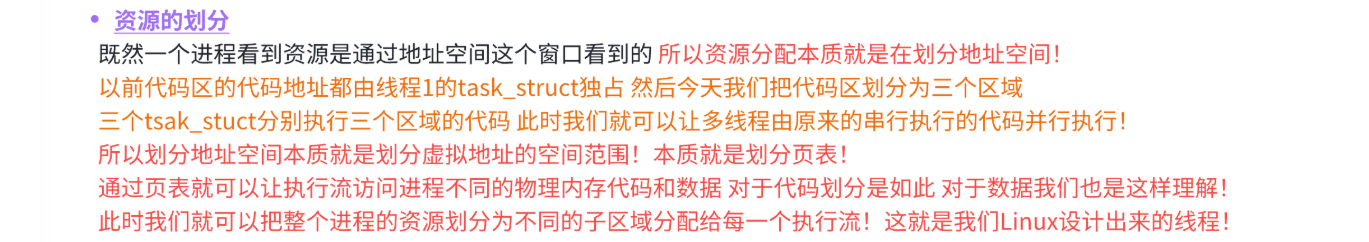
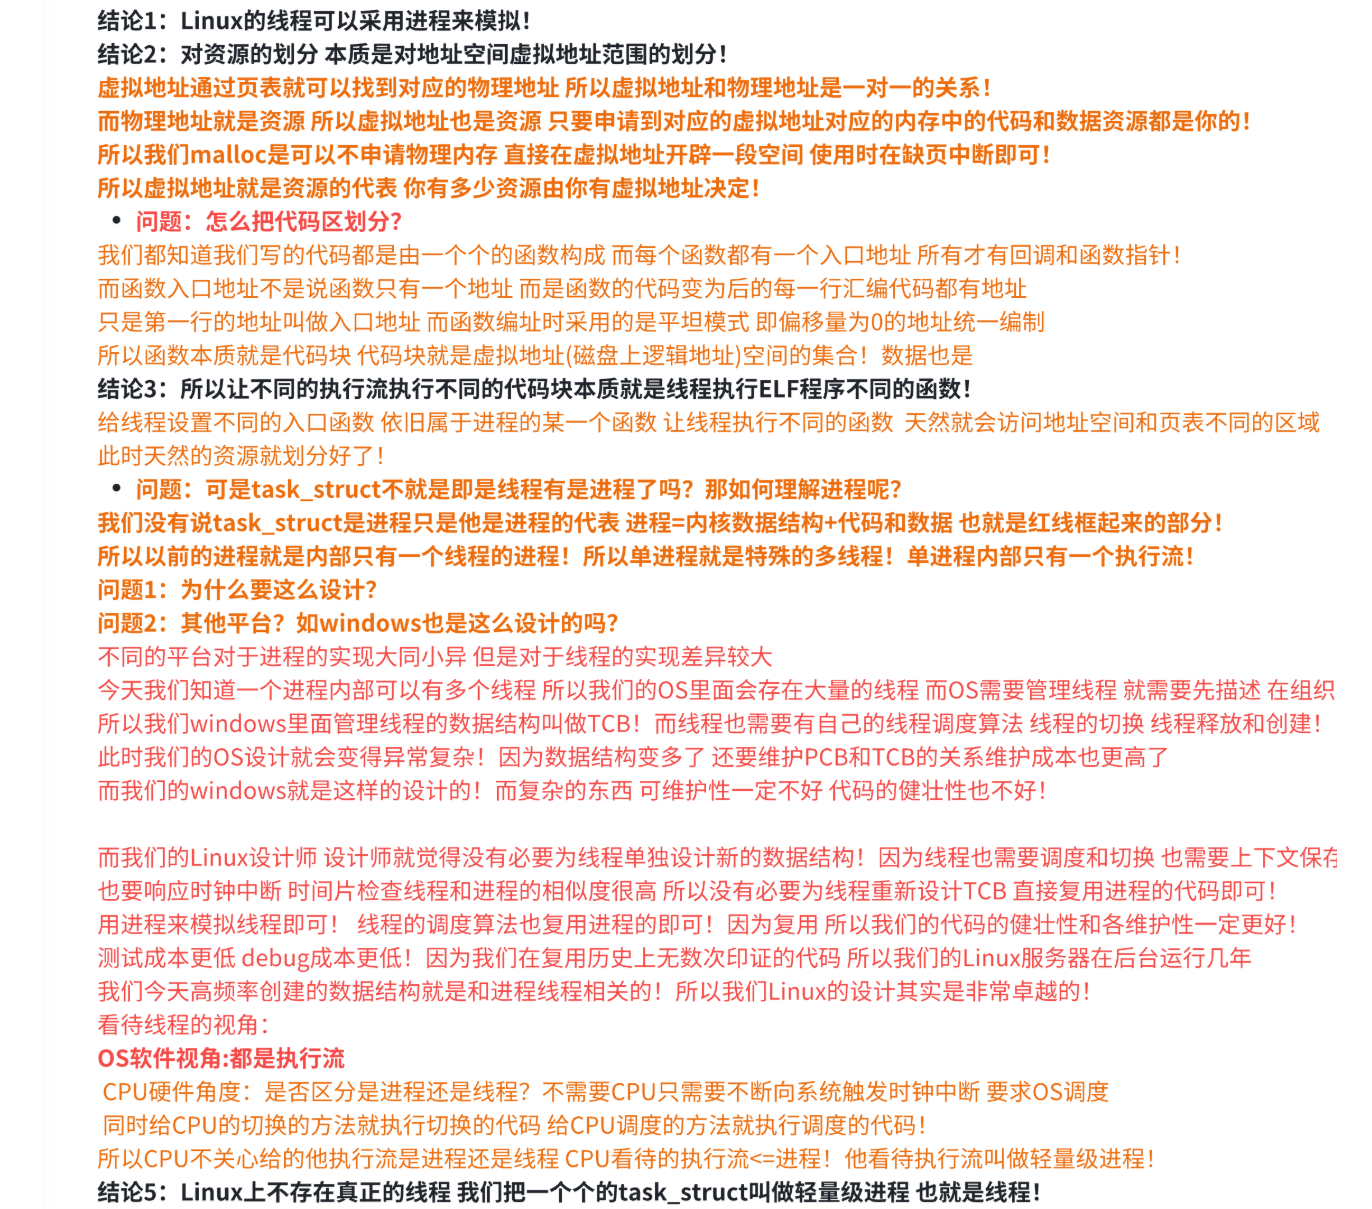
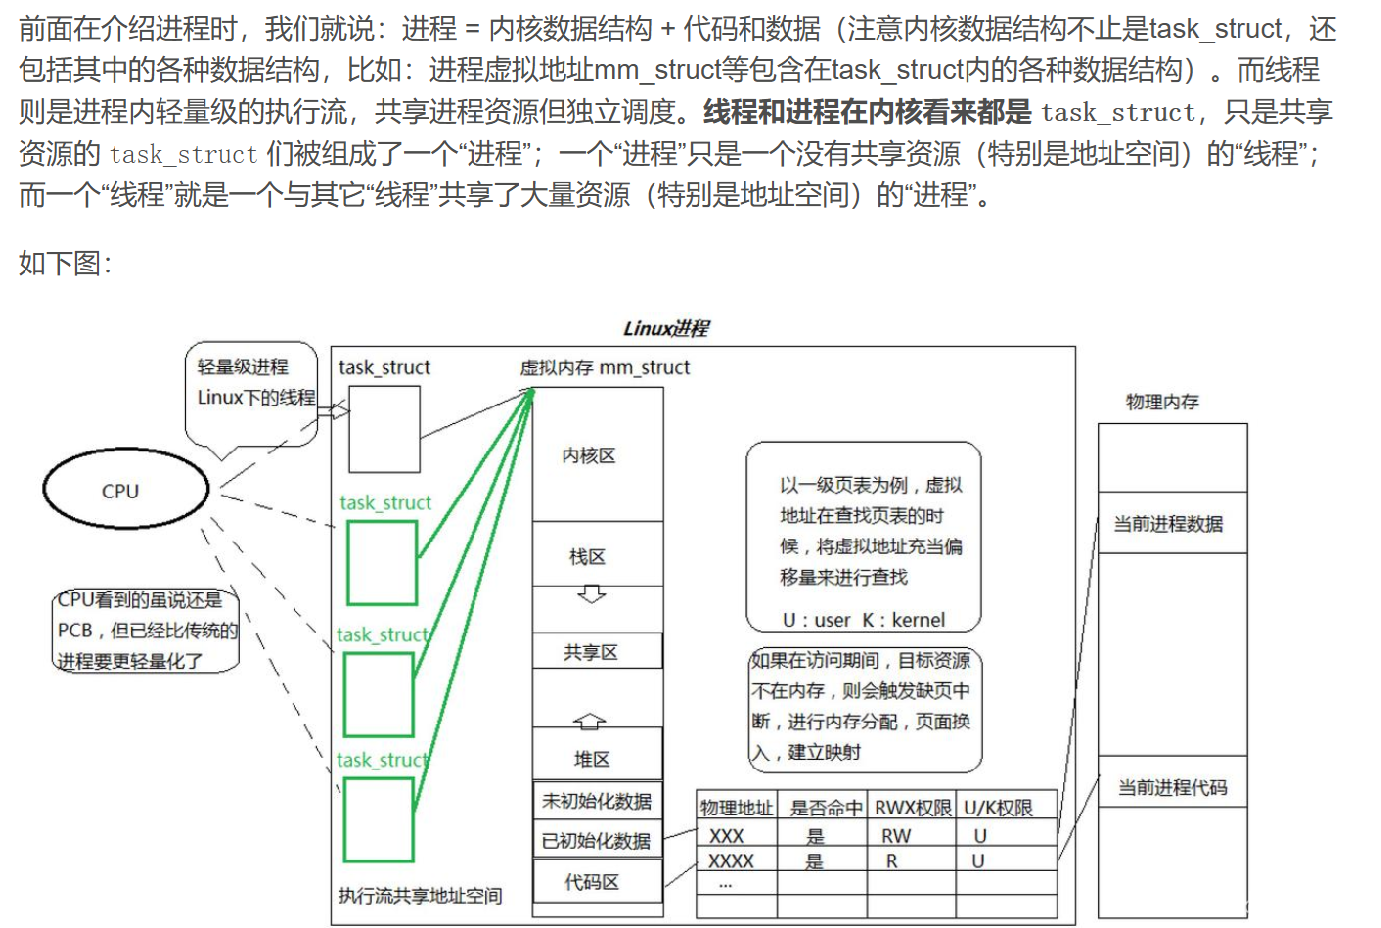
操作系统为了方便多个进程,有了进程控制块 PCB,同样为了管理我们的线程也应该创建我们的 TCB 结构(thread ctrl block),但是值得一提的是:在我们 Linux 操作系统中,为了提高代码的可复用性,降低我们的维护成本,采用进程的内核数据结构也就是 task_struct 来模拟的线程,所以我们常说 Linux 中没有真正意义上的线程。
并且 CPU 中只有执行流的概念,所以原则上来说 CPU 并不会区分进程与线程,但是 Linux 操作系统需要区分线程与进程,所以我们可以称线程 为轻量化进程。
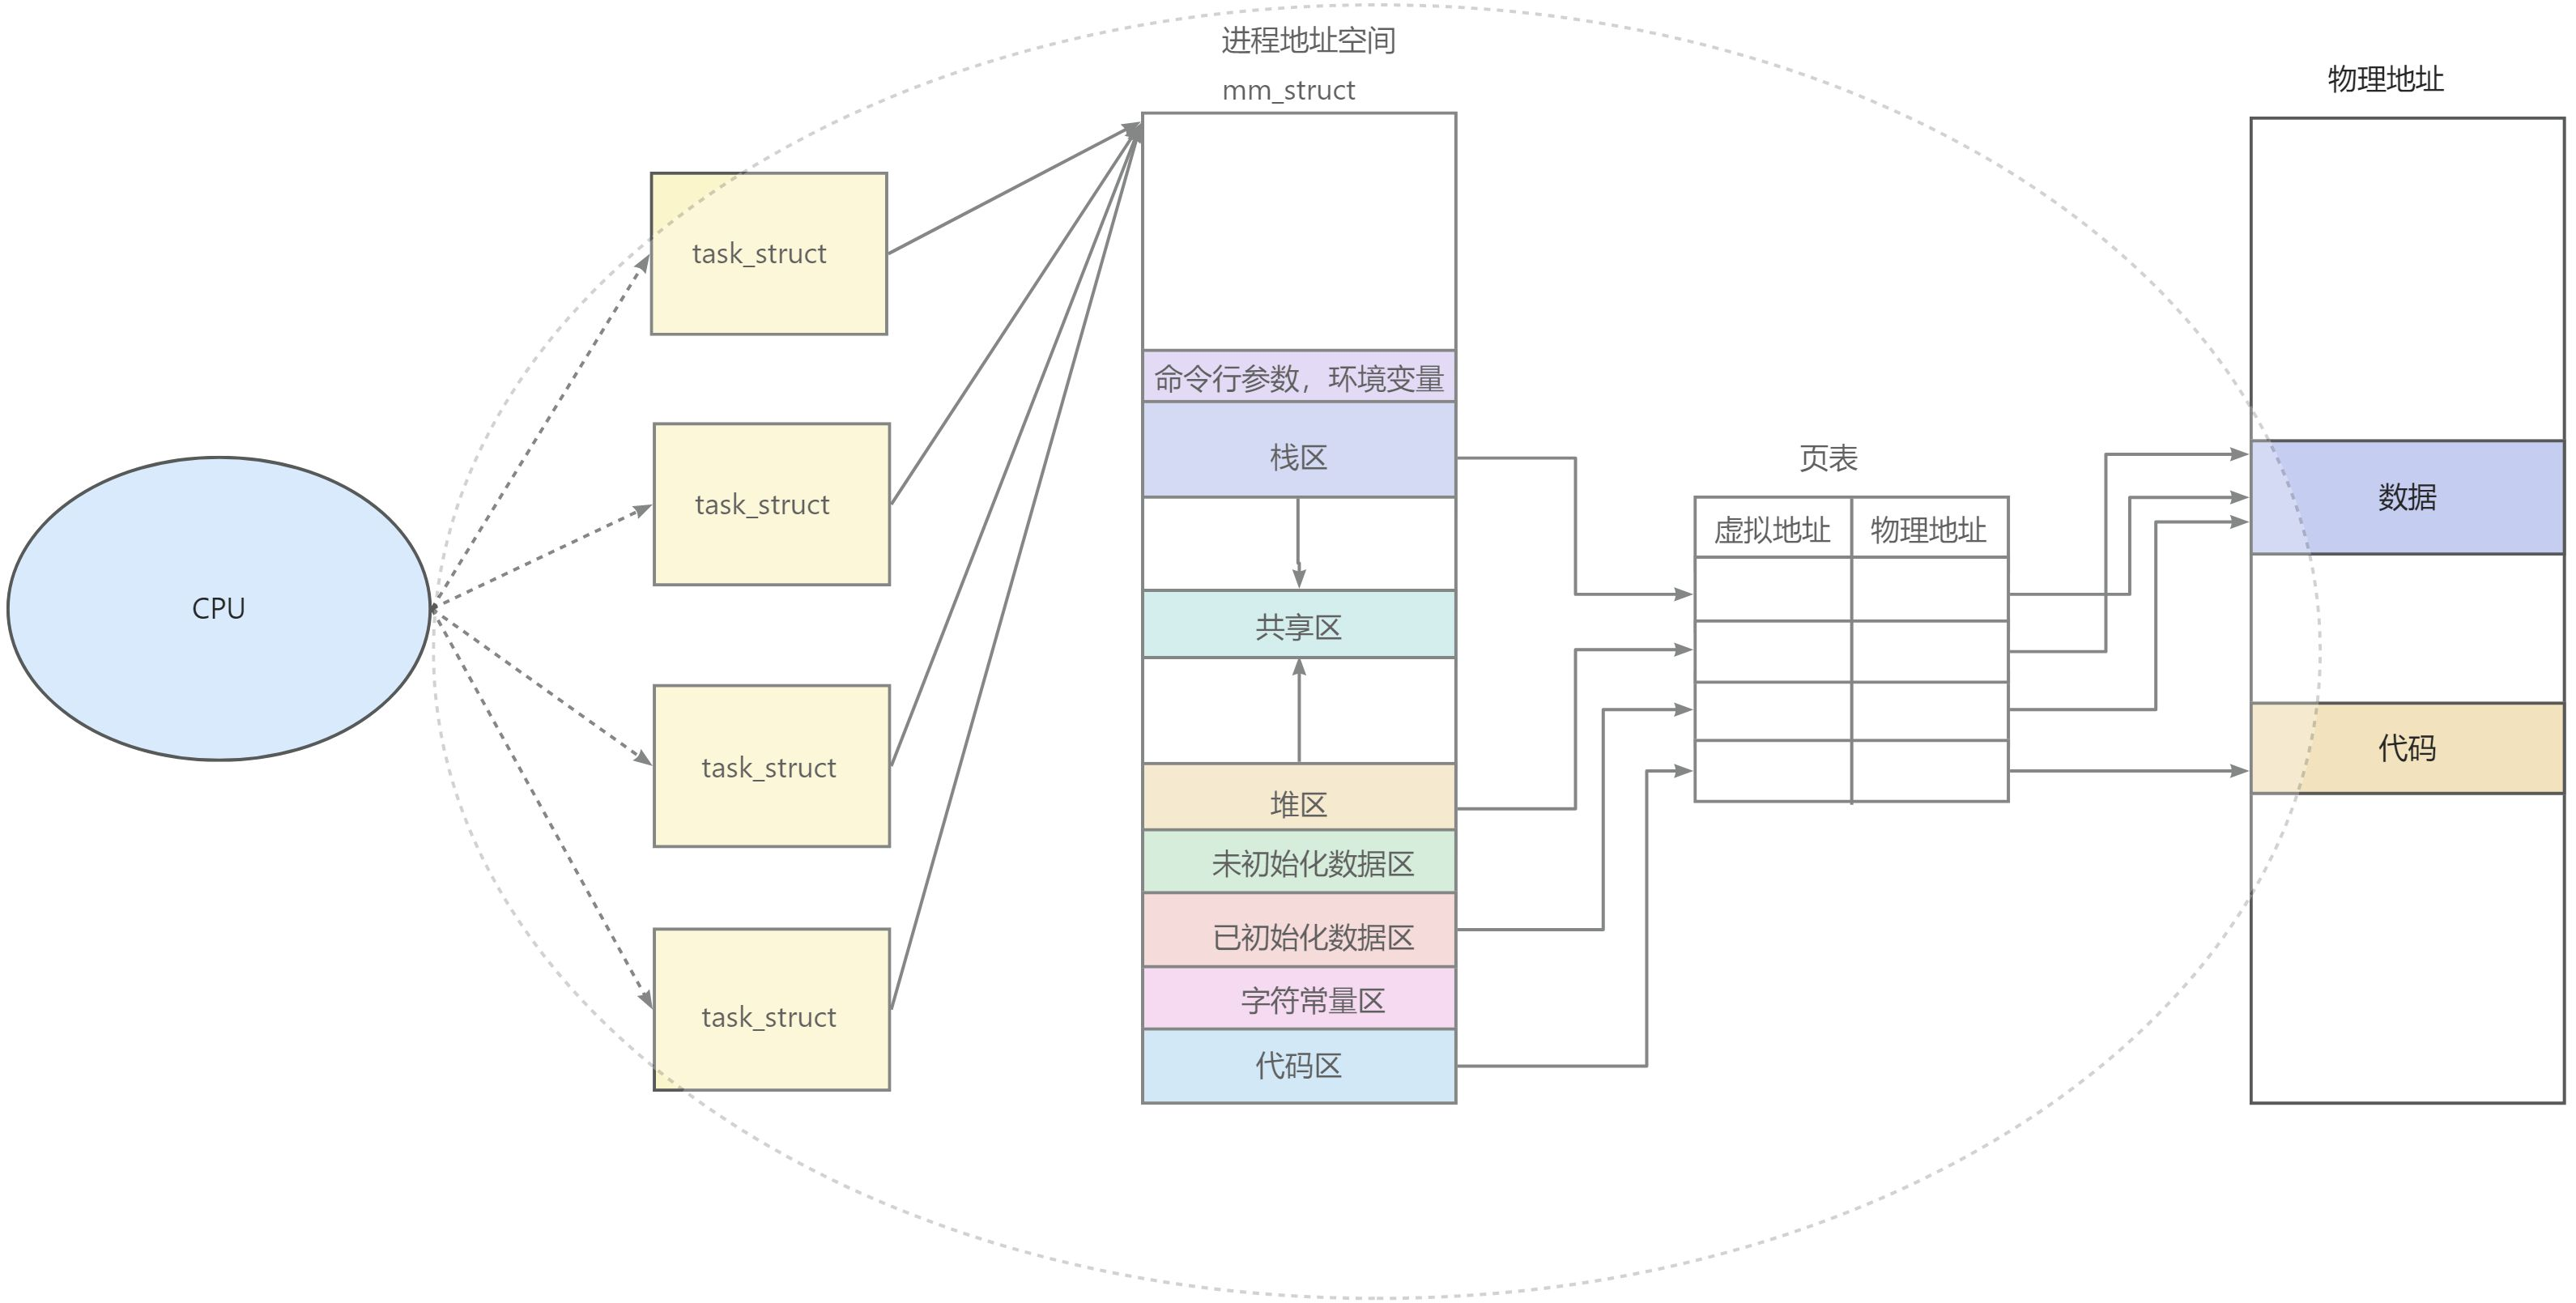
其中上图我们用虚线框住的就是我们的进程,而一个 task_struct代表的就是一个线程。
2、内核资源划分
3、总结
二、分页式存储管理
1、虚拟地址和页表的由来
思考一下,如果在没有虚拟内存和分页机制的情况下,每一个用户程序在物理内存上所对应的空间必须是连续的,如下图:
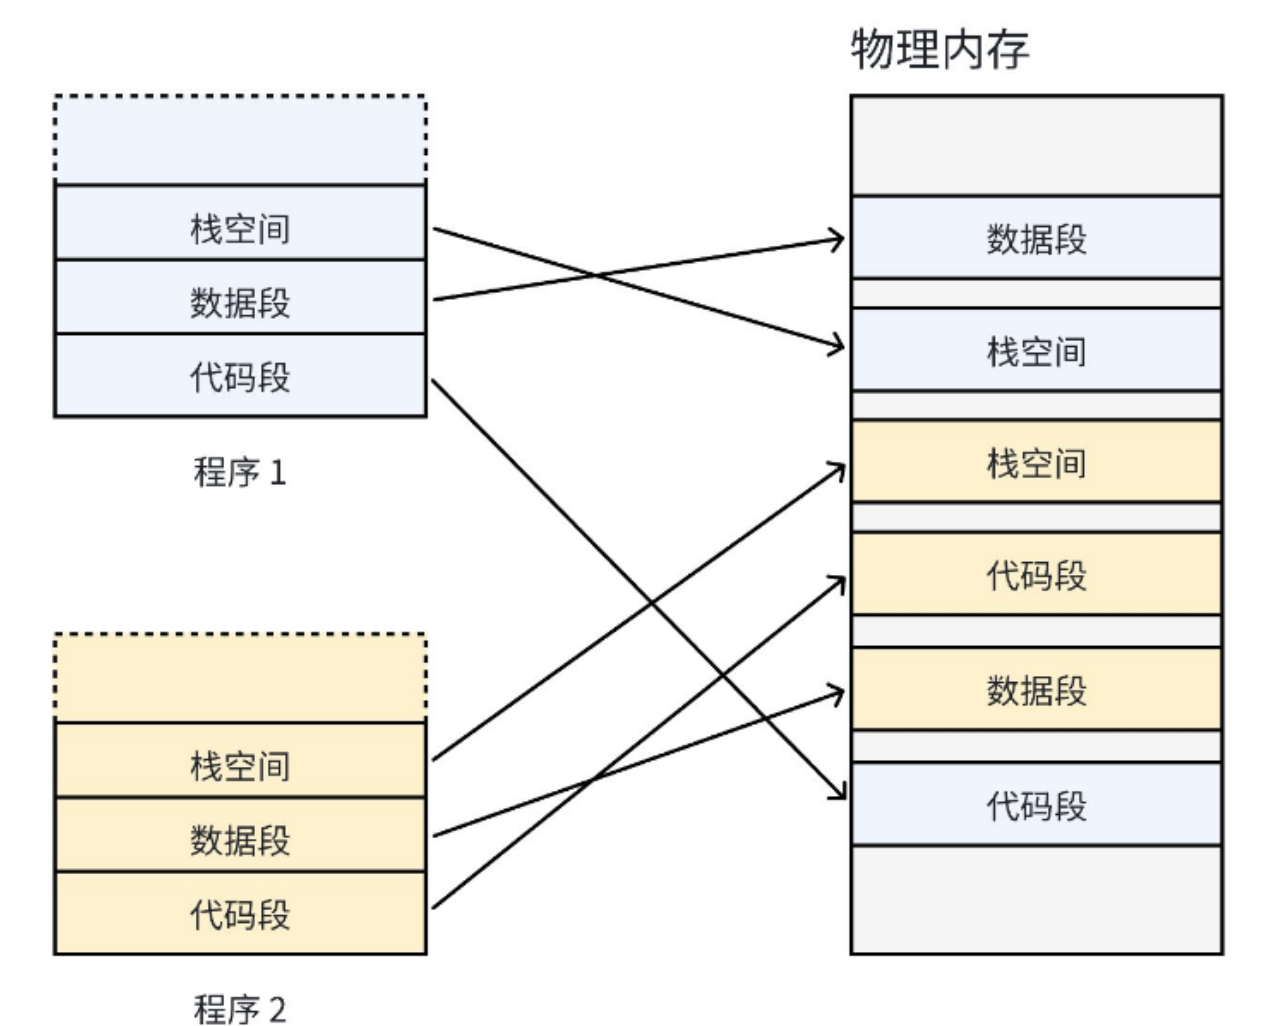
- 需求:用户程序希望使用连续的、巨大的地址空间(如 0x00000000 到 0xFFFFFFFF)。
- 现实:物理内存是有限的,且程序频繁地加载和退出。
- 直接映射的后果:如果直接将程序的连续地址空间映射到物理内存,会导致外部碎片。即物理内存中充斥着大量不连续的、大小不一的小块空闲内存,虽然总空闲内存可能很多,但无法分配出一块足够大的连续空间来加载一个新程序,导致内存利用率低下。
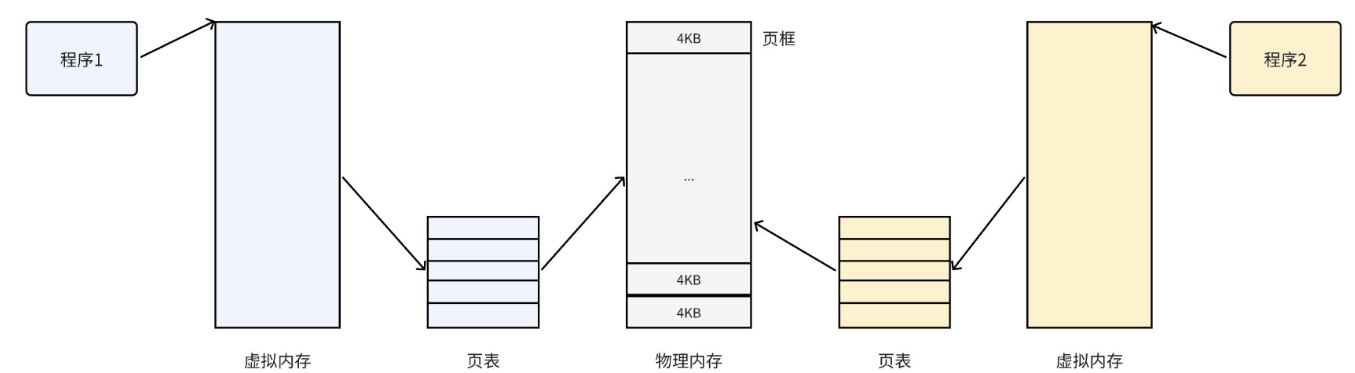
怎么办呢?我们希望操作系统提供给用户的空间必须是连续的,但是物理内存最好不要连续。此时虚拟内存和分页便出现了,如下图所示:
2、页框 VS 页
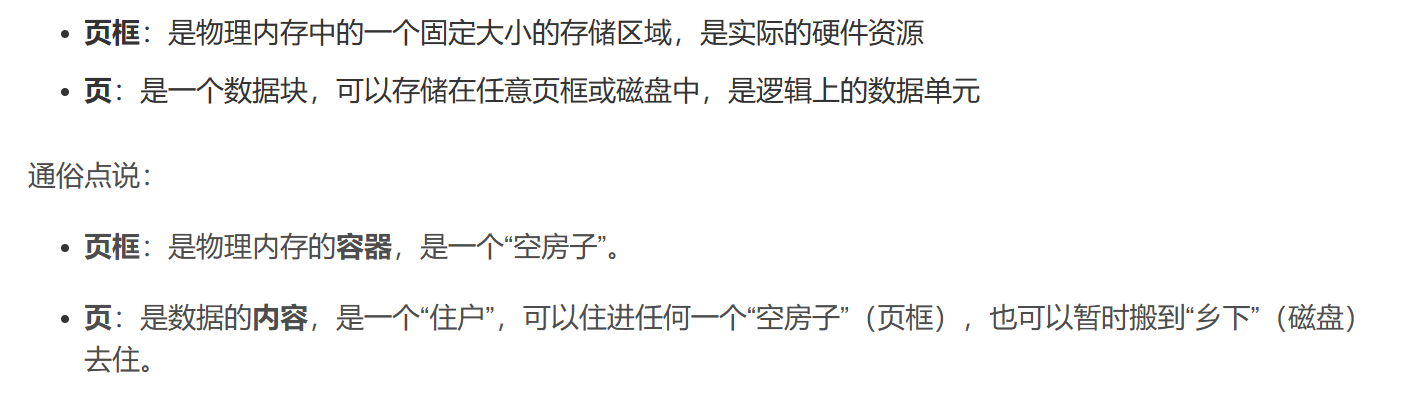
物理内存被划分为固定大小的"页框"(page frame),有时也称为物理页。每个页框包含一个物理页(page)。页的大小与页框大小相等。不同体系结构支持不同的页大小:
- 32位体系结构通常支持4KB(4096字节)的页
- 64位体系结构一般支持更大的页,如8KB(8192字节)
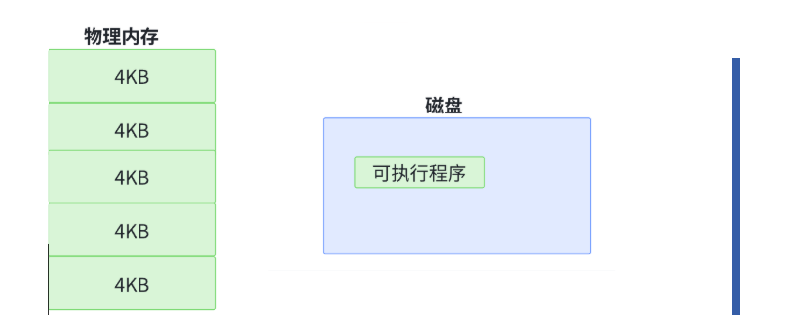
我们之前学习磁盘时知道,磁盘 是以 4kb 为单位划分的,而我们之前讲的可执行程序就是文件,文件就在磁盘存储,所以可执行程序无论是内容还是属性也是以 4kb为单位存储的!
而我们的物理内存 也不是以字节为单位进行管理的,但是使用上可以使用字节为单位使用!他也是以 4kb 为单位进行管理的!所以物理内存和磁盘进行 IO 交互时,是以 4kb为单位进行交互的!
而无论是在内存还是在磁盘上的 4kb 都叫做页框 或页帧 !4GB/4kb=1024*1024=1048576,也就是说 32 位平台下有 100 多万个 4kb的内存块。
3、物理内存管理
先描述,再组织:4kb 是我们的操作系统划分,所以 OS 里面存在很多的页框,有些 4kb 正在被使用,有些要被释放,有些是不能刷新到磁盘上的 (管道缓冲区)!所以 OS为了管理一个个的页框, OS也要先描述再组织!
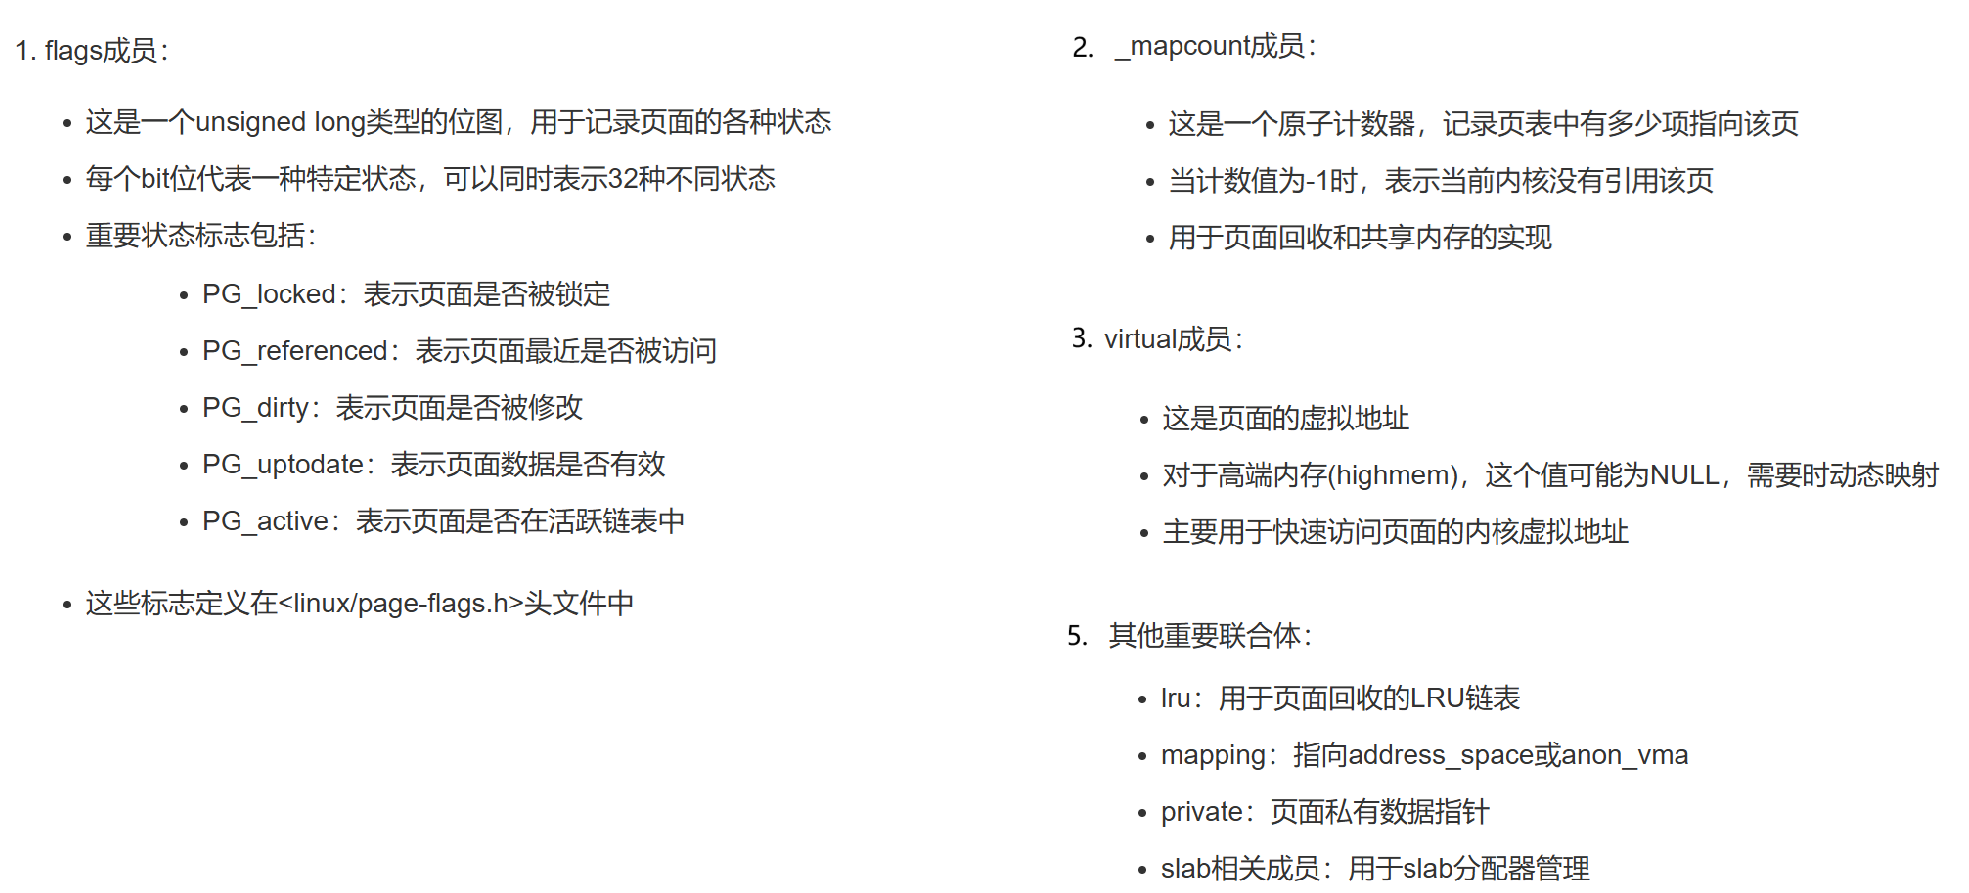
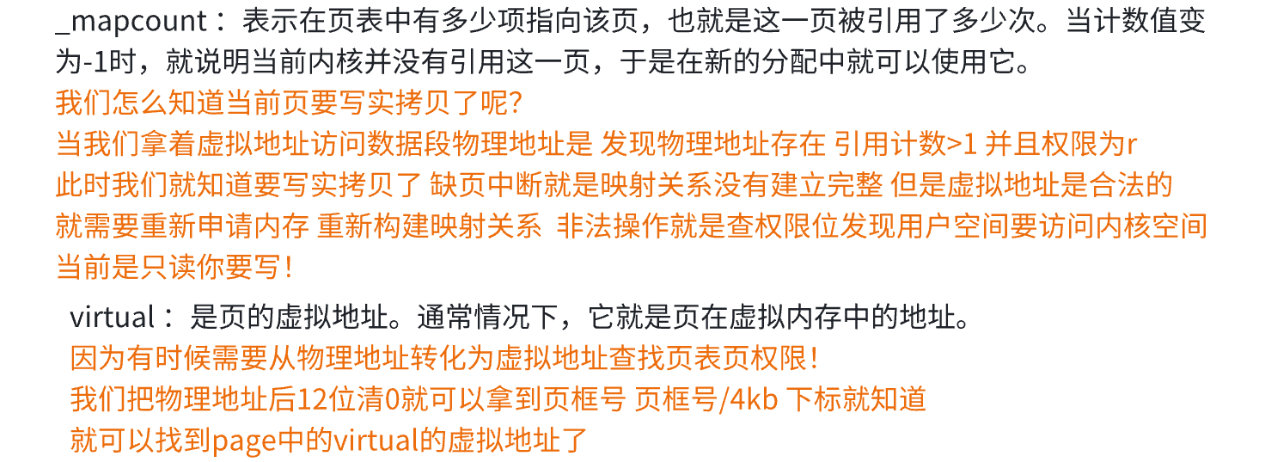
我们描述页框的结构体叫做 structure page , 他这个结构体必须非常小,因为他也要占据 page 的空间,所以它里面用到了联合体就是为了节省空间,还有一个 flag 标记位,表示该 4kb 有没有使用,是否锁定等。
由于需要管理大量页框,为节省内存空间,struct page 中大量使用了联合体(union)来共享内存空间。
cpp
/* include/linux/mm_types.h */
struct page {
    /* 原⼦标志,有些情况下会异步更新 */
    unsigned long flags;
    union {
        struct {
            /* 换出⻚列表,例如由zone->lru_lock保护的active_list */
            struct list_head lru;
            /* 如果最低为为0,则指向inode
            * address_space,或为NULL
            * 如果⻚映射为匿名内存,最低为置位
            * ⽽且该指针指向anon_vma对象
            */
            struct address_space* mapping;
            /* 在映射内的偏移量 */
            pgoff_t index;
            /*
            * 由映射私有,不透明数据
            * 如果设置了PagePrivate,通常⽤于buffer_heads
            * 如果设置了PageSwapCache,则⽤于swp_entry_t
            * 如果设置了PG_buddy,则⽤于表⽰伙伴系统中的阶
            */
            unsigned long private;
        };
        struct { /* slab, slob and slub */
            union {
                struct list_head slab_list; /* uses lru */
                struct { /* Partial pages */
                    struct page* next;
#ifdef CONFIG_64BIT
                    int pages; /* Nr of pages left */
                    int pobjects; /* Approximate count */
#else
                    short int pages;
                    short int pobjects;
#endif
                };
            };
            struct kmem_cache* slab_cache; /* not slob */
            /* Double-word boundary */
            void* freelist; /* first free object */
            union {
                void* s_mem; /* slab: first object */
                unsigned long counters; /* SLUB */
                struct { /* SLUB */
                    unsigned inuse : 16; /* ⽤于SLUB分配器:对象的数⽬ */
                    unsigned objects : 15;
                    unsigned frozen : 1;
                };
            };
        };
        ...
    };
    union {
        /* 内存管理⼦系统中映射的⻚表项计数,⽤于表⽰⻚是否已经映射,还⽤于限制逆向映射搜索*/
        atomic_t _mapcount;
        unsigned int page_type;
        unsigned int active; /* SLAB */
        int units; /* SLOB */
    };
    ...
#if defined(WANT_PAGE_VIRTUAL)
        /* 内核虚拟地址(如果没有映射则为NULL,即⾼端内存) */
        void* virtual;
#endif /* WANT_PAGE_VIRTUAL */
    ...
}
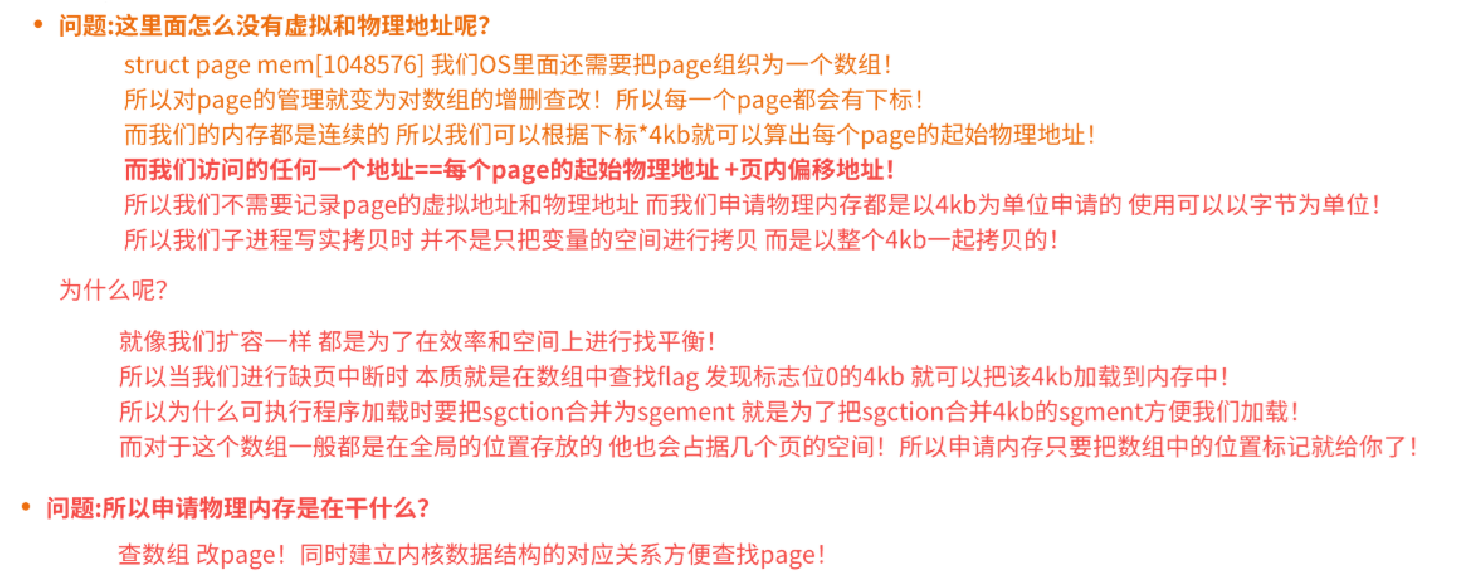
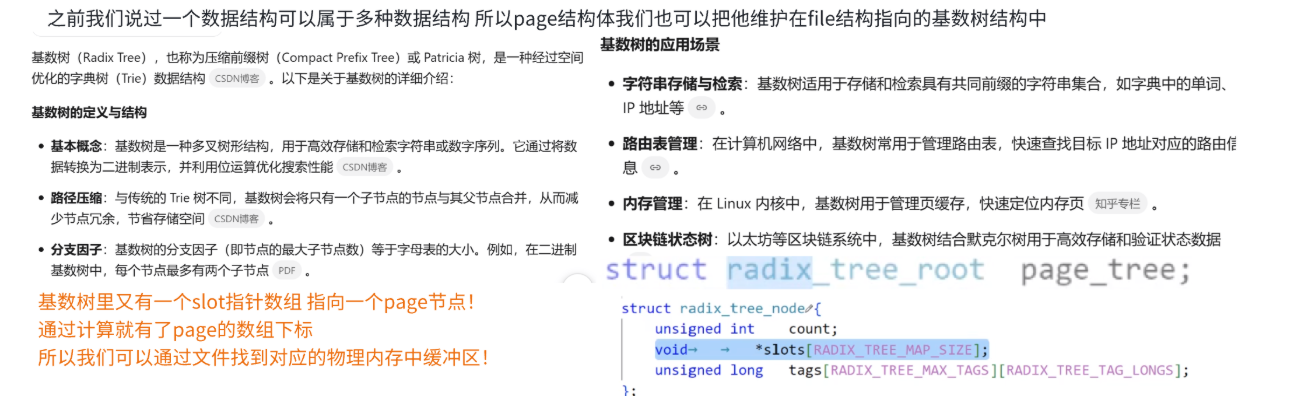
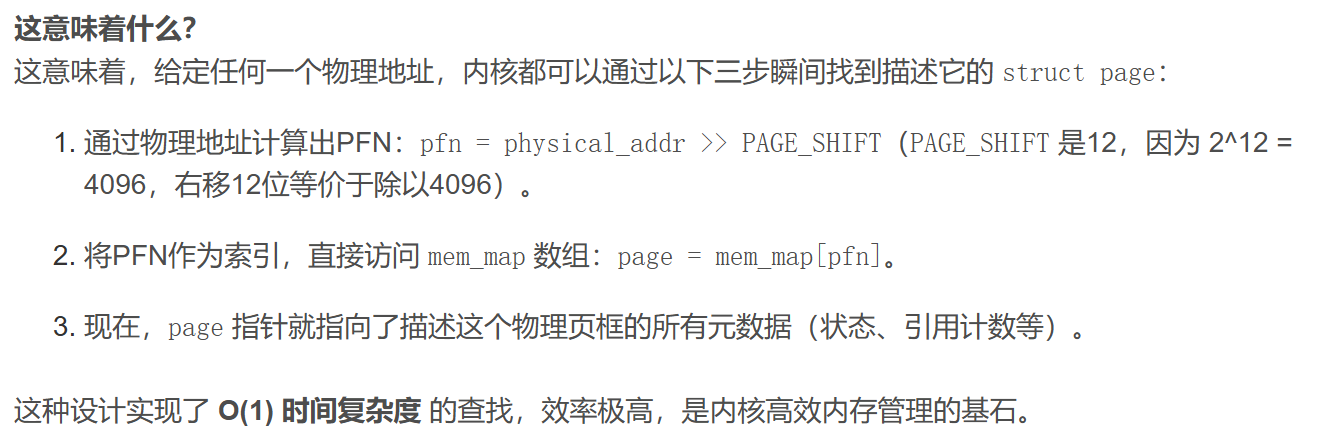
全局数组管理 :所有 struct page 存储在 mem_map 数组中,数组下标即物理页号(PFN),通过 PFN = (物理地址 >> 12) 可直接定位对应结构体 。
cpp
// 物理地址到 struct page 的转换
struct page *pfn_to_page(unsigned long pfn) {
    return &mem_map[pfn];
}
4、多级页表与页目录
页表中的每一个表项,指向一个物理页的开始地址。在 32 位系统中,虚拟内存的最大空间是 4GB , 这是每一个用户程序都拥有自己的虚拟内存空间。既然需要让 4GB 的虚拟内存全部可用,那么页表中就需要能够表示这所有的 4GB 空间,那么就一共需要 4GB/4KB = 1048576 个表项。如下图所示:
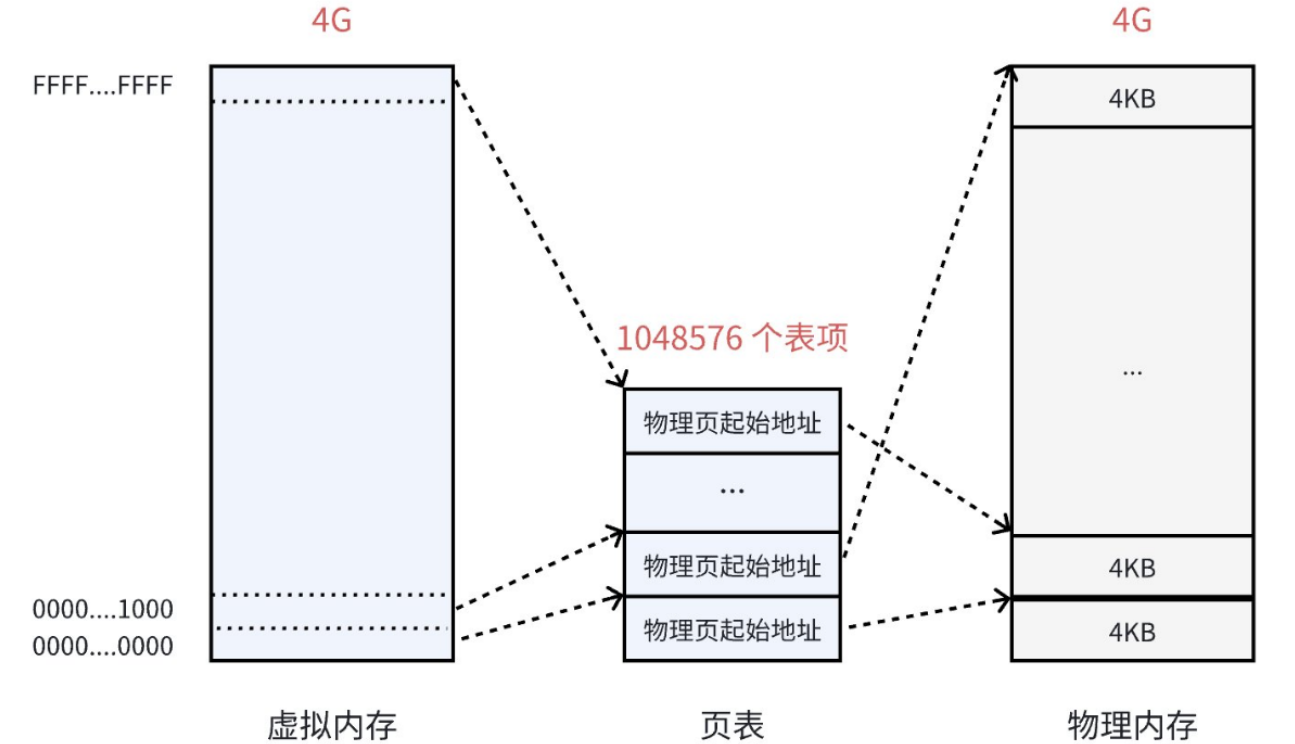
虚拟内存看上去被虚线"分割"成一个个单元,其实并不是真的分割,虚拟内存仍然是连续的。这个虚线的单元仅仅表示它与页表中每一个表项的映射关系,并最终映射到相同大小的一个物理内存页上。
页表中的物理地址,与物理内存之间,是随机的映射关系,哪里可用就指向哪里(物理页)。**虽然最终使用的物理内存是离散的,但是与虚拟内存对应的线性地址是连续的。**处理器在访问数据、获取指令时,使用的都是线性地址,只要它是连续的就可以了,最终都能够通过页表找到实际的物理地址。
为了解决物理内存的碎片问题,我们引入了页表这个"映射表",但这个映射表自身却可能面临需要大量连续内存的问题。
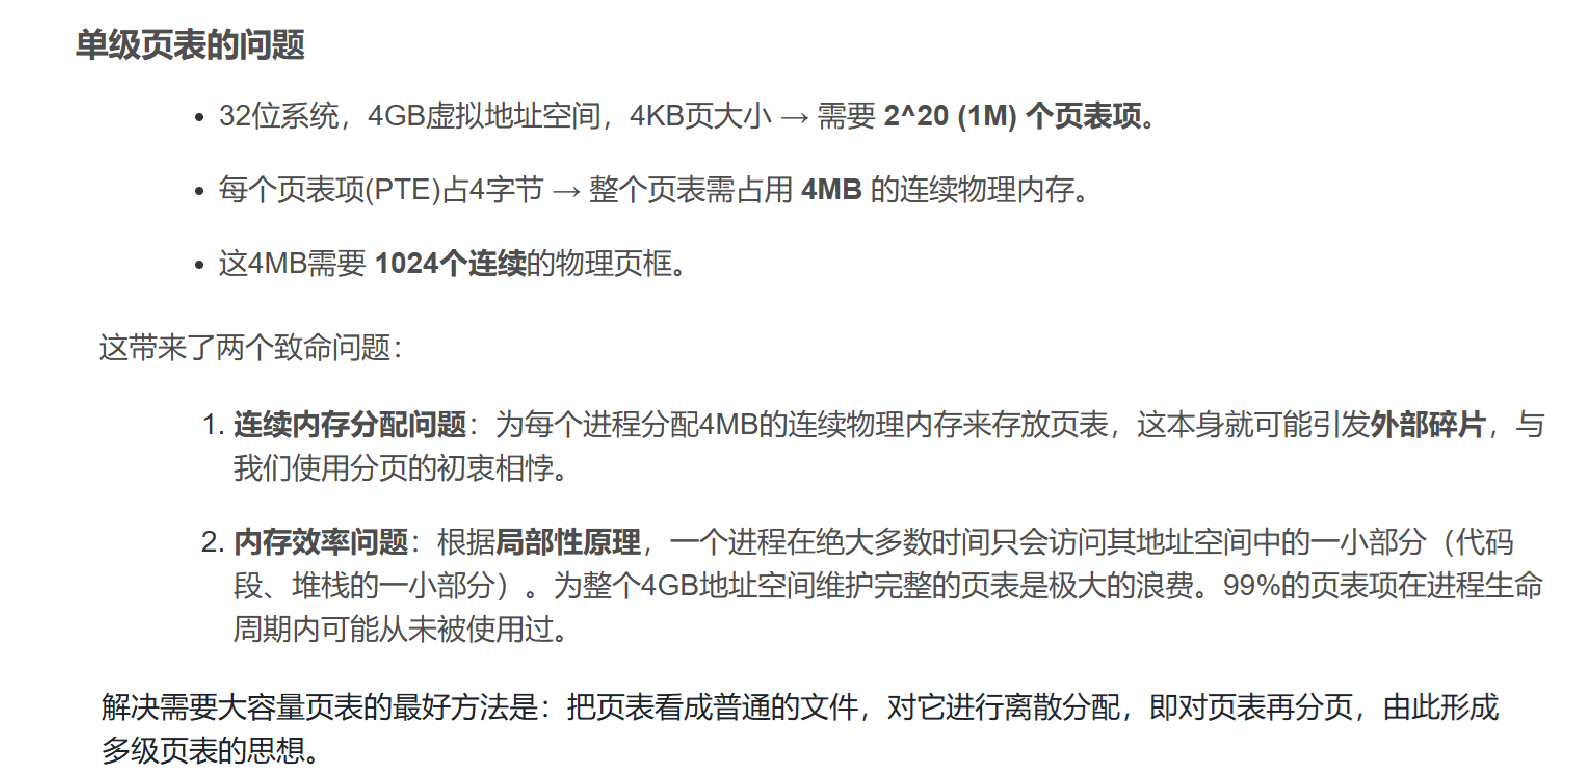
多级页表 是解决上述问题的经典方案,它采用了计算机科学中"分而治之 "和"按需分配"的思想。
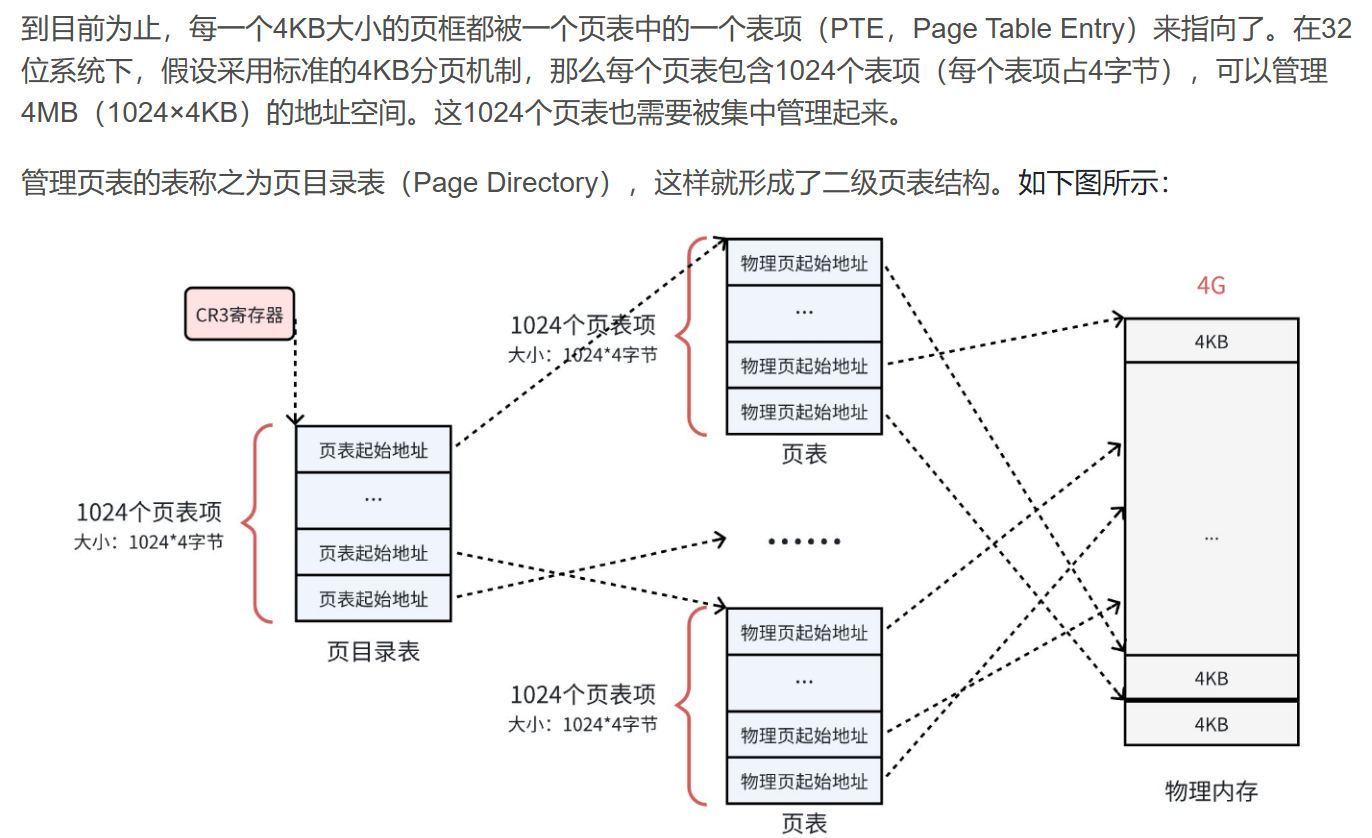
**核心思想:对页表本身进行分页:**将单一的大页表拆分成多个小页表(第二级页表,或更下级页表),然后再用一个顶级页表(第一级页表)来管理这些二级页表。
**工作流程(以经典的二级页表为例)**虚拟地址被划分为多个部分(以32位系统为例):
- 页目录索引 (高10 bits):用于在页目录表(Page Directory,第一级页表)中定位一个页目录项(PDE)
- 页表索引 (中间10 bits):PDE中包含了二级页表的物理基地址。用这个索引在找到的二级页表(Page Table)中定位一个页表项(PTE)
- 页内偏移 (低12 bits):PTE中包含了物理页框的基地址。用这个偏移量在物理页框内定位最终的字节。
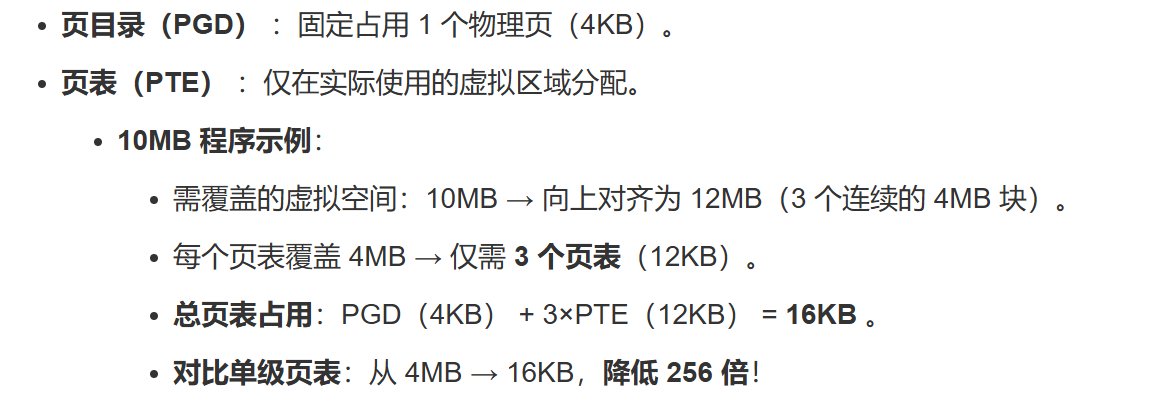
- 页目录(PGD) :包含 1,024 个表项,每个指向一个 页表(PTE) 的物理地址
- 页表(PTE) :包含 1,024 个表项,每个指向一个物理页框
- 每个表包含1,024个表项
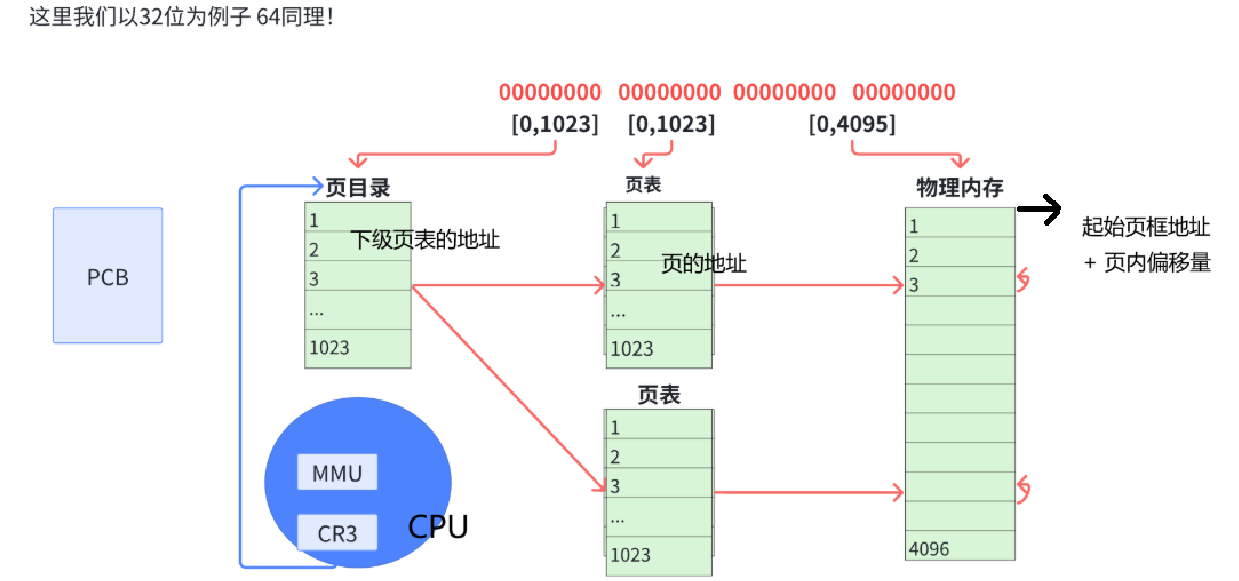
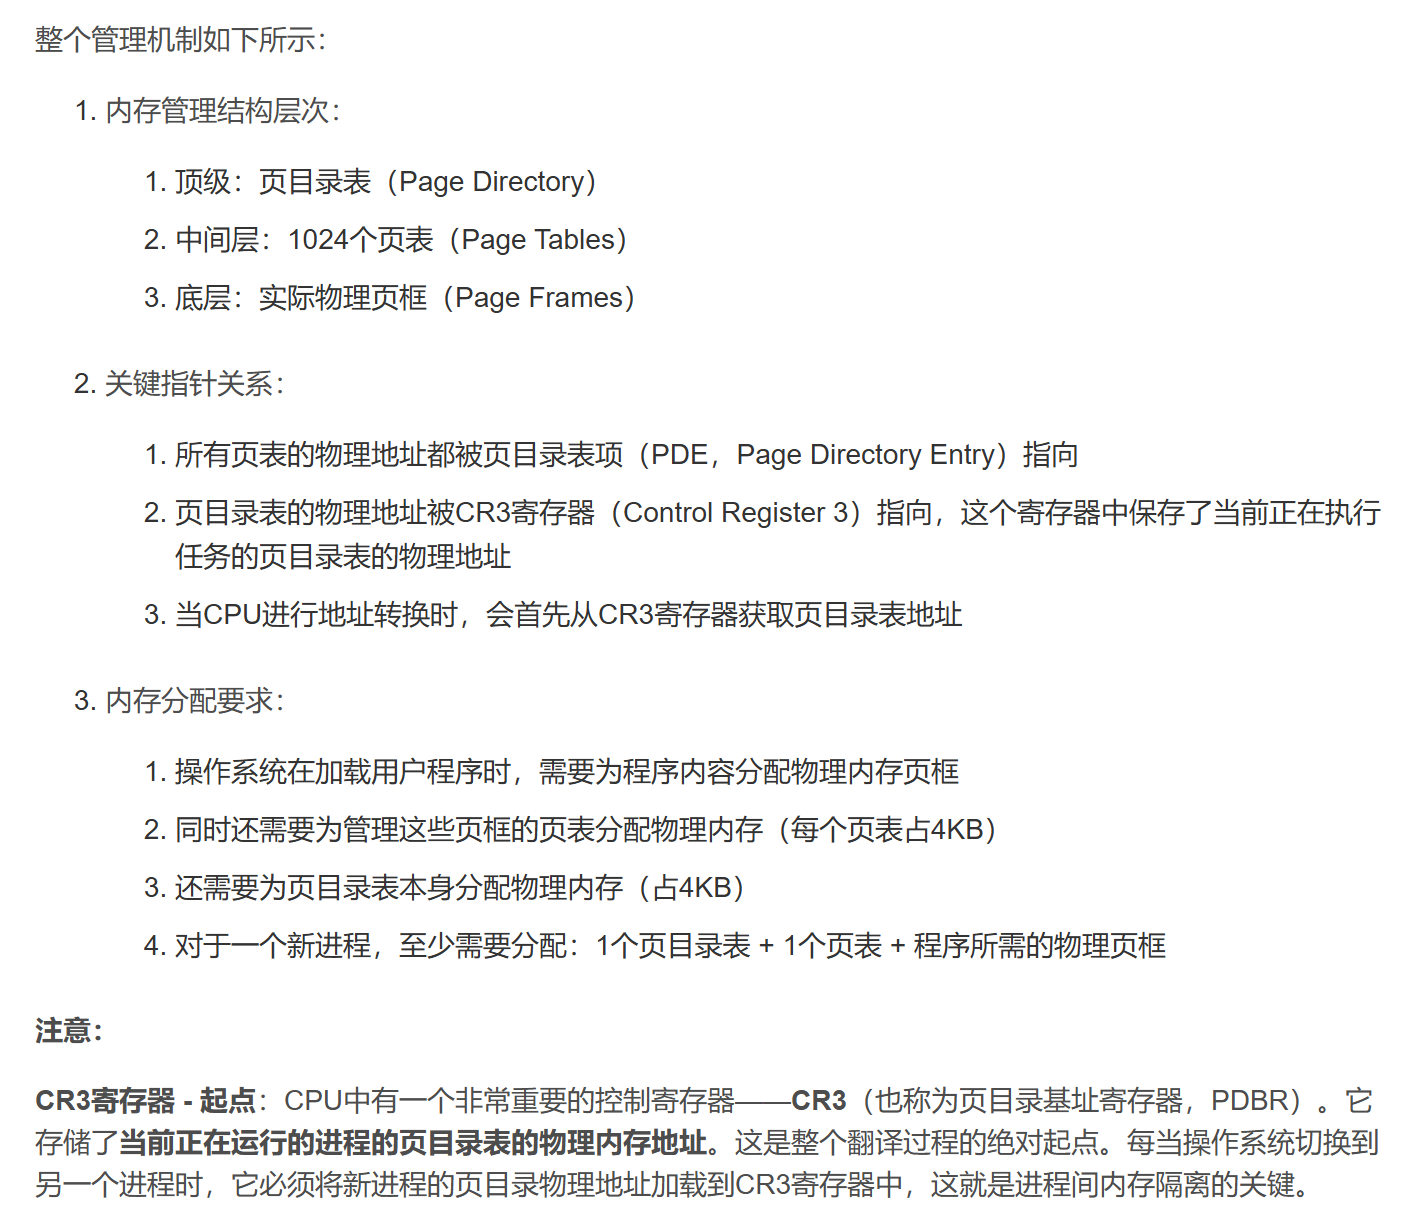
这样一来,1024(每个表中的表项个数) * 1024(表的个数),仍然可以覆盖 4GB 的物理内存空间。 这里的每一个表,就是真正的页表,所以一共有 1024 个页表。⼀个页表自身占用 4KB ,那么1024 个页表⼀共就占用了 4MB 的物理内存空间,和之前没差别啊?
从总数上看是这样,但是一个应用程序是不可能完全使用全部的 4GB 空间的,也许只要几十个页表就可以了。例如:一个用户程序的代码段、数据段、栈段,一共就需要 10 MB 的空间,那么使用 3 个页表就足够了。
**为什么是 12 位?**12 位数字是因为:页框大小是 4kb, 2^12 刚好就是 4kb ,刚好可以覆盖页框的整个范围。
**为什么是低位?**依据程序运行的局部性原理,当访问一个内存地址时,附近的内存地址也很可能在短期内被访问。如果使用低 12 位表示页内偏移,那么地址相近的字节只要它们的地址前若干位(高位部分,对应页号)相同,就意味着它们处于同一块页框中。这样一来,当从缓存中读取数据时,缓存命中率就更高,能够有效提升程序的运行效率 。
例如,假设虚拟地址是 32 位,高 20 位用来表示页号,低 12 位表示页内偏移。当 CPU 访问地址 0x00401234 时,高 20 位 0x00400 确定了页号,低 12 位 0x01234 确定了在该页框内的具体偏移位置,从而准确找到对应的数据。
总结:
- 执行流看到的资源,本质就是在合法情况下进程拥虚拟地址的数量,虚拟地址就是资源的代表
- 虚拟地址:(mm_struct + vm_area_struct)本质:进程资源的统计数据和整体数据
- 页表是一张虚拟地址到物理地址的地图
- 资源划分本质:就是地址空间划分
- 资源共享本质:就是虚拟地址共享
5、线程的深刻理解
- 线程进行资源划分的本质:划分地址空间,获得一定范围的合法虚拟地址,再本质上就是在划分页表
- 线程进行资源共享的本质:共享地址空间,再本质上就是对页表条目的共享
6、两级页表的地址转换(TLB)
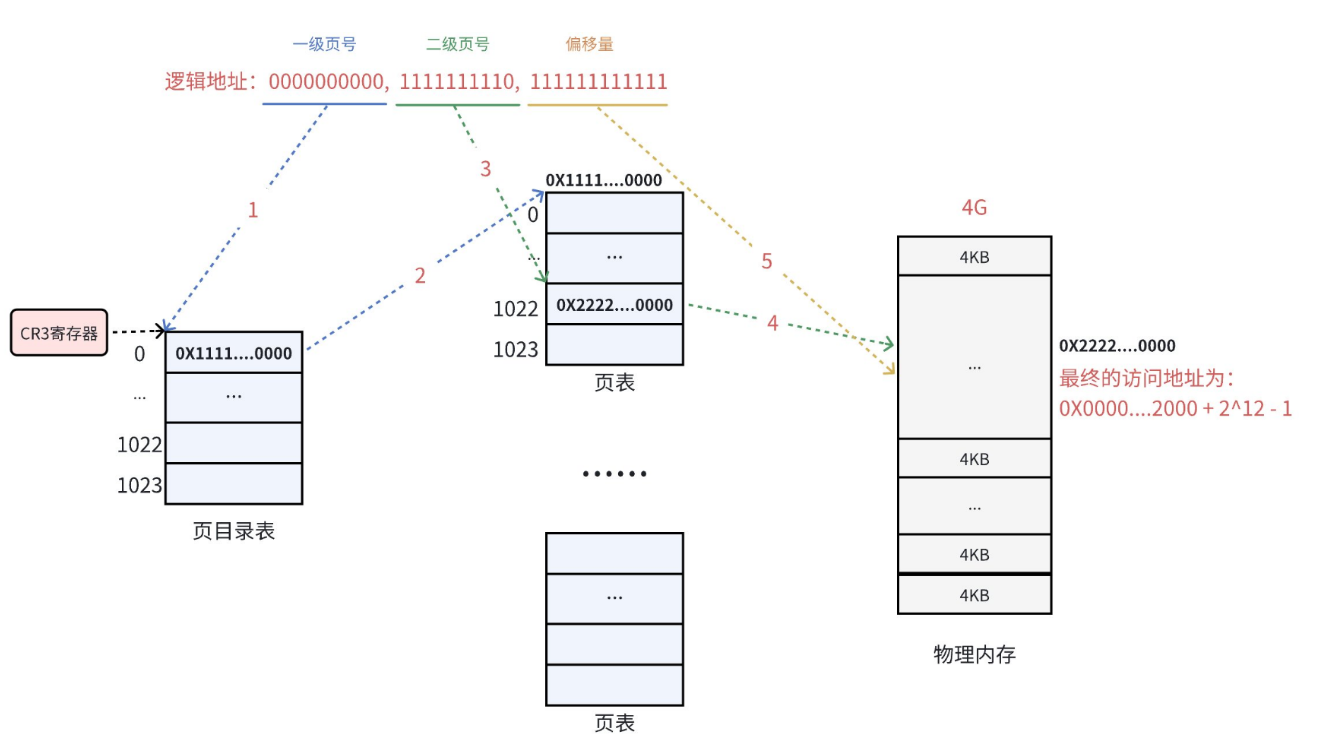
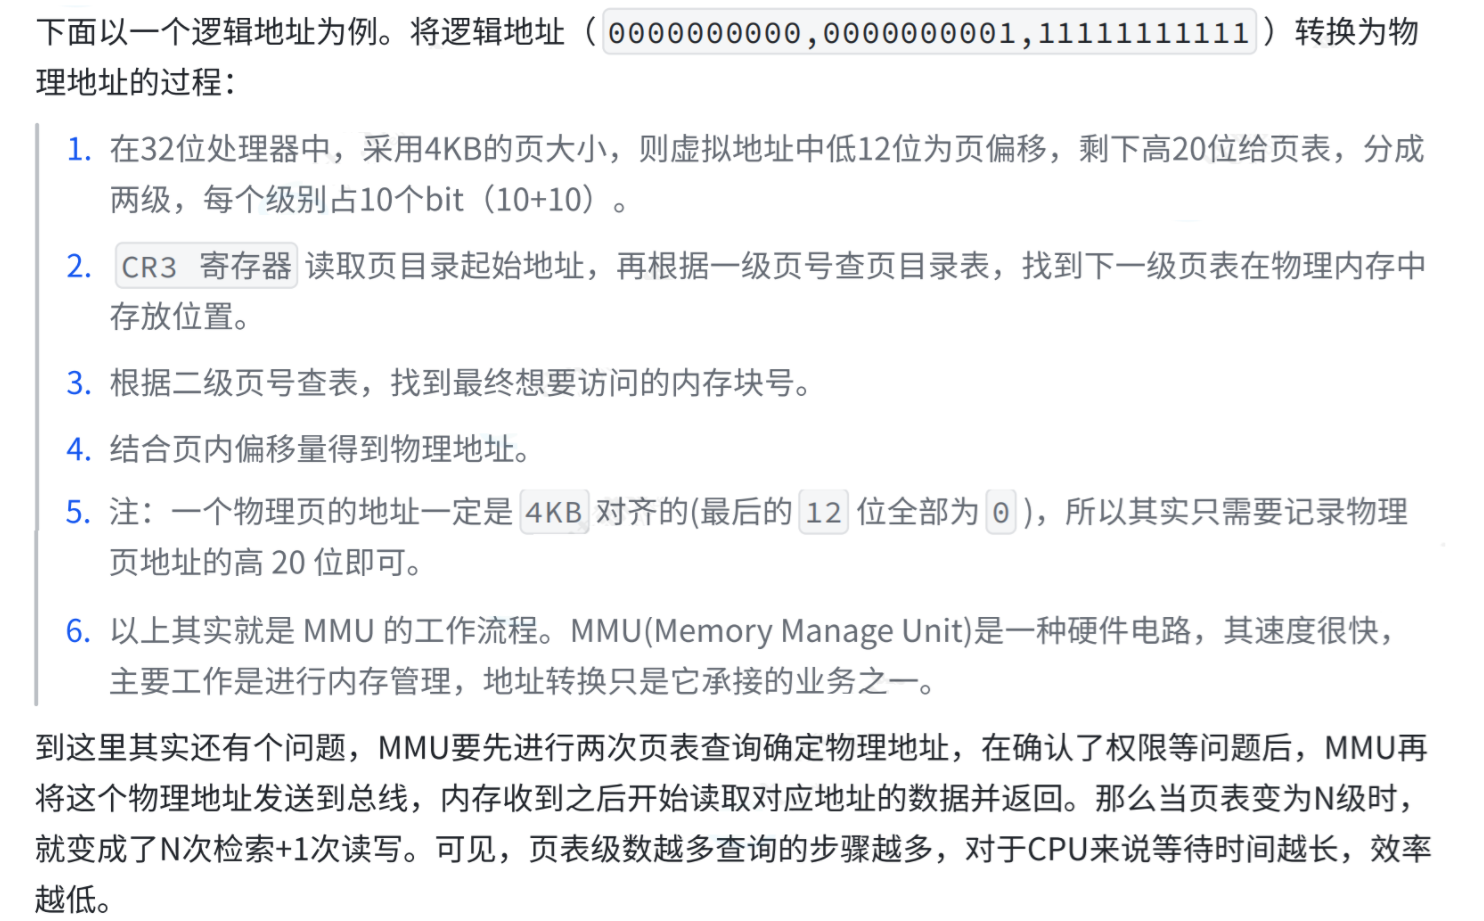
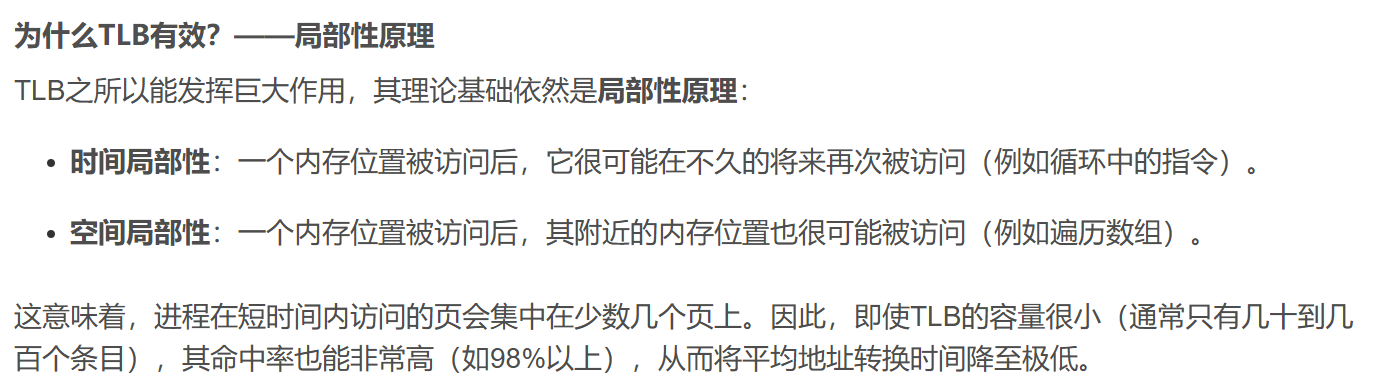
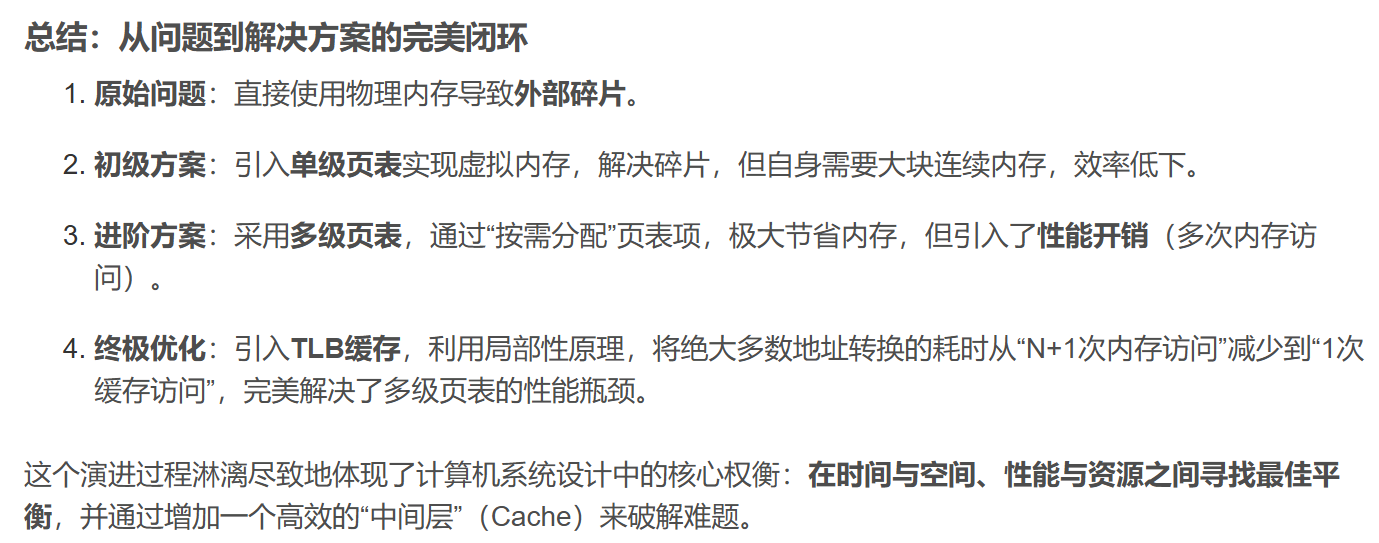
现在总结⼀下:单级页表对连续内存要求高,于是引⼊了多级页表,但是多级页表也是⼀把双刃剑,在减少连续存储要求且减少存储空间的同时降低了查询效率。
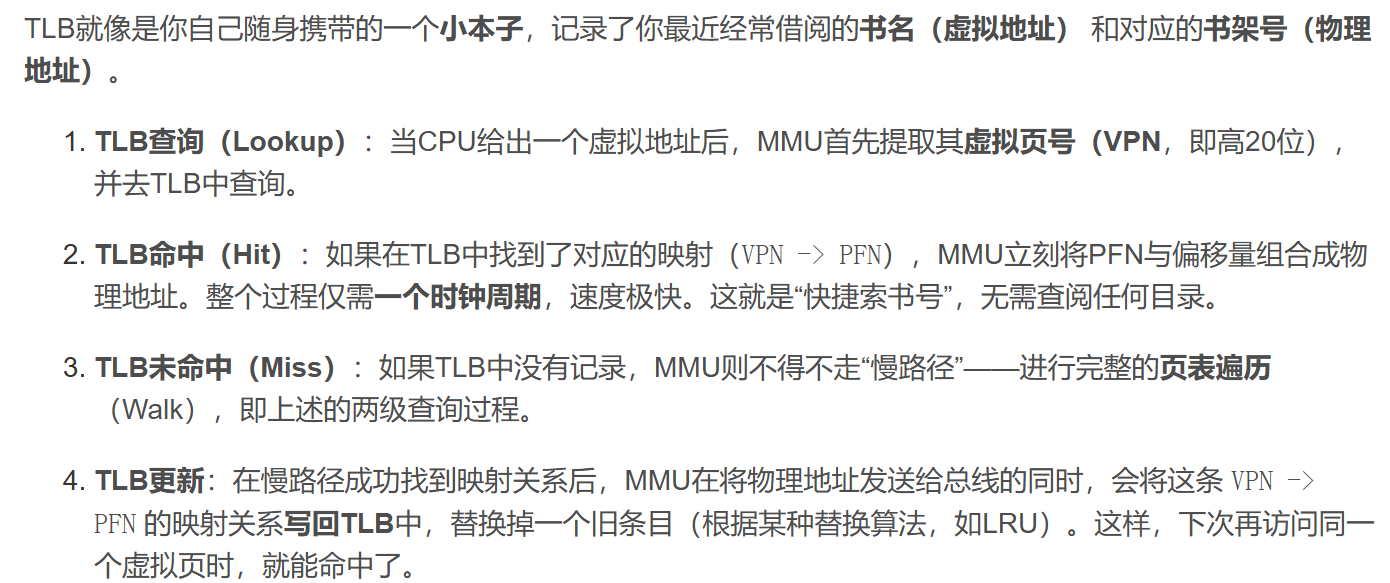
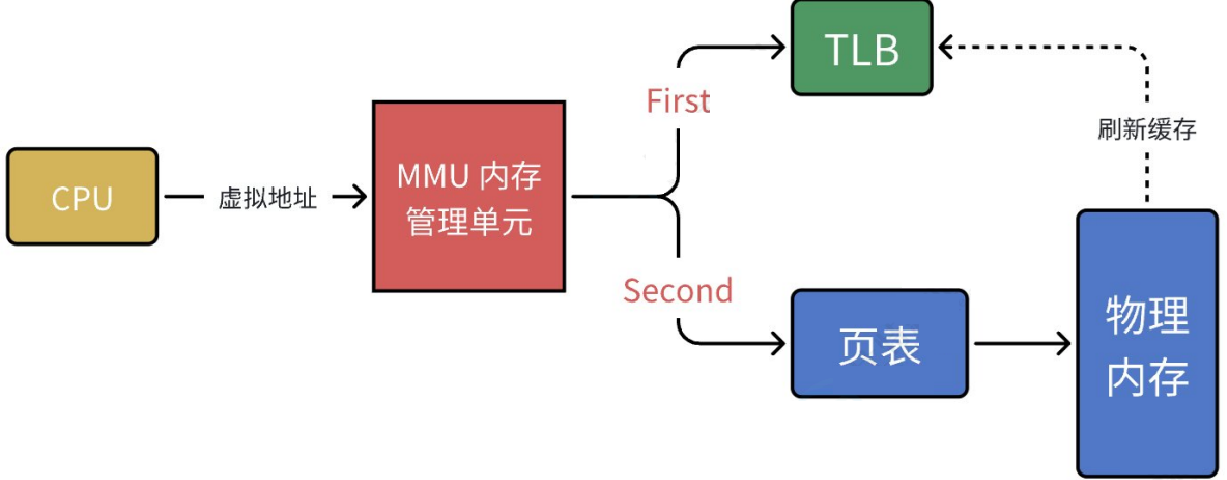
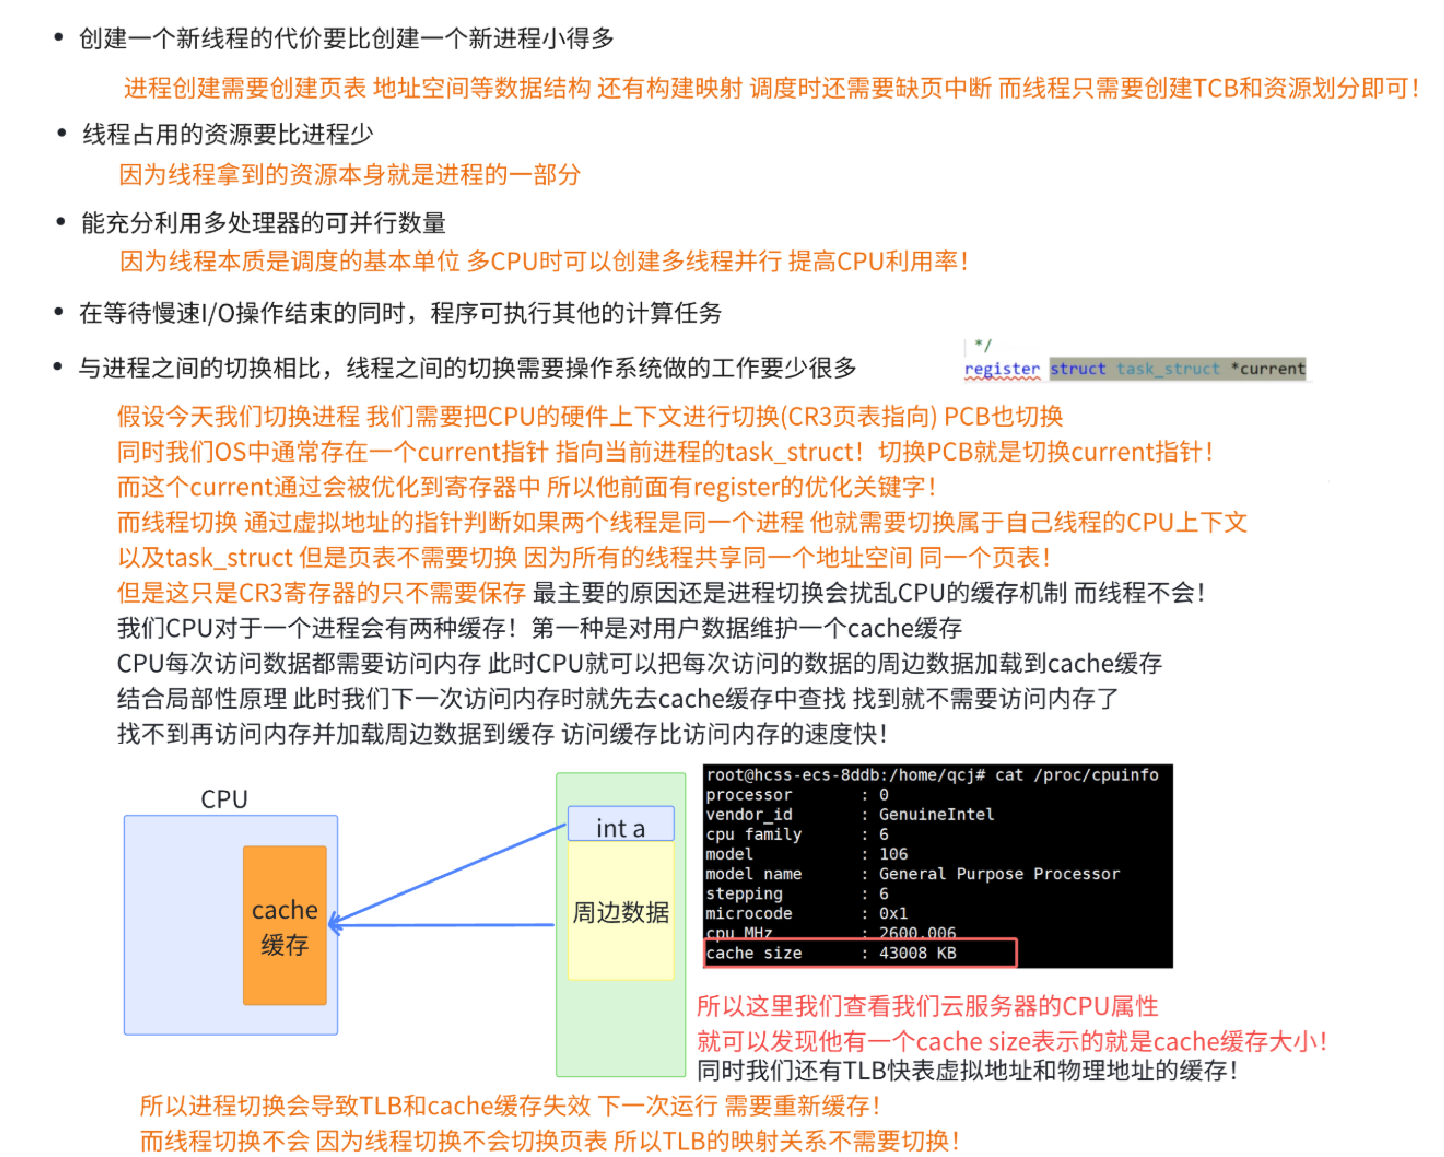
有没有提升效率的办法呢?计算机科学中的所有问题,都可以通过添加⼀个中间层来解决。MMU 引⼊ 了新武器,江湖⼈称快表的 TLB (其实,就是缓存,Translation Lookaside Buffer,学名转译后备缓冲器)
TLB 是集成在 MMU 内部的一个小型、专用的高速缓存(SRAM),其内容是虚拟页号 到物理页框号的映射关系。
当 CPU 给 MMU 传新虚拟地址之后, MMU 先去问 TLB 那边有没有,如果有就直接拿到物理地址发到 总线给内存,齐活。但 TLB 容量比较小,难免发生 Cache Miss ,这时候 MMU 还有保底的老武器 页表,在页表中找到之后 MMU 除了把地址发到总线传给内存,还把这条映射关系给到TLB ,让它记录 ⼀下刷新缓存。
7、缺页异常
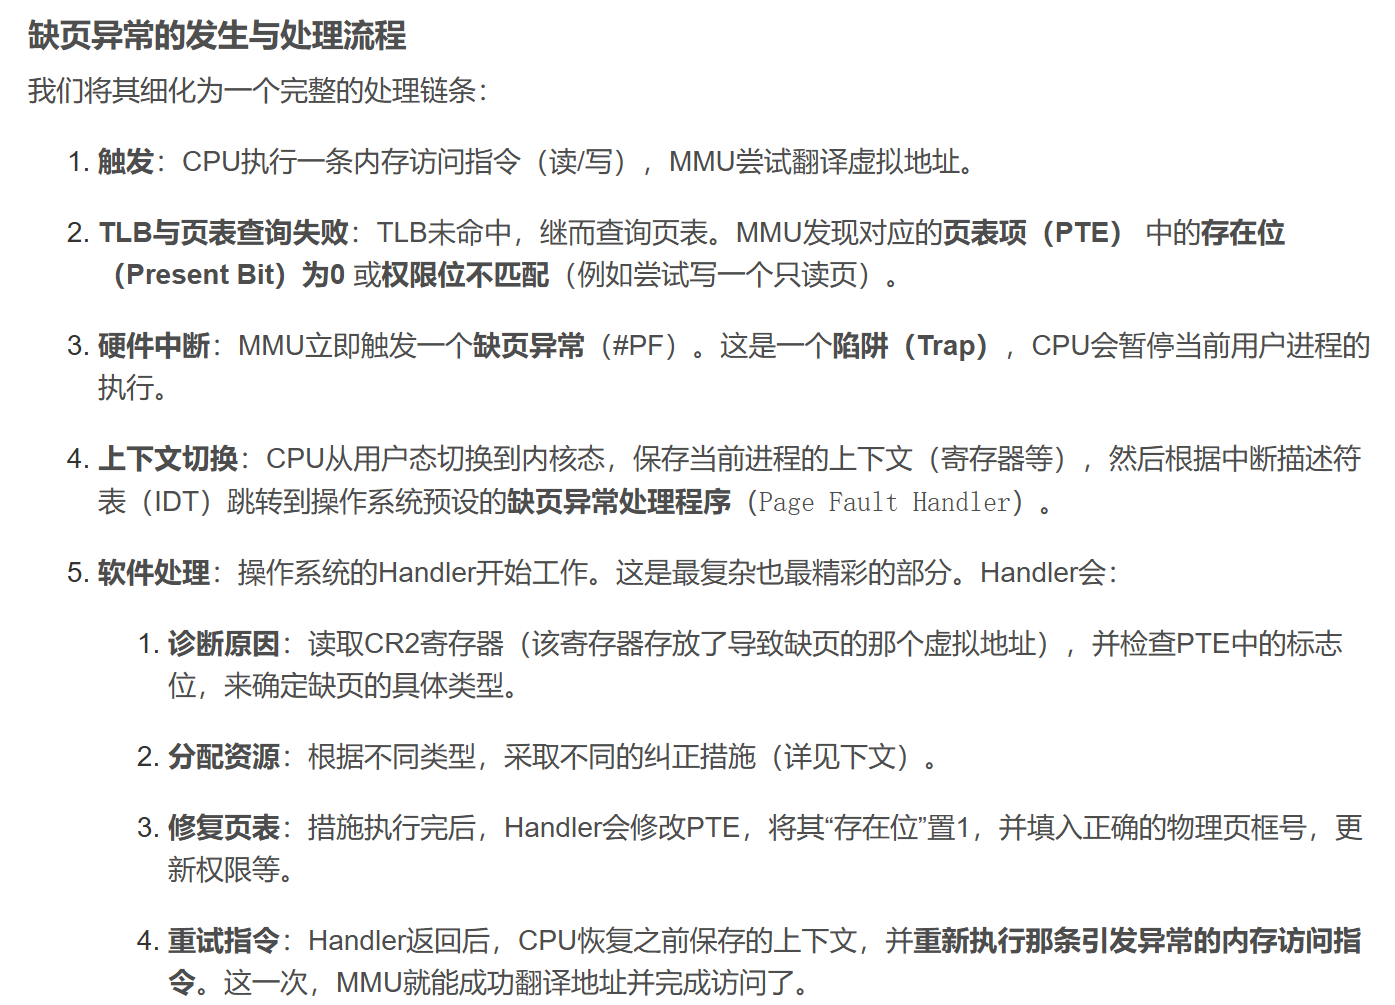
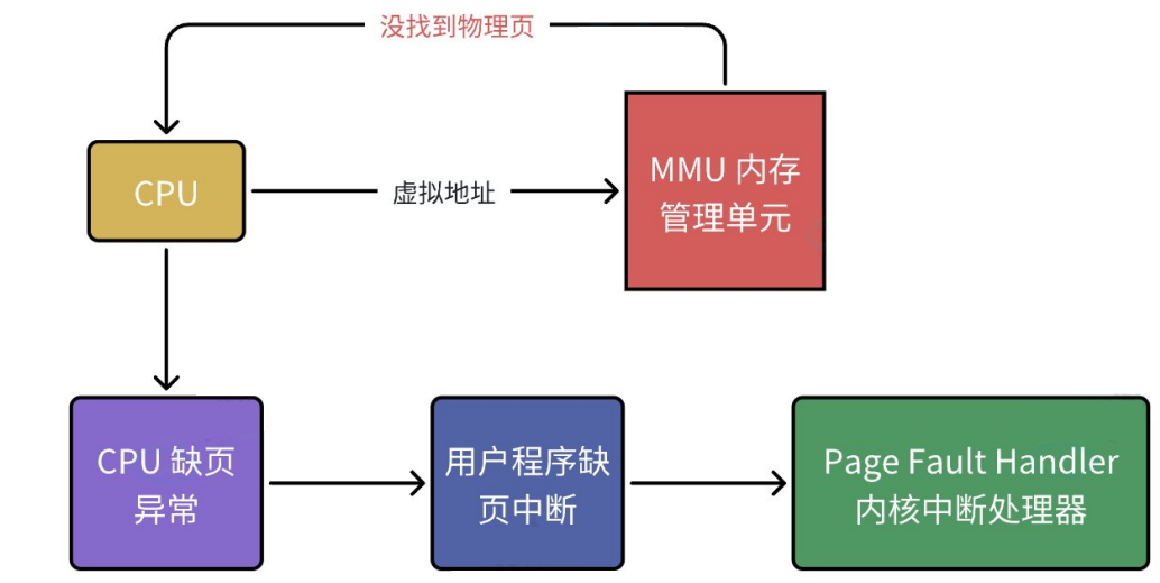
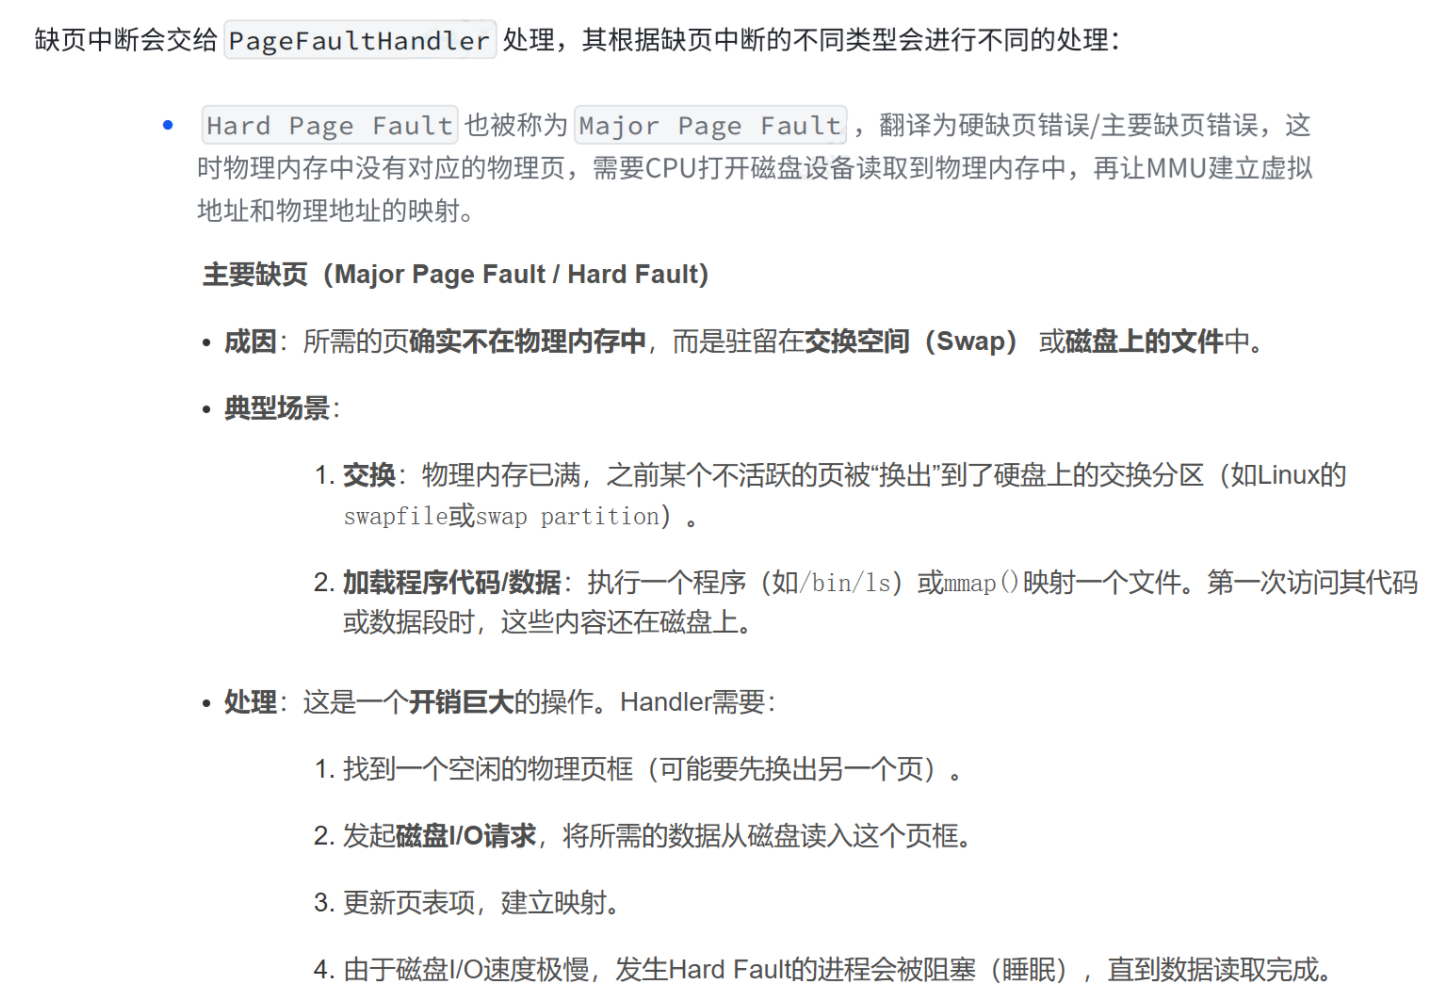
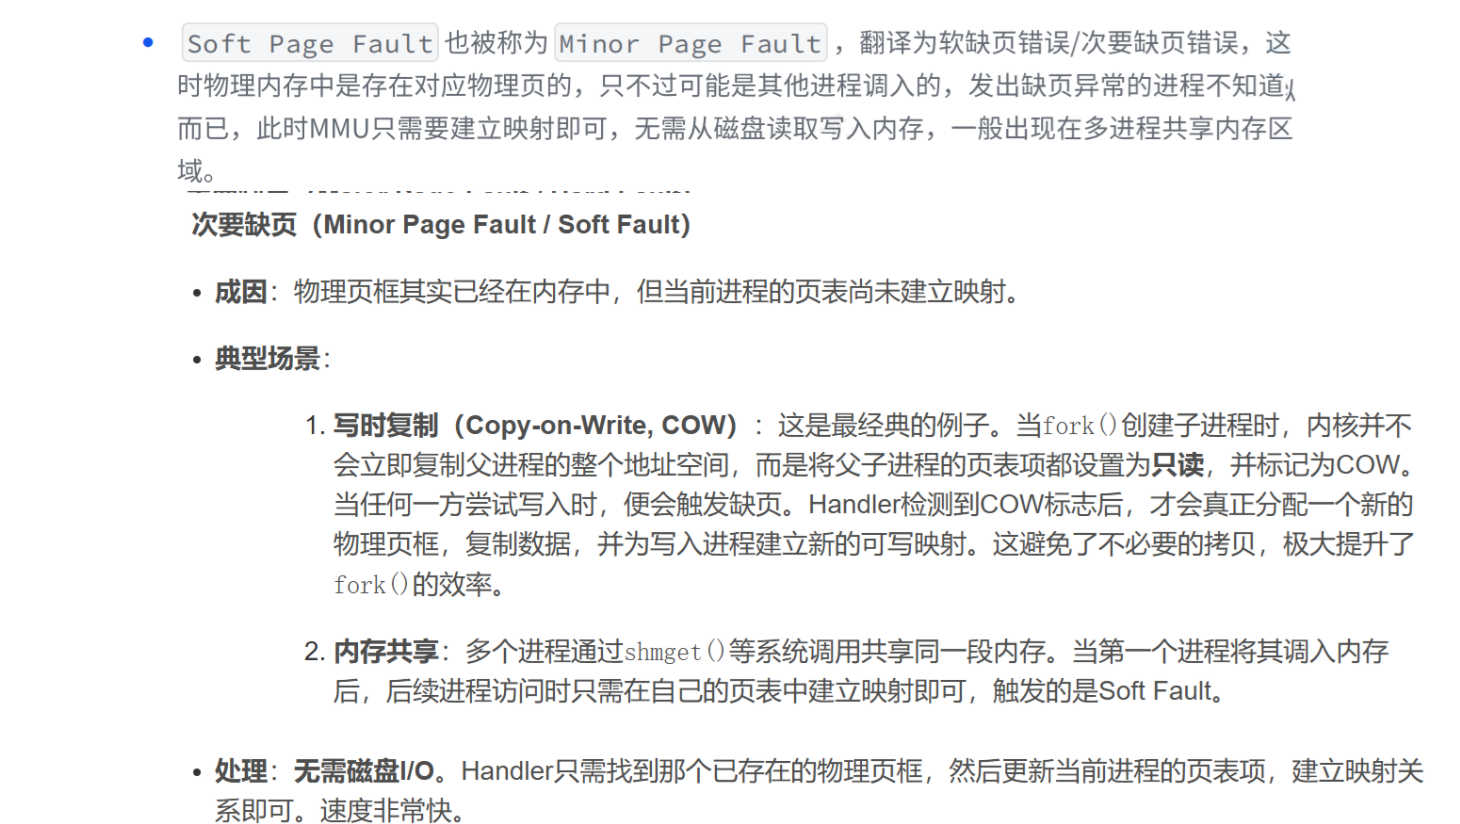
设想,CPU 给 MMU 的虚拟地址,在 TLB 和页表都没有找到对应的物理页,该怎么办呢?其实这就是缺页异常 Page Fault ,它是⼀个由硬件中断触发的可以由软件逻辑纠正的错误。
假如目标内存页在物理内存中没有对应的物理页或者存在但无对应权限,CPU 就无法获取数据,这种情况下 CPU 就会报告⼀个缺页错误。
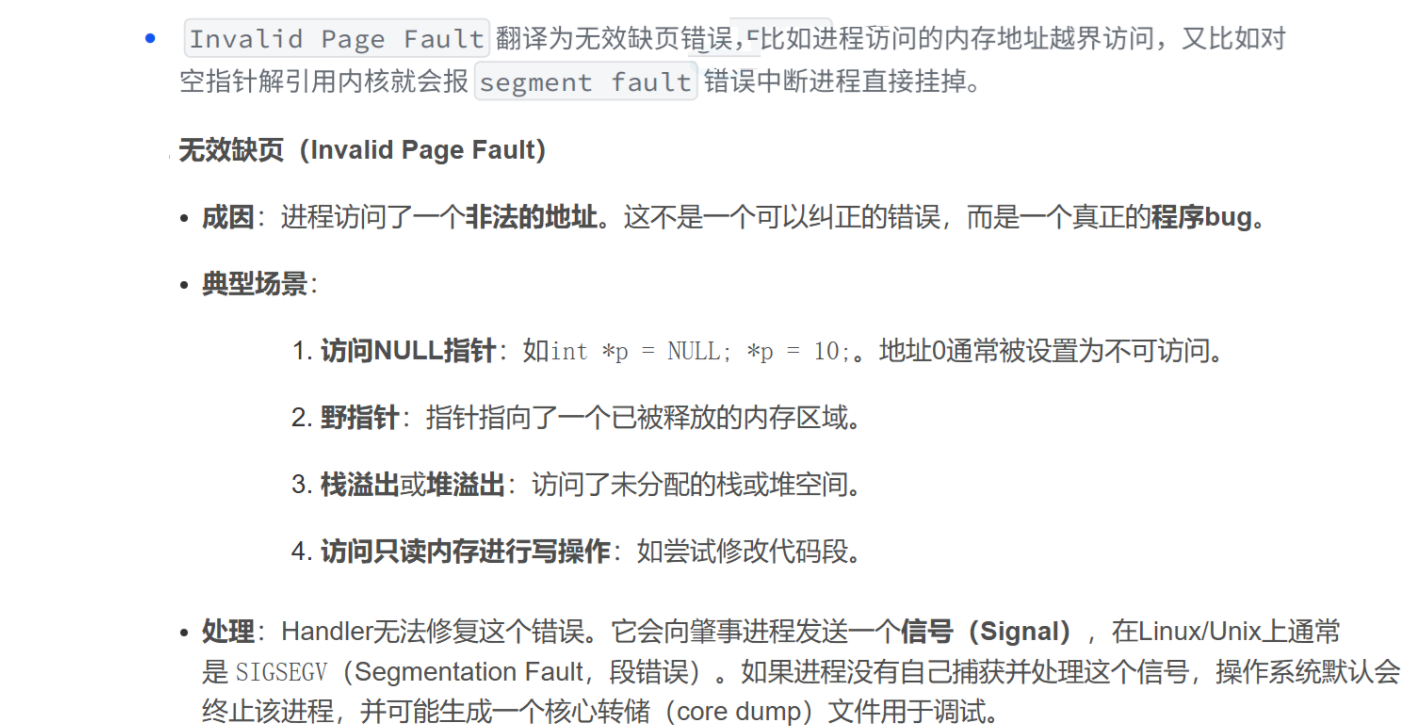
由于 CPU 没有数据就无法进行计算,CPU 罢工了用户进程也就出现了缺页中断,进程会从用户态切换到内核态,并将缺页中断交给内核的 Page Fault Handler 处理。
# 如何理解 new 和 malloc?
new(C++)和 malloc(C)在大多数现代操作系统中,并没有立即分配物理内存。它们只是在进程的虚拟地址空间中"预订"了一段地址范围(在堆上),并更新了内核中关于进程内存区域的数据结构(如VMA链表)。真正的物理内存分配,要延迟到第一次访问这块内存、触发缺页异常时才会发生。这是一种名为"延迟分配(Lazy Allocation)"的优化策略,避免了分配但永不使用的内存浪费。
# 如何理解写时拷贝(Copy-on-Write)?
如上文所述,COW 是 Soft Page Fault 的完美应用。它通过"拖延"拷贝操作,极大地提升了进程创建(
fork())的效率,并减少了内存消耗。只有在绝对必要时(写入时)才进行实际的拷贝。
# 申请内存,究竟是在干什么?
- 用户层:malloc/new 管理的是一个进程内部的堆内存池。它们从操作系统中申请大块内存(通过 brk 或 mmap 系统调用),然后自己切成小块分配给应用程序。这个过程主要是在管理虚拟地址空间。
- 内核层:当 brk/mmap 扩展了进程的地址空间后,内核只是记录了该进程拥有了一段新的、合法的地址范围(VMA)。真正的物理内存页框,要等到缺页异常发生时才会分配。
# 如何区分缺页与越界?内核如何检查页号合法性?
内核在缺页异常处理程序中,第一步就是进行合法性检查 。它通过查询进程的虚拟内存区域(VMA)链表来实现:
VMA:内核为每个进程维护一个数据结构链表,每个节点描述了一段连续的虚拟地址空间(如代码段、数据段、堆、栈、共享库等)及其属性(读、写、执行、是否共享等)。
检查过程 :当缺页发生在地址 addr时,Handler 遍历该进程的 VMA 链表,检查
addr是否落在某个 VMA 所描述的合法区间内。
如果落在某个VMA内 :这是一个合法的访问,缺页是因为物理页尚未分配(Hard Fault)或映射未建立(Soft Fault)。Handler 会继续分配页面或建立映射。
如果不在任何VMA内 :这是一个非法的访问(越界),即 Invalid Page Fault。Handler 会直接给进程发送 SIGSEGV 信号终止它。
# 越界了一定会报错吗?
不一定。 这取决于越界的那块地址是否碰巧落在另一个合法的 VMA 区间内。
如果越界访问跳到了一个未分配的、空洞的地址 ,会立刻触发
SIGSEGV。如果越界访问跳到了另一个已分配的区域 (例如,堆溢出覆盖了堆后的另一个数据结构),那么这次写入在硬件层面是"合法"的,不会立即报错。但这会导致 silent data corruption (静默数据破坏),是更难调试的严重 bug。工具如 Valgrind 就是通过模拟页表并记录所有合法分配来检测这类错误。
三、线程的优缺点
1、优点
2、缺点
四、线程异常
五、线程用途
六、进程 vs 线程
1、进程和线程

2、进程的多个线程共享
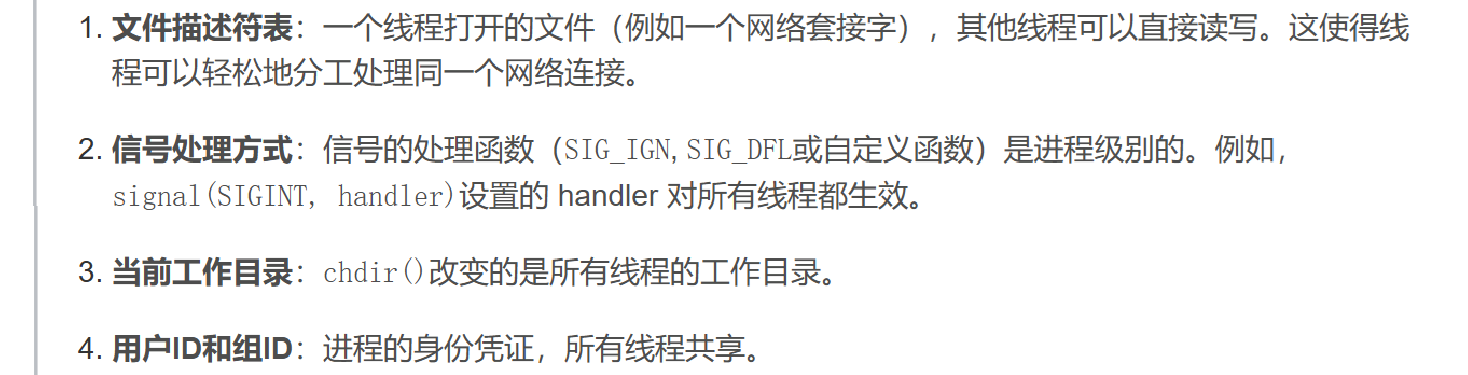
同⼀地址空间,因此 Text Segment 、 Data Segment 都是共享的,如果定义⼀个函数,在各线程中 都可以调用,如果定义⼀个全局变量,在各线程中都可以访问到,除此之外,各线程还共享以下进程资源和环境。
bash
      +-------------------------------------------------------+
      |                  Process (资源容器)                    |
      |  PID = 1234                                           |
      |-------------------------------------------------------|
      |  ┌─────────────────────────────────────────────────┐  |
      |  |             Virtual Address Space               |  |
      |  |                                                 |  |
      |  |  Code Segment  (共享) - printf, main, ...        |  |
      |  |  Data Segment  (共享) - global_var, static_var   |  |
      |  |  Heap          (共享) - malloc'd memory          |  |
      |  |                                                 |  |
      |  |  ┌─────────────┐  ┌─────────────┐  ┌─────────┐  |  |
      |  |  | Thread 1    |  | Thread 2    |  | ...     |  |  |
      |  |  | Stack       |  | Stack       |  |         |  |  |
      |  |  | (私有)       |  | (私有)      |  |         |  |  |
      |  |  |-------------|  |-------------|  |         |  |  |
      |  |  | TID = 4567  |  | TID = 4568  |  |         |  |  |
      |  |  | Registers   |  | Registers   |  |         |  |  |
      |  |  | (私有)       |  | (私有)      |  |         |  |  |
      |  |  └─────────────┘  └─────────────┘  └─────────┘  |  |
      |  |                                                 |  |
      |  └─────────────────────────────────────────────────┘  |
      |                                                       |
      |  文件描述符表 (共享) - fd0, fd1, fd2 (socket, file)      |
      |  信号处理方式 (共享) - SIGINT -> handler()               |
      |  用户ID/组ID (共享) - uid=1000, gid=1000                |
+-------------------------------------------------------+这张图直观地展示了:线程是进程地址空间内的一个执行实体,它既共享容器的广阔资源,又保有自己独立的"工作台"(栈和上下文)。
进程和线程的关系如下图: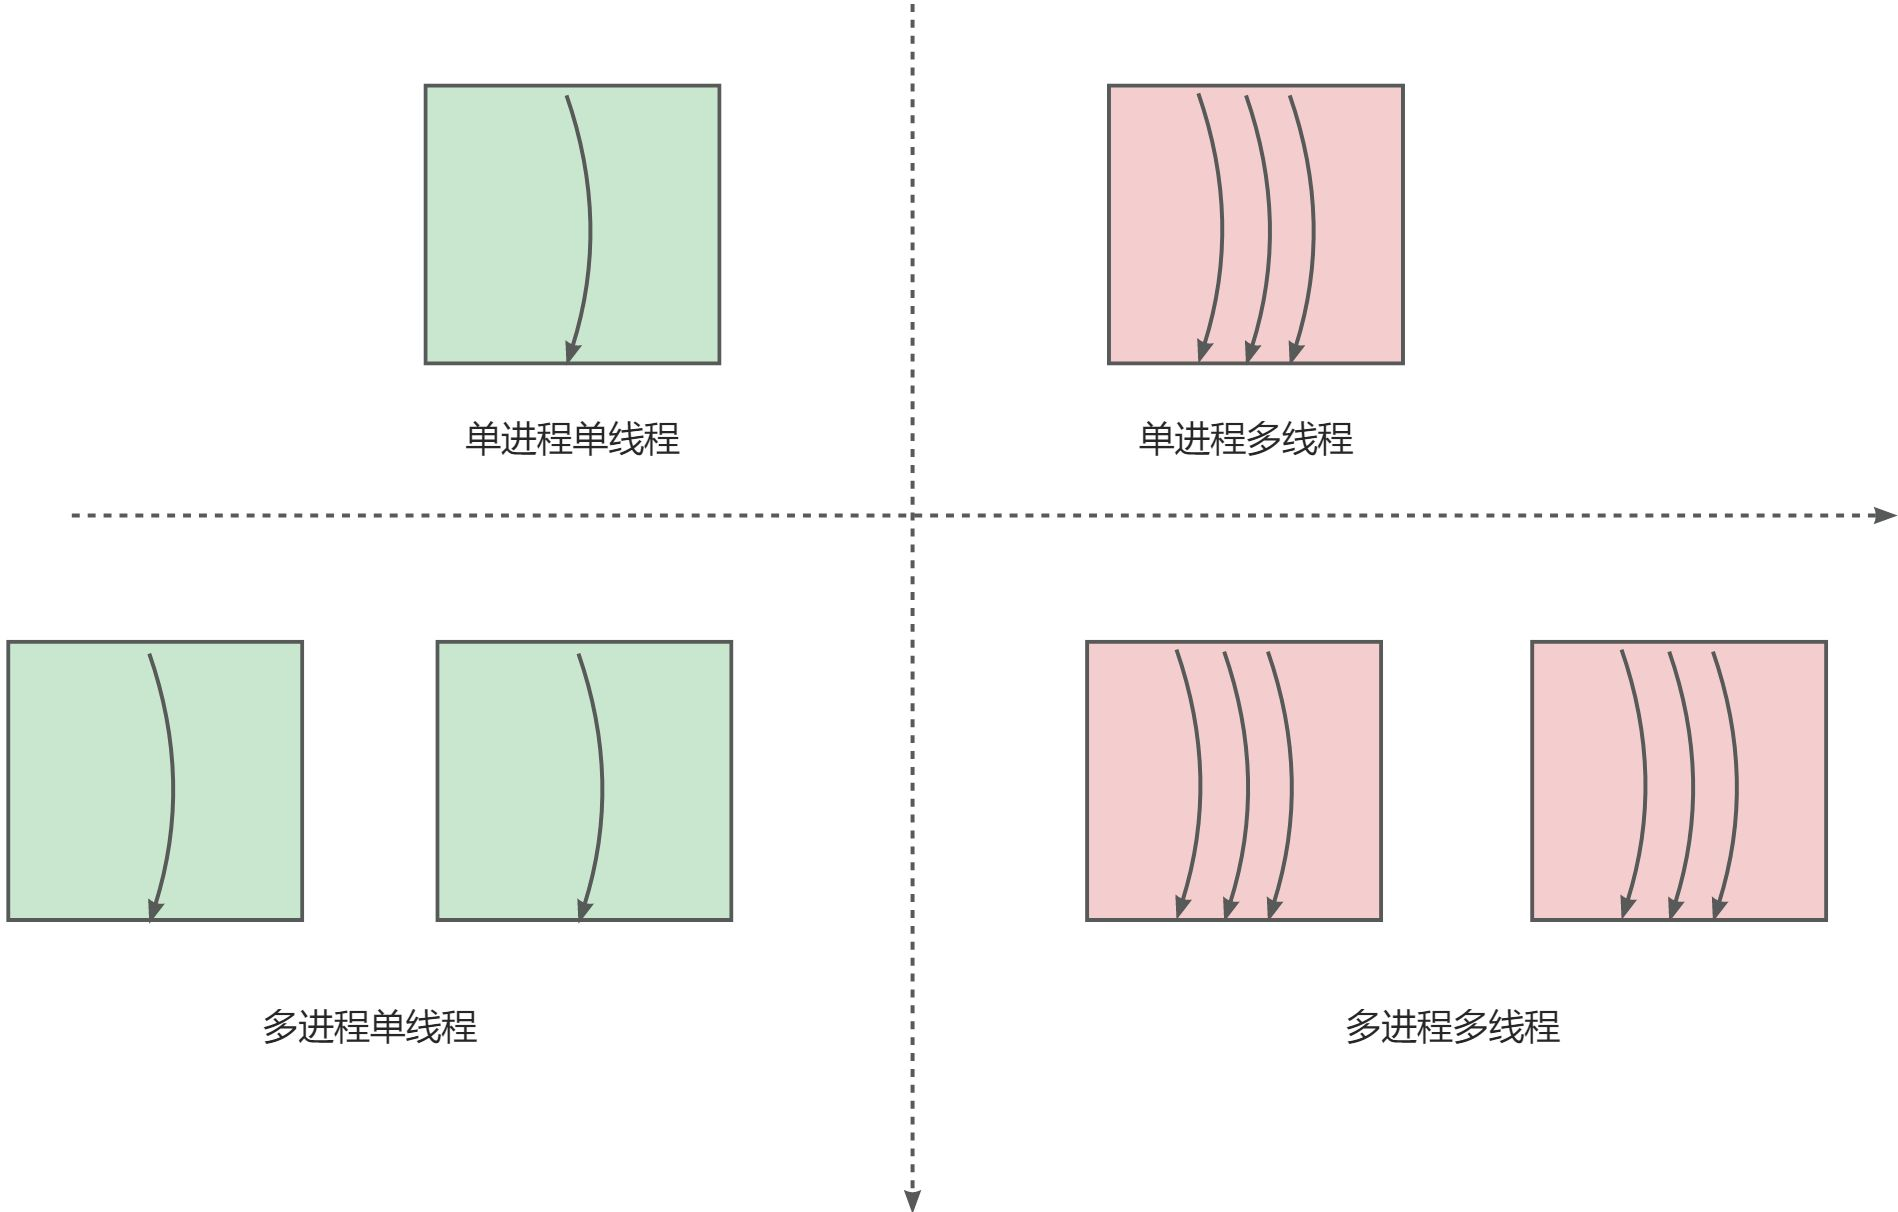
3、关于进程线程的问题