缓存预热
- 缓存预热是指在系统启动或服务重启后,提前将热点数据加载到缓存中的策略,目的是避免冷启动时缓存为空导致大量请求直接穿透到数据库
主要目的
- 解决冷启动问题:新系统上线或重启时缓存为空,首次请求会直接访问数据库,可能引发雪崩效应
- 提升缓存命中率:预先加载热点数据,减少用户请求时的数据库查询压力
- 缓解数据库负载:避免高并发流量瞬间冲击数据库,尤其是系统初期或流量高峰时段
实现方式
- 手动操作:通过刷新页面或脚本主动加载数据
- 自动加载:项目启动时执行初始化逻辑,将常用数据写入缓存
- 定时任务:结合定时器定期更新热点数据
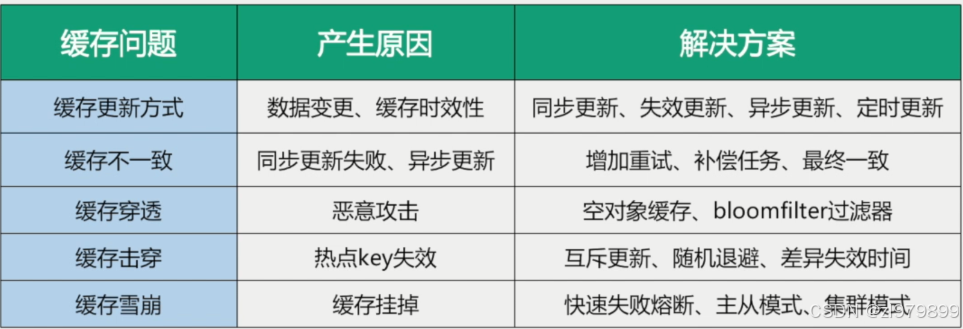
缓存穿透
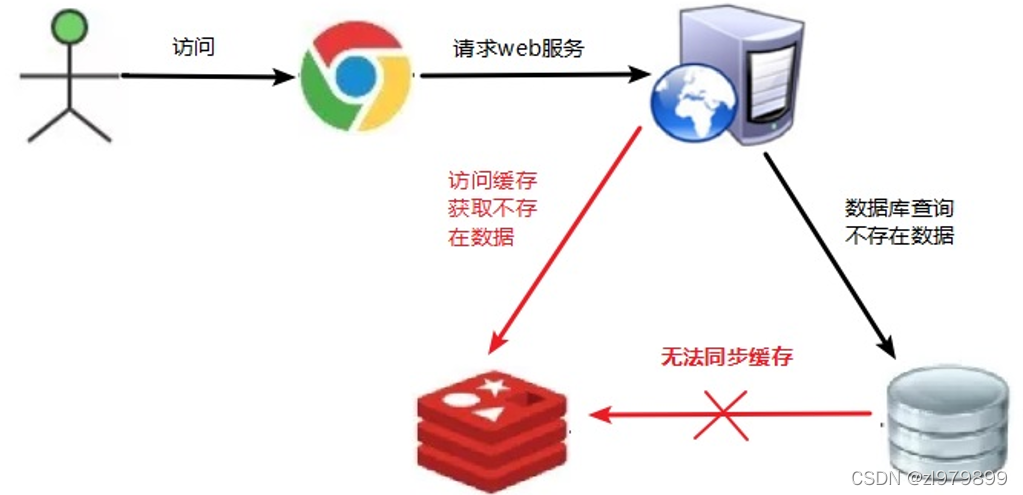
- key对应的数据在数据源并不存在,每次针对此key的请求从缓存获取不到,请求都会压到数据源,从而可能压垮数据源
- 比如用一个不存在的用户id获取用户信息,不论缓存还是数据库都没有,若黑客利用此漏洞进行攻击可能压垮数据库
解决方式
对空值缓存
- 如果一个查询返回的数据为空(不管是数据是否不存在),我们仍然把这个空结果(null)进行缓存
- value为null 不代表不占用内存空间,空值做了缓存,意味着缓存层中存了更多的键,需要更多的内存空间,因此可以设置空结果一个很短的过期时间,比如最长不超过五分钟
- 缓存层和存储层的数据可能会有一段时间窗口的不一致,可能会对业务有一定影响。例如过期时间设置为5分钟,如果此时存储层添加了这个数据,那此段时间就会出现缓存层和存储层数据的不一致,此时可以利用消息系统或者其他方式清除掉缓存层中的空对象
设置可访问的名单(白名单)
- 使用bitmaps类型定义一个可以访问的名单,名单id作为bitmaps的偏移量,每次访问和bitmaps里面的id进行比较,如果访问id不在bitmaps里面,进行拦截,不允许访问
采用布隆过滤器
- 布隆过滤器(Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量(位图)和一系列随机映射函数(哈希函数)
- 布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都远远超过一般的算法,缺点是有一定的误识别率和删除困难
- 将所有可能存在的数据哈希到一个足够大的bitmaps中,一个一定不存在的数据会被这个bitmaps拦截掉,从而避免了对底层存储系统的查询压力
- 在访问缓存层和存储层之前,将存在的key用布隆过滤器提前保存起来,做第一层拦截,当收到一个对key请求时先用布隆过滤器验证是key否存在,如果存在再进入缓存层、存储层
进行实时监控
- 当发现Redis的命中率开始急速降低,需要排查访问对象和访问的数据,和运维人员配合,可以设置黑名单限制服务
方案对比
|-------|-------------------|------------------------|
| 解决方案 | 适用场景 | 维护成本 |
| 缓存空对象 | 数据命中不高 数据频繁变化实时性高 | 代码维护简单 需要过多的缓存空间 数据不一致 |
| 布隆过滤器 | 数据命中不高 数据相对固定实时性低 | 代码维护复杂 缓存空间占用少 |
缓存击穿
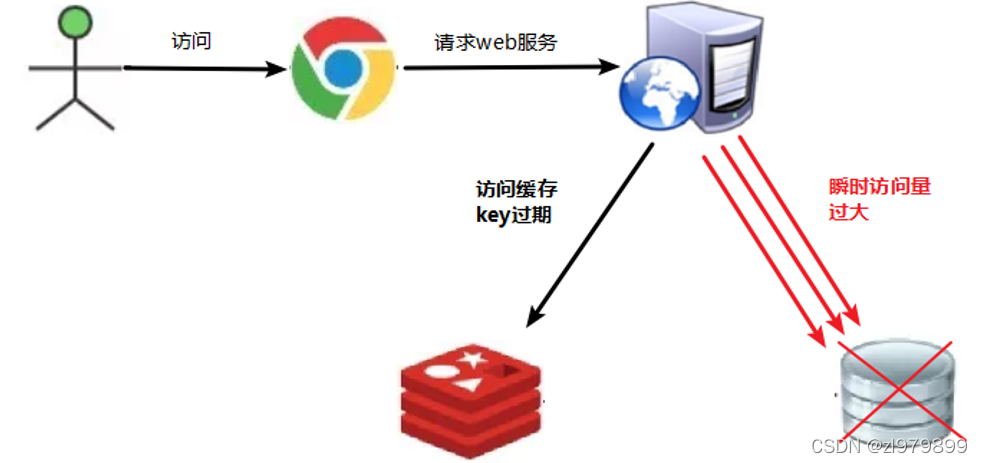
- key对应的数据存在,但在redis中过期,此时若有大量并发请求过来,这些请求发现缓存过期一般都会从后端DB加载数据并回设到缓存,这个时候大量并发的请求可能会瞬间把后端DB压垮
- 击穿: 指的是单个key在缓存中查不到再去数据库查询,如果数据量不大或者并发不大的话是没有什么问题的
解决方式
预先设置热门数据
- 在redis高峰访问之前,把一些热门数据提前存入到redis里面,加大这些热门数据key的时长
实时调整
- 现场监控哪些数据热门,实时调整key的过期时长
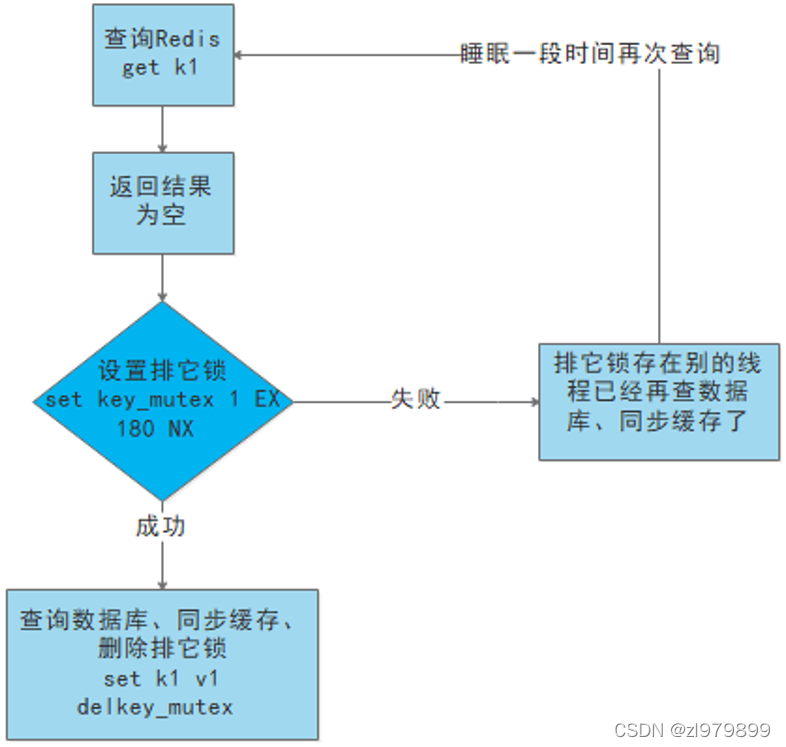
使用锁
- 就是在缓存失效的时候(判断拿出来的值为空),不是立即去load db
- 先使用缓存工具的某些带成功操作返回值的操作(比如Redis的SETNX)去set一个mutex key
- 当操作返回成功时,再进行load db的操作,并回设缓存,最后删除mutex key
- 当操作返回失败,证明有线程在load db,当前线程睡眠一段时间再重试整个get缓存的方法
缓存雪崩
- key对应的数据存在,但在redis中过期,此时若有大量并发请求过来,这些请求发现缓存过期一般都会从后端DB加载数据并回设到缓存,这个时候大量并发的请求可能会瞬间把后端DB压垮
- 如果缓存层由于某些原因不可用(宕机)或者大量缓存由于超时时间相同在同一时间段失效(大批key失效/热点数据失效),大量请求直接到达存储层,存储层压力过大导致系统雪崩
- 缓存雪崩与缓存击穿的区别在于这里针对很多key缓存,击穿则是某一个key
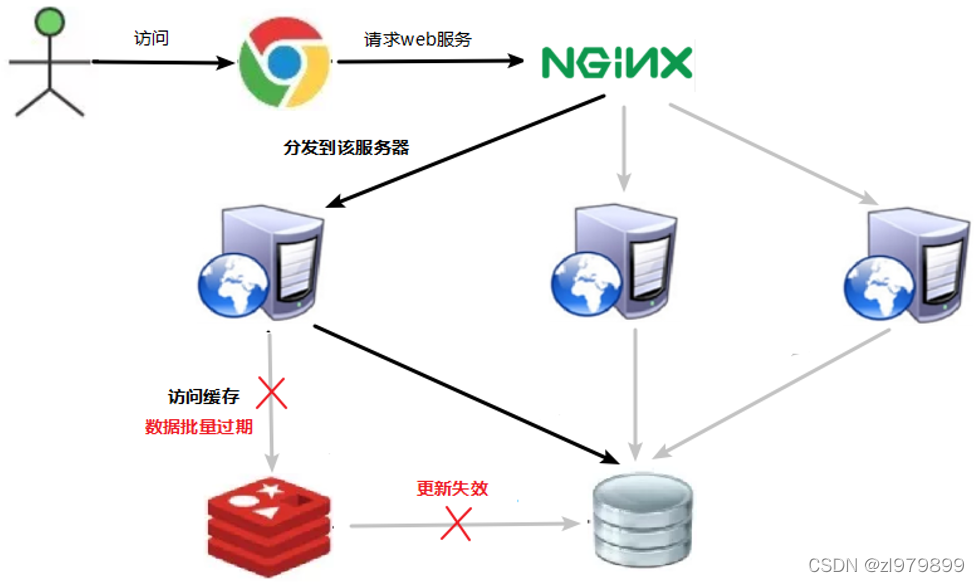
解决方式
构建多级缓存架构
- nginx缓存 + redis缓存 +其他缓存(ehcache等)
使用锁或队列
- 用加锁或者队列的方式保证来保证不会有大量的线程对数据库一次性进行读写,从而避免失效时大量的并发请求落到底层存储系统上。不适用高并发情况
设置过期标志更新缓存
- 记录缓存数据是否过期(设置提前量),如果过期会触发通知另外的线程在后台去更新实际key的缓存
将缓存失效时间分散开
- 在原有的失效时间基础上增加一个随机值,比如1-5分钟随机,这样每一个缓存的过期时间重复率就会降低,就很难引发集体失效的事件