1.前言
DeepSeek‑OCR 是由 DeepSeek AI 团队推出的开源视觉‑语言模型,核心目标是通过"光学压缩"把长文本转化为图像,再将图像压缩为少量视觉 token,实现对超长文本的高效 OCR 与上下文理解。
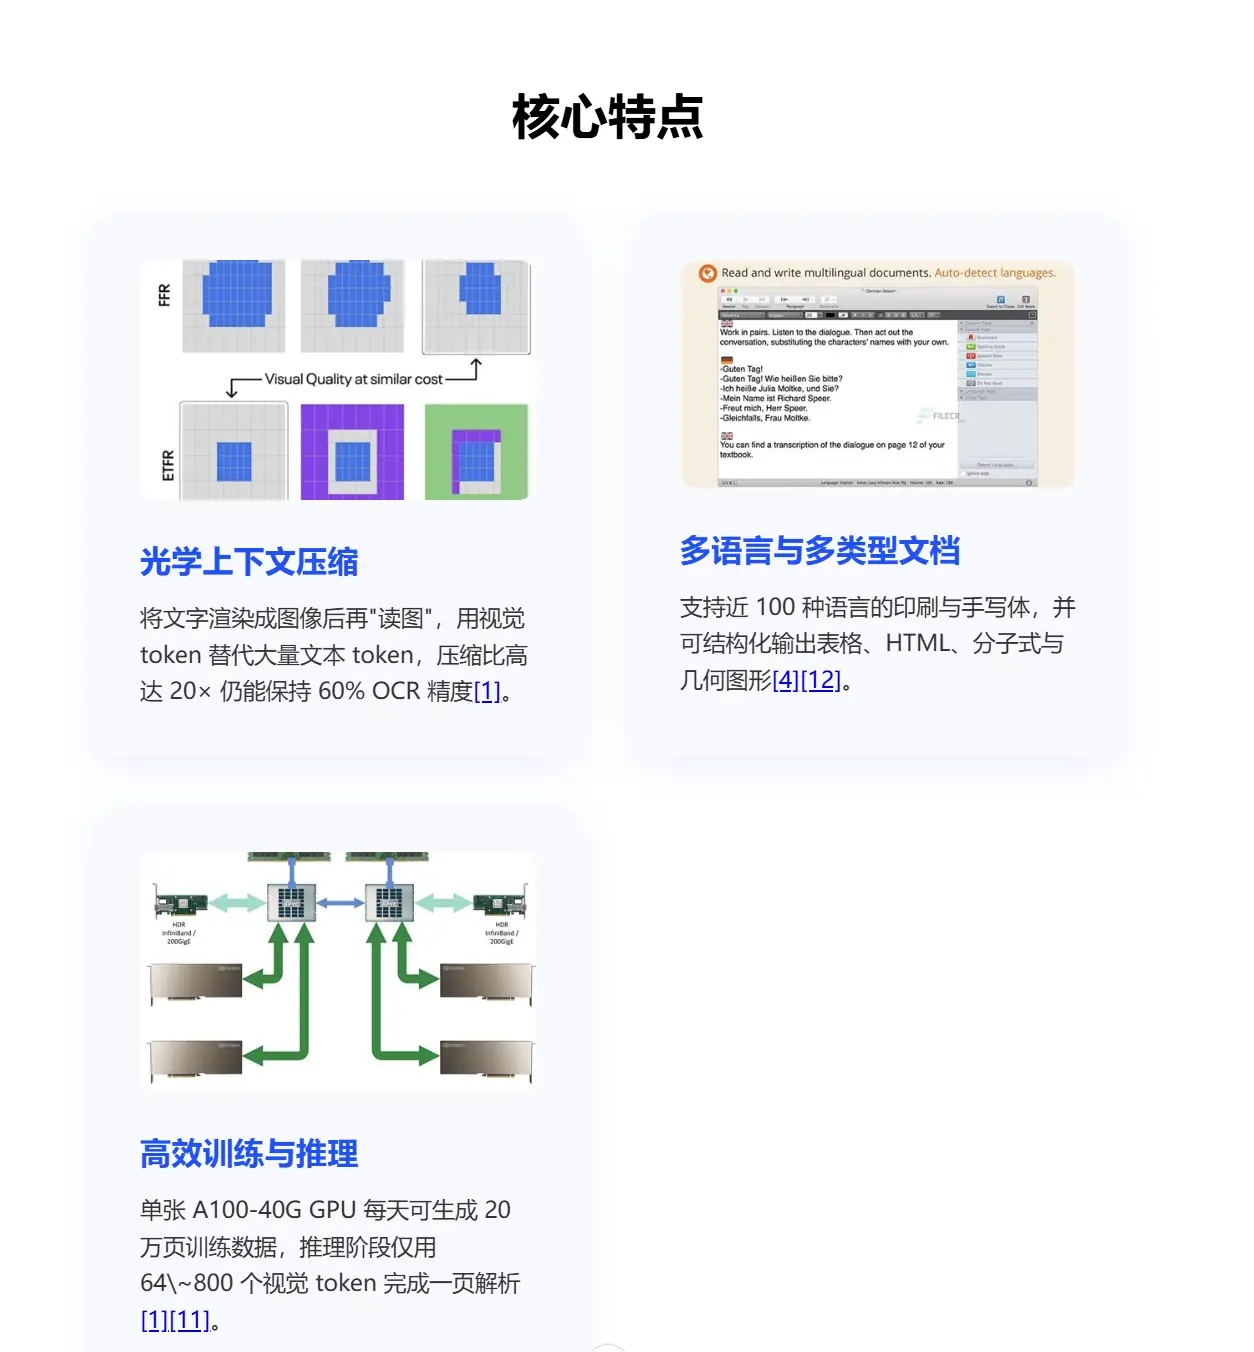
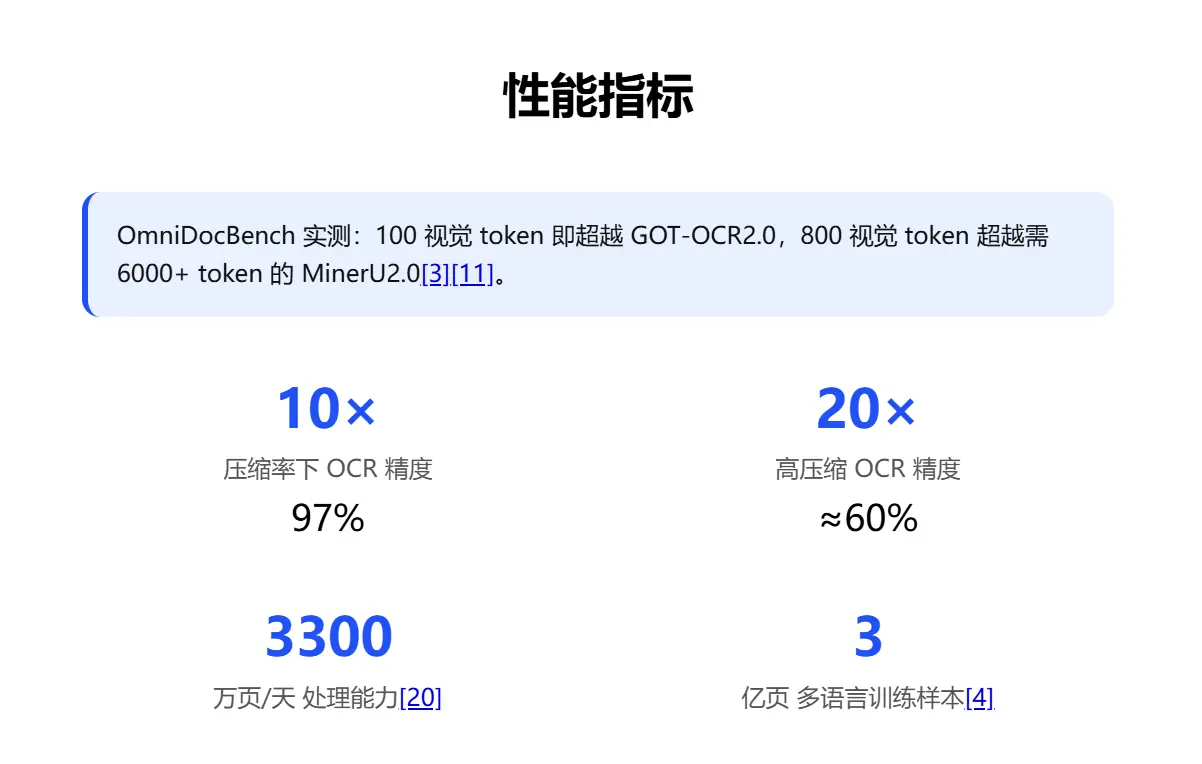
DeepSeek‑OCR 通过将文本转化为视觉信息并进行高效压缩,突破了传统 OCR 在长文本、复杂布局和多语言场景下的瓶颈。其核心技术(光学压缩 + MoE 解码)使得模型在保持 97% 以上精度的同时,实现 10‑20 倍的 token 压缩,具备低显存、高吞吐、开源易用等优势,已成为大模型长上下文处理和多模态文档解析的前沿方案。
这2天DeepSeek‑OCR 非常火爆,今天我们在魔搭社区是手把手教大家部署这个模型,体验和感受一下这个模型的能力。
2.模型部署实战
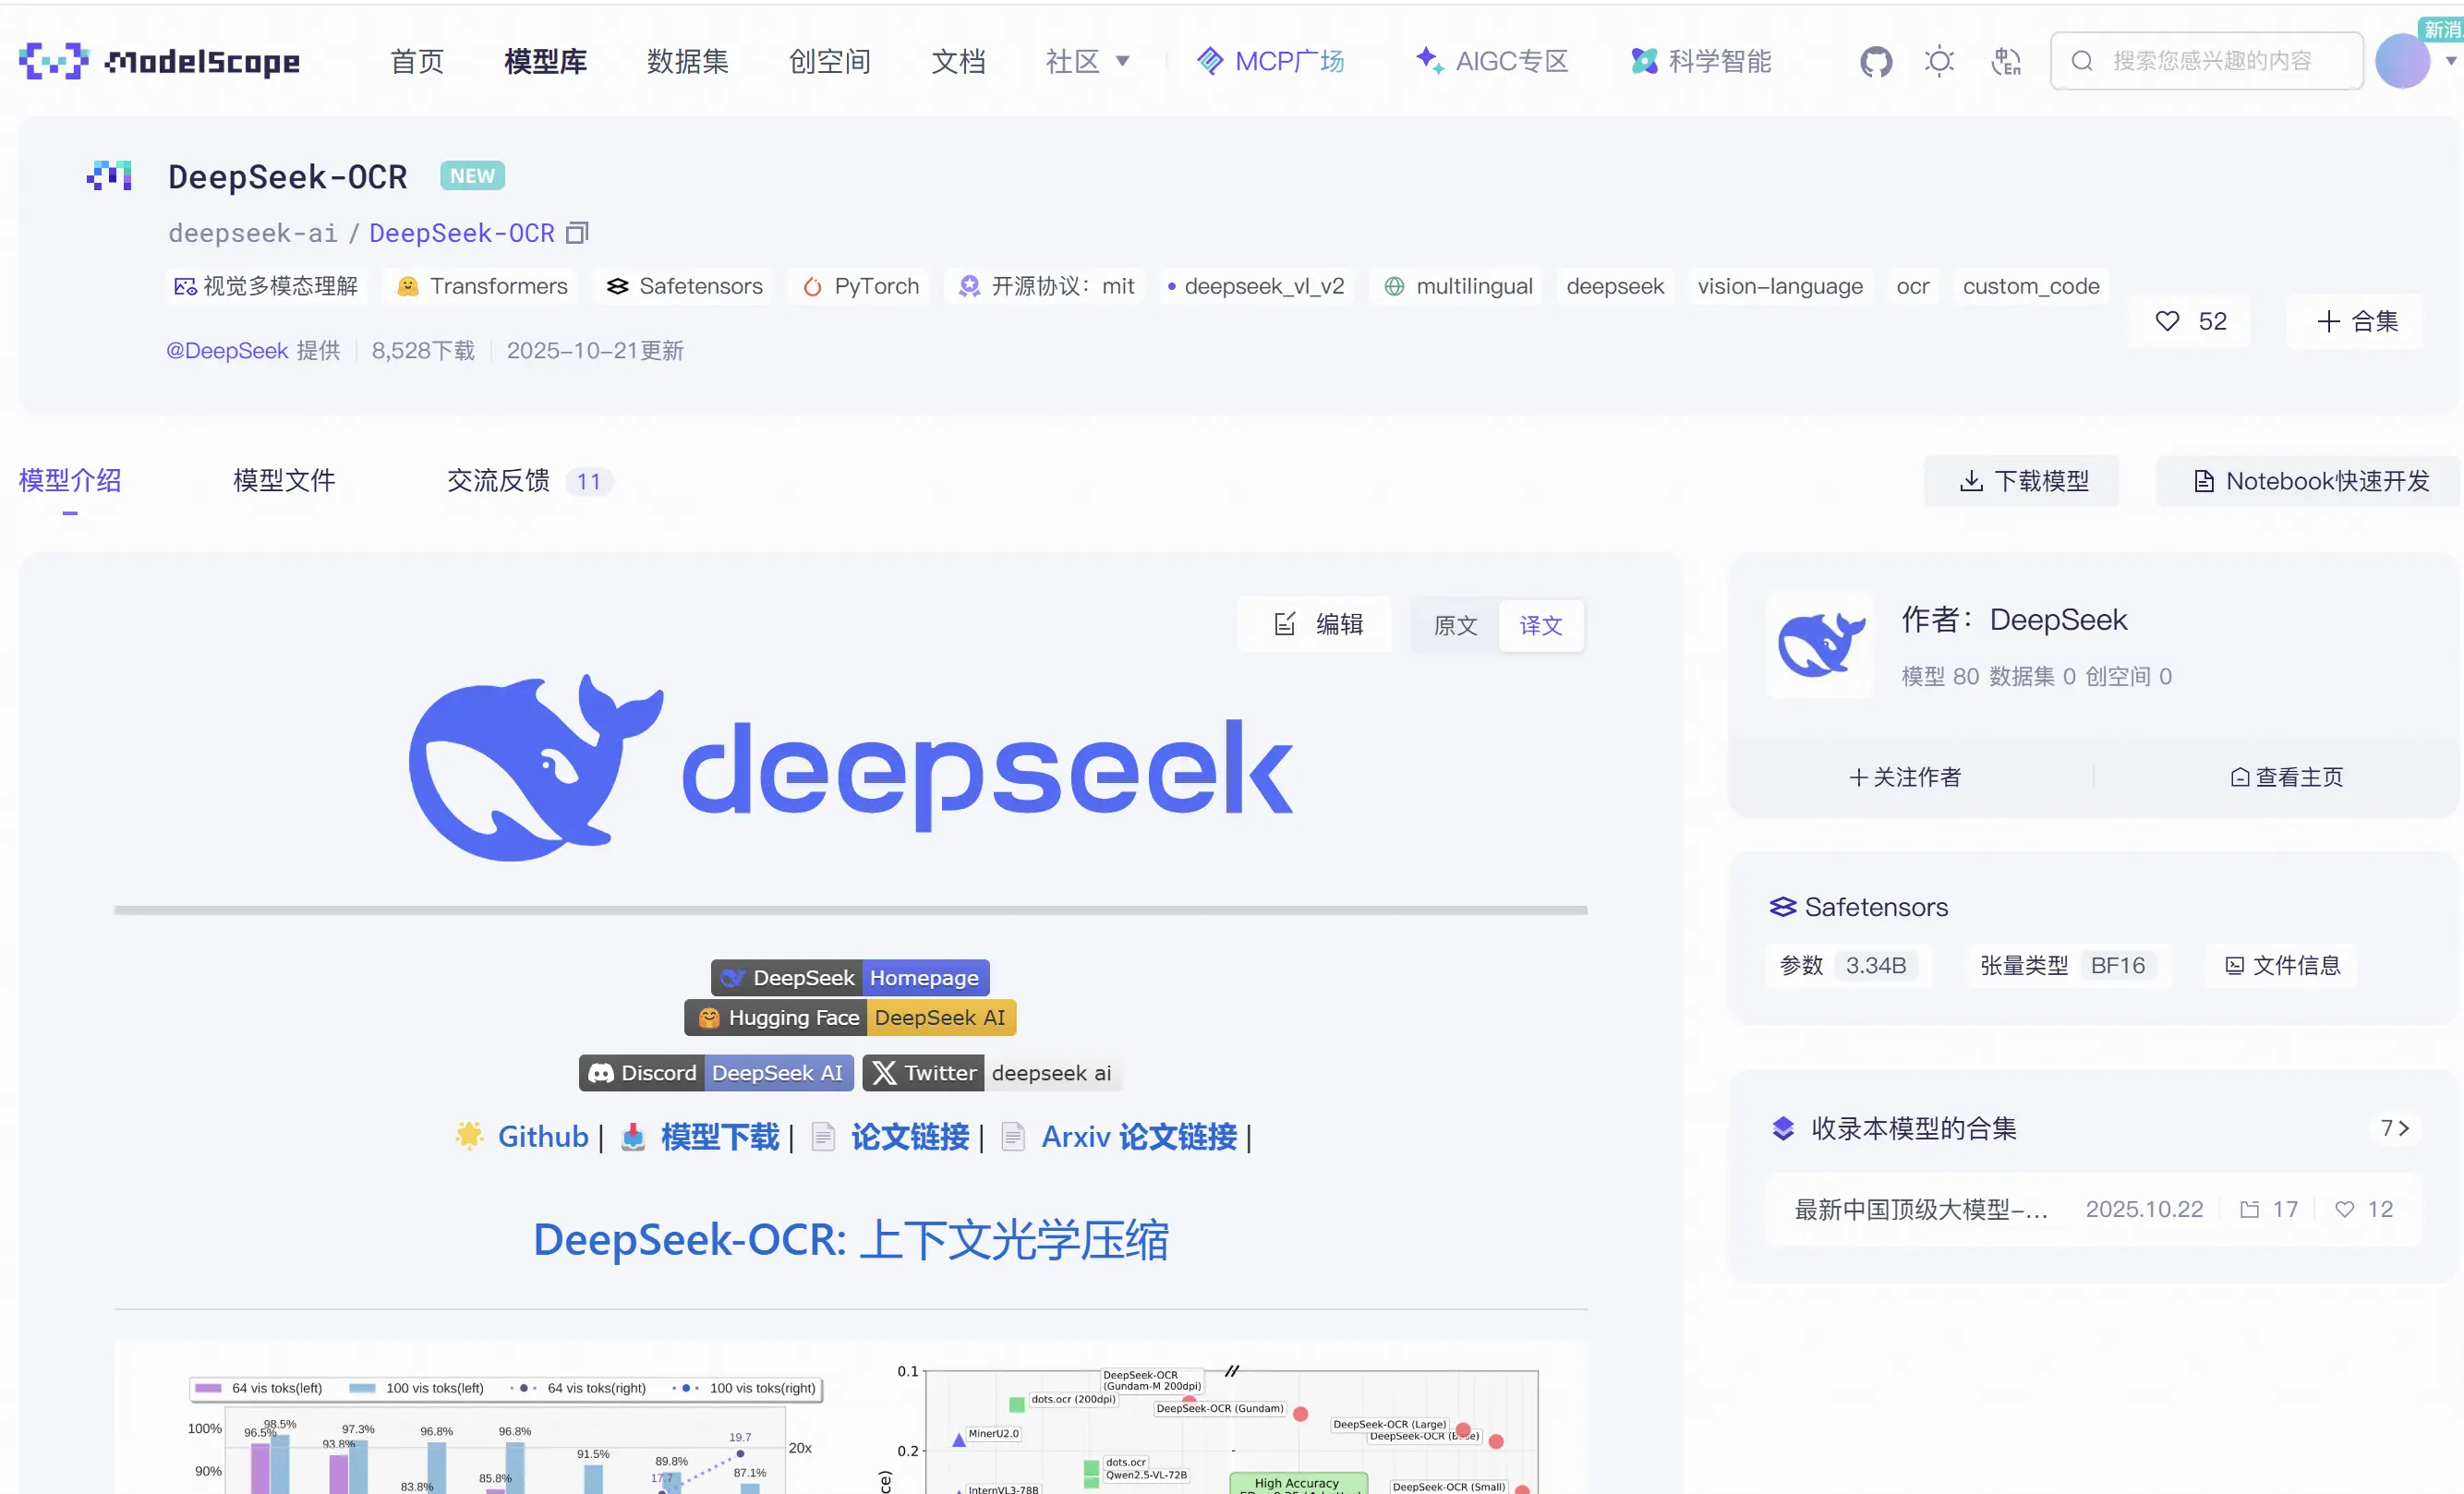
2025年10月21日国内的魔搭社区已经上架了这块模型(DeepSeek‑OCR),我们登录魔搭社区平台查看这个模型
我们查看一下权重文件
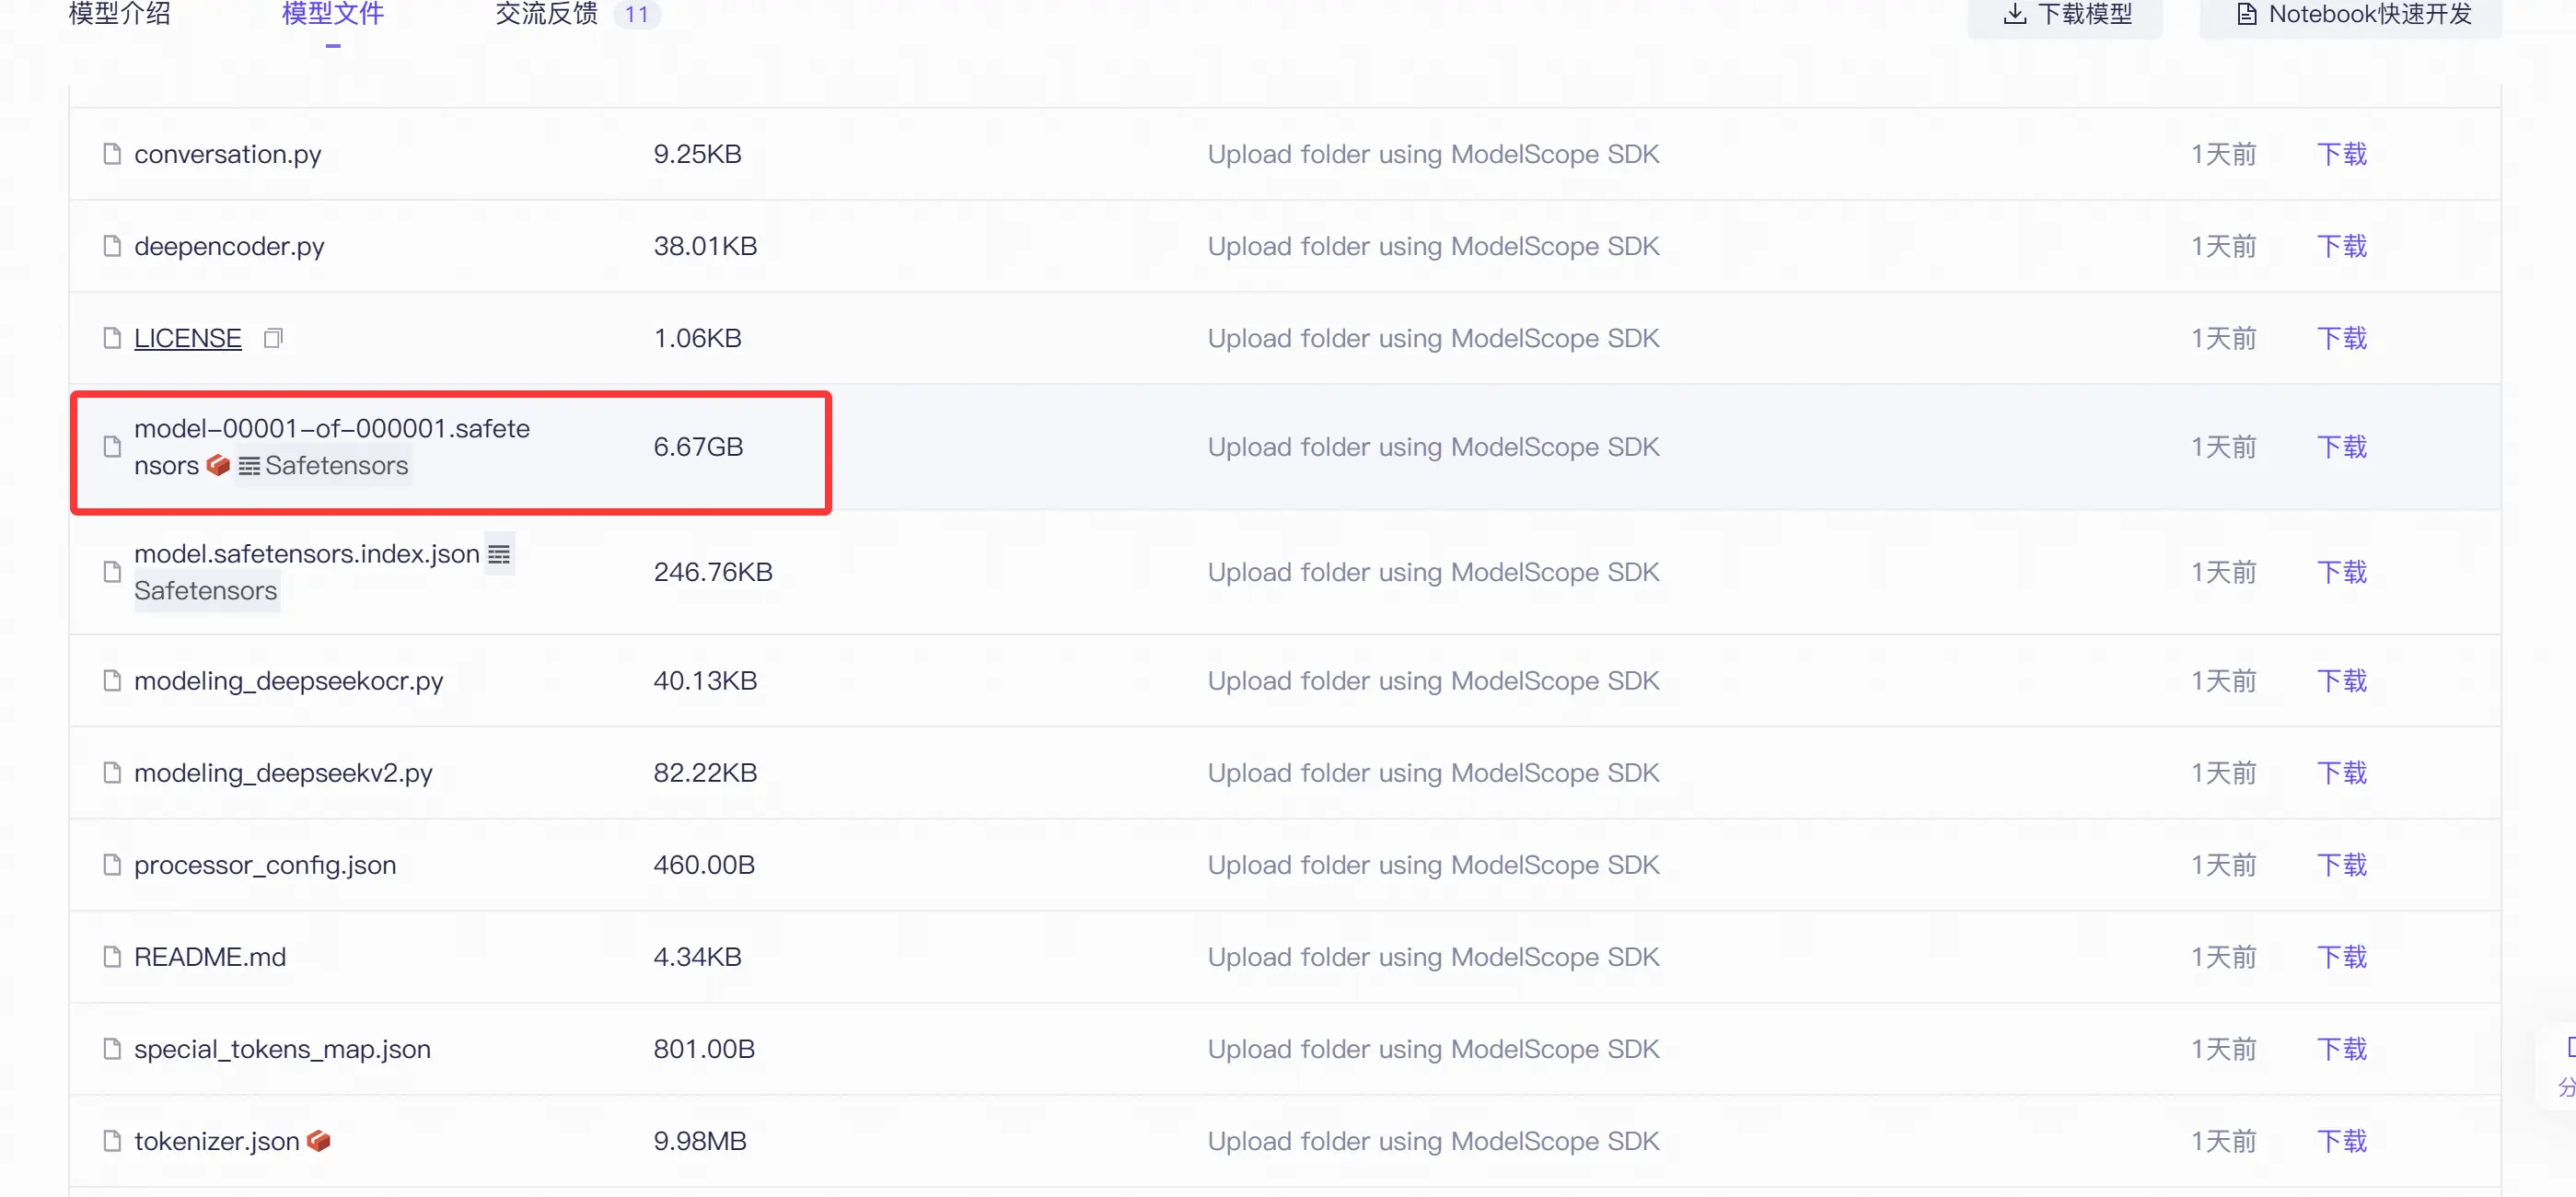
这个模型权重文件大概 6.67GB,这样的我们在消费机显卡上也能实现模型的推理。
模型下载
我们首先需要在魔搭社区提供的nodebook 开启带有GPU的服务。
在我的个人主页里面,我的nodebook------魔搭平台免费实例------GPU环境,模型镜像就选择最新的ubuntu22.04-cuda12.1.0-py311-torch2.3.1-tf2.16.1-1.31.0
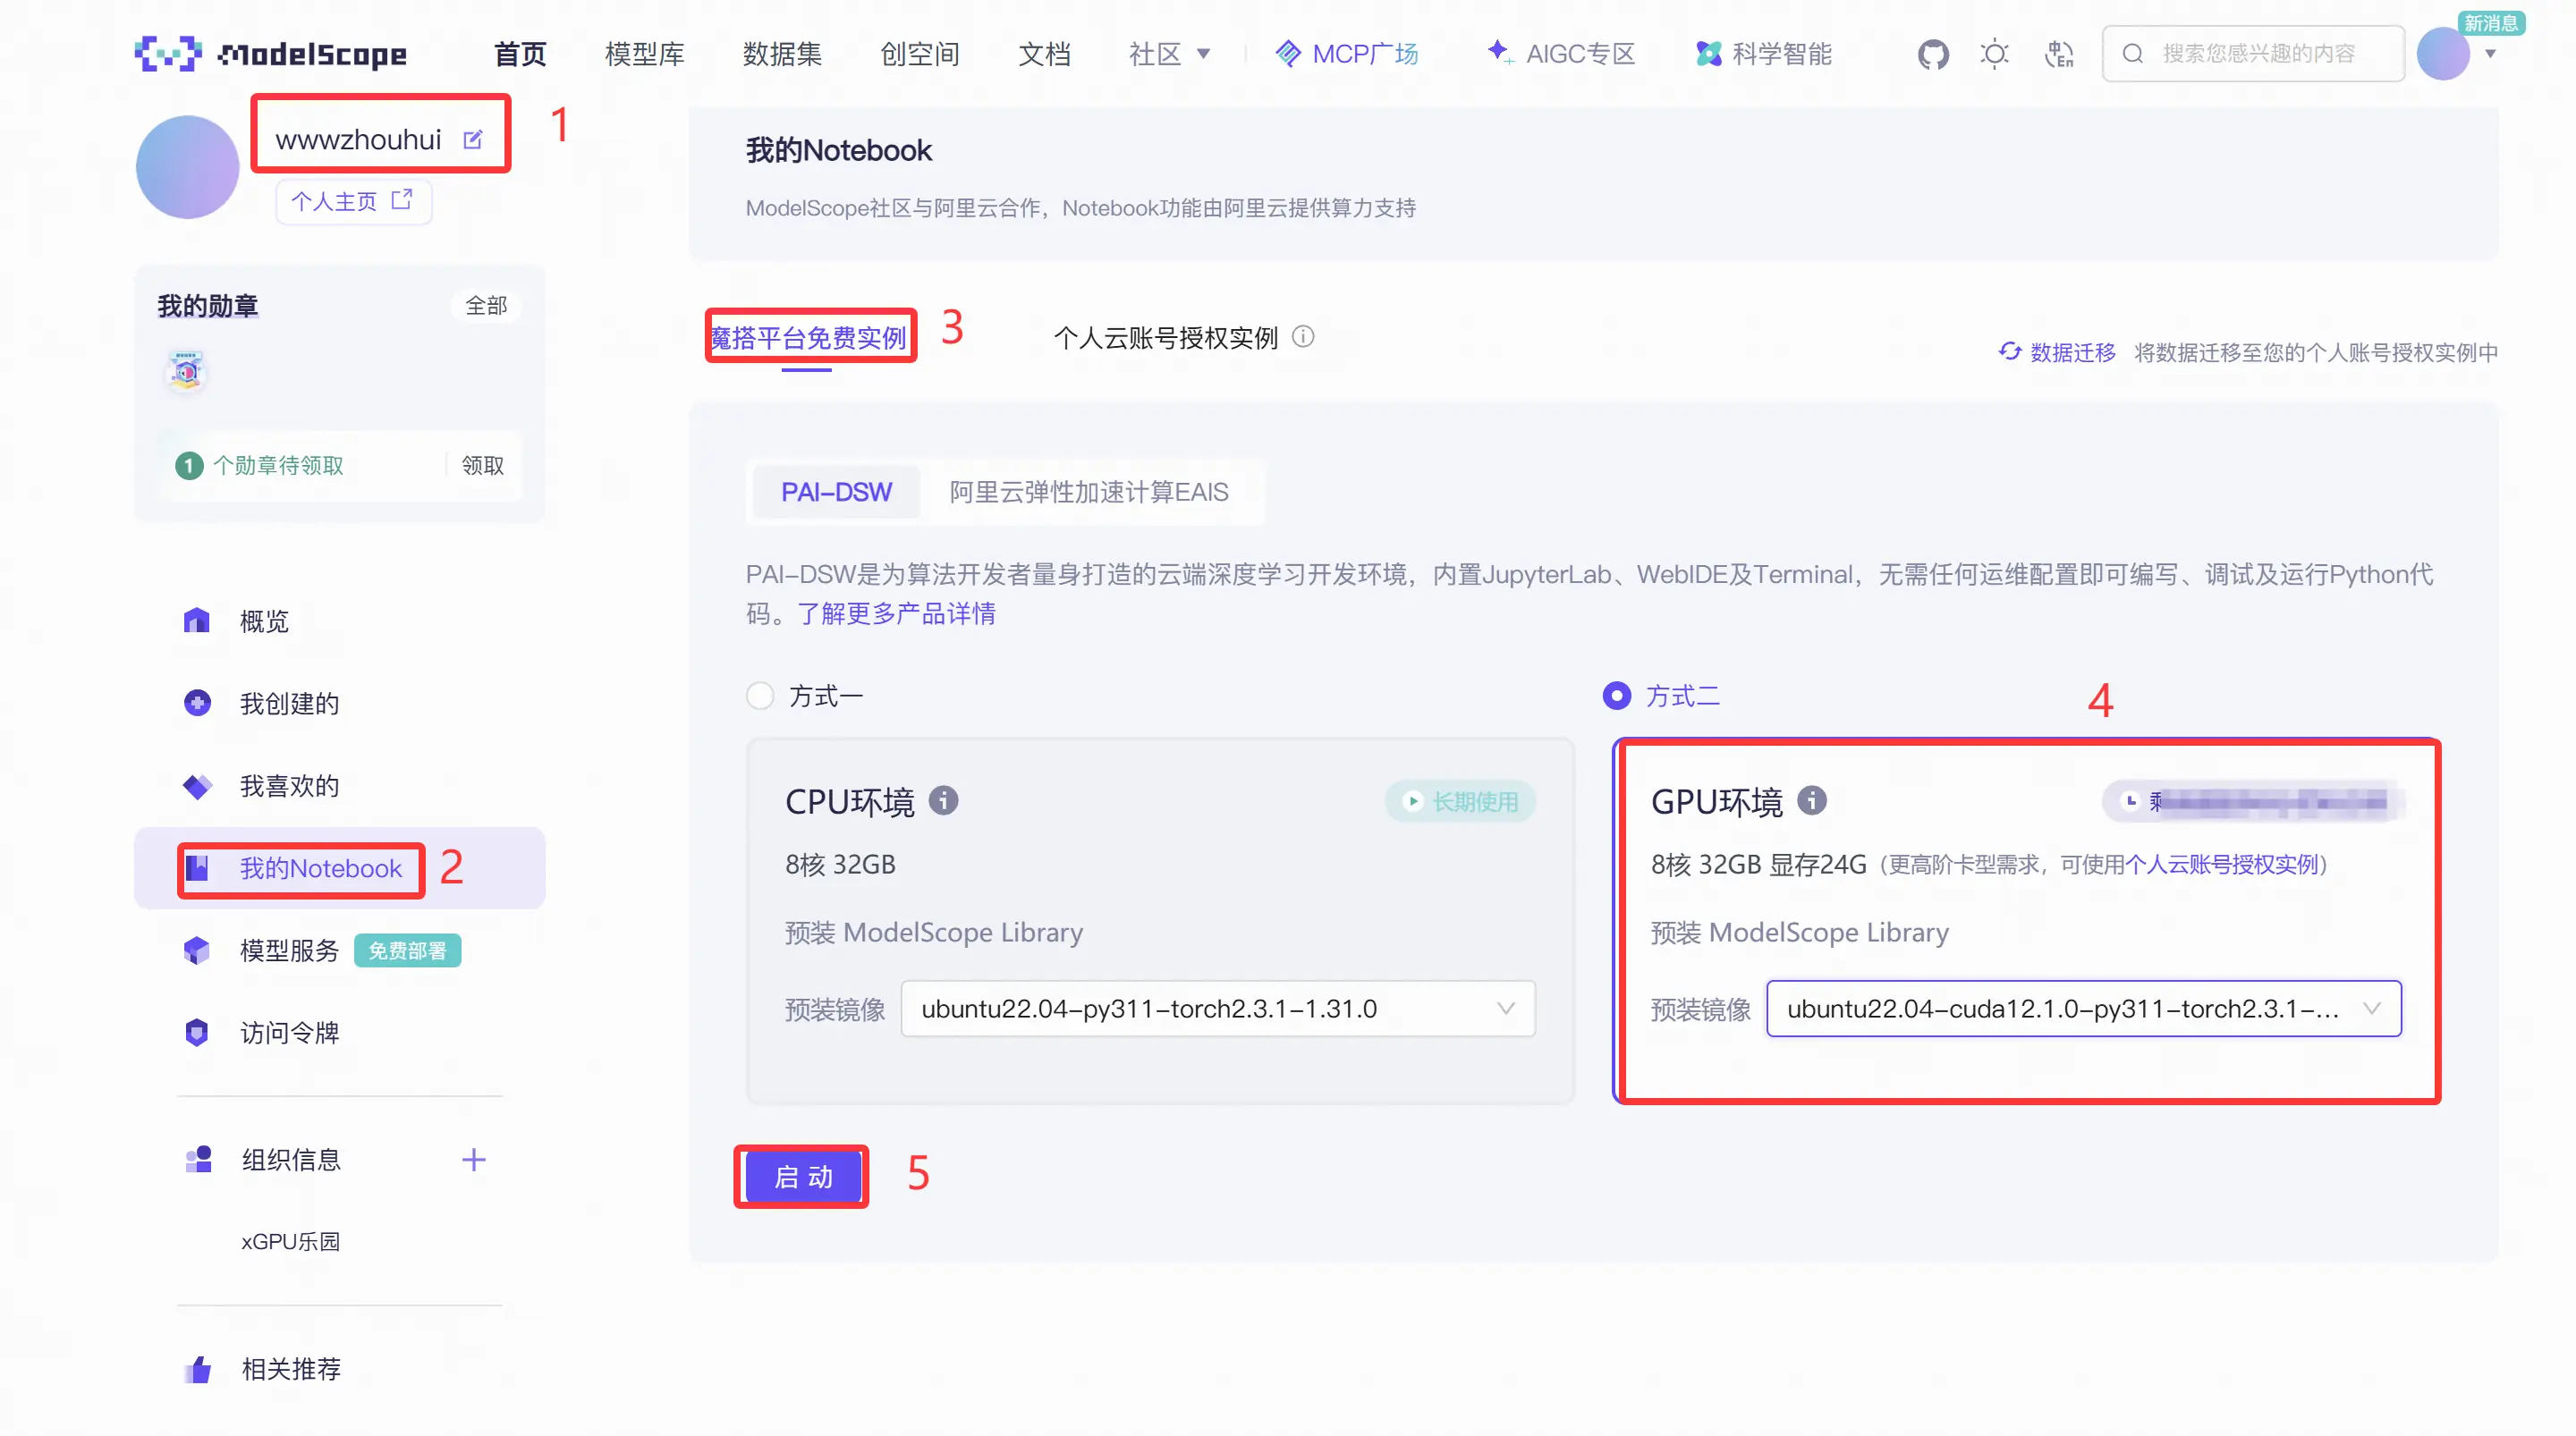
启动完成后我们大概等待几分钟后,后端服务给我们分配服务器,分配好后我们看到下面的画面
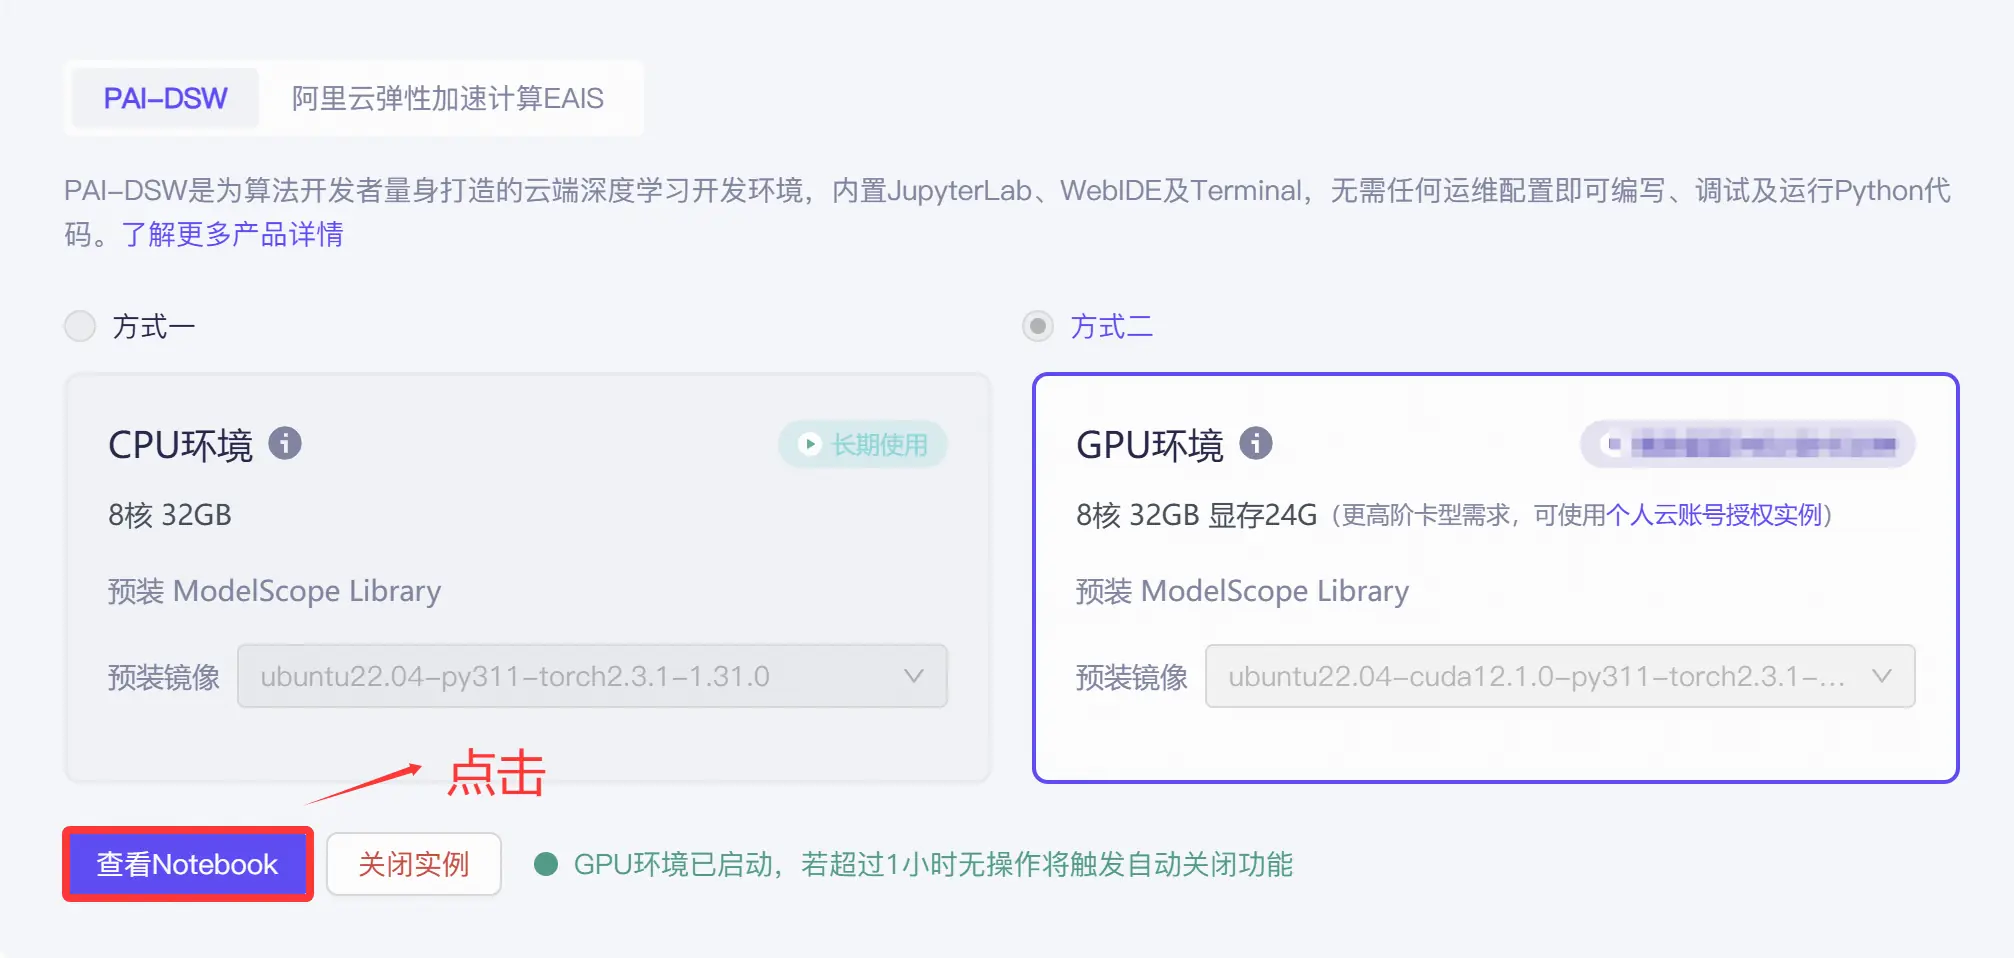
我们点击查看notebook 进入 jupyter 调试页面 (每天第一次登录 后会调转到阿里云授权,手机扫描授权即可)
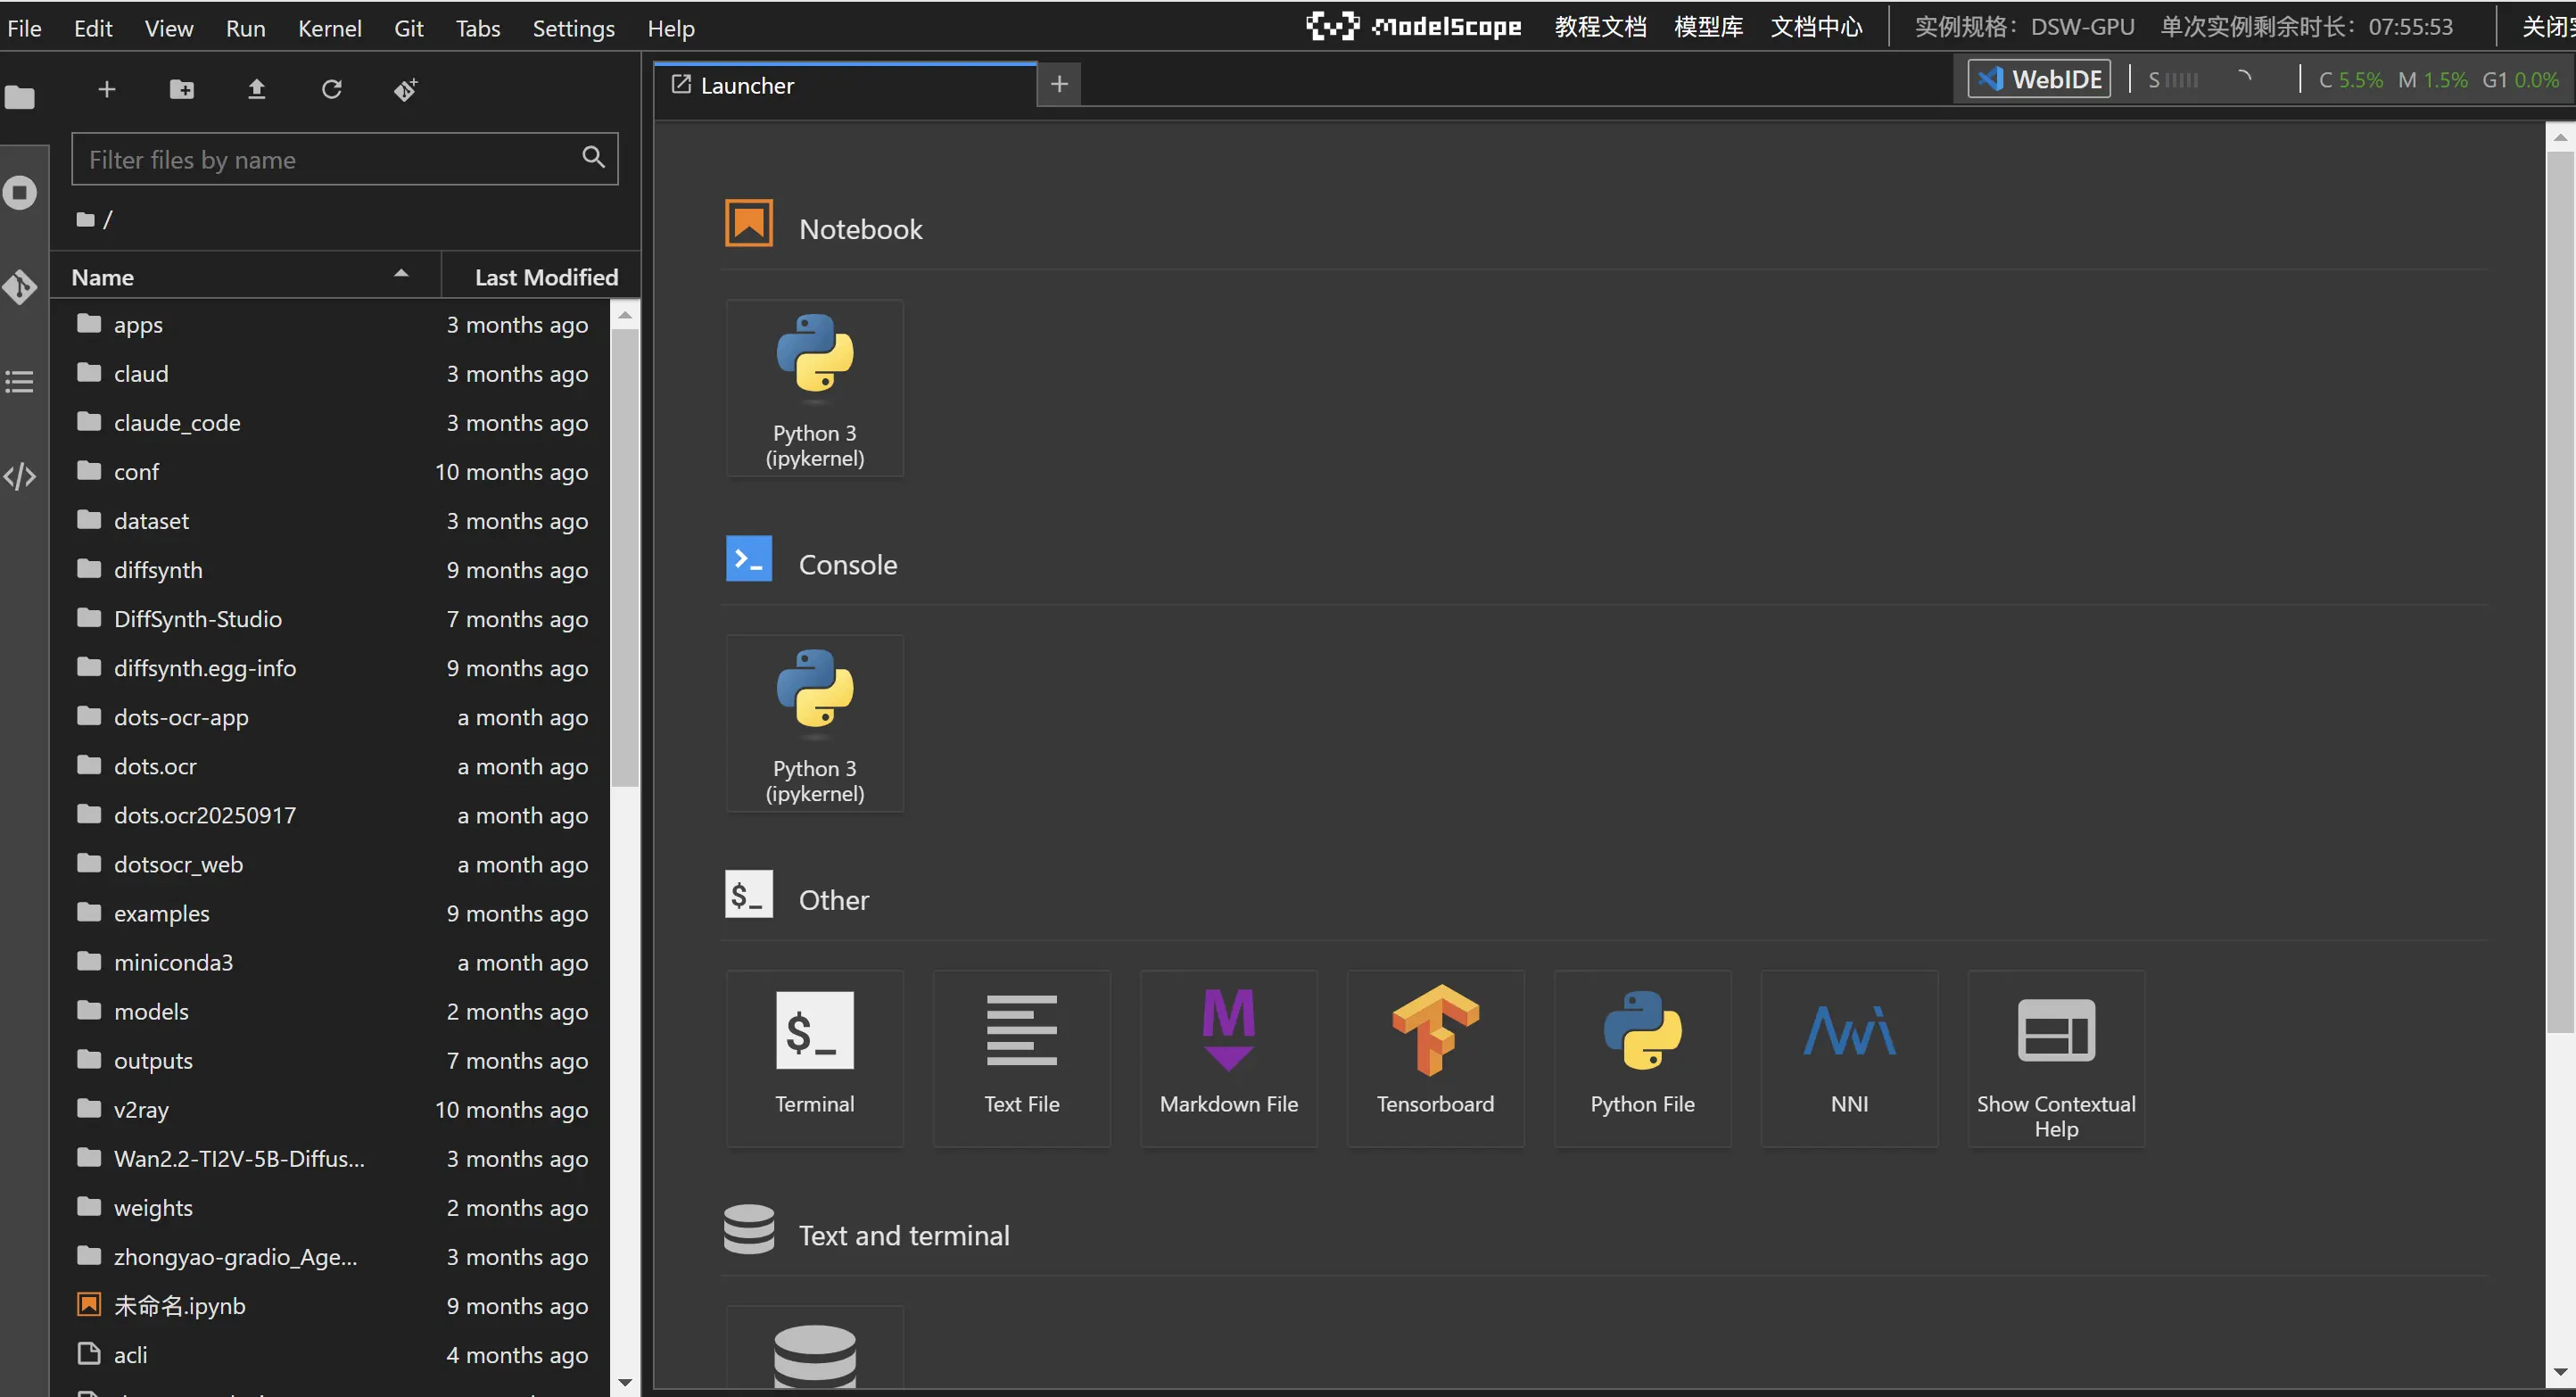
我之前的notebook 空间里面有之前安装的东西,如果是新的这里没有那么多文件夹。
打开terminal开启一个终端。我们输入下面命令行下载模型
css
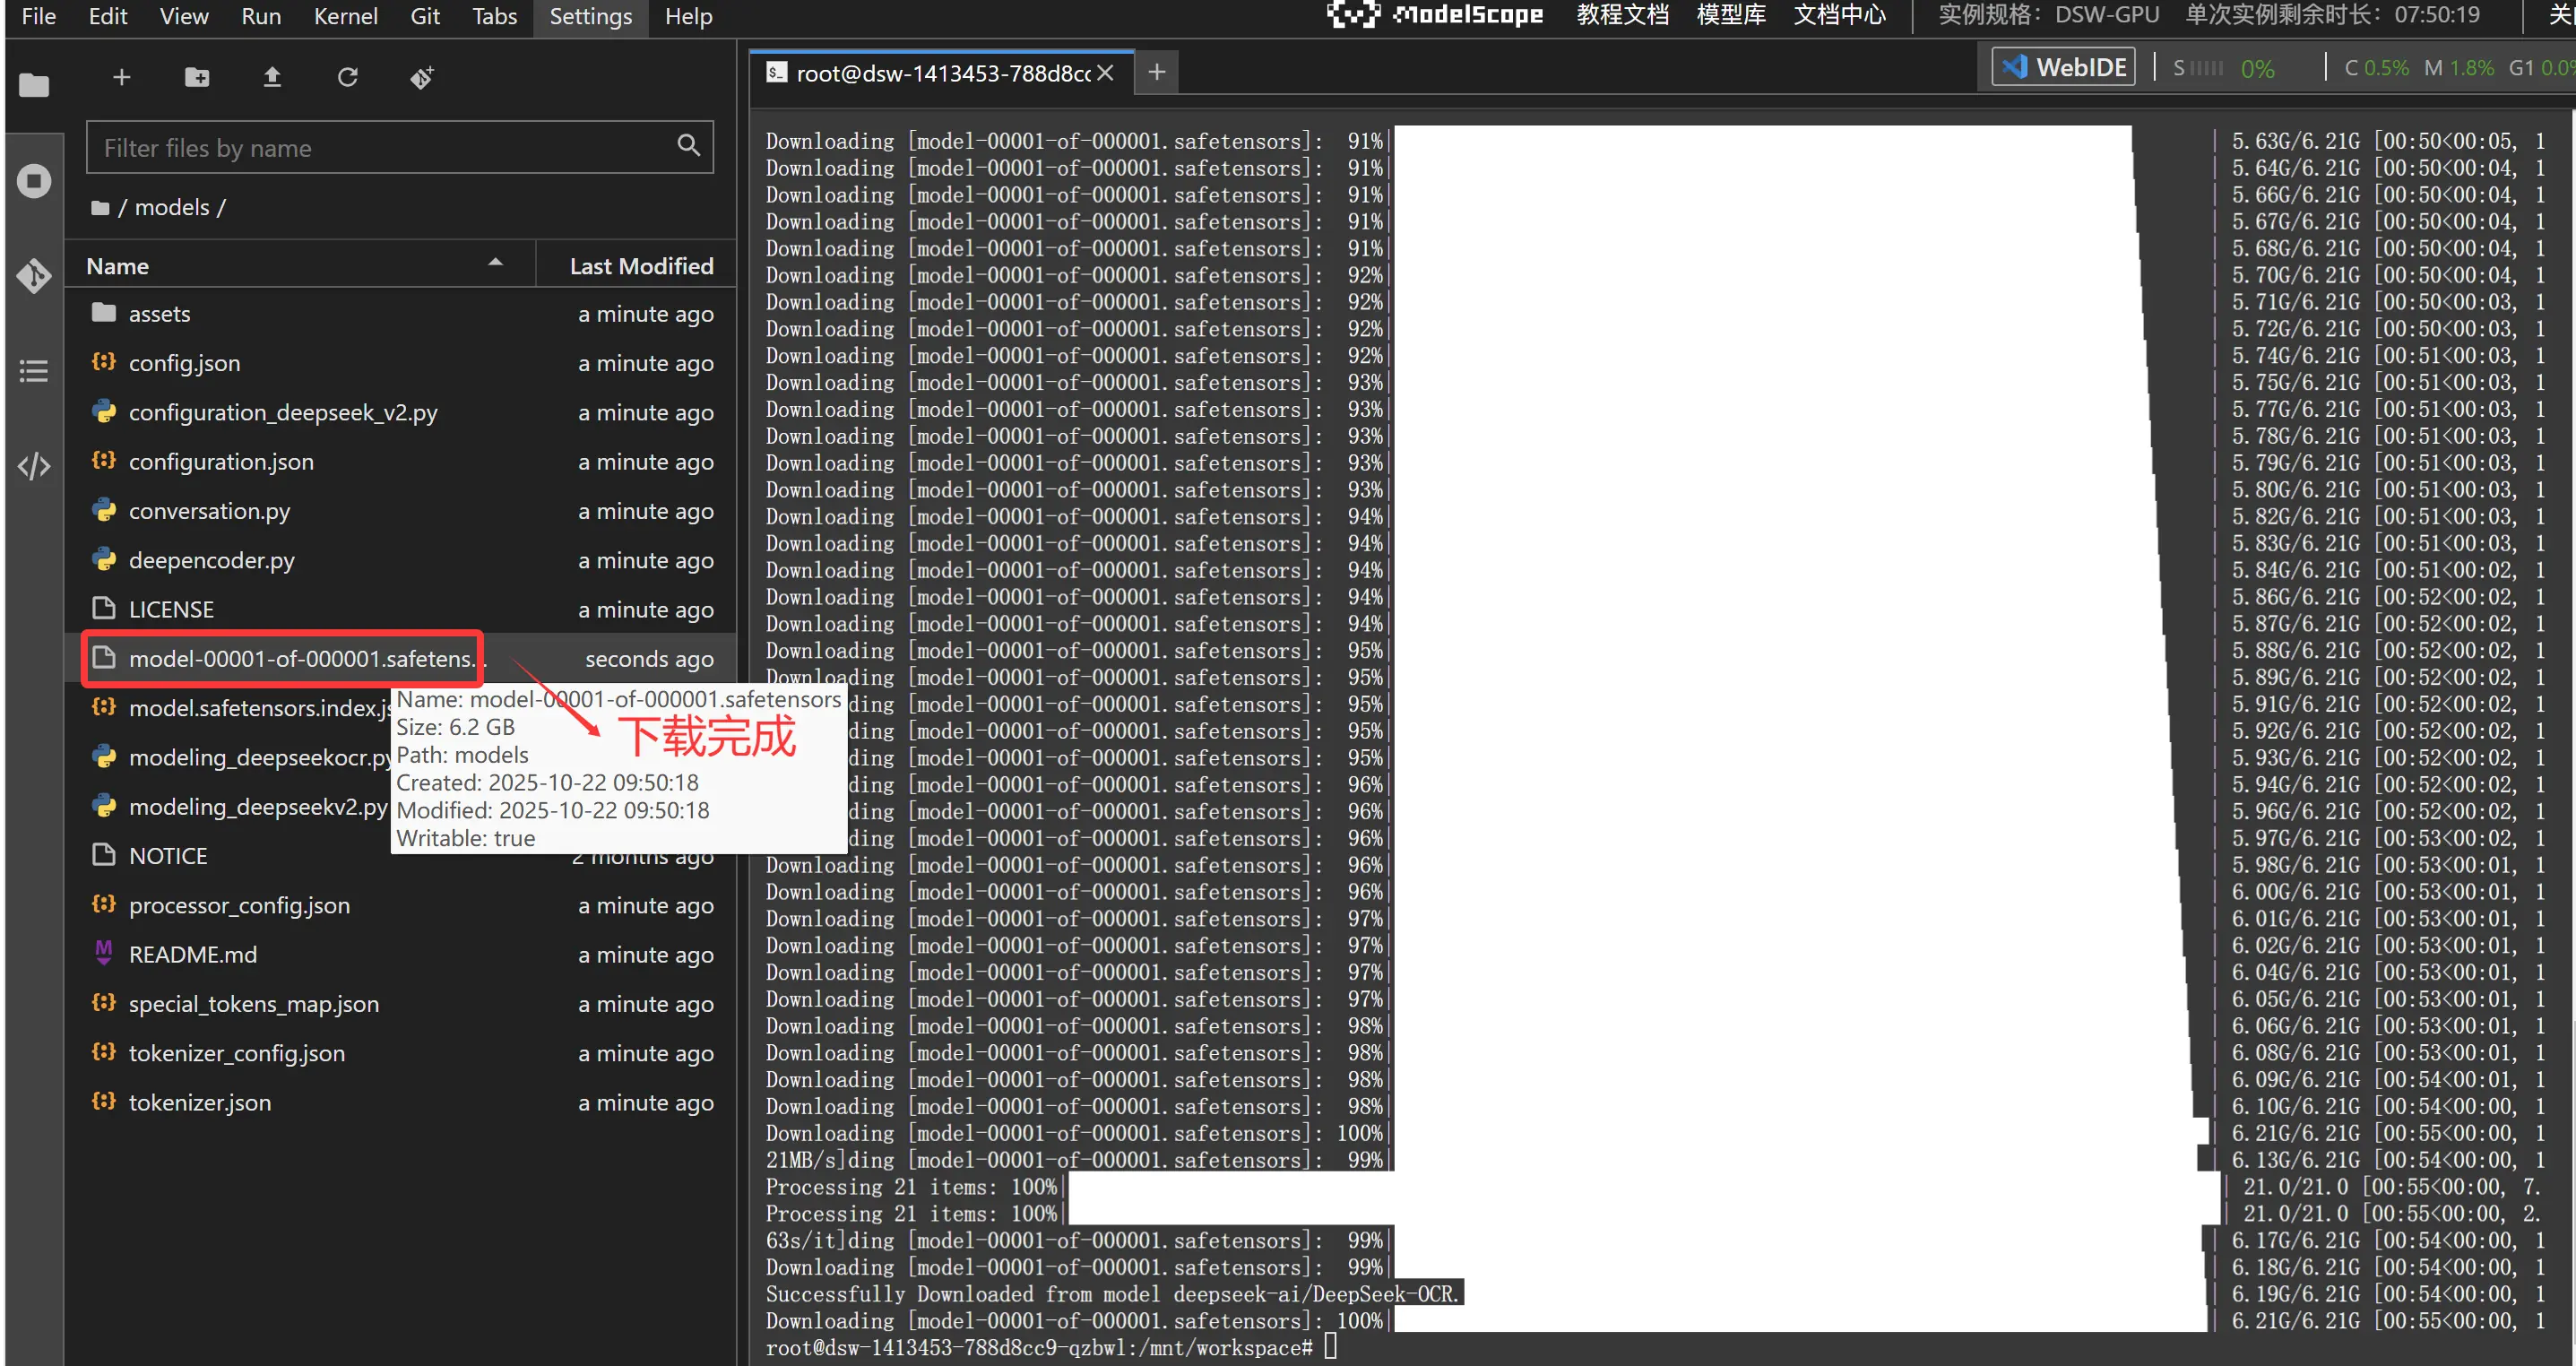
modelscope download --model deepseek-ai/DeepSeek-OCR --local_dir /mnt/workspace/models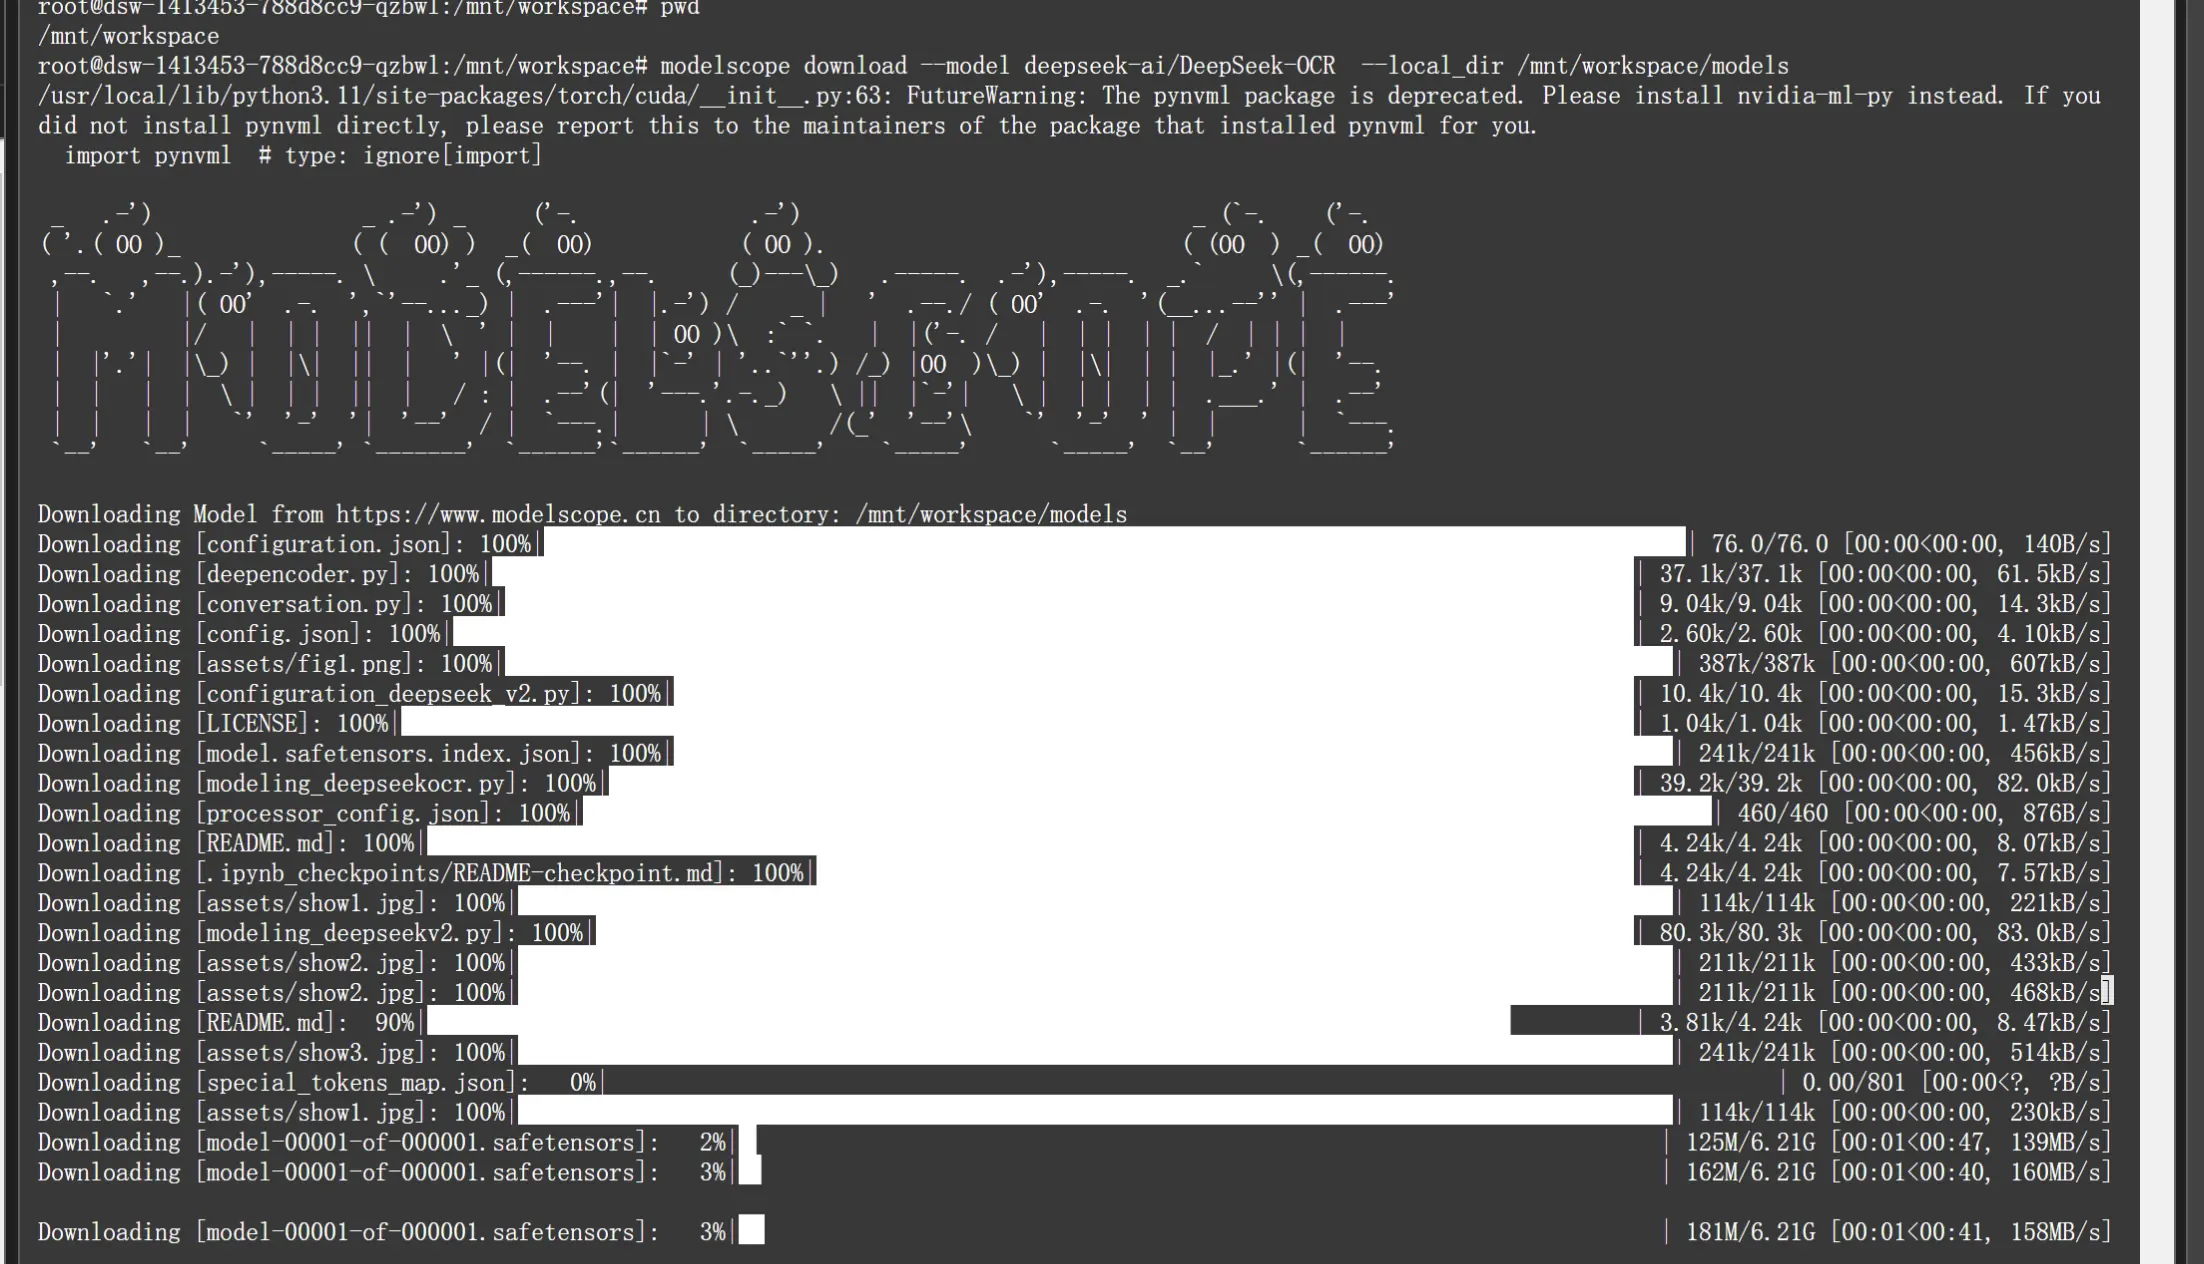
我们大概等待几分钟后就看到下载好的模型文件了。
依赖安装
官方测试环境是测试环境为python 3.12.9 + CUDA11.8
ini
torch==2.6.0
transformers==4.46.3
tokenizers==0.20.3
einops
addict
easydict
pip install flash-attn==2.7.3 --no-build-isolation
魔搭提供的镜像ubuntu22.04-cuda12.1.0-py311-torch2.3.1-tf2.16.1-1.31.0版本 我们需要安装一下依赖包
ini
pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 --index-url https://download.pytorch.org/whl/cu118
pip install vllm==0.8.5
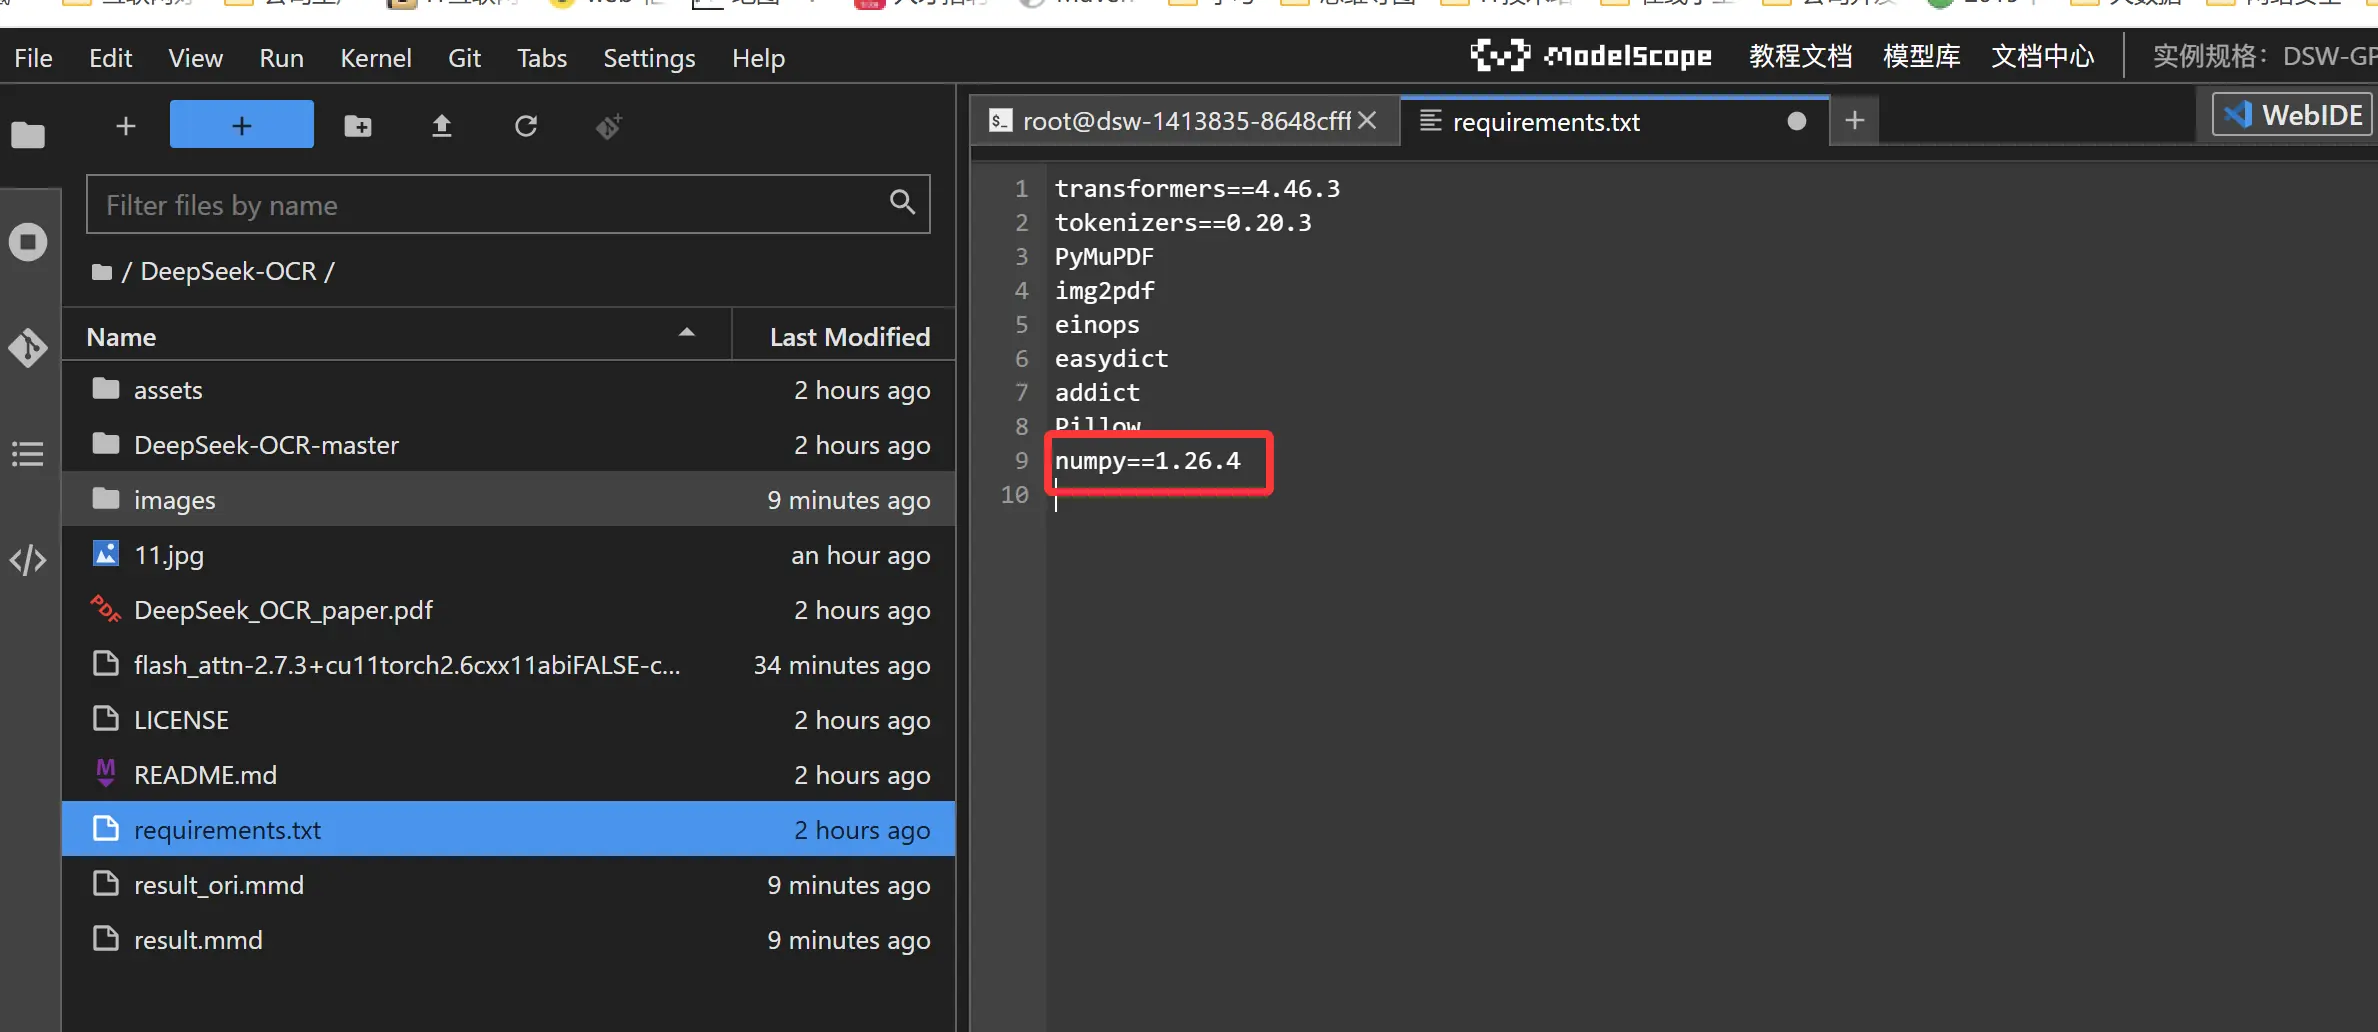
这里我们还需要修改requirements.txt里面的numpy==1.26.4( 不修改会报错)
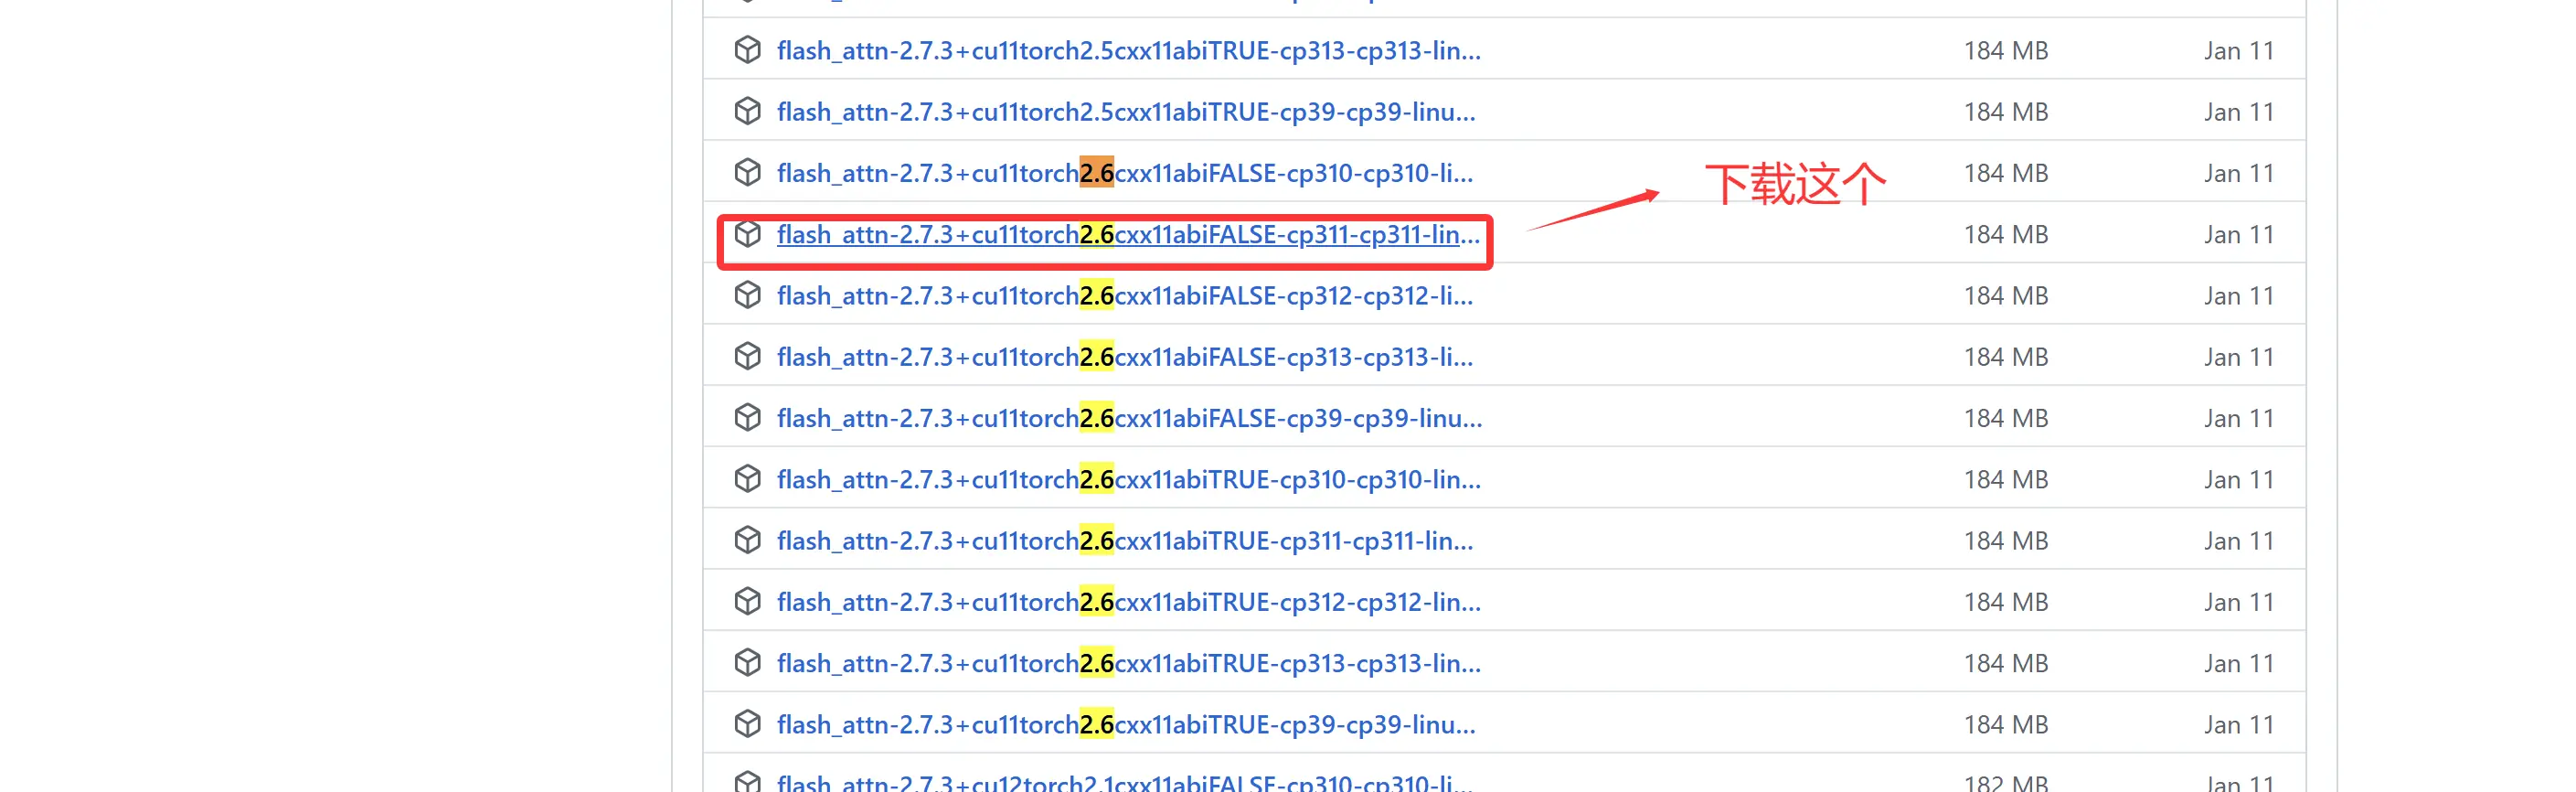
另外我们还需要下载flash-attn==2.7.3 这个版本,这里我们需要通过下载离线包上传并安装
离线包地址github.com/Dao-AILab/f...
下载完成后我们需要把这个离线包上传魔搭社区notebook调试环境中
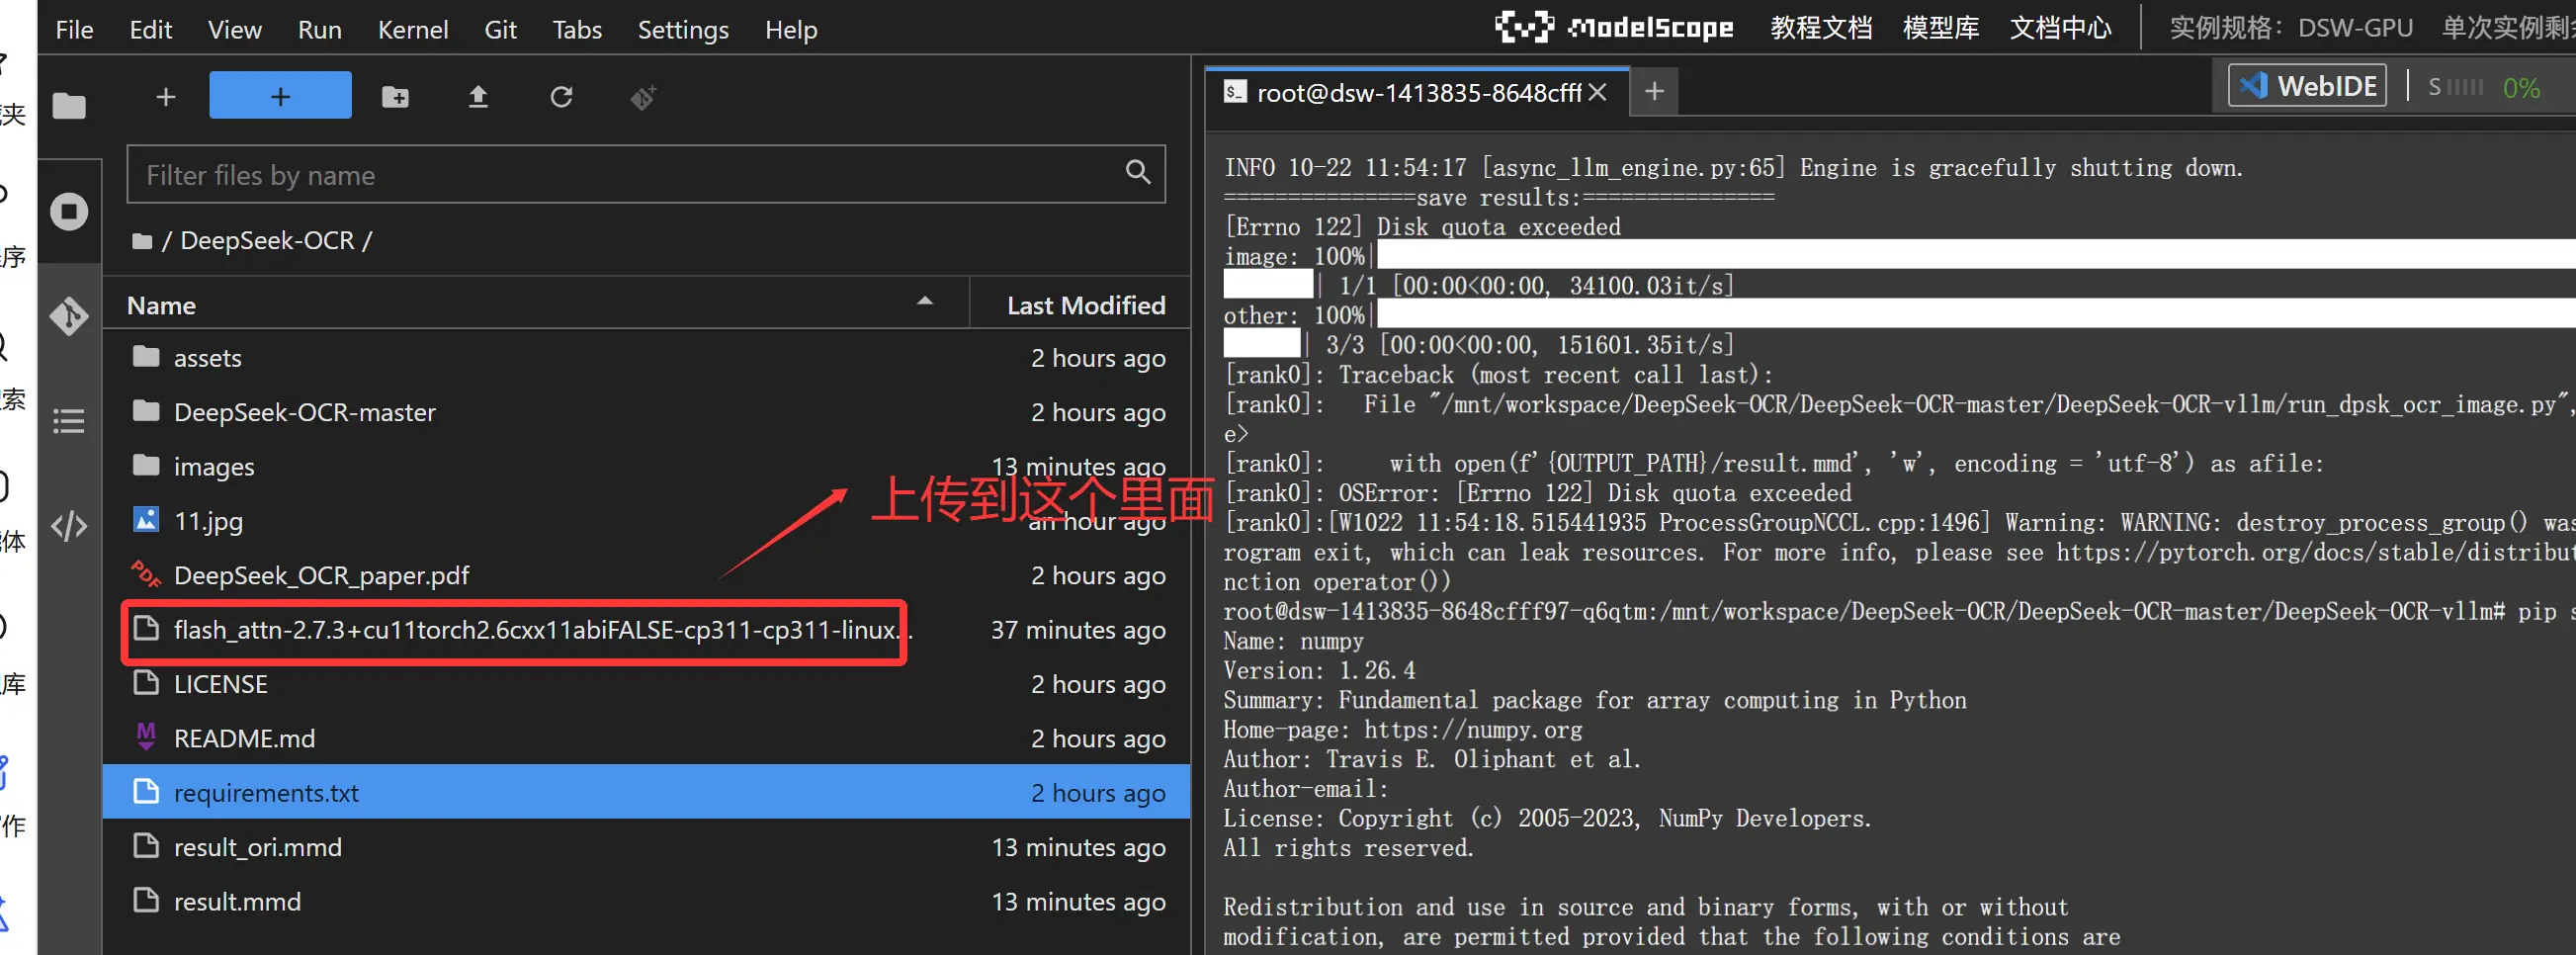
上传后我们通过下面命令安装flash-attn==2.7.3
bash
cd /mnt/workspace/DeepSeek-OCR
pip install flash_attn-2.7.3+cu11torch2.6cxx11abiFALSE-cp311-cp311-linux_x86_64.whl
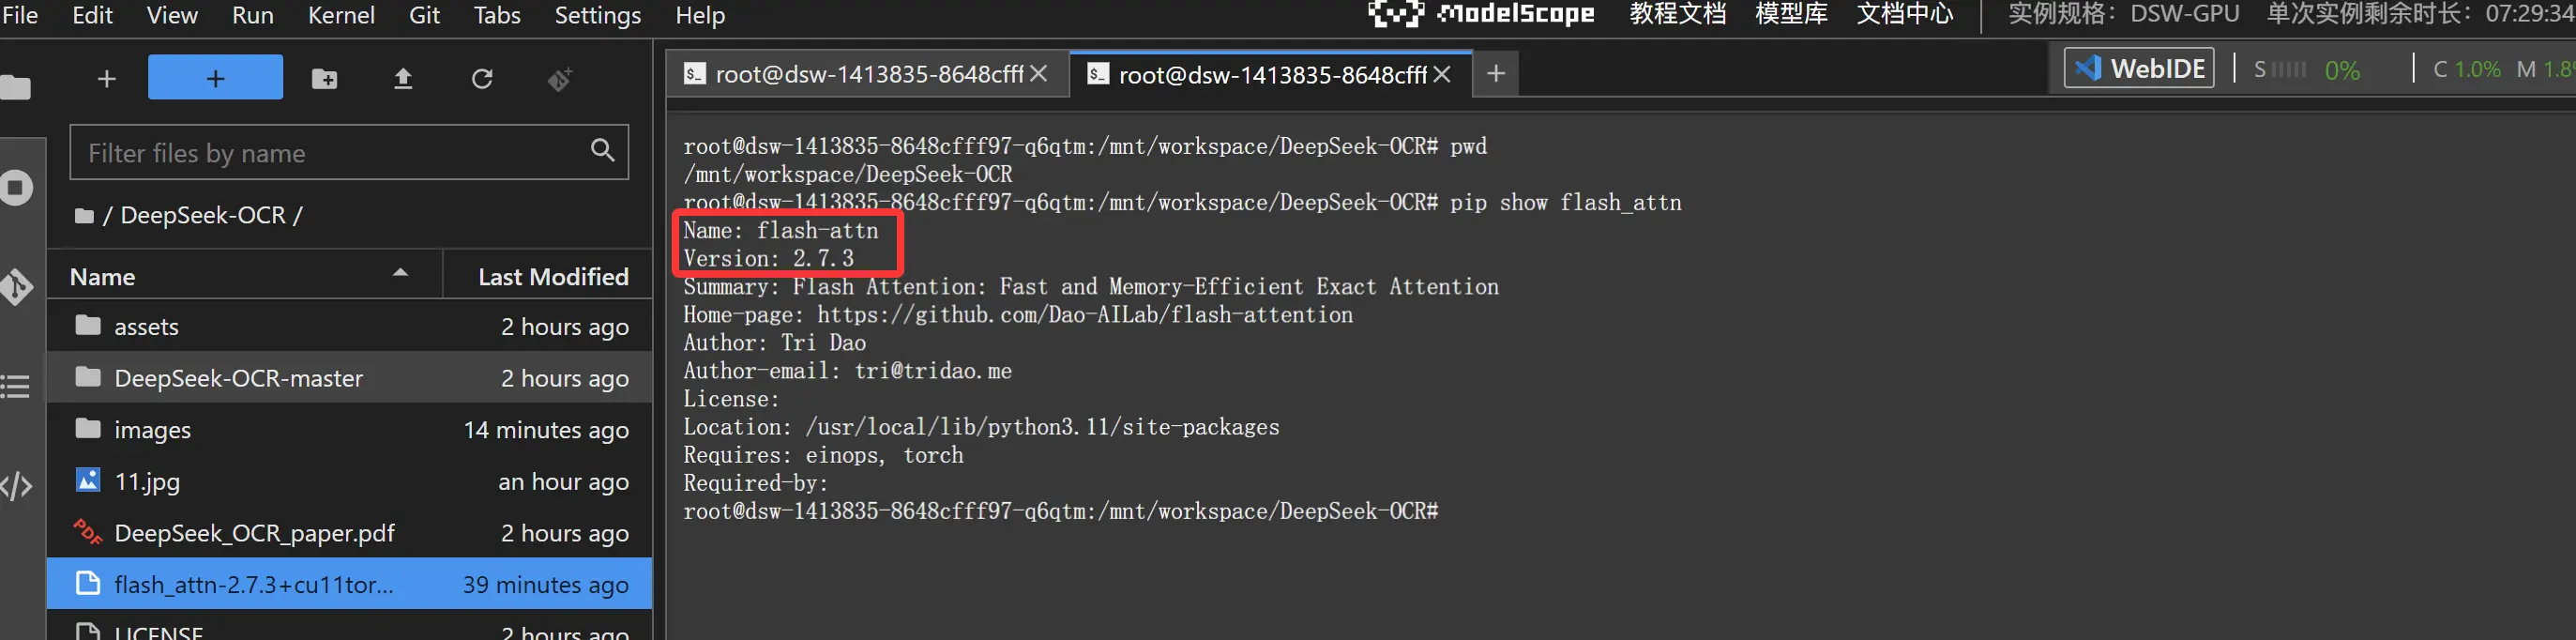
安装完成后我们检查这个依赖
模型推理
我们在github上找到官方的推理代码github.com/deepseek-ai...
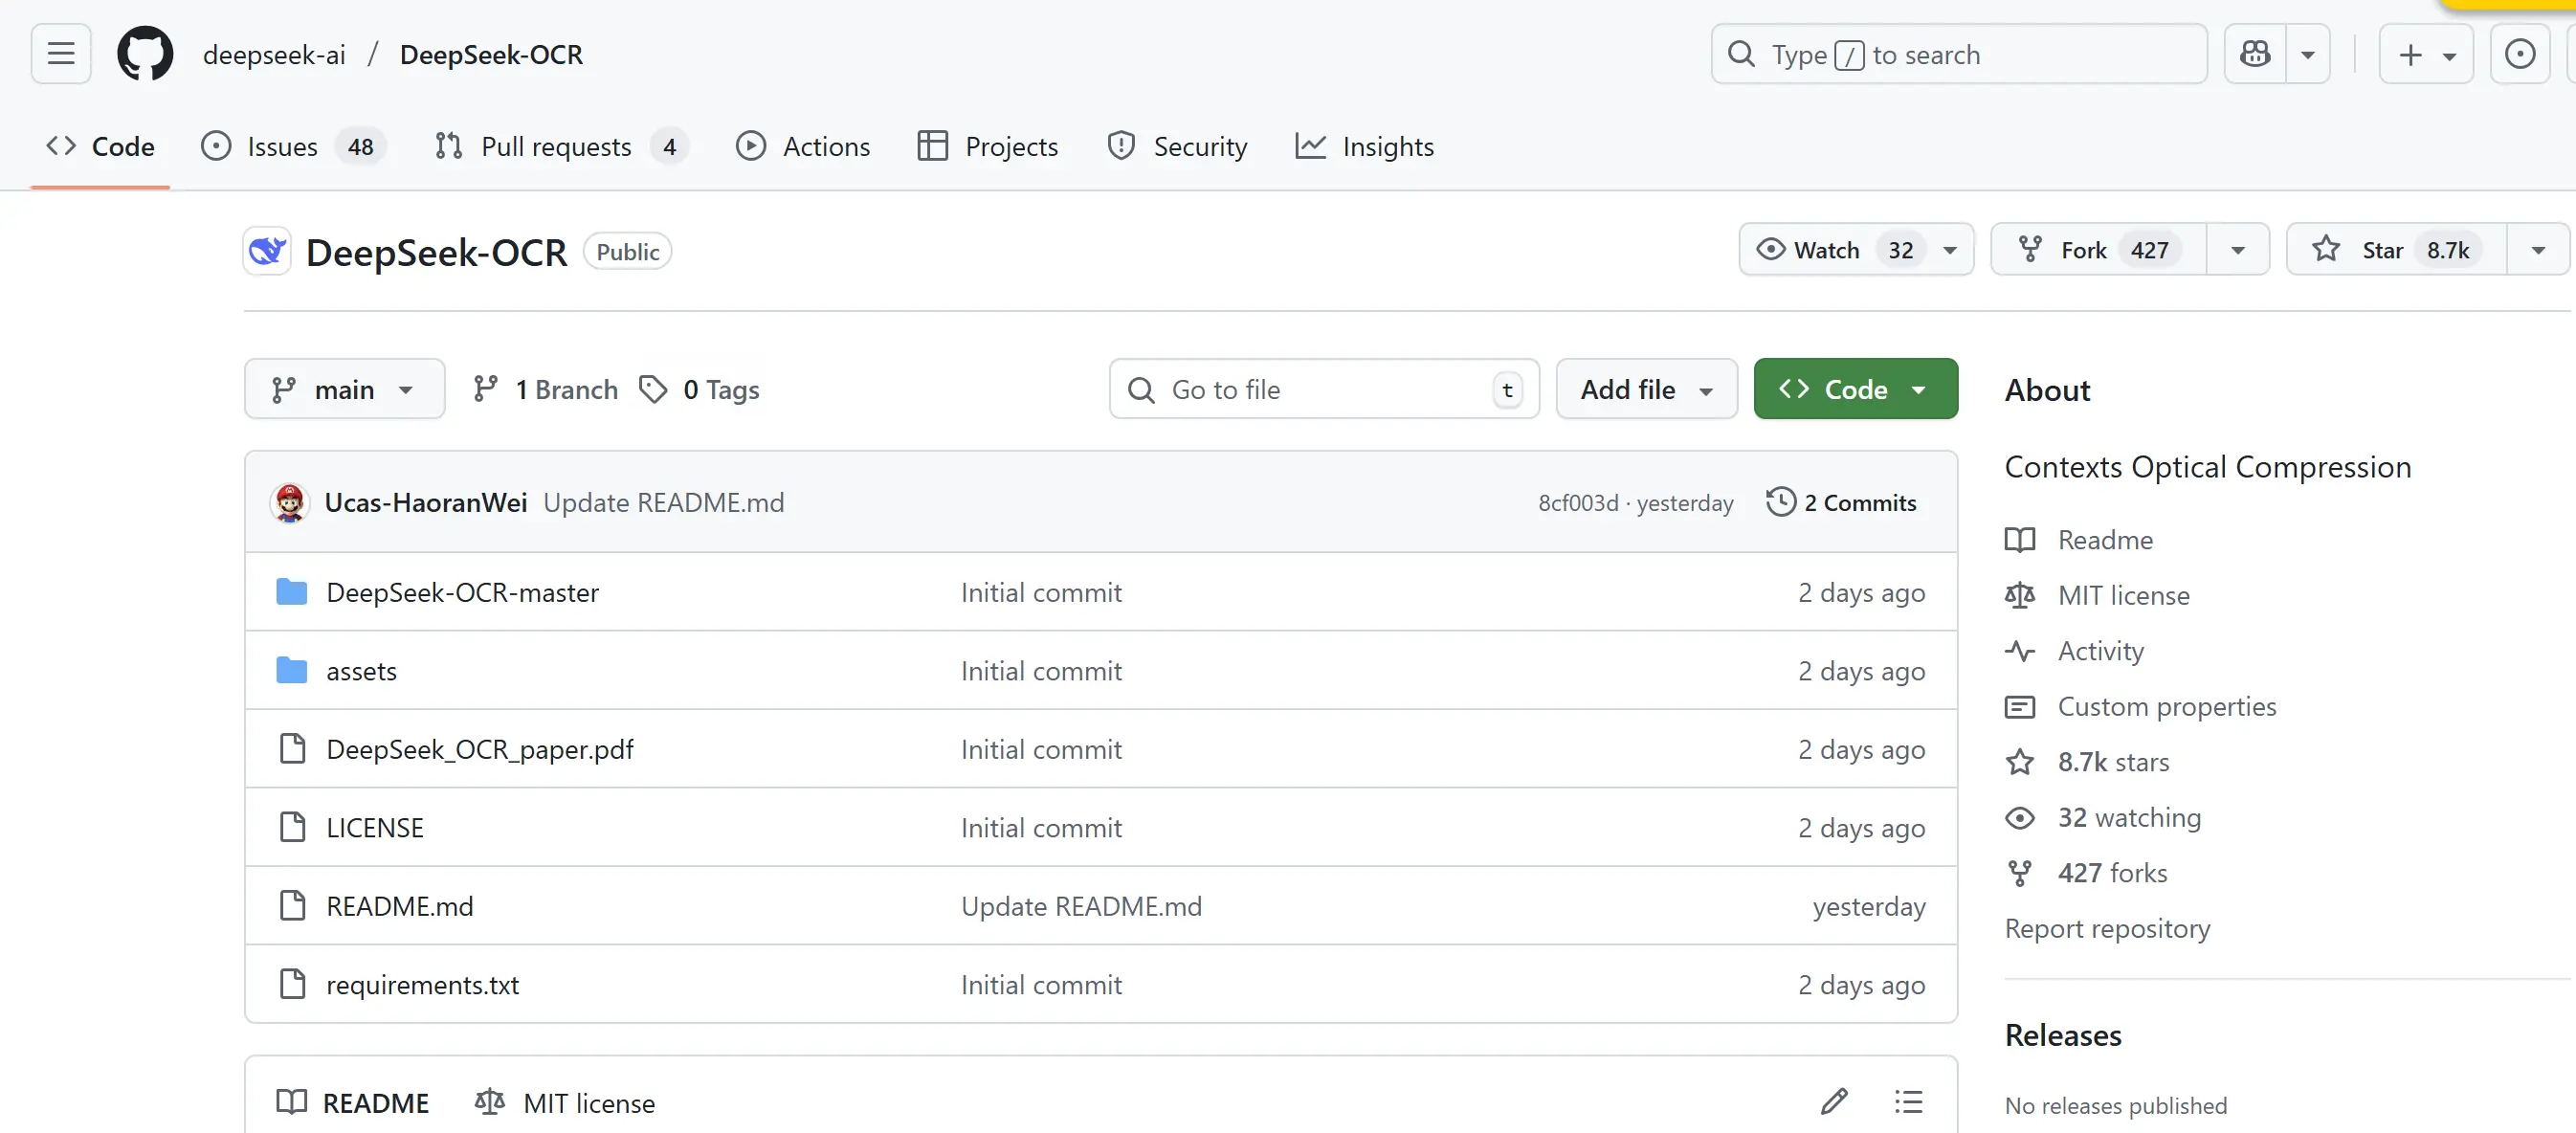
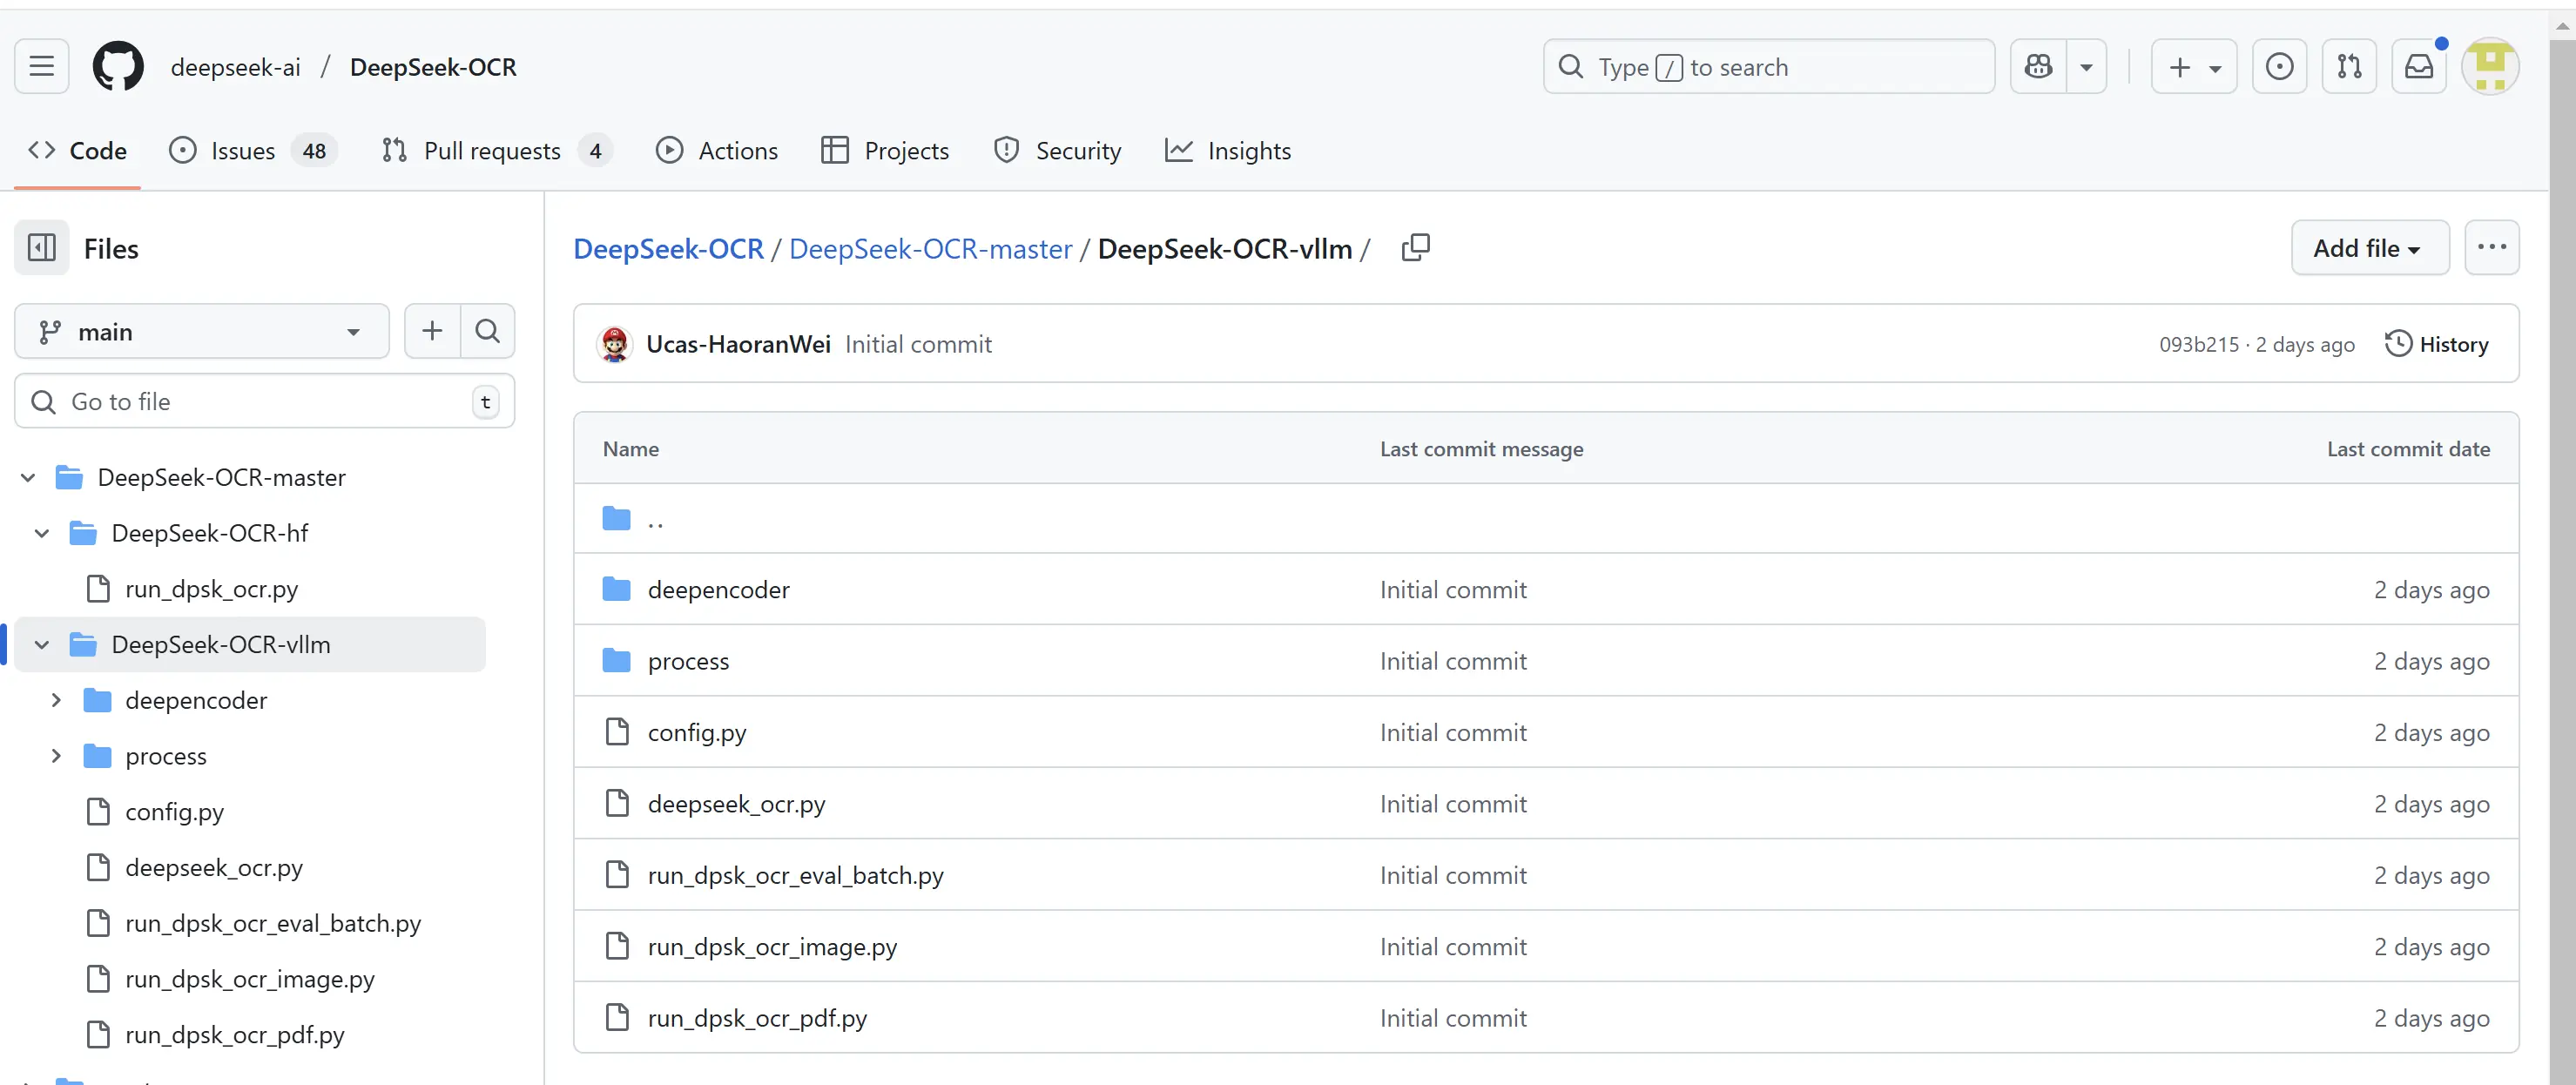
默认的官方推理代码比较简单
我们现在官方的推理代码
bash
cd /mnt/workspace
git clone https://github.com/deepseek-ai/DeepSeek-OCR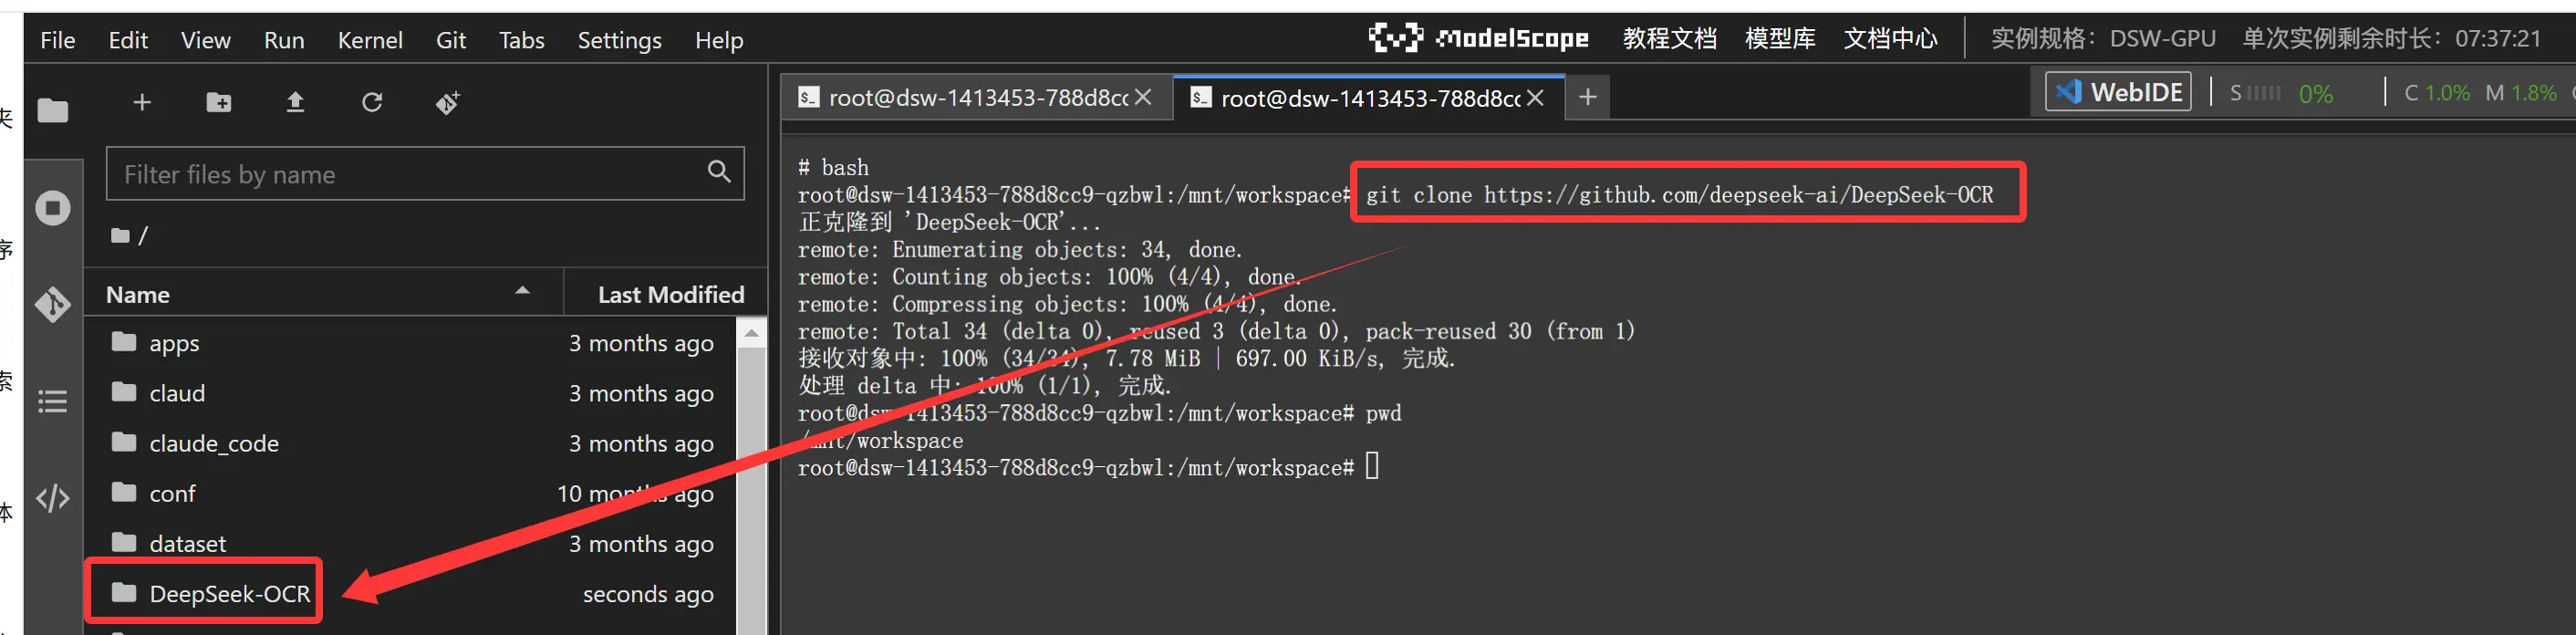
我们需要对推理代码进行修改
/mnt/workspace/DeepSeek-OCR/DeepSeek-OCR-master/DeepSeek-OCR-vllm 目录下的config.py模型地址修改、输入图片、输出图片路径等信息
ini
MODEL_PATH = '/mnt/workspace/models' # change to your model path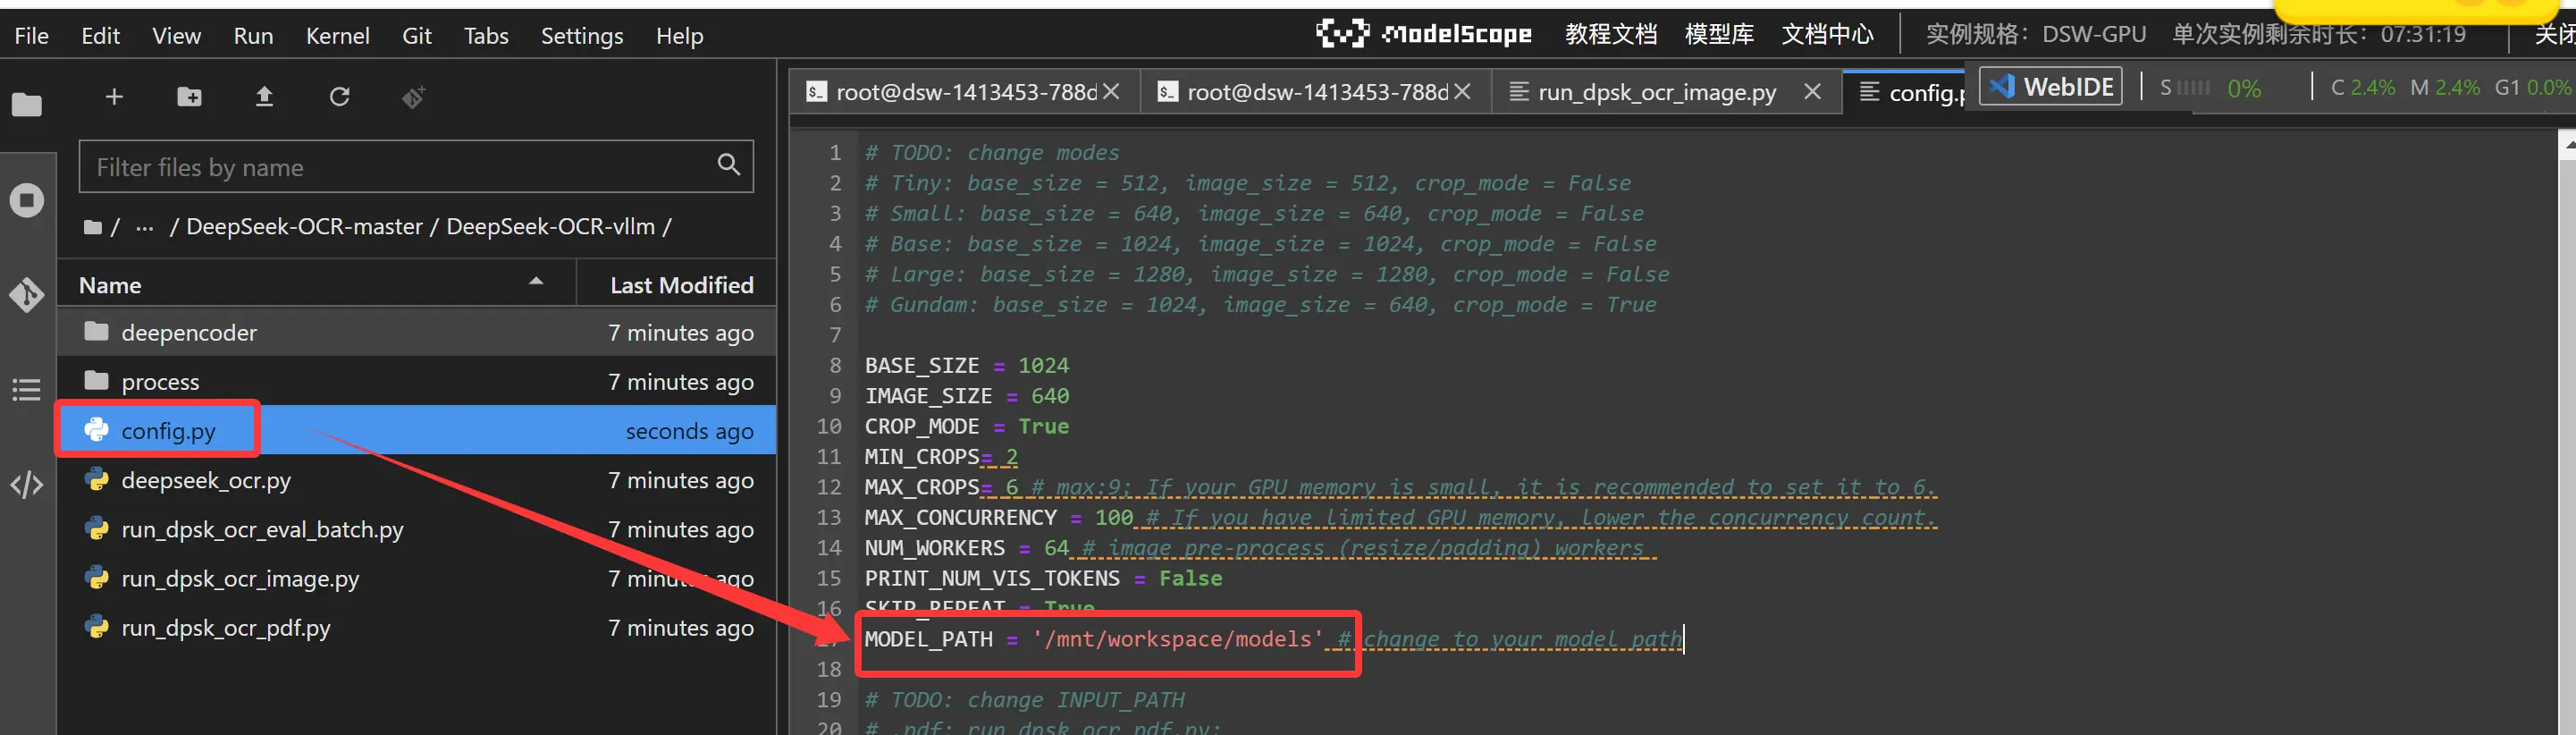
ini
INPUT_PATH = '/mnt/workspace/DeepSeek-OCR/11.jpg'
OUTPUT_PATH = '/mnt/workspace/DeepSeek-OCR'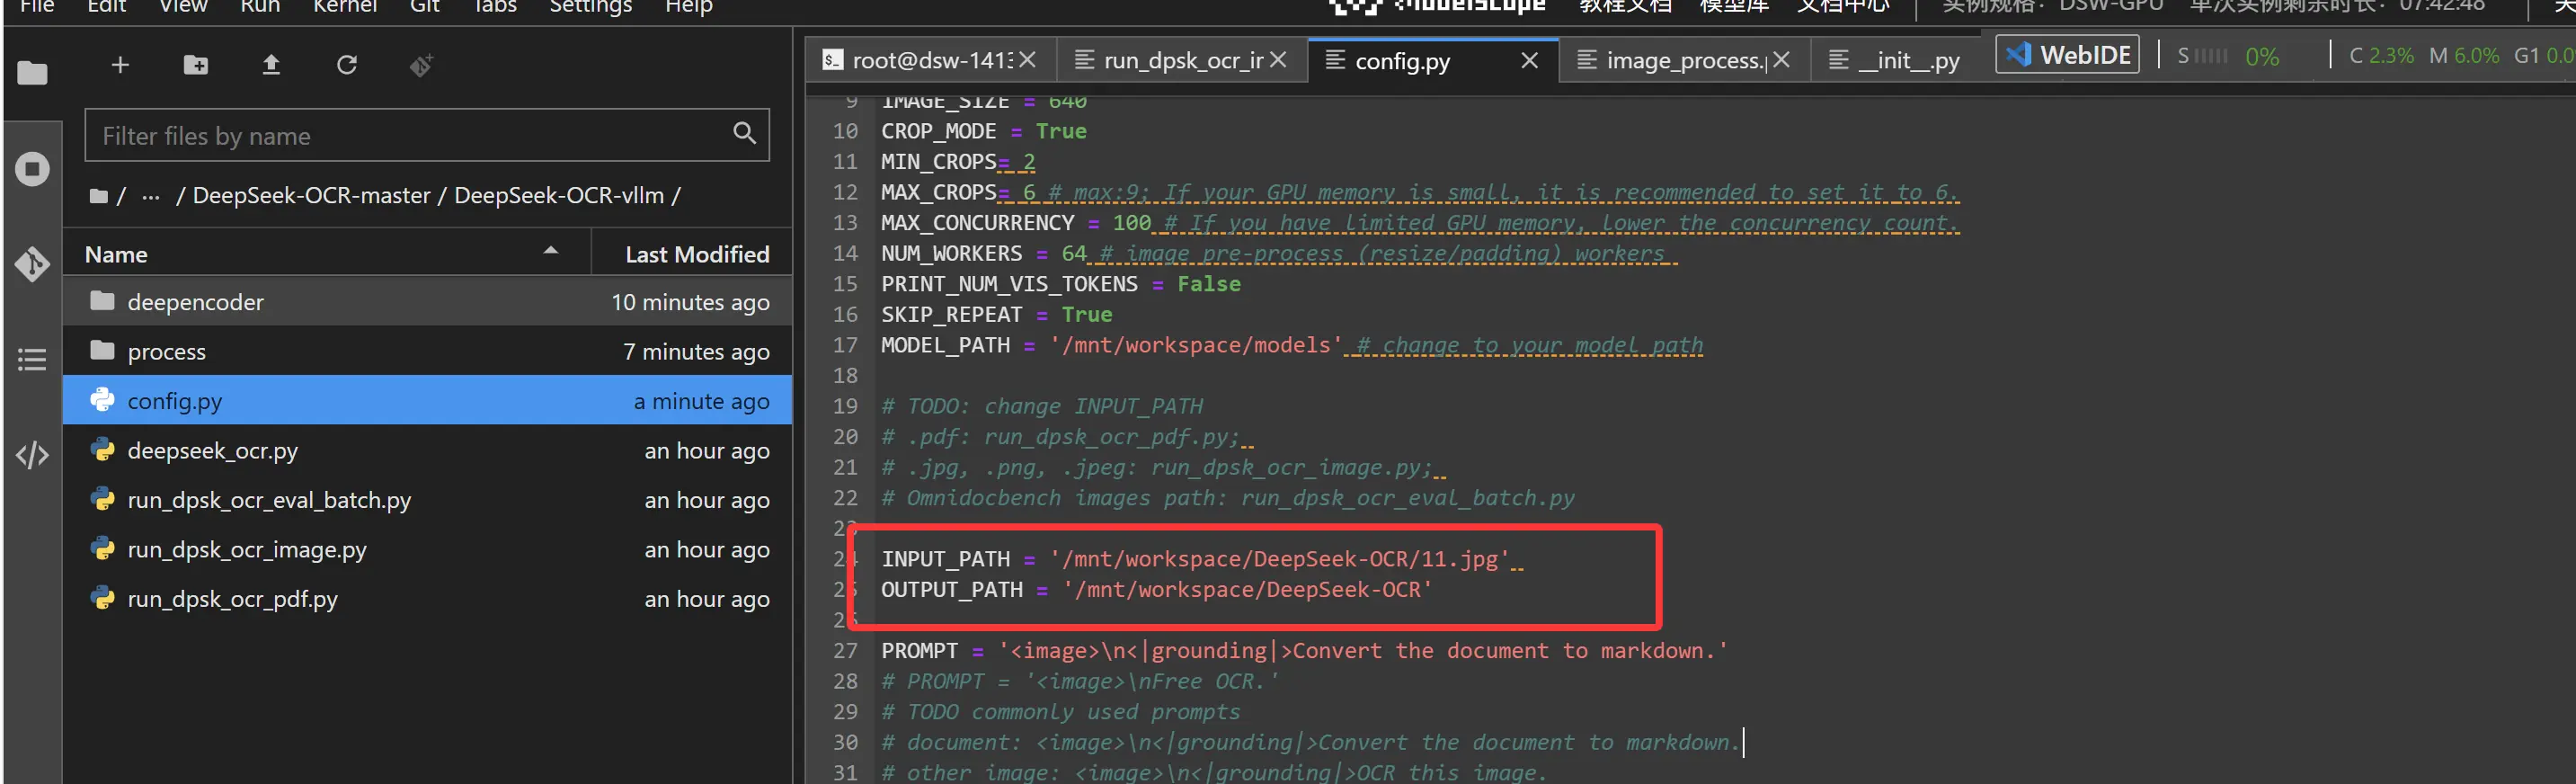
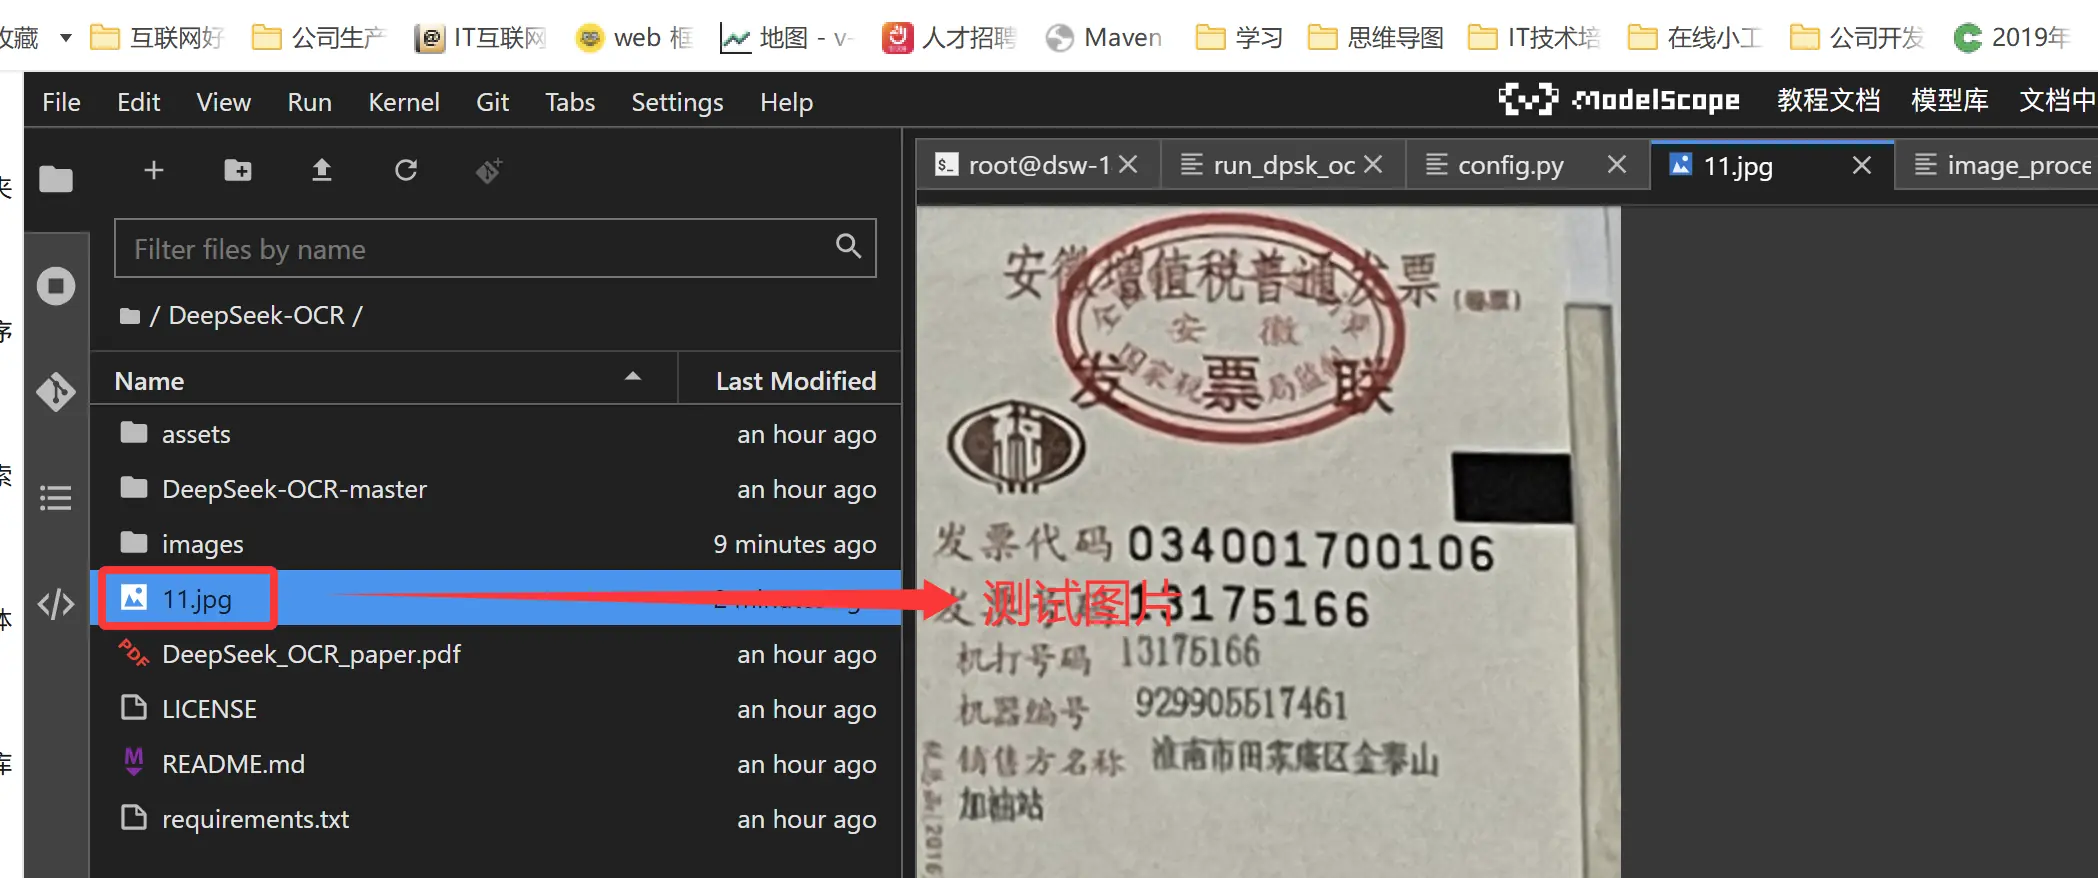
另外我们这里为了测试还需要上传一个11.jpg
接下来我们运行
bash
cd /mnt/workspace/DeepSeek-OCR/DeepSeek-OCR-master/DeepSeek-OCR-vllm
python run_dpsk_ocr_image.py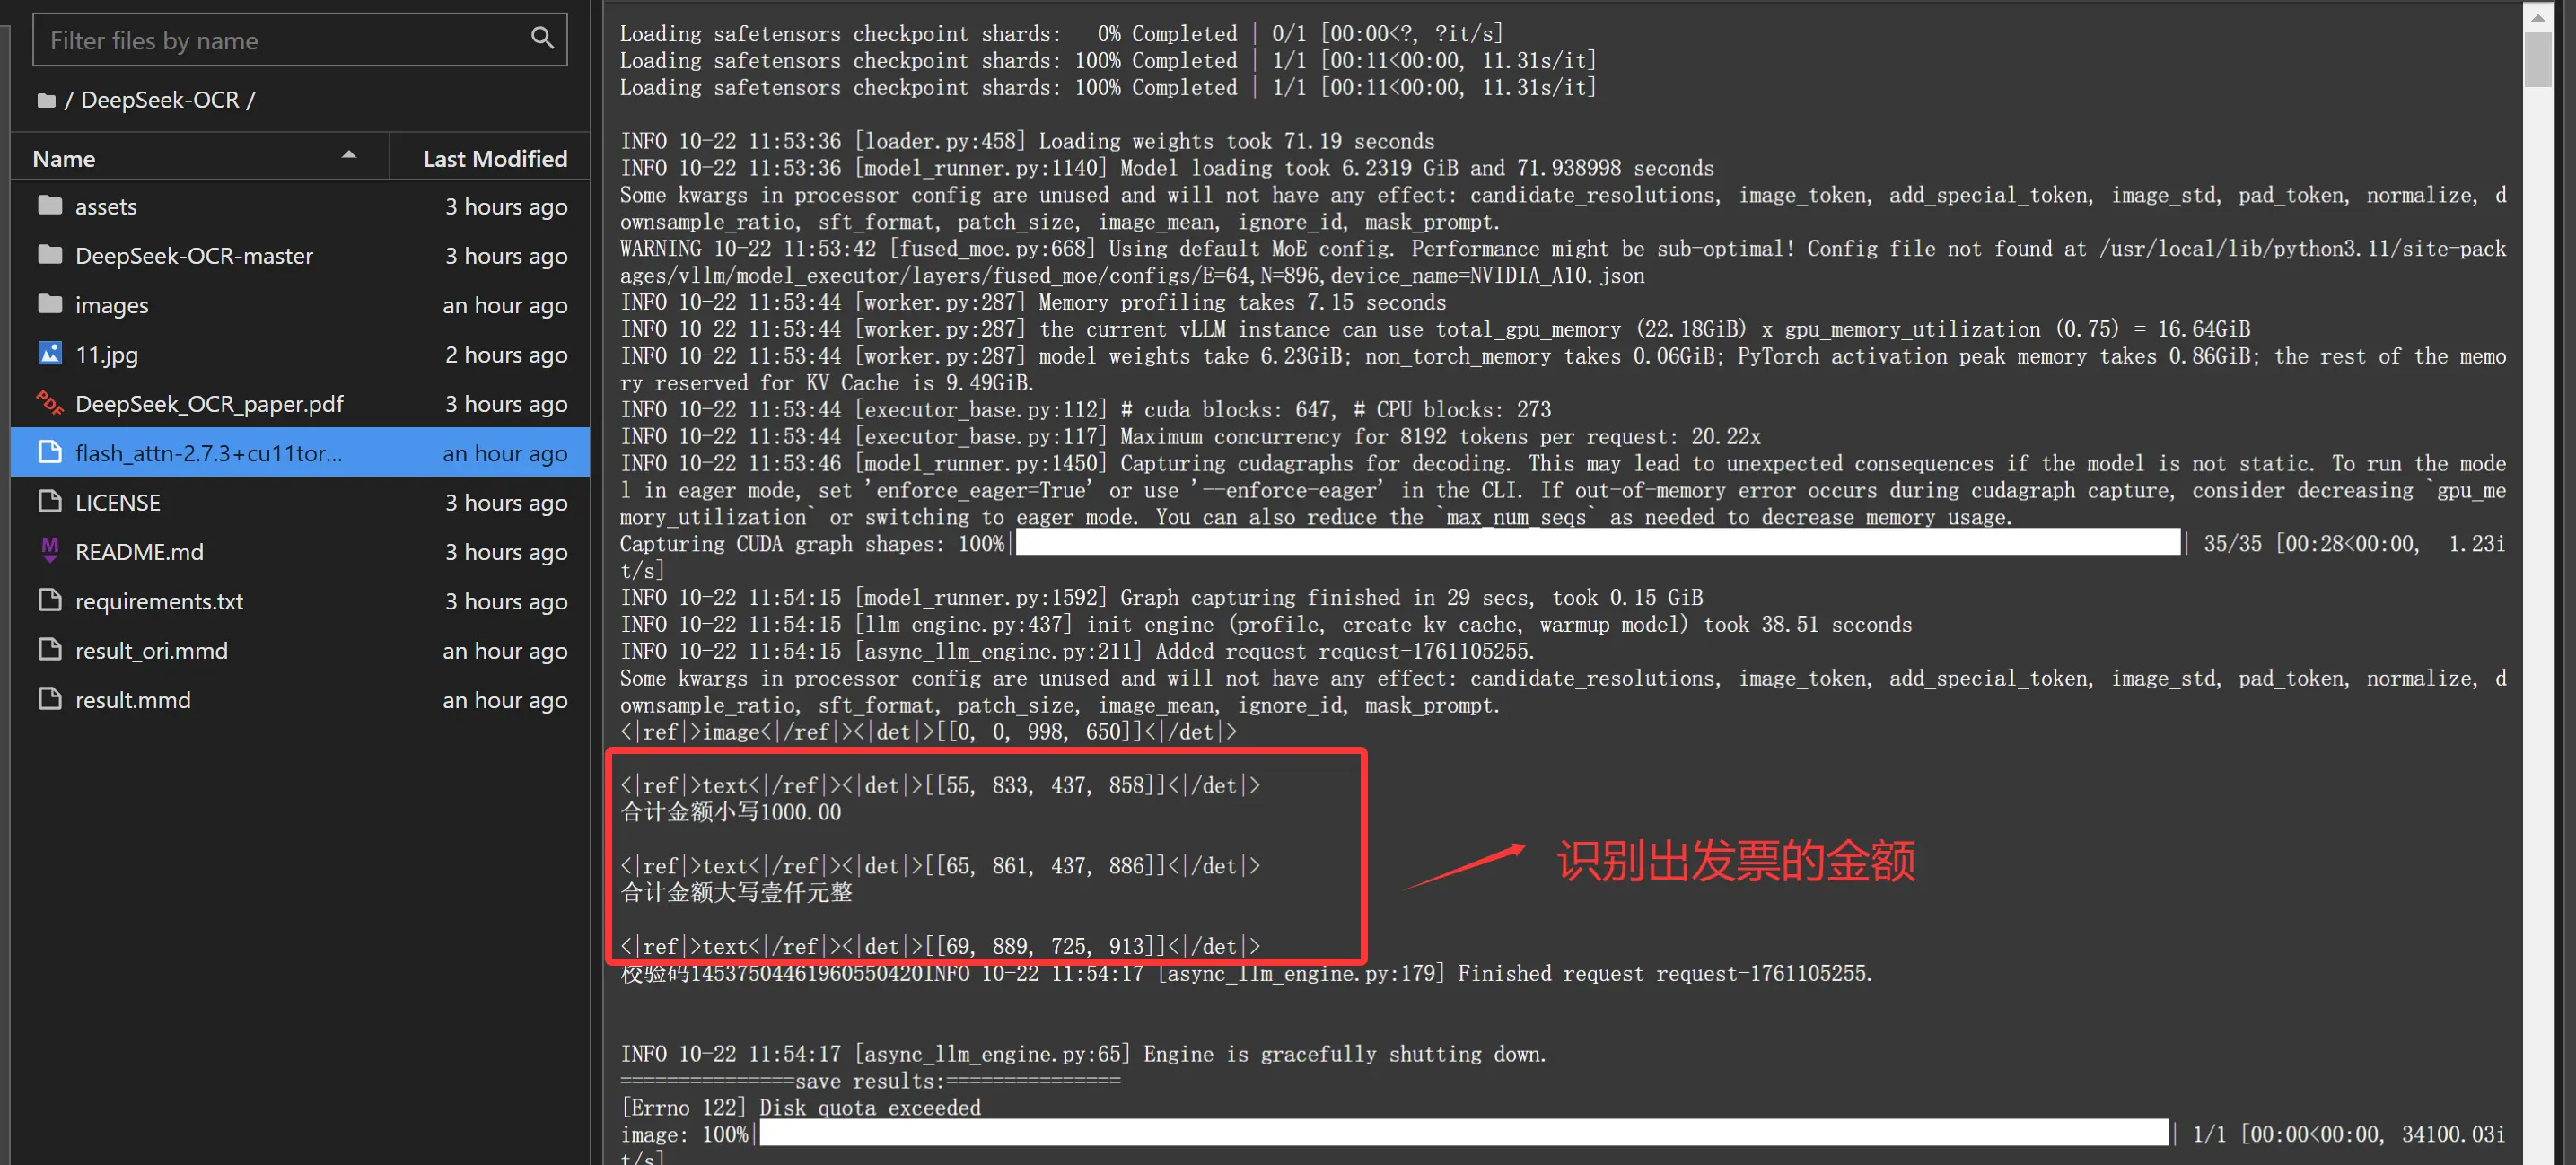 上面的推理都是命令行实现的,目前官方提供的demo确实比较简陋。接下来我们自己编写一个带页面的
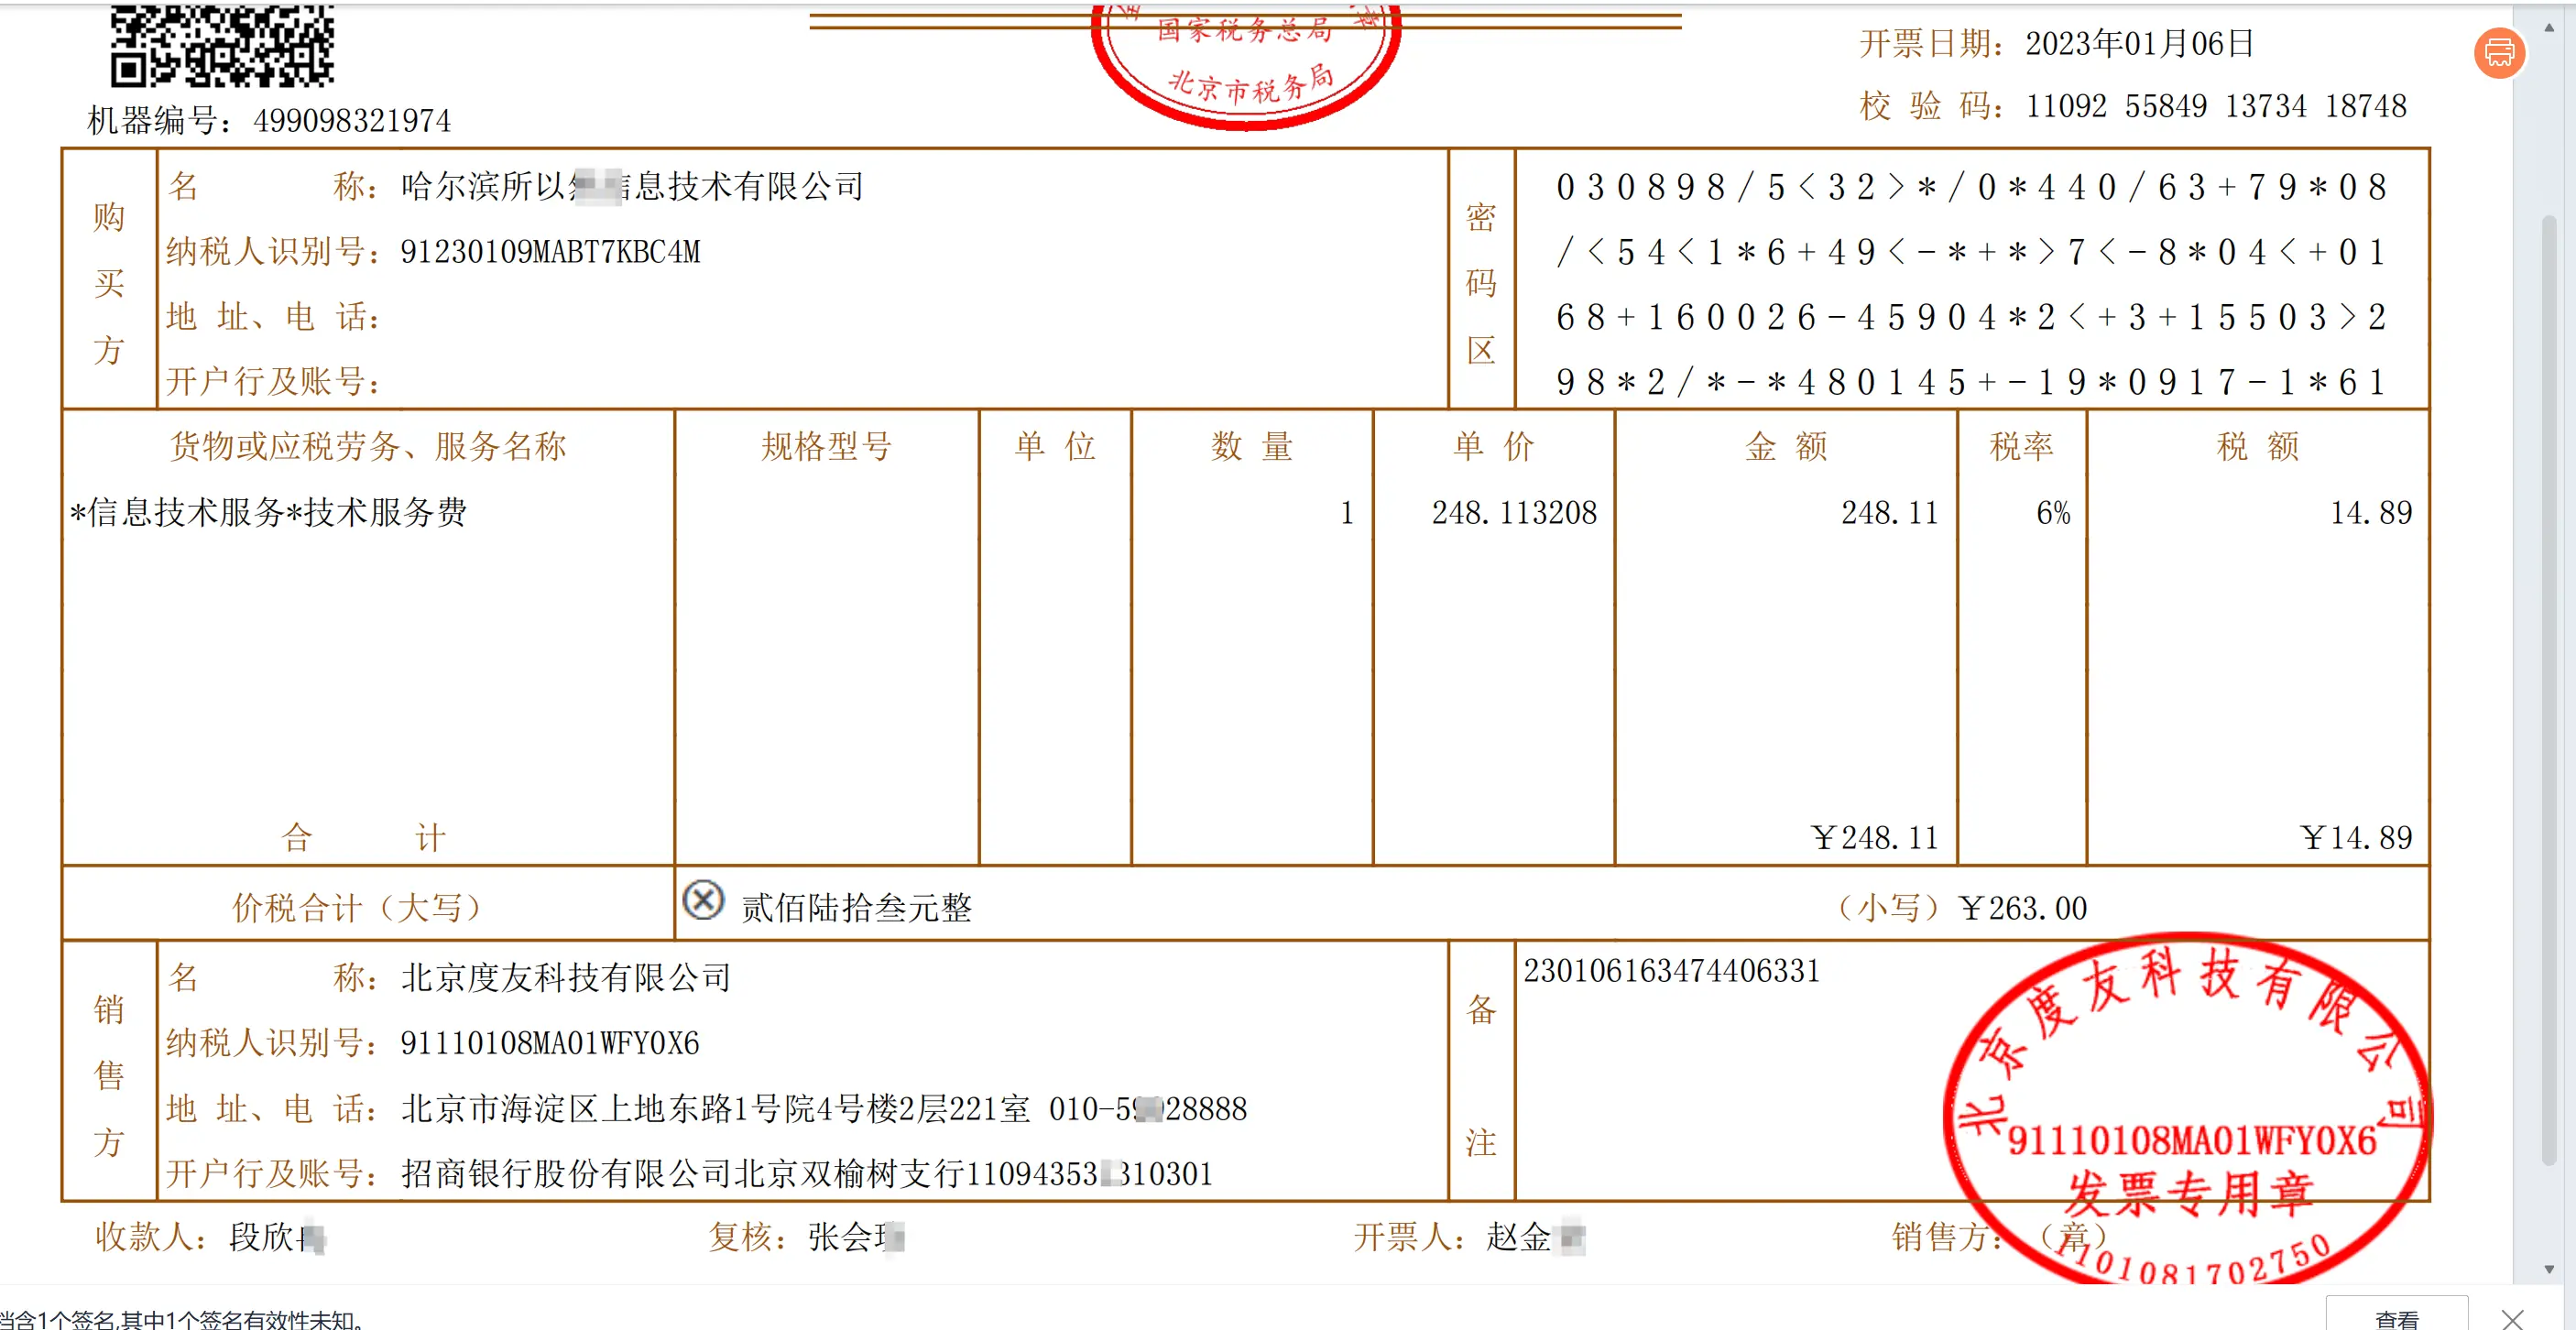
原始票面信息(部分信息我隐掉了)
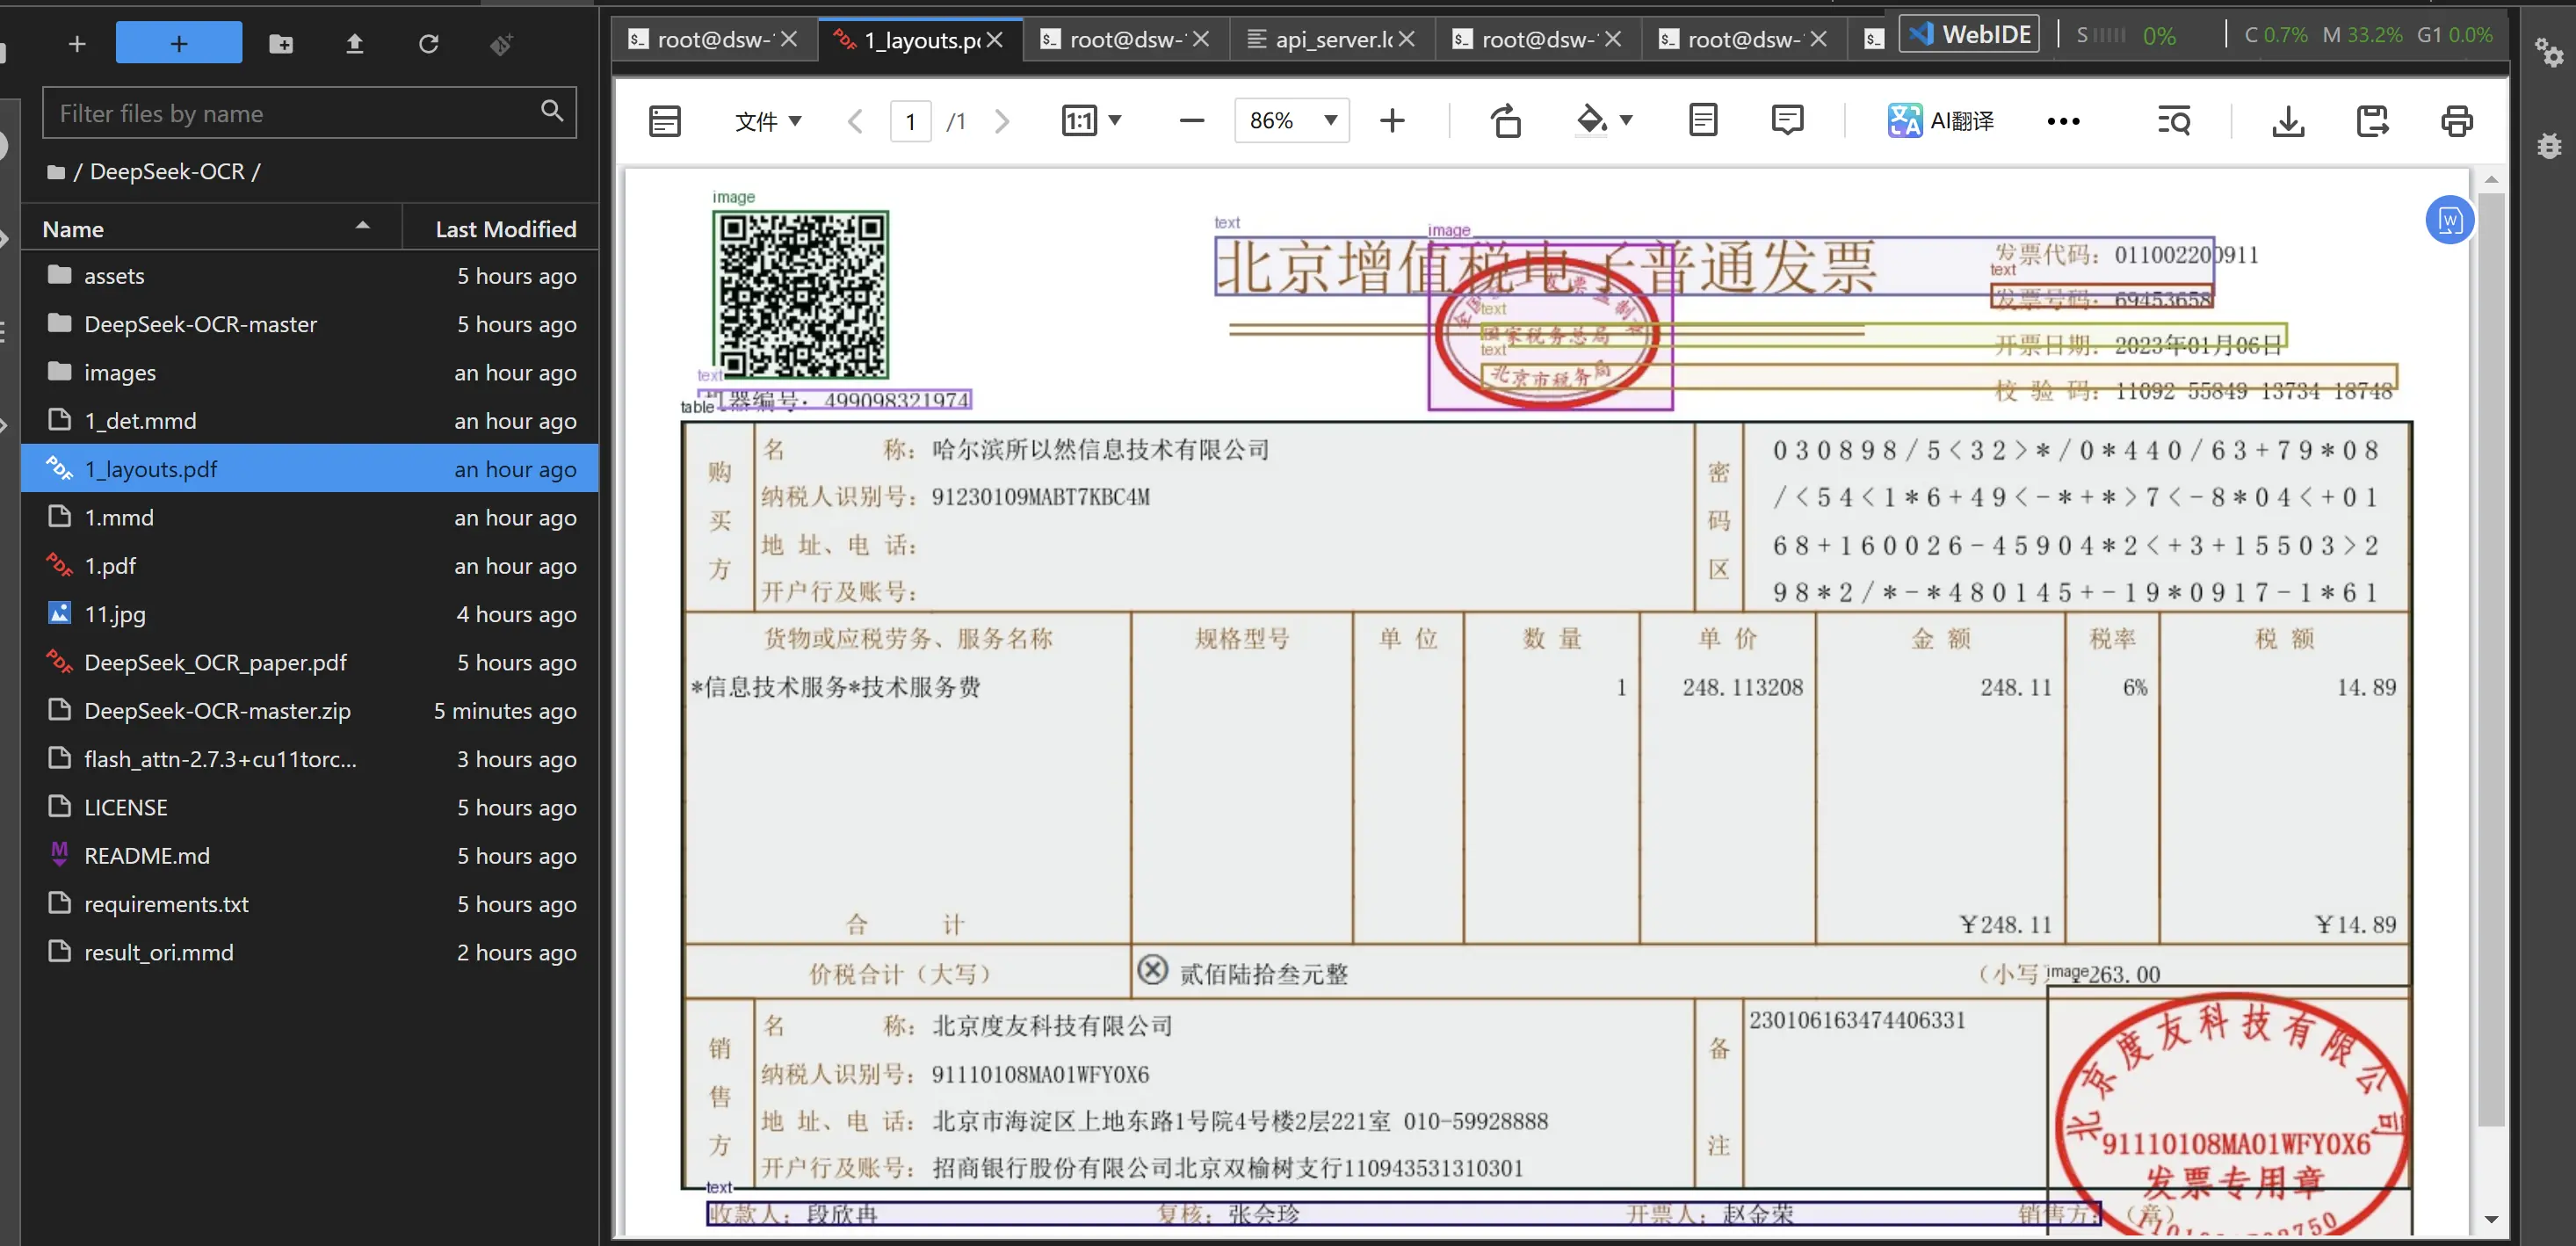
PDF 标注效果如下:
页面识别的效果如下
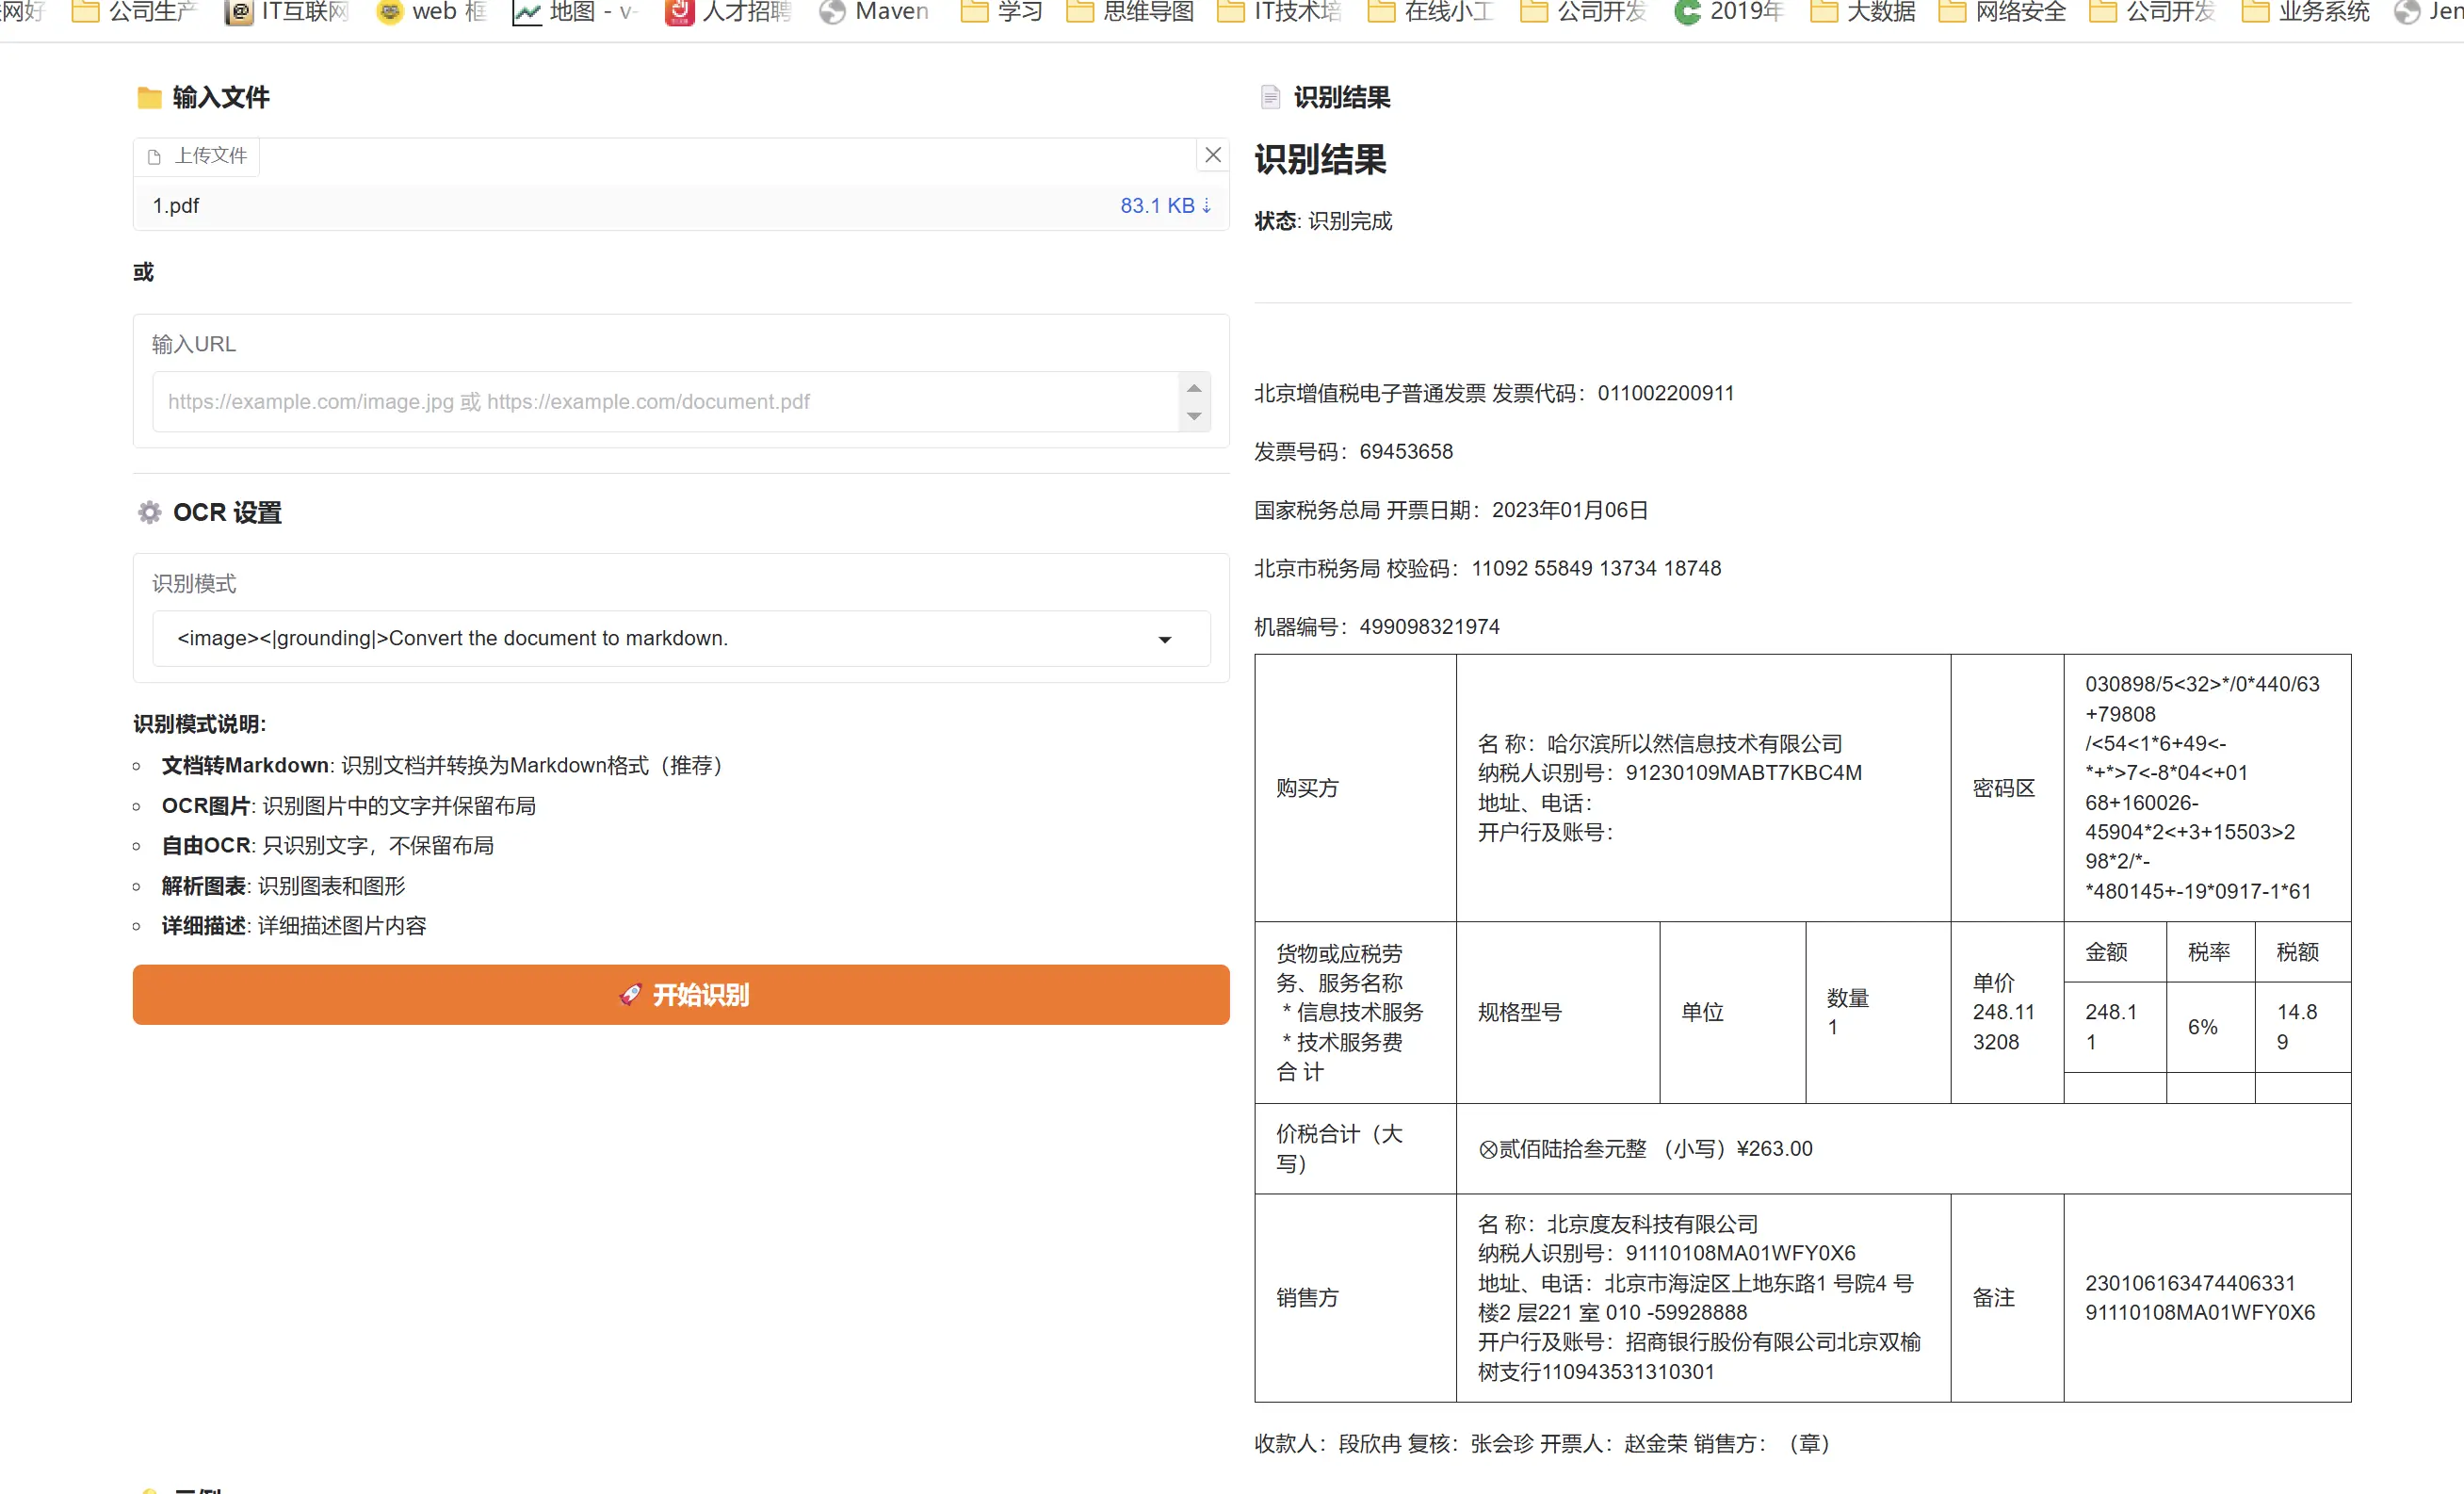
通过对比来看识别率还是挺准的,这张发票基本上识别出来了。
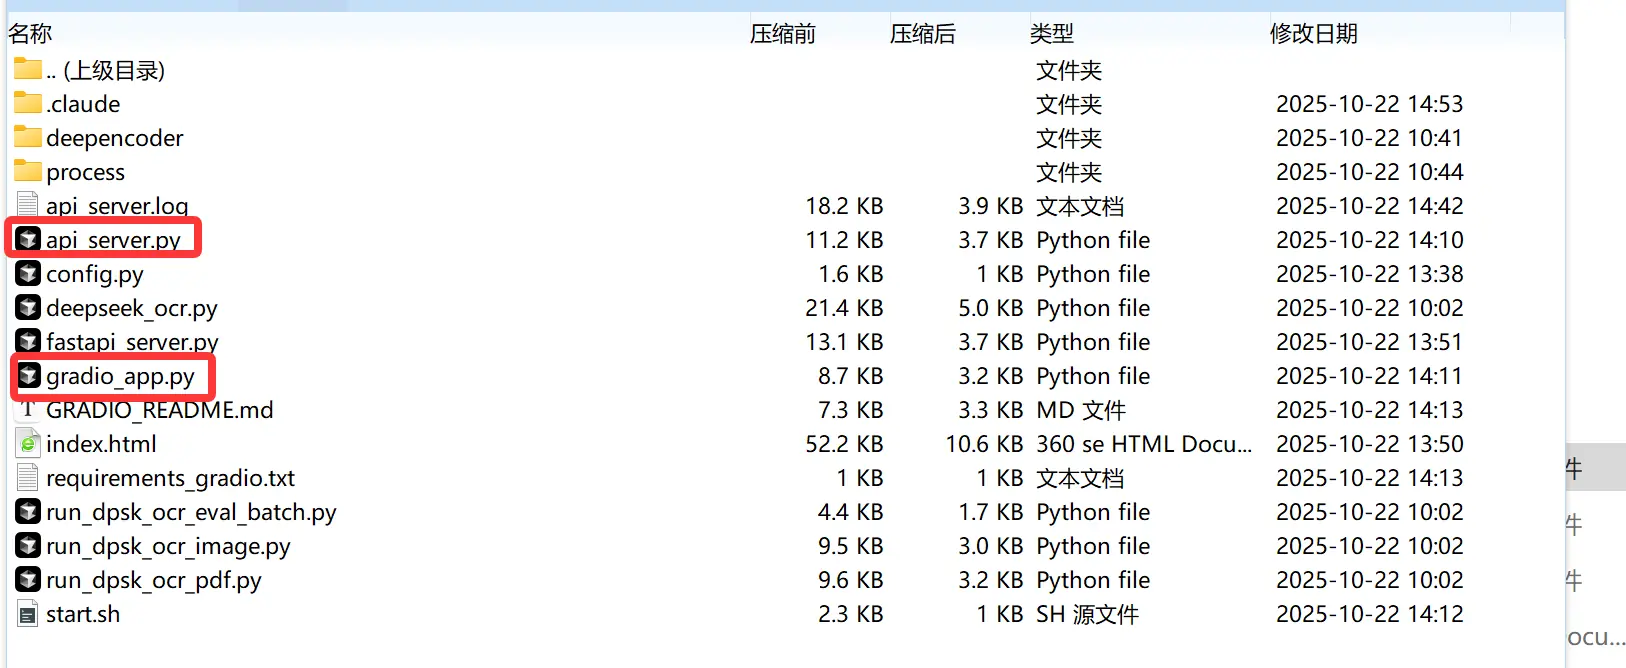
推理的代码有2个一个前端代码 一个是后端代码.代码打包见附件。
通过上面的方式我们轻松在魔搭社区上实现了DeepSeek‑OCR模型的推理。
我们在查看下显存的消耗情况,输入下面的命令
nvidia-smi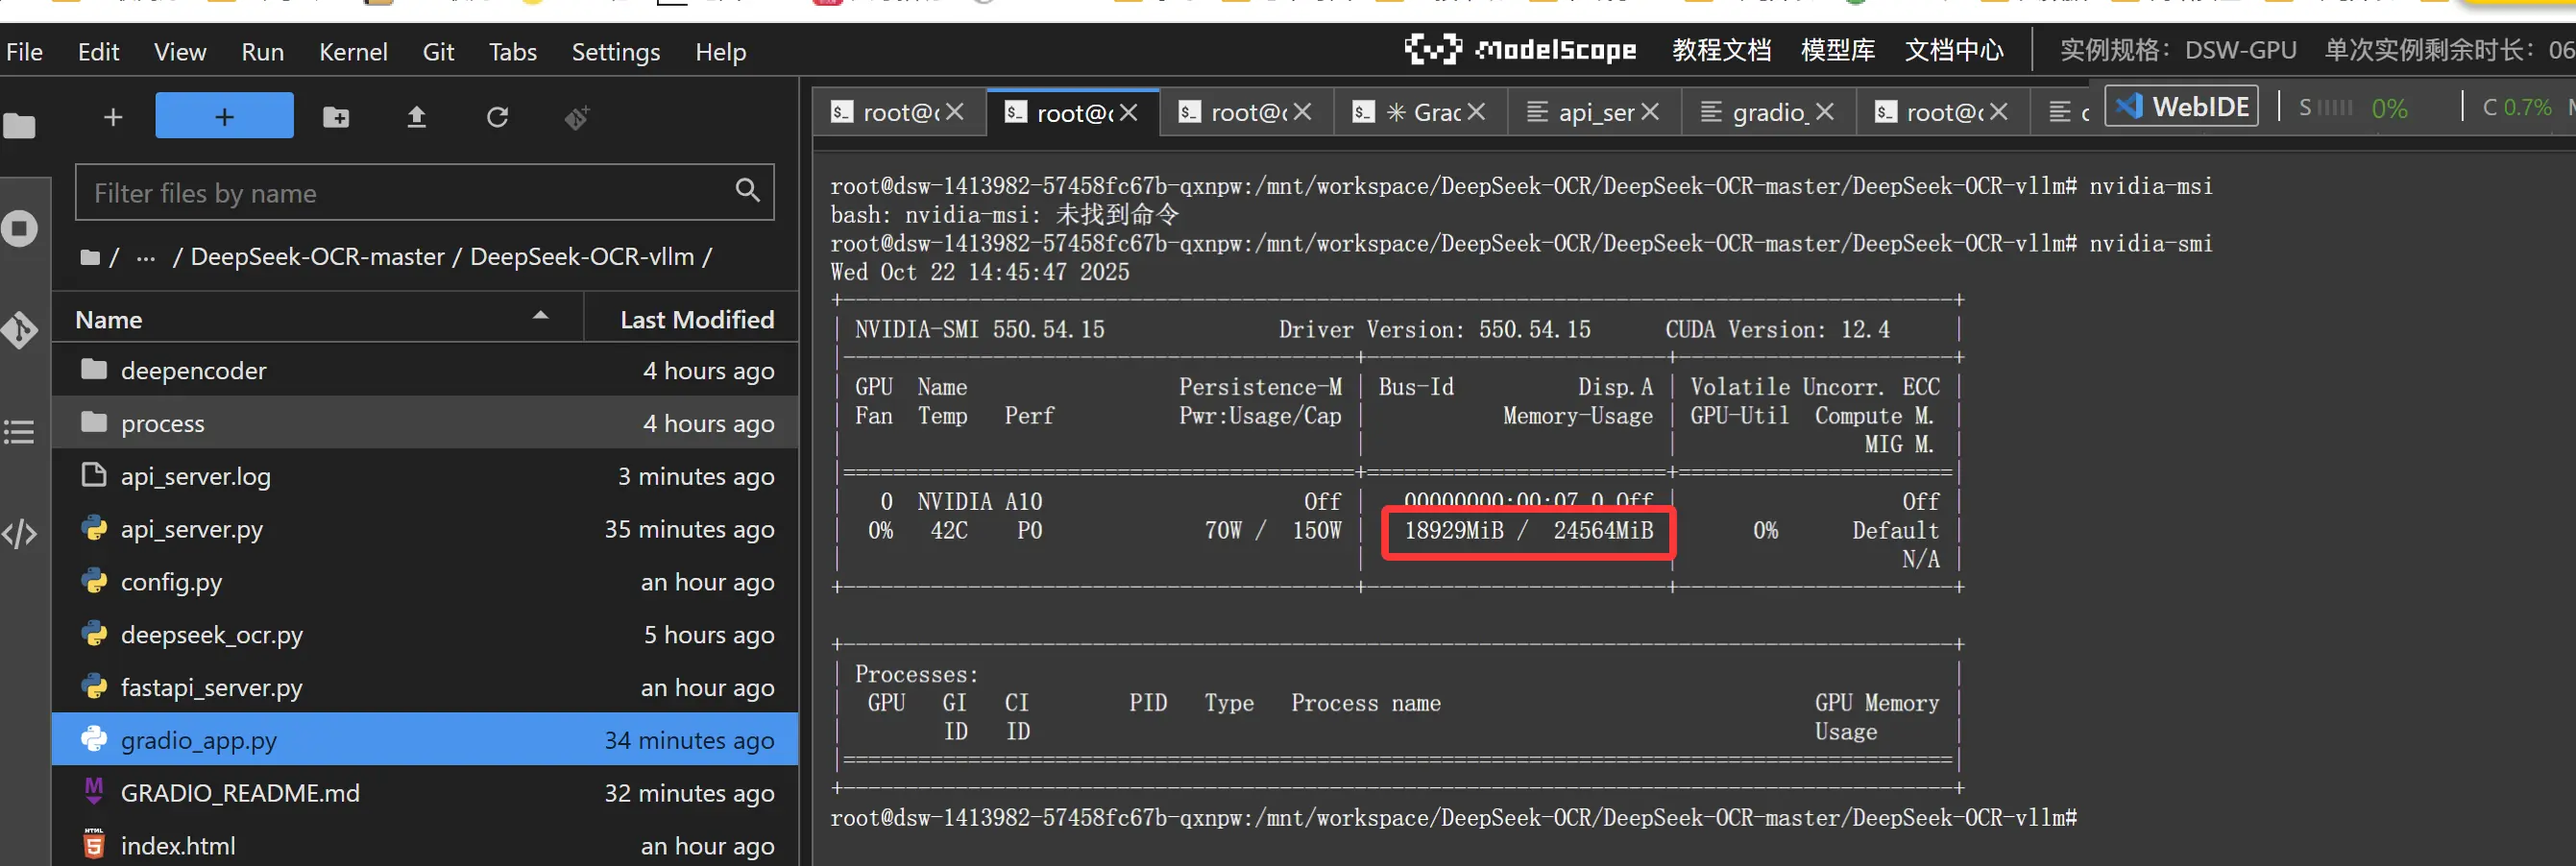
这个显卡大概是24GB显存,目前推理运行起来大概占用到18GB,这里用到VLLM 做推理。有部分是用了显卡的缓存,导致显存占用比较大,实际显存消耗应该小于18GB.基本上家庭消费级显卡是可以运行起来的。
3.总结:
今天主要带大家了解并实现了 DeepSeek-OCR 模型在魔搭社区的部署实战与应用落地完整流程,该流程以 "光学压缩 + MoE 解码" 核心技术为驱动,结合长文本 OCR 识别场景,通过魔搭社区提供的 GPU 环境、模型资源与调试工具,搭配自定义前后端开发,形成了一套从模型下载、环境配置到功能验证的全链路 OCR 解决方案。
通过这套实践方案,开发者能够高效突破传统 OCR 技术瓶颈 ------ 借助清晰的分步操作(包括魔搭 GPU 实例启动、模型权重下载、依赖包适配安装、推理代码修改),无需担心长文本 token 限制或复杂布局识别难题,就能快速实现高精度 OCR 能力落地(如本次发票文档的完整识别)。无论是基础的命令行推理测试、自定义图片路径配置,还是通过 FastAPI 构建的多格式输入 API 服务(支持图片 URL/Base64、PDF URL/Base64)、基于 Gradio 的可视化交互界面,都能通过文中提供的代码与命令完成,极大降低了开源大模型 OCR 技术的应用门槛。在实际验证中,DeepSeek-OCR 不仅保持了 97% 以上的识别精度,还实现 10-20 倍 token 压缩,24GB 显存显卡即可流畅运行,且识别结果支持 Markdown 格式输出,适配性远优于传统 OCR 工具;特别是通过离线包安装 flash-attn 依赖、修改 numpy 版本规避报错等细节处理,有效解决了部署过程中的常见问题。同时,方案具备良好的扩展性 ------ 小伙伴们可以基于此扩展更多实用场景,如多语言文档批量识别、表格结构化提取、PDF 批量转文字、对接业务系统实现自动化文档处理等,进一步发挥长文本 OCR 在办公自动化、数字档案管理等领域的应用价值。
感兴趣的小伙伴可以按照文中提供的步骤进行实践,根据实际业务需求调整 API 接口逻辑或前端交互样式。今天的分享就到这里结束了,我们下一篇文章见。
附件代码
通过网盘分享的文件:DeepSeek-OCR-master.zip
链接: pan.baidu.com/s/1LeELopB3... 提取码: cnkb
#首发于魔搭研习社