前言
在 Netty 编程中,writeAndFlush() 是我们最常使用的方法之一。它代表着从用户层到内核缓冲区的一整条出站(Outbound)数据路径。本章将从源码层面,深入分析 writeAndFlush() 的执行流程与关键机制。
write方法
在前面讲解编解码器时,我们提到过"编码"的概念。编码指的是将服务器处理完的业务对象转换为字节码 的过程。
因为数据写出属于 Outbound 事件 ,所以负责编码的 Handler 一般位于管道尾部(TailHandler)之前,如下图所示:
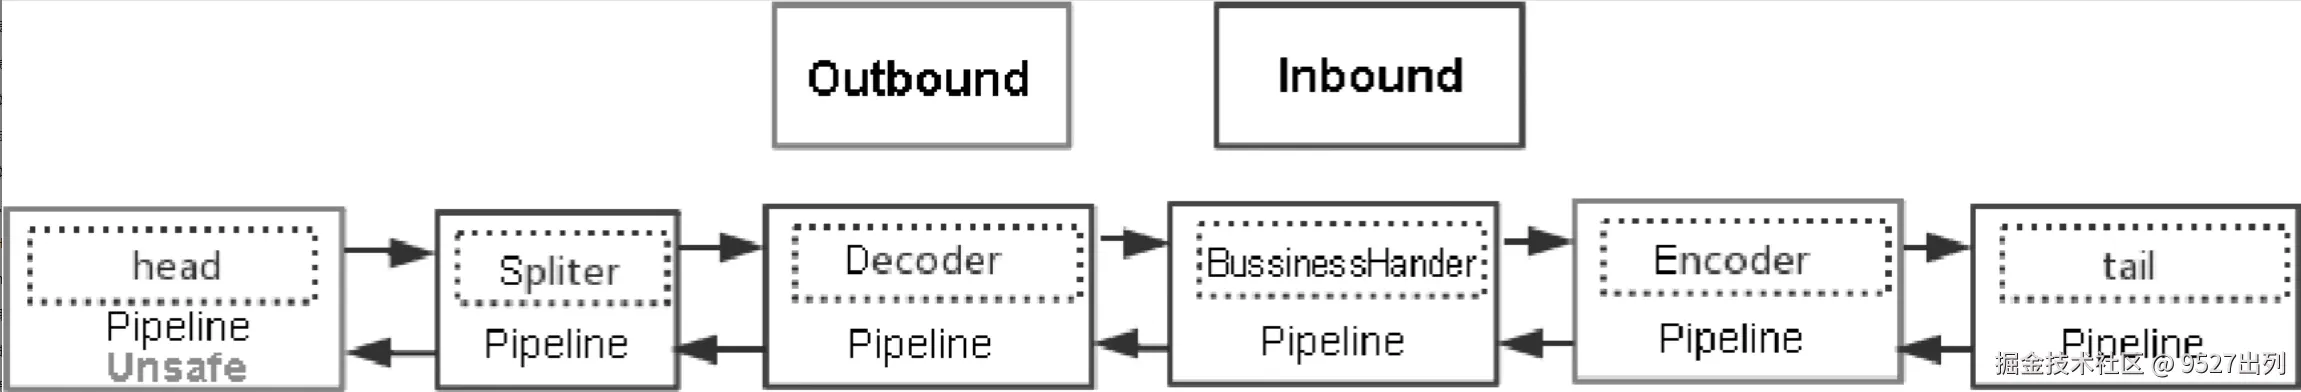
典型的编码器(Encoder)通常继承自 MessageToByteEncoder。
当我们调用 ctx.channel().write() 时,Netty 会从管道尾部(Tail)开始,依次调用所有 Outbound 类型的 Handler。
1. MessageToByteEncoder.write()
ini
MessageToByteEncoder

public void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) throws Exception {
    ByteBuf buf = null;
    try {
        if (acceptOutboundMessage(msg)) {
            I cast = (I) msg;
            buf = allocateBuffer(ctx, cast, preferDirect);
            try {
                encode(ctx, cast, buf);
            } finally {
                ReferenceCountUtil.release(cast);
            }

            if (buf.isReadable()) {
                ctx.write(buf, promise);
            } else {
                buf.release();
                ctx.write(Unpooled.EMPTY_BUFFER, promise);
            }
            buf = null;
        } else {
            ctx.write(msg, promise);
        }
    } catch (Throwable e) {
        throw new EncoderException(e);
    } finally {
        if (buf != null) {
            buf.release();
        }
    }
}
这一过程可分为以下几个步骤:
- 判断消息类型 :若当前
Handler能处理该消息,则进入后续流程,否则直接传递给下一个节点。 - 类型转换:将消息强制转换为编码器可处理的类型。
- 分配 ByteBuf:为编码后的字节数据分配缓冲区。
- 编码过程 :调用
encode()方法(用户自定义逻辑),将对象序列化为字节。 - 释放原对象:数据已被写入 ByteBuf,原消息对象不再需要。
- 传递下一个节点 :若
buf中有数据则继续传递,否则释放。 - 最终释放资源:在 Pipeline 中处理完毕后释放 ByteBuf。
2. HeadContext.write()
所有 Outbound Handler 执行完后,ByteBuf 会进入管道首部(Head):
arduino
HeadContext

@Override
public void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) throws Exception {
    unsafe.write(msg, promise);
}
这里的 unsafe.write() 实际由 AbstractUnsafe 实现:
ini
public final void write(Object msg, ChannelPromise promise) {
    assertEventLoop();

    ChannelOutboundBuffer outboundBuffer = this.outboundBuffer;
    if (outboundBuffer == null) {
        safeSetFailure(promise, WRITE_CLOSED_CHANNEL_EXCEPTION);
        ReferenceCountUtil.release(msg);
        return;
    }

    int size;
    try {
        msg = filterOutboundMessage(msg);
        size = pipeline.estimatorHandle().size(msg);
        if (size < 0) size = 0;
    } catch (Throwable t) {
        safeSetFailure(promise, t);
        ReferenceCountUtil.release(msg);
        return;
    }

    outboundBuffer.addMessage(msg, size, promise);
}
核心逻辑如下:
- 确保线程安全 :
assertEventLoop()确认当前操作在 Reactor 线程中。 - 过滤消息类型 :通过
filterOutboundMessage()处理不同类型的消息。 - 估算写入字节数:用于流控与统计。
- 加入写缓冲区 :调用
ChannelOutboundBuffer.addMessage()存入待写链表。
ChannelOutboundBuffer
ChannelOutboundBuffer 内部维护了一个单向链表结构,用来保存待写的 ByteBuf 节点。
ini
public void addMessage(Object msg, int size, ChannelPromise promise) {
    Entry entry = Entry.newInstance(msg, size, total(msg), promise);
    if (tailEntry == null) {
        flushedEntry = null;
        tailEntry = entry;
    } else {
        tailEntry.next = entry;
        tailEntry = entry;
    }
    if (unflushedEntry == null) {
        unflushedEntry = entry;
    }
    incrementPendingOutboundBytes(size, false);
}
该链表包含三个重要指针:
| 指针 | 含义 |
|---|---|
| flushedEntry | 已刷新(写入操作系统缓冲区)的第一个节点 |
| unflushedEntry | 尚未刷新到内核缓冲区的第一个节点 |
| tailEntry | 链表尾节点 |
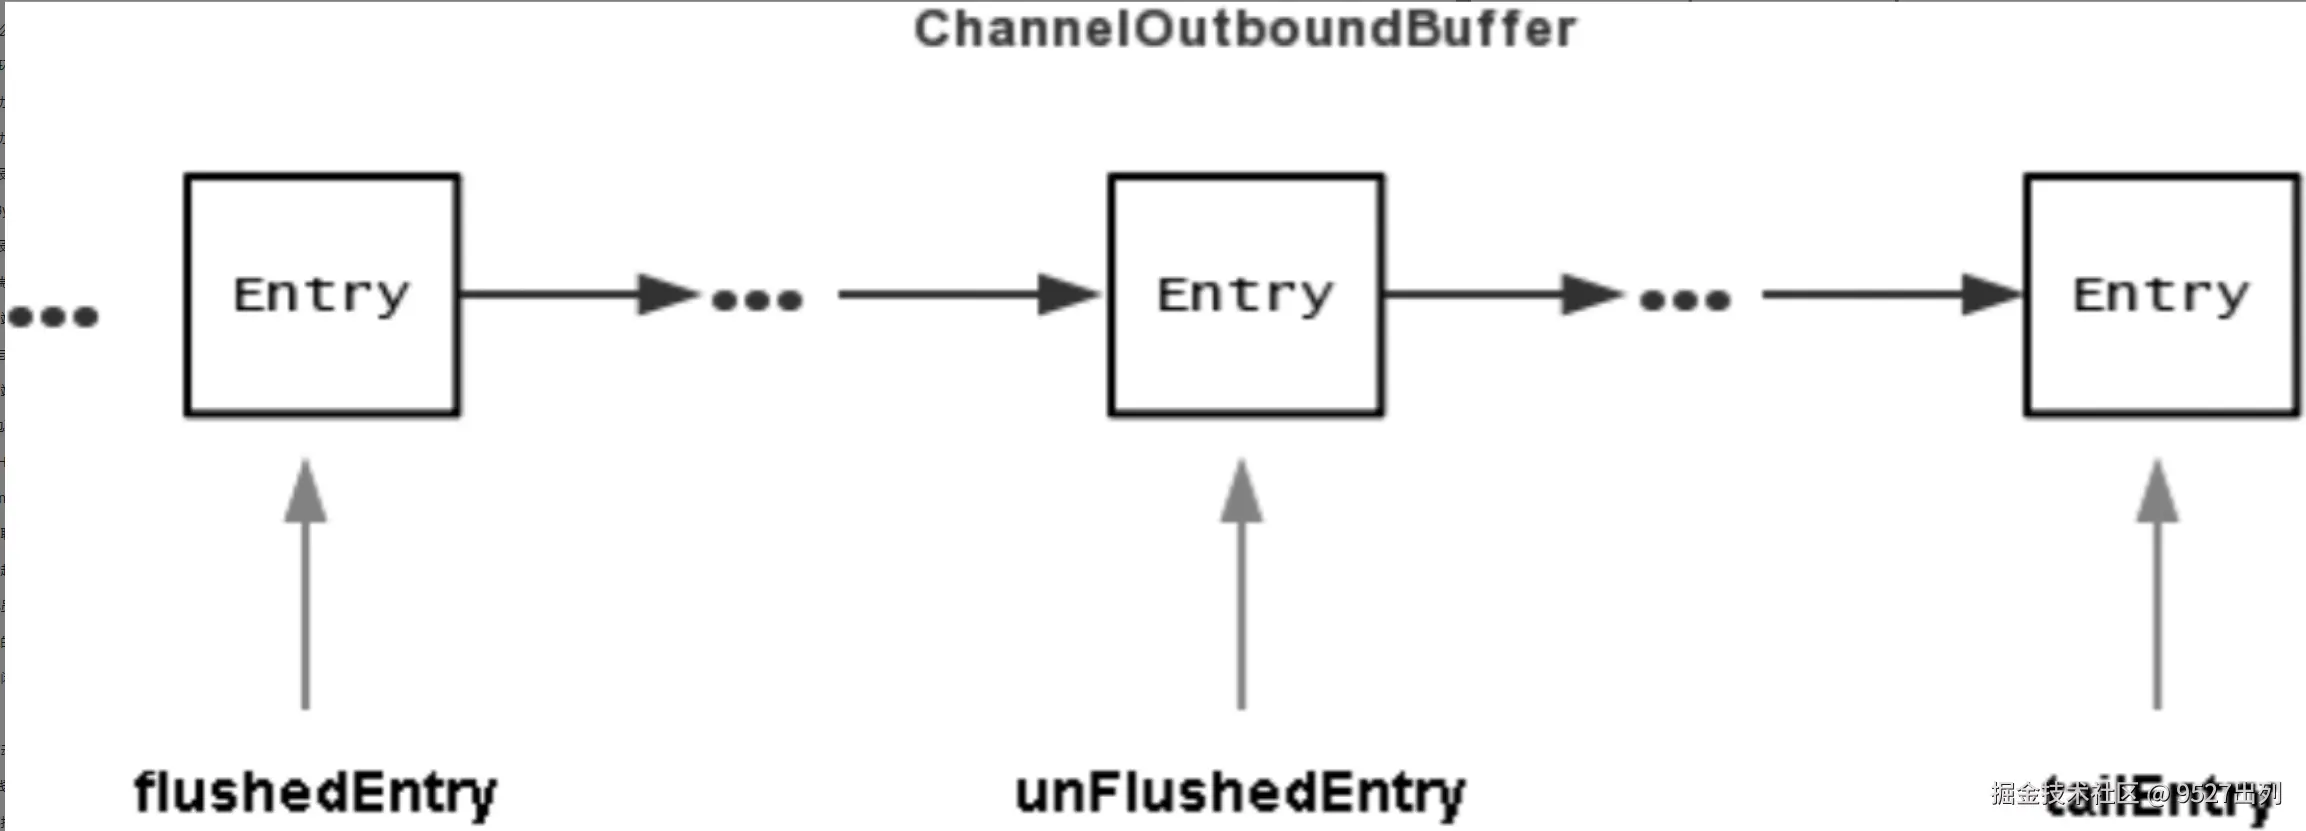 每次
addMessage() 调用,都会在 unflushedEntry 和 tailEntry 之间插入新的待写节点。
flush方法
flush()方法其实和write()的执行流程比较相似。
ctx.flush()和ctx.channel().flush()最终都会调用到Head节点的flush方法
java
HeadContext

@Override
public void flush(ChannelHandlerContext ctx) throws Exception {
    unsafe.flush();
}unsafe.flush()方法由AbstractUnsafe实现
ini
HeadContext

@Override
public final void flush() {
    assertEventLoop();
    ChannelOutboundBuffer outboundBuffer = this.outboundBuffer;
    if (outboundBuffer == null) {
        return;
    }
    outboundBuffer.addFlush();
    flush0();
}其中outboundBuffer.addFlush()负责移动outboundBuffer中的三个指针,指针最终会变成下图所示
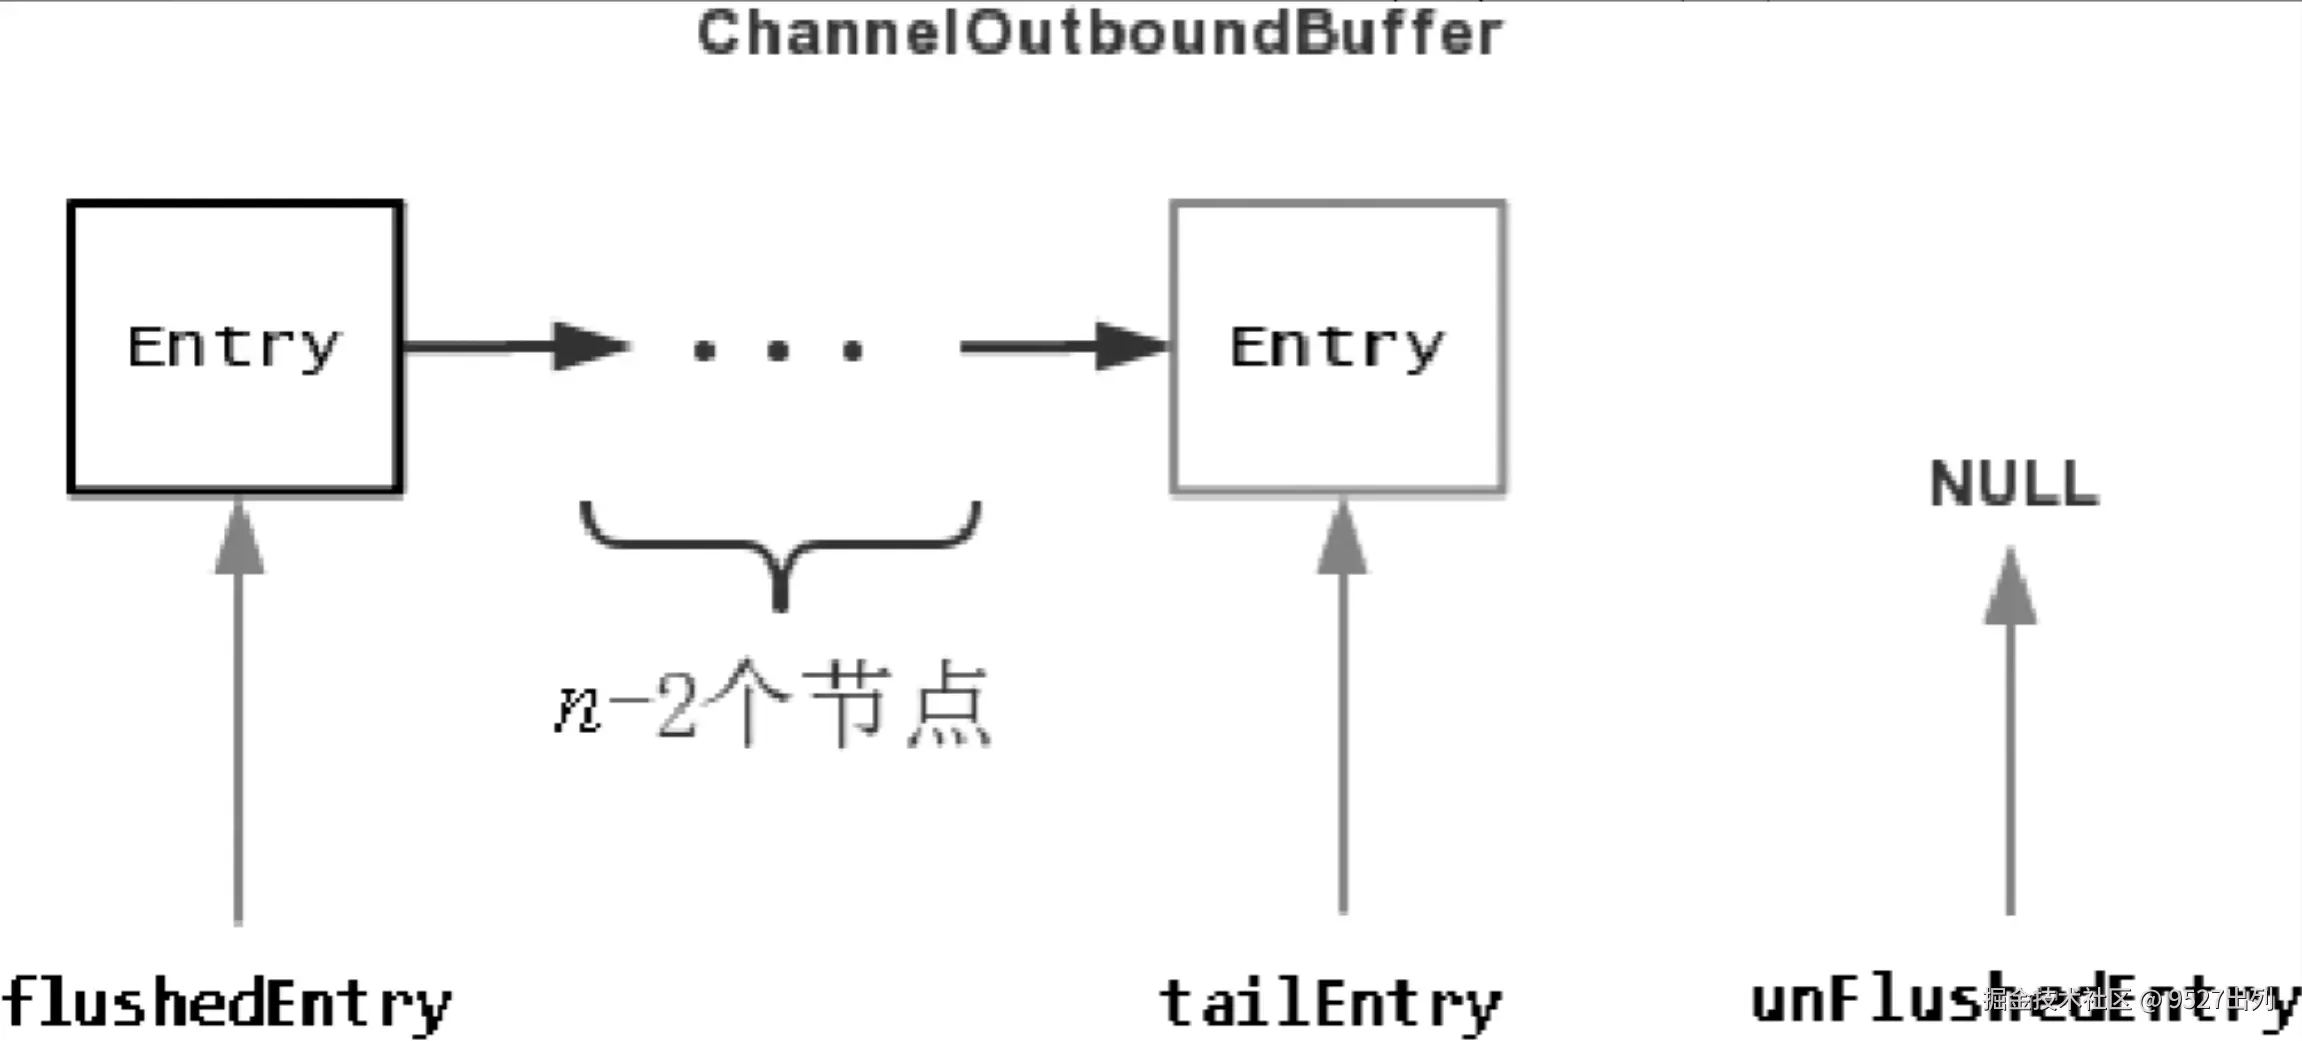
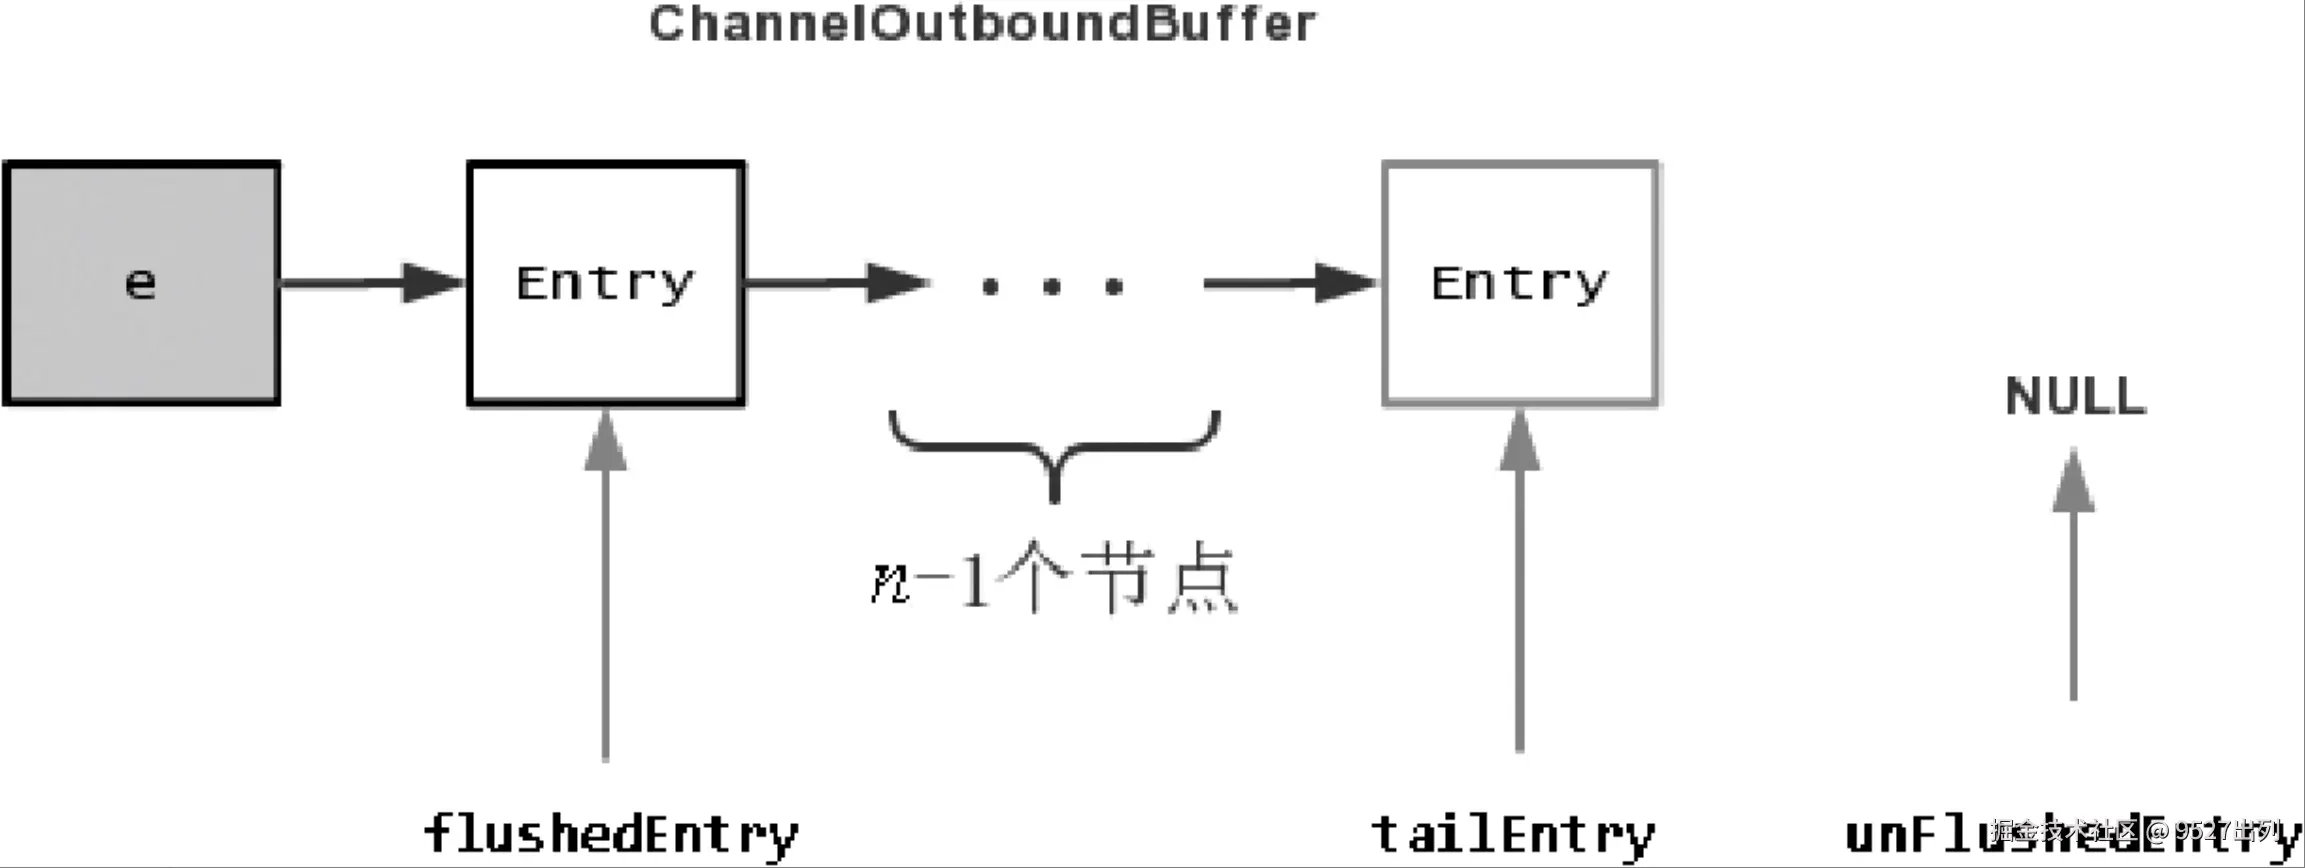
flush0()方法最终会调用AbstractNioByteChannel的doWrite()方法, doWrite()方法取出outboundBuffer 中单链表的节点,利用自旋锁 将节点写到协议栈的缓冲区。
之后移除当前接节点并将flushedEntry指向一下个节点。如图
writeAndFlush 方法
writeAndFlush() 本质上等价于:
scss
write(msg);
flush();
也就是说:
先将消息加入出站缓冲区,再立即触发刷入内核缓冲区的动作。
小结
至此,我们完整分析了 writeAndFlush() 的内部执行路径:
- write 阶段:对象 → ByteBuf → OutboundPipeline → ChannelOutboundBuffer
- flush 阶段:出站缓冲区 → 操作系统内核缓冲区
本系列从 Netty 的启动流程、Reactor 线程模型、客户端接入、数据解码,到本章的写出流程,系统地展示了 Netty 在网络通信中的核心机制。
Netty 作为一款高性能网络通信框架,内部蕴含了大量优秀设计:
- 对
SelectionKey的结构优化(由集合改为数组); - Selector 重建机制,规避 JDK 空轮询 Bug;
- 精细化内存管理与线程模型优化。