我常用的一个爬虫利器,自动采集视频数据

上周用到一个专门用来采集Youtube等视频网站数据的爬虫工具yt-dlp,是Github上比较火的开源应用,可以采集少量视频内容,但它是在有限的IP资源上运行的单点脚本,所以一旦规模化就很容易遇到HTTP 429 (Too Many Requests) 错误。
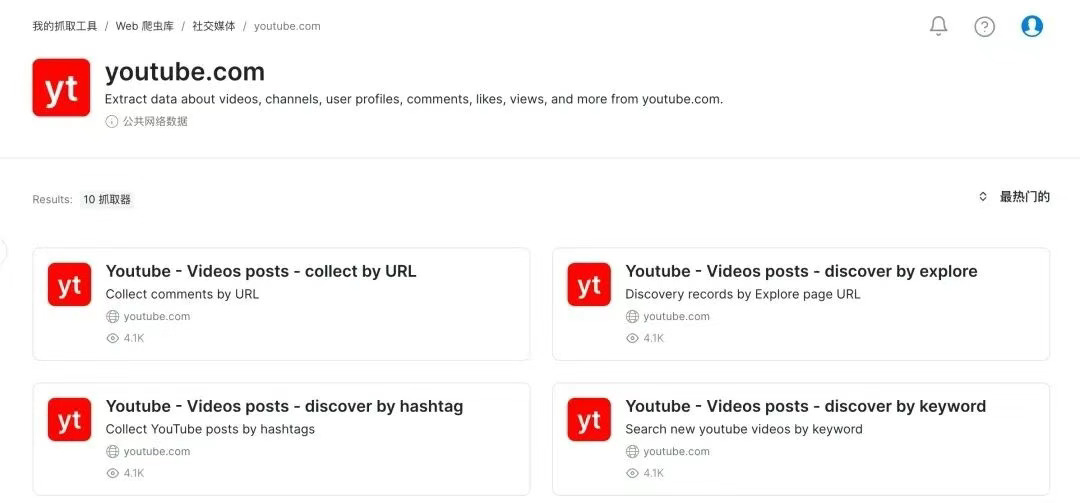
如果是搭建平台级采集应用,可以尝试亮数据网页抓取API,也能搭配yt-dlp一起用,它类似封装好的数据采集流水线,能自动处理各种反爬技术,它内置了专门用于Youtube等各大网站的网页抓取API,能直接通过requests访问并获取相应的视频、评论、互动等数据。

可以在下面链接使用亮数据的API功能,会赠送资源额度,个人研究够用了。
https://get.brightdata.com/webscra

相关推荐
xyzzklk2 天前
在Open-WebUI中提升向量化速度
网络·人工智能·爬虫·ai·语言模型·自然语言处理·安卓
严肃小白兔2 天前
Cloudflare 开始区分 AI 爬虫与个人 Agent:网站访问控制应该怎样设计?
人工智能·爬虫
傻啦嘿哟5 天前
高德地图POI爬虫:爬取商户与景点数据,做LBS应用
爬虫
weixin199701080165 天前
官方授权通道和灰色爬虫,做数据服务该选哪条路(附 python 源码)
c++·爬虫·python
正飞信息技术6 天前
llms.txt部署指南:给AI爬虫一张清晰的网站地图
人工智能·爬虫
NeoGressAI外贸数字化8 天前
外贸独立站robots.txt怎么写:6个AI爬虫放行规则
人工智能·爬虫
OnlineProxy8 天前
移动应用数据爬取:通过模拟器与流量嗅探对 API 进行逆向工程
爬虫·python·httpx
傻啦嘿哟8 天前
分布式爬虫架构:Redis+Scrapy打造企业级爬虫系统
分布式·爬虫·架构
梯度下降者8 天前
零基础入门Python 爬虫
爬虫·python·数据分析·入门指南·webcrawler
2601_967979129 天前
0 到 1 学爬虫:用 Python 爬取网页数据指南一(附实战案例)
爬虫·python·实战案例·html解析·网页数据