论文题目:《Immersion in the GitHub Universe: Scaling Coding Agents to Mastery》
近日,中国人民大学高瓴人工智能学院与字节跳动技术团队合作完成相关研究,重磅发布 Scale-SWE 数据集。研究团队依托火山引擎强大的 Sandbox 基建,通过 Sandboxed multi-agent 系统,成功实现 SWE 任务的规模化拓展,构建起包含 100k 真实数据、目前规模最大的开源高质量 SWE 数据集------这一成果为 Code Agent 训练数据的规模扩展提供了可行路径,让模型在 GitHub 量级的真实场景数据上进行充分训练成为现实。
与此同时,基于该数据集蒸馏数据所训练的 Qwen3-30A3B-Instruct 模型,在 SWE-bench-Verified 评测中取得了 64% 的优异成绩,实现学术界同等规模模型对工业界标杆模型(GLM-4.7-Flash)的赶超,充分彰显了高质量数据与强大技术基建深度结合的核心价值。
此次 Scale-SWE 数据集的高效构建,关键得益于火山引擎 Sandbox 基建的有力支撑。 正是这一行业领先的技术底座,让 SWE 数据的规模化拓展变得迅速、可控且具备高可行性。在数据集构建过程中,研究团队仅启用 5000 并发的 Sandbox 资源,便实现了数据构建流水线的稳定运行、安全防护与高效迭代,轻松支撑起 100k 量级数据的快速落地。
而这一并发规模,仅为火山引擎 Sandbox 基建能力的"冰山一角"------其实际可支持 10 万量级的 Sandbox 并发调度,依托这一强大的技术储备,为 Code Agent 的全流程研发提供了全方位保障。从数据构建、RL 训练,到模型蒸馏、自动化评测,火山引擎 Sandbox 基建以高并发、高安全、高稳定的核心优势,将研发流程化繁为简,为低效环节显著提速,让每一步工作都更便捷、更安全,成为 Code Agent 训练与迭代的首选基建支撑。
以下是关于本次研究成果的一些关键解读:
1. 真实 SWE 数据的重要性
此前,已有一些研究如 SWE-smith、SWE-Mirror 尝试利用自动化的流程合成数据,实现 SWE 数据的 Scaling。这类方法仅利用少量仓库就可以构造出数万条 SWE 数据,比如 SWE-smith 用了 128 个仓库就生成了 50k 条数据,其优势在于能够相对简单、快速地实现数据规模的 Scaling。
然而以往也有工作(如 BugPilot)指出,观察得到合成数据的数据集数据分布极其不均衡,与该团队的分类结果一致,如下图所示:
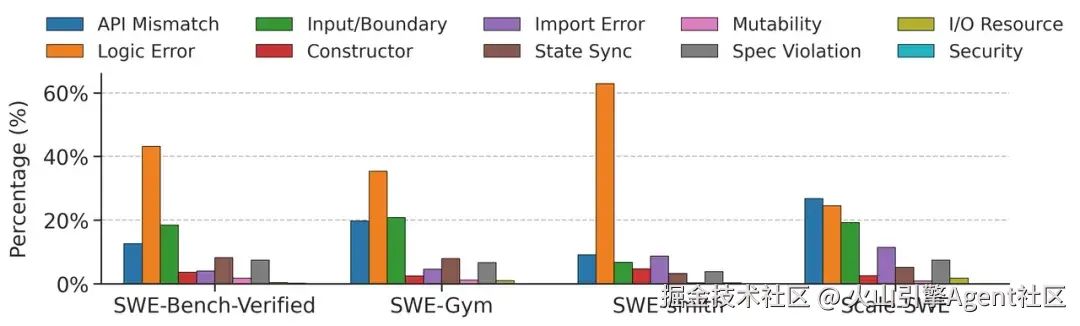
可以看到,相对于真实数据,SWE-smith 的绝大部分数据类型集中在 logic error 上。而真实数据集,比如 Scale-SWE、SWE-Gym 则表现出相对均衡的类别分布,更接近真实场景下的数据类别分布。
2. 为什么以往的 SWE 真实数据没有实现 Scaling
(1) 基础设施需要支持高并发 Sandbox 调度
要构造 SWE 数据,无论是配置环境,还是 P2P、F2P 的验证都需要在 Sandbox 环境(沙盒环境)中完成,这意味着要进行高并发的镜像拉取、容器创建与销毁等操作。如果使用本地物理机进行检验,由于部分仓库的 pytest 需要大量 CPU 资源,会导致资源抢占问题。因此,需要依赖可支持大批量、高并发调度的 Sandbox 基础设施。
(2) 环境配置的复杂性
以往的数据往往集中在相对较少、环境配置相对简单的仓库。这样做的好处是大部分 pull request 的环境配置可以通过相对简单且通用的流程完成(如直接执行 pip install -e .)。然而,仅覆盖这类简单场景显然无法支撑大规模数据集的构建,因为 GitHub 上大部分仓库代码的环境配置不会这么简单。传统方法多依赖规则或单轮 LLM 对话来生成类似 requirements.txt 的文件,面对复杂环境配置时,这样的方法难以实时执行测试脚本以验证配置是否成功,并根据反馈动态调整。
(3) unit-test 的稀缺性
对于 SWE 任务,unit-test 是很关键的,包含 Fail-to-Pass(F2P)和 Pass-to-Pass(P2P)。然而,当前许多开发者已经缺乏在提交代码时同步编写 unit-test 的习惯,这为构建真实 SWE 数据带来了严峻挑战------研究团队观察到,大量质量较高、极具价值的 pull request 并未附带 unit-test。以往的 SWE 数据构建方法通常仅保留作者在 pull request 中新增的 unit-test,这会导致大量高质量样本被遗漏。
(4) Problem Statement 的严谨性
大量 pull request 实际上并未关联对应的 issue。为构建 SWE 任务中的 problem statement,以往的工作往往会把 pull request 对话的内容和其他 pull request 的 meta 信息给到 LLM 来生成 problem statement。然而,pull request 本身是在作者解决问题后提交的代码与说明,若直接交由大模型让其生成 problem statement,极易导致信息泄露,例如泄露 bug 产生的位置或具体解决方案。
3. Scale-SWE 方法
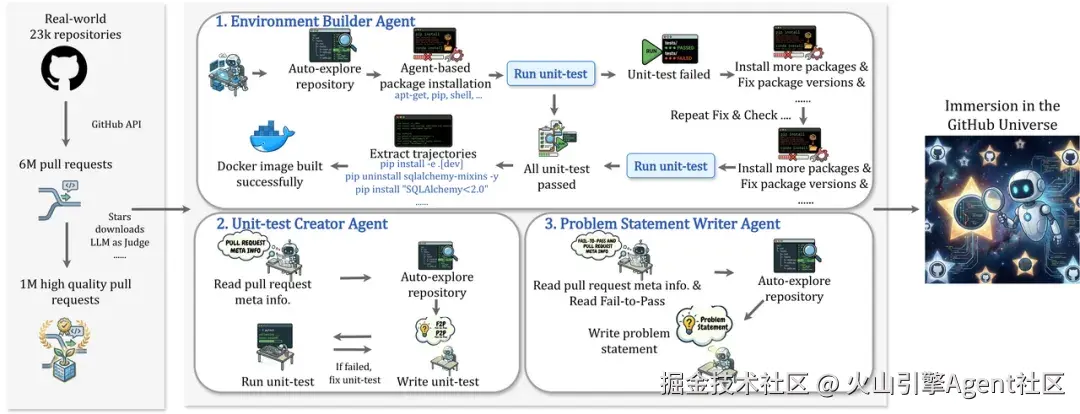
为解决上述问题,研究团队提出了一套在 Sandbox 环境中运行的多 Agent 工作流,主要包含三个核心模块:EBA(Environment Builder Agent)、UCA(Unit-test Creator Agent)和 PSWA(Problem Statement Writer Agent)。
- EBA(Environment Builder Agent): EBA 负责在 Sandbox 中自主探索仓库结构,定位并配置环境文件,如 README.md, setup.py, pyproject.toml 等并完成环境配置。在执行 pytest 等脚本验证环境后,可根据报错信息动态调整配置。该阶段对资源消耗较大,依赖高并发调度实现高效执行。
- UCA(Unit-test Creator Agent): 针对缺乏自带 unit-test 的高质量 pull request,UCA 可依据代码差异与仓库完整代码自动生成 F2P/P2P 测试样例,并通过与环境交互进行调整,最终通过切换 commit 执行测试进行验证,确保测试用例符合定义。高并发物理机调度是本阶段快速验证的基础,因为数据量的规模高达 100k。
- PSWA(Problem Statement Writer Agent): PSWA 负责生成高质量的问题描述,要求既不泄露缺陷位置或解决方案,又能完整准确地反映问题语义。为防止信息泄露,团队选用指令遵循能力更强的 Gemini 3-Pro 作为驱动模型。消融实验显示,问题描述质量对模型 SFT 效果影响显著,在 SWE-bench-Verified 上差异可达近 10%。
上述三个 Agent 模块的高效协同,高度依赖稳定、高并发的 Sanbox 基础设施作为底座。依托火山引擎 Sandbox 基建,研究团队得以调度数千个 Sandbox 并发执行 SWE 数据构建任务,原本单台物理机需运行约 1 个月 的工作量,现仅需 1 小时即可完成,且调度过程稳定可靠,有效避免了资源抢占问题。同时,镜像拉取内置 cache 机制,大幅降低延迟。正是这一高并发调度能力,为 100k 量级 SWE 数据的快速构建提供了坚实支撑,使多 Agent 工作流的规模化落地成为可能。
4. 结果
为了验证 Scale-SWE 数据的效果,研究团队使用 DeepSeek v3.2 进行蒸馏。得到 71k 条成功轨迹,并基于 Qwen3-30B-A3B-Instruct 进行 SFT。结果如下:
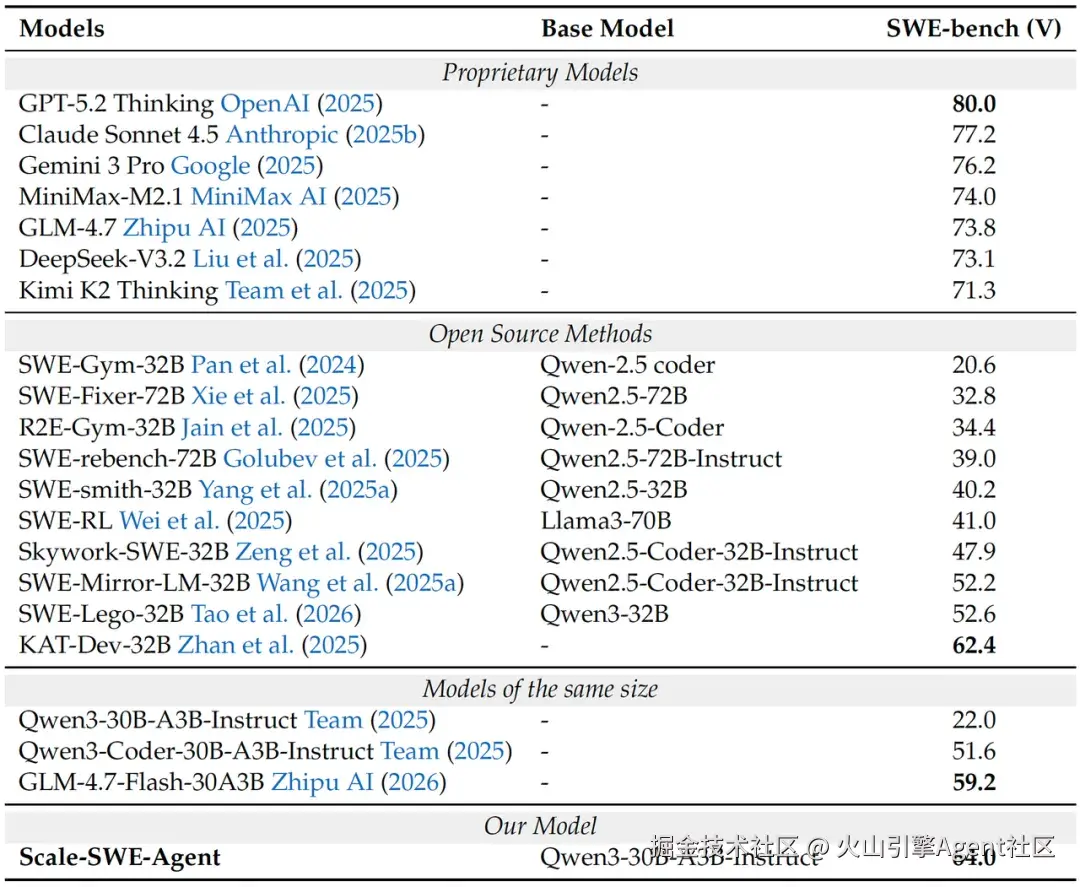
实验表明,对于同等规模模型,Scale-SWE-Agent 相较于 Qwen3-Coder-30A3B 和 GLM-4.7-Flash-30A3B 均有显著提升。即便是更大规模的模型(如 KAT-Dev-32B)以及基于其他数据集训练的模型(如 SWE-Lego-32B),Scale-SWE 仍展现出稳定的性能优势,充分验证了该数据集的有效性。
此外,团队在相同蒸馏流程下,对比了不同数据集的效果,结果如下:
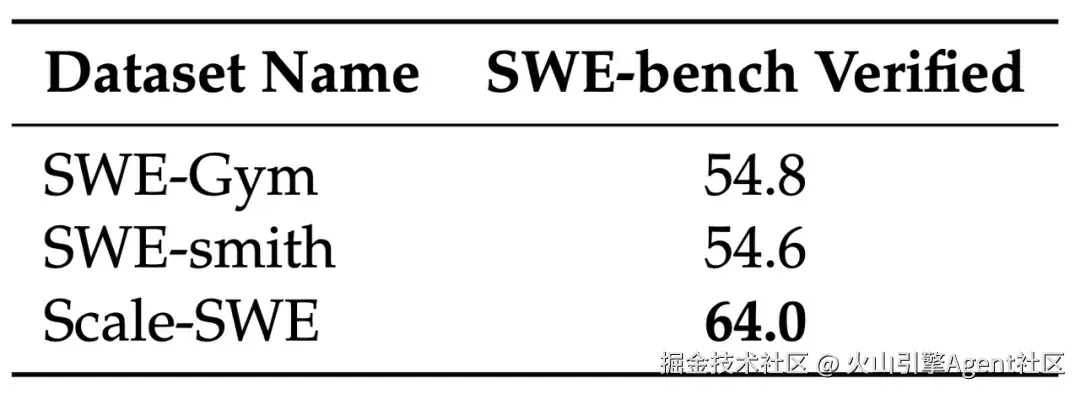
对比结果进一步印证了真实数据的重要性。尽管 SWE-smith 的数据量远超 SWE-Gym,但二者最终表现相近;而 Scale-SWE 在效果上显著超越 SWE-Gym,充分说明了数据规模扩展与真实数据质量相结合的关键价值。
5. 展望未来
更多细节与实验结果,请参见论文,Scale-SWE 能够降低在 SWE 领域研究者的入门门槛,提供大规模开源 SWE 数据以及直接可用的大量蒸馏数据,助力相关研究与应用的高效推进。
而此次 Scale-SWE 数据集的发布,既是双方合作研究成果的集中呈现,也充分体现了火山引擎 Sandbox 基础设施在高并发调度、系统稳定性与工程效率方面的硬核实力。未来,团队将持续深化与火山引擎的协作,依托高质量数据与强大基建,推动 Code Agent 技术实现更高效的突破与落地。