本地部署Ollama及部署模型

Ollama:是一款旨在简化大模型语言模型本地部署和运行过程的开源软件。

ollama提供一个轻量级、易扩展的框架,让开发者可以在本地机器构建和管理LLMs(大语言模型)

通过ollama,开发者可以导入和定制自己的模型,无需关注复杂的底层实现细节。

简单来说,就是在自己电脑部署和运行大模型,由自己电脑的硬件提供算力支撑模型运行。

1.1Ollama下载安装
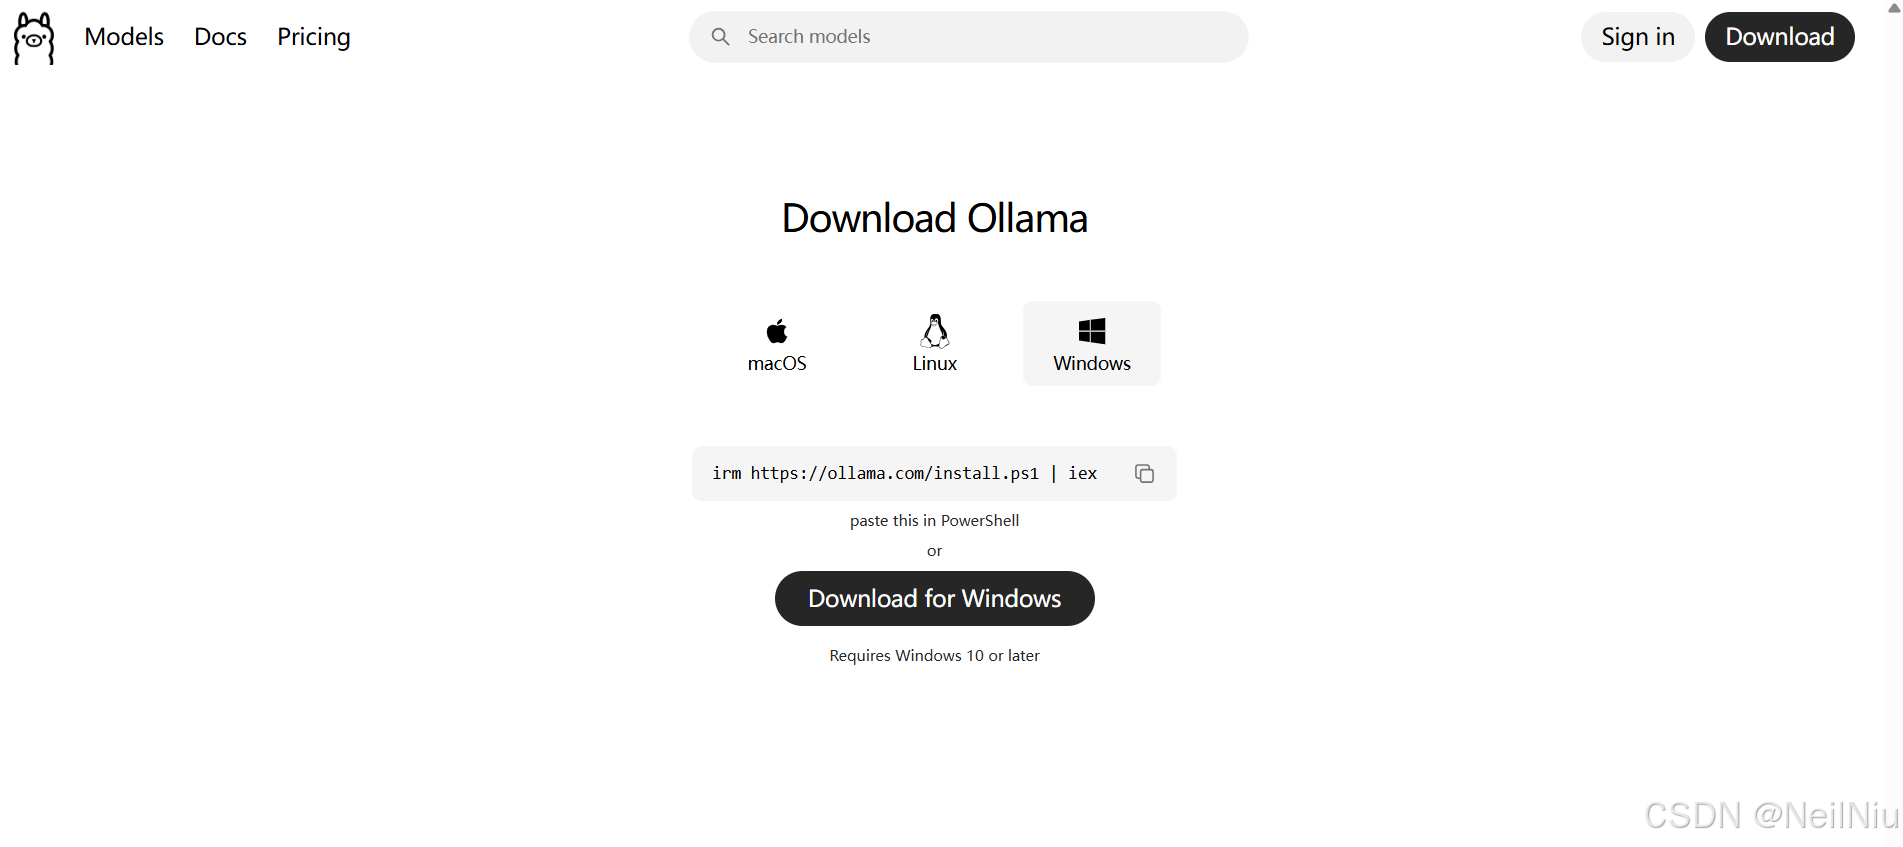
https://ollama.com/download

下载后默认安装路径是C盘,可以使用命令,修改安装路径

复制代码
OllamaSetup.exe /DIR="D:\tools\Ollama\Models"

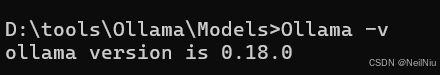
安装后,可以输入,查看安装的版本号

复制代码
Ollama -v

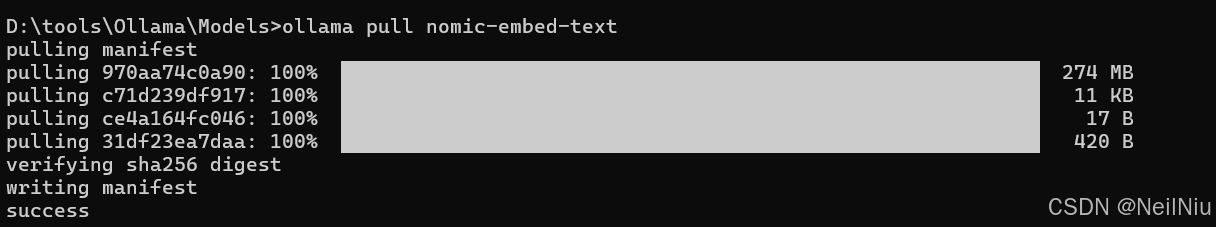
接下就可以拉取模型,可以拉取

复制代码
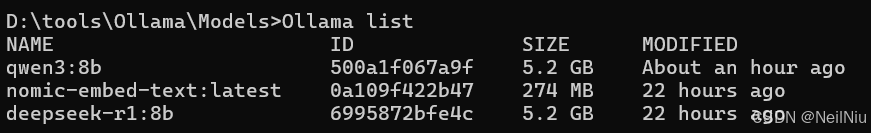
ollama pull deepseek-r1:8b
ollama pull qwen3:8b
ollama list
开源的文本嵌入模型工具

复制代码
ollama pull nomic-embed-text
复制代码
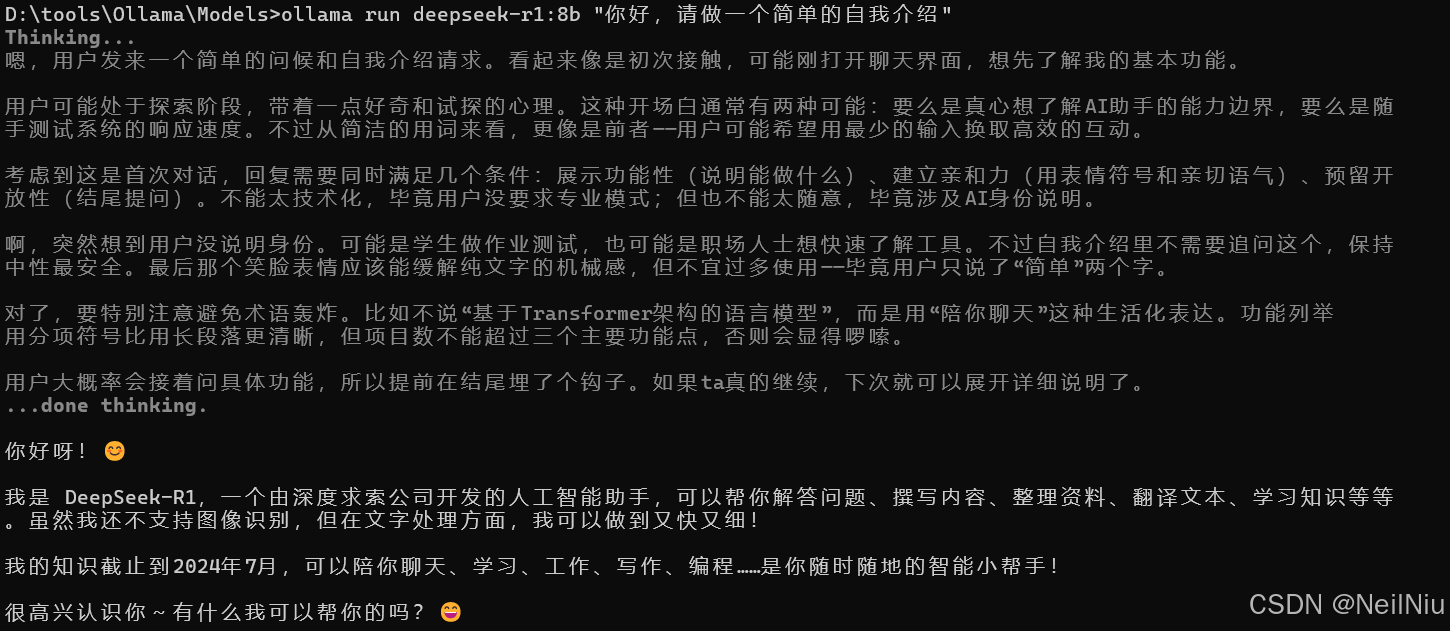
ollama run deepseek-r1:8b "你好,请做一个简单的自我介绍"
总结:

Ollama部署:在官网下载并安装客户端即可

蒸馏模型就是对标准大模型核心技能的学习,并进行瘦身,从而获得更低的性能要求。

简单来说蒸馏模型就是标准大模型的学生,学到了老师的核心本领,但是没有老师强。根据参数量的不同,参数量越大,蒸馏模型学到老师核心本领就越扎实,性能越好。

集显:1.5b左右

4G独显:8b以内

8G独显:14b以内

相关推荐
JAI科研1 天前
把一个 Qwen3.8的聊天模型改造成 JEV 决策模型
人工智能·语言模型·自然语言处理·chatgpt·transformer·vllm·sglang
谢白羽2 天前
从传统运维到 AI Infra: K8s 上调度 100 张 GPU踩坑笔记
运维·人工智能·缓存·kubernetes·vllm·sglang·vllm-omni
Hrain-AI3 天前
企业本地推理引擎选型实战:Ollama、vLLM 与 MLX 怎么挑
vllm
摸鱼仙人~3 天前
从 AI 应用开发到 GPU 计算软件:一份完整的 GPGPU、PyTorch、vLLM 与 AI Infra 学习路线
人工智能·pytorch·vllm
程序猿编码4 天前
不依赖 vLLM/llama.cpp:一套面向学习的 DeepSeek-R1 CUDA 推理实现
c++·学习·语言模型·llama·vllm·大模型推理
缘友一世4 天前
GLM5.3 CyberSec w4A16本地部署[10]:CUDA 图捕获与编译开关
ubuntu·vllm·glm5.3 cybersec
缘友一世4 天前
GLM5.3 CyberSec w4A16本地部署[15]:抗退化采样与思考档
ubuntu·vllm·glm5.3 cybersec
Soonyang Zhang6 天前
aisimulate分析(一)——算子workload建模
仿真·1024程序员节·vllm·推理框架·sglang
缘友一世6 天前
GLM5.3 CyberSec w4A16本地部署[9]:MTP 调参(num_speculative_tokens 的选择及其负载相关性)
ubuntu·vllm·glm5.3 cybersec
喜欢打篮球的普通人6 天前
AI 编译器的五大挑战与未来:从 TVM、XLA 到自动并行
vllm