在前面几期的"高质量数据集"系列文章中,我们探讨了高质量数据集的定义、应用场景与建设方法,并进一步明确了高质量数据集的核心定位------服务于人工智能模型应用的。
那么,高质量数据集是如何服务于人工智能应用呢?本文讲解四种主流落地范式,为正在规划建设高质量数据集的企业提供参考。
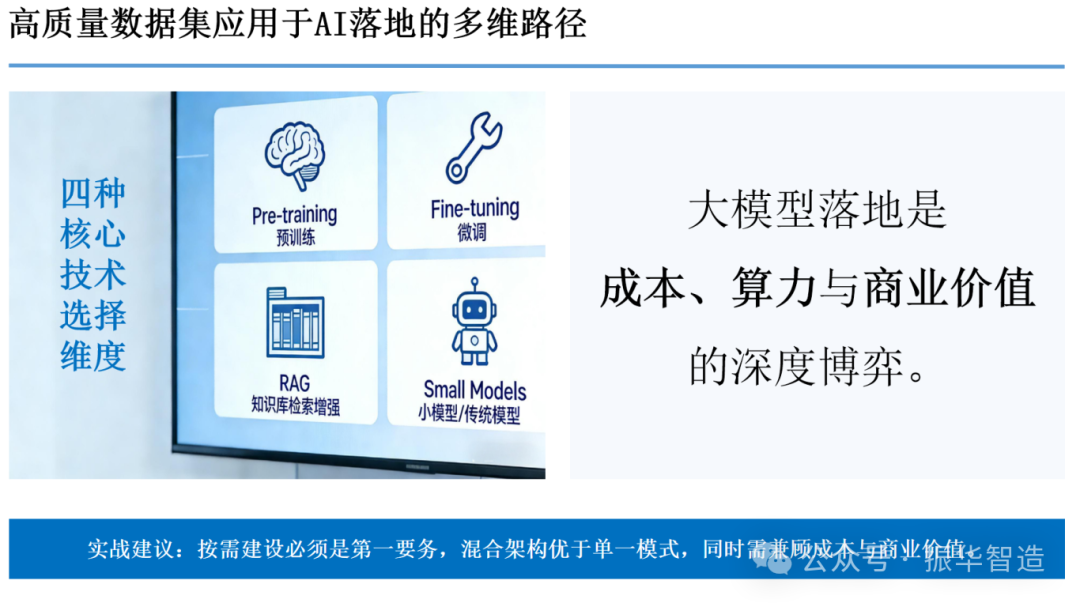
01、用于大模型持续预训练
将高质量领域语料(如全量医疗文献、法律判例、工业维修手册)投入通用模型,进行增量预训练。数据需经过去重、清洗和格式统一,保持分布一致性。
优势
▶️内化知识:将领域知识彻底"刻入"模型参数,推理时无需外部依赖,延迟最低。
▶️泛化性强:模型能理解该领域的深层逻辑和隐性知识,而不仅仅是记忆事实。能达到"举一反三"的效果。
▶️与大模型交互时,不受上下文限制。
劣势
▶️成本高昂:算力消耗巨大,训练周期长。【大实话,企业要做模型训练,需有充足的财力算力支持哦!】
▶️灾难性遗忘:若数据配比不当,可能导致模型丧失通用能力,表现反而更差。
▶️知识更新滞后:①知识更新需要重新训练,无法实时响应最新数据。②训练赶不上大模型的迭代更新。【现在通用大模型的更新迭代多快啊!】
▶️泛数据泄露风险:①独特、高熵的数据模型会强行记忆,问答输出原始数据。②大模型学到的知识会透漏商业秘密。
▶️数据删除难题:机器遗忘问题,经过某知识训练过的大模型,要删除(遗忘)某知识,要实现精准剔除而不影响模型整体性能仍然是当前未解决的难题之一。
适用场景
垂直领域大模型的基座模型构建。

对知识实时性要求不高、追求深度专业能力的场景。

有较充裕的预算做基座模型的训练。
02、用于大模型-监督微调
利用高质量的指令对,特别是包含思维链的专家示范数据,对模型进行微调。重点在于数据的"质量密度"而非数量。【要知道,10000条标注的数据优于1000000条原始数据】。
优势
▶️行为塑造:最直接地改变模型的输出风格、遵循复杂指令的能力和特定任务的表现。
▶️性价比高:相比预训练,所需数据量和算力较小,见效快。
▶️定制化强:可快速适配特定企业的业务流程和话术规范。【是现阶段业界落地多的大模型应用路径】
劣势
▶️知识边界受限:主要提升"怎么做"(能力),较难大幅扩展"知道什么"(新知识),容易产生幻觉。
▶️过拟合风险:若数据集多样性不足,模型在未见过的类似任务上表现可能骤降。
▶️数据更新、数据删除也是需要解决的问题。
适用场景
垂直场景的专属模型微调(如自动客服、工作助手);

数据集规模适中(数万到数十万条);

想要快速实践大模型技术,解决专职岗位的工作助手场景时,是一个可选路径。
03、用于大模型-知识库检索增强
高质量数据不进入模型参数,而是用于构建外部向量数据库或知识图谱。在大模型推理时,动态检索相关知识片段作为Prompt上下文输入给模型。
优势
▶️实时性与可追溯性:数据更新即生效,且能提供引用来源,消除幻觉,适合强事实依赖场景。
▶️数据安全相对可控:敏感数据无需训练进模型,通过权限可以实现控制灵活。
▶️低成本试错:更换数据集无需重新训练模型。【这是目前上手最快的方式!结合本体模型,效果翻倍!推荐!】
劣势
▶️上下文窗口限制:受限于模型最大词元(Token)数,难以处理超长逻辑链条或多文档综合推理。
▶️推理延迟:增加了检索和后处理步骤,响应速度慢于纯模型推理。
▶️存在割裂感:模型可能无法完美融合检索内容与自身知识,导致逻辑断层。
适用场景
高频更新的知识库问答场景;

高敏感数据的隐私保护场景;

通用大模型推理能力够用,结合监督微调,是现在较多的落地路径。
04、用于小模型-小模型训练
小模型不仅仅指参数量更小的"大模型",也包括传统机器学习的小模型。与追求通用能力的"大模型"不同,小模型专门处理边界封闭、清晰、高度专业化的任务,小模型的输出范围相对有限。小模型不追求"全能",而是追求在单一任务上达到极致的效果、速度和稳定性。
优势
▶️可解释性好:对于分类、抽取类任务,输出结构清晰,便于审计和调试。
▶️确定性更强:在封闭的任务定义下,经过充分训练的小模型往往比"什么都懂但偶尔胡说"的大模型更稳定、更可控。
▶️端侧安全与离线可用:小模型可完全部署在用户终端,比如手机、车机、工厂传感器等,数据不出域,无需联网,能较好的解决数据安全问题。
▶️算力资源友好:不依赖昂贵的GPU集群,普通CPU或NPU即可运行。
▶️极致性能与成本:在特定任务场景中,推理速度显著优于大模型,成本显著降低,适合高并发场景。
劣势
▶️泛化能力弱:一旦遇到训练数据分布之外的新任务或新指令,表现会断崖式下跌,缺乏大模型的"举一反三"能力。
▶️维护碎片化:如果有100个特定任务,可能需要维护100个不同的小模型,存在版本管理和迭代成本。
▶️也需要足够的高质量标注数据,零样本/少样本能力远弱于大模型。
适用场景
边界封闭、边界清晰、高度专业化的任务的;

通常场景明确的专项工作事项,可以尝试通过小模型解决;

大模型驱动的智能体应用中,作为协同组件。
05、落地最佳实践
构建"中央大脑(基座大模型)+敏捷执行单元(小模型)"的协同架构。
实际应用中,最佳的实践方案不是"二选一",而是构建一种分层协同的混合架构:以"大模型+RAG"为中央决策大脑和知识外挂,以"小模型"为边缘专用感官,通过高质量数据蒸馏实现能力互补。
▶️大模型+ RAG:充当"中央大脑"和"知识外挂"。利用其强大的通用推理能力、语言理解能力和通过RAG获取的实时外部知识,负责处理复杂逻辑、长尾问题、多步规划和非结构化信息的综合研判。【当然,如果算力和财力充沛,此处还可以叠加微调、叠加微调!】
▶️小模型:充当"敏捷执行单元"。利用高质量数据训练出的轻量级模型,部署在边缘端或作为微服务,负责高频、标准化、对延迟极其敏感的特定任务。
美林数据深耕智能制造领域,在智能化应用、数据治理、大模型落地等方面有行业积累,致力于为企业数字化转型提供全链路技术赋能与解决方案。