kafka如何合理分配消费者数量和分区数量

kafka 规则:在正常运行时,一个分区只能由同一个消费者组内的一个消费者"独占"消费 ------ 其他消费者不能同时参与,也不会"排队等待轮到自己"。

只有当当前消费者失效(宕机、网络断开、处理超时等) 时,Kafka 才会触发 Rebalance,将该分区重新分配给组内其他存活的消费者。

下图就是分配就是不和合理的,在同一个消费分组增加消费者是不能增加消息的消费速度的,反而浪费资源;
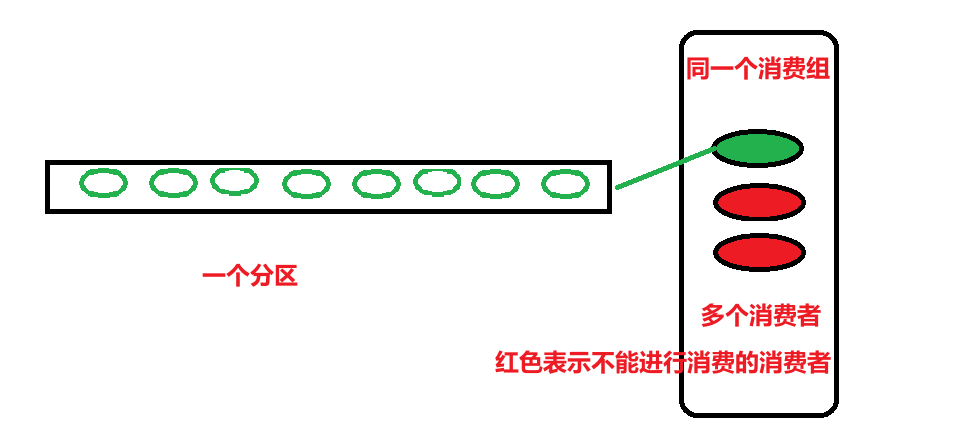
❌ 误区:"增加消费组(每个组里有一个消费者) = 提高单业务的消费速度"

场景 1:你只有一个业务逻辑(比如"处理订单")

目标:尽快清空积压消息

Topic:1 个分区

❌ 错误做法:创建 5 个消费组(group-1, group-2...),每个组 1 个消费者

→ 结果:5 个消费者重复处理同一批消息!

订单被处理 5 次(发 5 次货、扣 5 次款)

这是灾难性 Bug,不是提速!

✅ 唯一有效方案:

  1. 优化消费者代码(提升单线程处理速度)

  2. 增加 Topic 分区数(从 1 → N),再启动 N 个消费者(同组)

javascript 复制代码
# 将分区从 1 增加到 3
kafka-topics.sh --alter --topic your-topic --partitions 3 --bootstrap-server your-broker-ip:9092

最佳实践原则:
消费者数量 ≤ 分区数量
理想情况:消费者数量 = 分区数量(或略少)

相关推荐
starzy199015 小时前
KafkaProducer 加载元数据:一条 MetadataRequest 的完整旅程
大数据·kafka
RobinXYuan21 小时前
【Kafka 源码手记】04 客户端如何找到 Broker
kafka·源码阅读
Linux实战笔记1 天前
记一次消息队列选型对比线上排查:Kafka/RabbitMQ/Pulsar 技术选型
kafka·rabbitmq·高并发·pulsar·消息队列选型
Norris Huang1 天前
Kafka Connect 与 Flink CDC 写入 Iceberg:Upsert 的代价,以及 S3 Tables 的真正价值
分布式·flink·kafka
张彦峰ZYF1 天前
一条消息的丢与重:Kafka 与 RabbitMQ 可靠投递的确认、位点、死信与幂等全链路
后端·kafka·消息队列·rabbitmq·isr·解耦与削峰·丢失与重复
我不会起名字3223 天前
Kafka 分区数到底设几个:吞吐量、顺序性与 rebalance 代价的取舍
kafka·消息队列·调优·分区
starzy19903 天前
深度拆解 Kafka 源码:Producer 构造器装配了哪些核心组件
分布式·kafka
我不会起名字3223 天前
Go 写 Kafka 消费者:sarama 的 3 个坑与优雅退出写法
kafka·消息队列·go·sarama
RobinXYuan5 天前
【Kafka 源码手记】02 Kafka 的核心哲学:Everything Is A Log
kafka·源码阅读
Sayai5 天前
Kafka 2.8→3.9.1 跨大版本升级实战:ZooKeeper 同步升级、数据目录迁移与回滚预案全流程
大数据·运维·分布式·zookeeper·kafka