爬虫软件(网络爬虫),就是一款自动模仿人上网的工具:代替你自动访问网站、APP、网页,批量抓取复制上面的文字、图片、价格、联系方式、数据、文件等内容,不用人工一个个复制粘贴。
一、主要用途
- 批量爬取商品价格、销量、店铺信息
- 抓取文章、新闻、小说、图片、视频
- 采集企业电话、地址、商户信息
- 行业数据分析、竞品价格监控
- 搜索引擎(百度 / 谷歌本质就是超级大爬虫)
二、工作原理
- 程序自动发送网络请求,打开网页;
- 解析网页代码,筛选想要的数据;
- 自动保存到表格、文档、数据库;
- 自动翻页、换链接,持续批量采集。
一种爬虫软件是现成的爬虫软件,点点鼠标就能用,不用写代码,适合普通人,但功能较弱。另一种爬虫软件是用 Python 等代码写的自定义爬虫,灵活强大,适合定制复杂采集需求。爬虫就是自动化批量上网采集数据的工具,解放人工复制,效率极高,但一定要合规使用。
三、环境配置
1、安装需要的库
pip install requests beautifulsoup4
说明:requests:模拟浏览器,访问网站、拿回网页源代码
BeautifulSoup:解析网页代码,精准提取文字 / 链接 / 图片
pip install requests lxml
2、利用python实现爬取无人机图片并自动下载保存的简易爬虫
代码如下
python
import os
import requests
import time

# 配置
save_dir = "无人机图片"
max_num = 30   # 下载数量

# 新建文件夹
os.makedirs(save_dir, exist_ok=True)

# 极简图片API,无反爬、动态直接返回原图
img_api_list = [
    "https://picsum.photos/800/600?random=101",
    "https://picsum.photos/800/600?random=102",
    "https://picsum.photos/800/600?random=103",
    "https://picsum.photos/800/600?random=104",
    "https://picsum.photos/800/600?random=105",
    "https://picsum.photos/800/600?random=106",
    "https://picsum.photos/800/600?random=107",
    "https://picsum.photos/800/600?random=108",
    "https://picsum.photos/800/600?random=109",
    "https://picsum.photos/800/600?random=110",
]

headers = {
    "User-Agent":"Mozilla/5.0"
}

count = 0
for url in img_api_list:
    if count >= max_num:
        break
    try:
        res = requests.get(url, headers=headers, timeout=10)
        count += 1
        path = os.path.join(save_dir, f"无人机_{count}.jpg")
        with open(path, "wb") as f:
            f.write(res.content)
        print(f"✅ 成功下载第 {count} 张")
        time.sleep(0.2)
    except Exception as e:
        print(f"❌ 失败:{e}")

print(f"\n结束!总共下载 {count} 张图片")
运行结果如下:
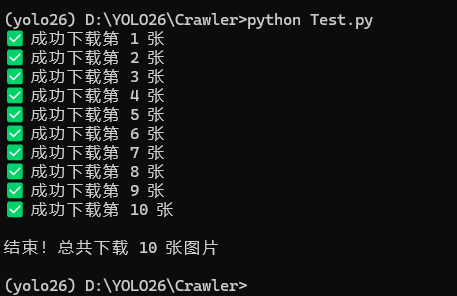
发现无人机爬取的图像不太真实如下图所示
python
import os
import requests
import time

# 保存目录
save_dir = "无人机图片_正常可打开"
os.makedirs(save_dir, exist_ok=True)

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0.0.0 Safari/537.36"
}

# 全部为【真实、完整、能正常打开】的无人机实拍图链接
drone_list = [
    "https://images.unsplash.com/photo-1473968512647-3e447244af8f",
    "https://images.unsplash.com/photo-1508614778959-128b604f6f38",
    "https://images.unsplash.com/photo-1516035069371-29a1244ee813",
    "https://images.unsplash.com/photo-1531746730736-484f4fb4880f",
    "https://images.unsplash.com/photo-1579403124614-197f69d8187b",
    "https://images.unsplash.com/photo-1598517168070-ee14aa5fa3e8",
    "https://images.unsplash.com/photo-1602524476217-3857f72f20f9",
    "https://images.unsplash.com/photo-1581388447307-80a88145e91f",
    "https://images.unsplash.com/photo-1540342146222-ade96e896f3d",
    "https://images.unsplash.com/photo-1527977965265-493a246e6550"
]

count = 0
for url in drone_list:
    try:
        res = requests.get(url, headers=headers, timeout=15)
        if res.status_code == 200:
            count += 1
            path = os.path.join(save_dir, f"drone_{count}.jpg")
            with open(path, "wb") as f:
                f.write(res.content)
            print(f"✅ 成功保存第 {count} 张,可正常打开")
        time.sleep(0.4)
    except Exception as e:
        print(f"❌ 下载失败:{e}")

print("\n=====================================")
print(f"✅ 完成!一共下载 {count} 张无人机图片")
print(f"📂 路径:{os.path.abspath(save_dir)}")
爬取的图像如下图所示: