一文读懂GROUP BY 1,2 VS GROUP BY column_1, column_2 的区别

为了更直观的查看这两者的区别,我把示例表格输入本地 MySQL 客户端里,并用 EXPLAIN 进行执行效率的分析。 以下是分别得到的 EXPLAIN 分析结果:
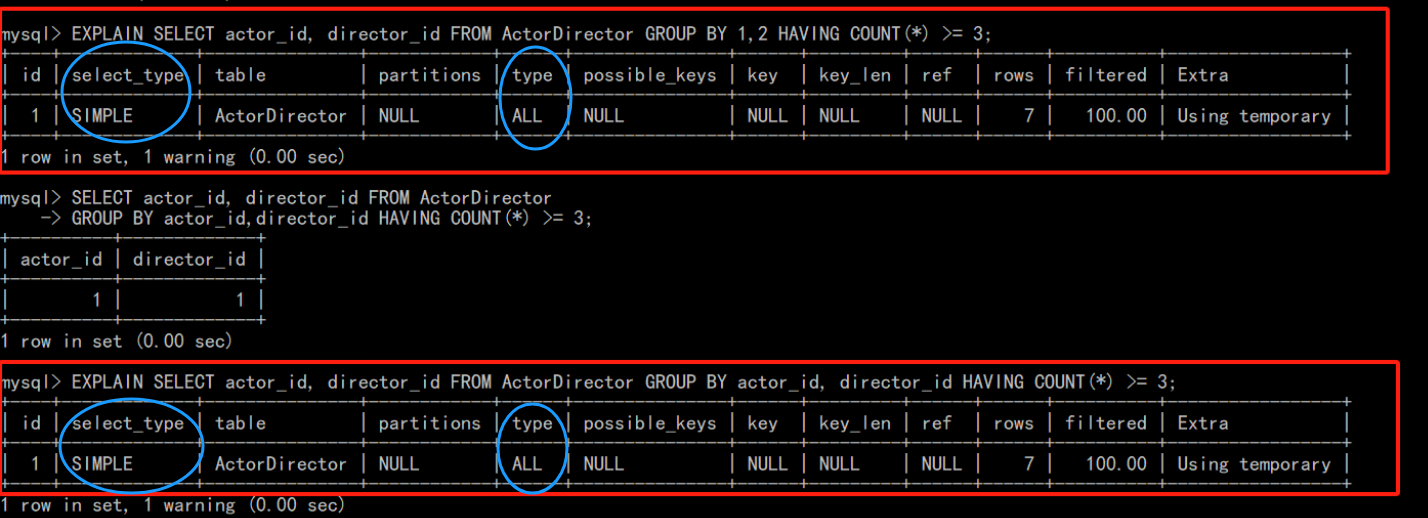
简单解释一下这个表格里面的一些重要字段含义:

● select_type:表示查询的类型,常见的类型有 SIMPLE、PRIMARY、SUBQUERY、DERIVED 等。SIMPLE 表示简单查询,PRIMARY 表示主查询,SUBQUERY 表示子查询,DERIVED 表示派生表的查询。

● type:表示连接类型,包括 system、const、eq_ref、ref、range、index、all 等。一般来说,连接类型从最好到最差的顺序是 system、const、eq_ref、ref、range、index、all。

● key:表示实际选择的索引。

● ref:表示连接使用的索引或常数。

● rows:表示估计要检查的行数。

其中最值得关注的是 type 字段,因为它描述了 MySQL 在执行查询时使用的连接算法,是能影响了查询性能的最直观表现。而 ALL表示全表扫描 ,没使用索引,对所有行进行扫描。回到此题,两种查询语句的返回字段值都是一样的,所以如果仅在示例表给出的数据上执行这两种查询,其实是 没区别的。

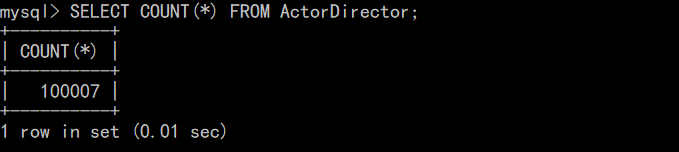
但是,小白为了更加严谨一点,因为此题仅 7 条数据,所以当表格数据量达到 10 万甚至更大的时候,这两种查询是否还是没区别?

为了验证我的想法,我先用存储过程写了一个自动生成类似数据的过程,且数据量达到了 10 万条左右。
相关推荐
薛定e的猫咪3 分钟前
(ICLR 2026)DF-META:面向 FJSP 的无导数元学习实例自适应调度
人工智能·深度学习·学习·算法·机器学习
小羊没烦恼!2 小时前
异步编程:线程概述及使用
java·开发语言·mysql·算法·c#
wanderist.2 小时前
202609CSP认证P3
算法
云淡风轻~窗明几净2 小时前
角谷猜想最接近严格证明的测试 Version1.1.1
人工智能·算法·机器学习·图论
机器学习之心3 小时前
PINN × SVM × NSGA-II × 熵权TOPSIS:一套跑通「建模—优化—决策」的多目标优化框架
算法·机器学习·支持向量机
别动我齐刘海3 小时前
机器人 C++ / 系统联调补强2——异常处理、Protobuf
linux·c++·人工智能·学习·算法·机器学习·机器人
荆棘鸟智能4 小时前
短历时洪水预报算法实践:水文模型与 LightGBM 残差订正融合
人工智能·算法·机器人
葫三生5 小时前
关于三生原理系列被技术开发社区批量收录或引发策展边界讨论的一种思考
大数据·人工智能·深度学习·算法·机器学习·数据挖掘·开源
catcatuncle5 小时前
OpenWorkBuddy 部署排错手册:从源码启动到自己搭一个给团队用,七个最容易卡住的地方
算法
avi91115 小时前
【AI教人】在Inspector显示所有Delegate-Odin Inspector之三
java·前端·算法·delegate·inspector·editor扩展·unity editor