1、本地cuda安装
版本:12.1
sudo sh cuda_12.1.1_530.30.02_linux.run
echo 'export CUDA_HOME=/usr/local/cuda-12.1' >> ~/.bashrc
echo 'export PATH=CUDAHOME/bin:CUDA_HOME/bin:CUDAHOME/bin:PATH' >> ~/.bashrc
echo 'export LD_LIBRARY_PATH=CUDAHOME/lib64:CUDA_HOME/lib64:CUDAHOME/lib64:LD_LIBRARY_PATH' >> ~/.bashrc
source ~/.bashrc
2、torch安装
pip install torch2.4.1 torchvision0.19.1 torchaudio2.4.1 --index-url https://download.pytorch.org/whl/cu121
3、依赖环境安装
训练环境:
pip install pyyaml5.4.1
pip install pyyaml
pip install opencv-python
pip install scipy pip install nuscenes-devkit
pip install mmcv==2.2.0 -f https://download.openmmlab.com/mmcv/dist/cu121/torch2.4/index.html
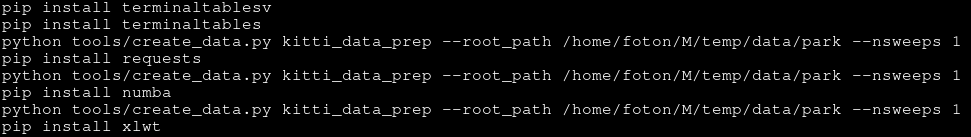
pkl生成环境:
pip install terminaltables
pip install requests
pip install numba
pip install xlwt
 4、代码修改
4.1 Traceback (most recent call last):
File "/home/foton/M/temp/Project/generate_pkl/tools/create_data.py", line 11, in
from det3d.datasets.kitti import kitti_common as kitti_ds
ModuleNotFoundError: No module named 'det3d'
修改本地路径
4.2 yaml
yaml.load(f),但 PyYAML ≥ 5.1 之后,出于安全考虑,yaml.load()必须显式指定 Loader参数,否则会报:
TypeError: load() missing 1 required positional argument: 'Loader'
self.task_cfg = yaml.load(f)
改为:
self.task_cfg = yaml.safe_load(f)
4.3
Python 3.10 中 collections.Iterable已被移除,而 det3d代码中还在使用旧的导入方式。
from collections import Iterable, defaultdict
修改后:
from collections.abc import Iterable
from collections import defaultdict
4.4
warnings.warn(warning.format(ret))
rank0: Traceback (most recent call last):
rank0: File "/home/foton/M/temp/Project/CPGNet/train.py", line 260, in
rank0: main(args, config)
rank0: File "/home/foton/M/temp/Project/CPGNet/train.py", line 209, in main
rank0: model = torch.nn.parallel.DistributedDataParallel(base_net.to(device),
rank0: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/nn/parallel/distributed.py", line 822, in init
rank0: _verify_param_shape_across_processes(self.process_group, parameters)
rank0: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/distributed/utils.py", line 286, in _verify_param_shape_across_processes
rank0: return dist._verify_params_across_processes(process_group, tensors, logger)
rank0: torch.distributed.DistBackendError: NCCL error in: .../torch/csrc/distributed/c10d/NCCLUtils.hpp:275, unhandled cuda error (run with NCCL_DEBUG=INFO for details), NCCL version 2.20.5
rank0: ncclUnhandledCudaError: Call to CUDA function failed.
rank0: Last error:
rank0: Cuda failure 802 'system not yet initialized'
rank3: Traceback (most recent call last):
rank3: File "/home/foton/M/temp/Project/CPGNet/train.py", line 260, in
rank3: main(args, config)
rank3: File "/home/foton/M/temp/Project/CPGNet/train.py", line 209, in main
rank3: model = torch.nn.parallel.DistributedDataParallel(base_net.to(device),
rank3: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/nn/parallel/distributed.py", line 822, in init
rank3: _verify_param_shape_across_processes(self.process_group, parameters) n many cases (e.g. in a constructor) irank3: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/distributed/utils.py", line 286, in _verify_param_shape_across_processes of tensor.type().backend() use tensorrank3: return dist._verify_params_across_processes(process_group, tensors, logger)
rank3: torch.distributed.DistBackendError: NCCL error in: .../torch/csrc/distributed/c10d/NCCLUtils.hpp:275, unhandled cuda error (run with NCCL_DEBUG=INFO for details), NCCL version 2.20.5
rank3: ncclUnhandledCudaError: Call to CUDA function failed.
rank3: Last error:
rank3: Cuda failure 802 'system not yet initialized'
rank2: Traceback (most recent call last):
rank2: File "/home/foton/M/temp/Project/CPGNet/train.py", line 260, in
rank2: main(args, config)
rank2: File "/home/foton/M/temp/Project/CPGNet/train.py", line 209, in main
rank2: model = torch.nn.parallel.DistributedDataParallel(base_net.to(device),
rank2: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/nn/parallel/distributed.py", line 822, in init
rank2: _verify_param_shape_across_processes(self.process_group, parameters)
rank2: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/distributed/utils.py", line 286, in _verify_param_shape_across_processes
rank2: return dist._verify_params_across_processes(process_group, tensors, logger)
rank2: torch.distributed.DistBackendError: NCCL error in: .../torch/csrc/distributed/c10d/NCCLUtils.hpp:275, unhandled cuda error (run with NCCL_DEBUG=INFO for details), NCCL version 2.20.5
rank2: ncclUnhandledCudaError: Call to CUDA function failed.
rank2: Last error:
rank2: Cuda failure 802 'system not yet initialized'
rank1: Traceback (most recent call last):
rank1: File "/home/foton/M/temp/Project/CPGNet/train.py", line 260, in
rank1: main(args, config)
rank1: File "/home/foton/M/temp/Project/CPGNet/train.py", line 209, in main
rank1: model = torch.nn.parallel.DistributedDataParallel(base_net.to(device),
rank1: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/nn/parallel/distributed.py", line 822, in init
rank1: _verify_param_shape_across_processes(self.process_group, parameters)
rank1: File "/home/foton/miniconda3/envs/cpg/lib/python3.10/site-packages/torch/distributed/utils.py", line 286, in _verify_param_shape_across_processes
rank1: return dist._verify_params_across_processes(process_group, tensors, logger)
rank1: torch.distributed.DistBackendError: NCCL error in: .../torch/csrc/distributed/c10d/NCCLUtils.hpp:275, unhandled cuda error (run with NCCL_DEBUG=INFO for details), NCCL version 2.20.5n many cases (e.g. in a constructor) irank1: ncclUnhandledCudaError: Call to CUDA function failed. of tensor.type().backend() use tensorrank1: Last error:
rank1: Cuda failure 802 'system not yet initialized'
rank0:W611 19:02:58.669442585 ProcessGroupNCCL.cpp:1168 Warning: WARNING: process group has NOT been destroyed before we destruct ProcessGroupNCCL. On normal program exit, the applicatio
用0、1卡没问题
5、nccl与gloo
nccl比gloo快1.5倍