前言
在 Java 生态系统中,java.lang.String 无疑是使用频率最高、面试考察最密集、同时也是设计哲学体现最为淋漓尽致的类。它看似只是一个简单的文本容器,但其背后融合了不可变设计、内存优化、JVM 运行时支持、字符编码规范以及并发安全等多重考量。
一、String 的底层存储结构与历史演进
理解 String 的一切特性,都必须从其底层存储结构出发。String 的内部表示并非一成不变,而是随着 JDK 版本的迭代经历了两次重大变革,每一次变革都深刻反映了 Java 对"内存效率"与"兼容性"之间权衡的思考。
1.1 JDK 8 及以前:基于 char\[\] 的 UTF-16 固定编码
在 JDK 8 及之前的版本中,String 的核心字段定义如下:
java
public final class String implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final char[] value;

    /** Cache the hash code for the string */
    private int hash; // Default to 0

    // ...
}
这种设计采用 UTF-16 编码,每个 char 占用固定的 2 个字节。其优点在于索引访问是 O(1) 的,逻辑简单;但缺点极其明显:对于主要由 ASCII/Latin-1 字符组成的字符串(这在英文为主的程序中占比极高),每个字符都浪费了 1 个字节的内存。在实际生产环境中,大量短字符串对象的存在导致堆内存被严重浪费,GC 压力随之增大。
1.2 JDK 9+:Compact Strings 紧凑字符串
为了解决上述内存浪费问题,JDK 9 引入了 Compact Strings 优化(JEP 254)。String 的内部存储发生了根本性变化:
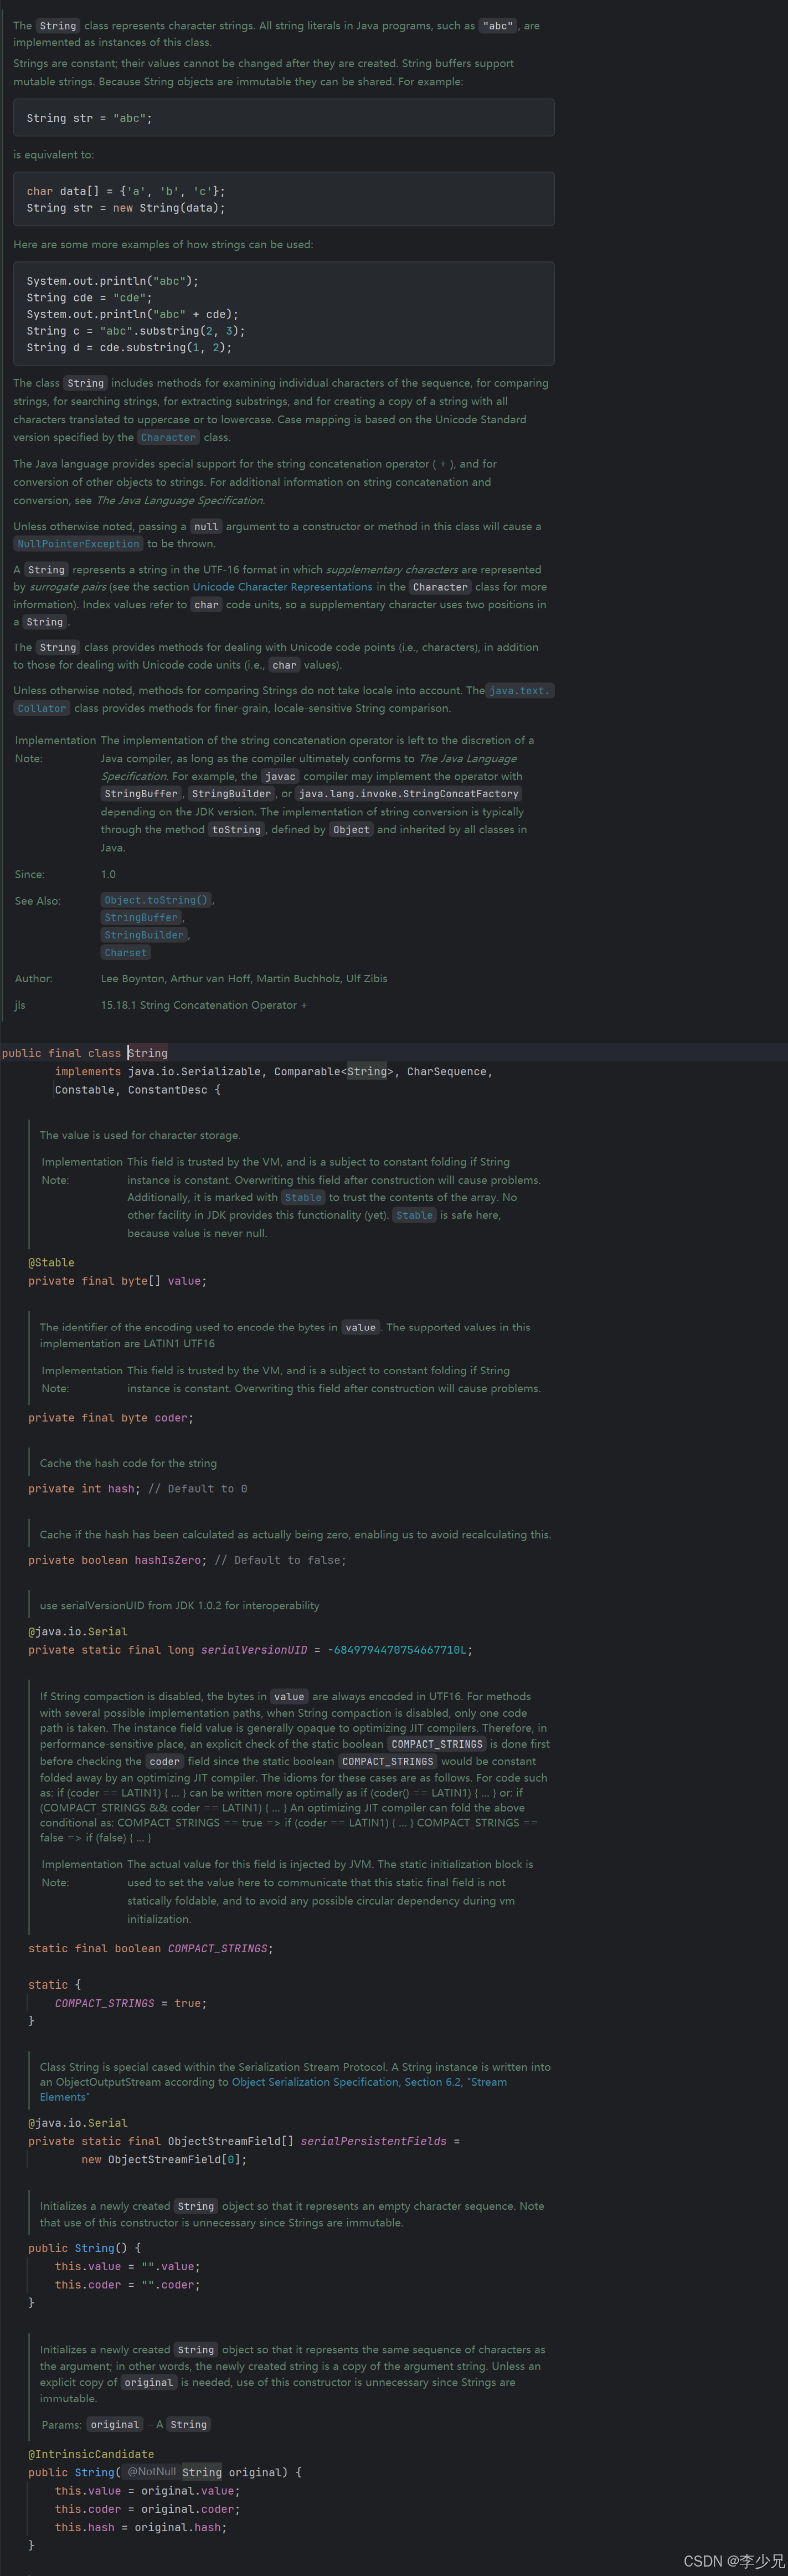
java
public final class String implements java.io.Serializable, Comparable<String>, CharSequence {
    @Stable
    private final byte[] value;

    /**
     * The identifier of the encoding used to encode the bytes in {@code value}.
     * The supported values in this implementation are:
     * LATIN1
     * UTF16
     */
    private final byte coder;

    static final byte LATIN1 = 0;
    static final byte UTF16 = 1;

    // ...
}| 对比维度 | JDK 8 及以前 | JDK 9+ (Compact Strings) |
|---|---|---|
| 底层存储 | char[] value |
byte[] value + byte coder |
| 编码方式 | UTF-16 (固定2字节/字符) | Latin-1 (1字节) 或 UTF-16 (2字节) 自适应 |
| 内存占用 | 较高,Latin-1字符也占2字节 | Latin-1字符串节省约50%,平均节省30%-40% |
| 索引访问 | 直接数组下标 | 需根据 coder 判断偏移量计算 |
| API 兼容性 | - | 完全透明,所有公开API行为不变 |
| JVM 支持 | 无特殊支持 | JIT编译器对String操作有专门内联优化 |
核心工作原理 :当创建一个 String 时,JVM 会检测内容是否全部落在 Latin-1(ISO-8859-1,即 0x00~0xFF)范围内。如果是,则使用 LATIN1 编码,每个字符仅占 1 字节;如果包含超出 Latin-1 范围的字符,则自动回退到 UTF16 编码。这个判断和转换过程对开发者完全透明,所有公开 API 的行为与旧版本保持一致。
⚠️ 重要澄清 :Compact Strings 不是压缩算法,它是一种编码自适应策略 。它不会改变 String 的任何语义行为,也不会影响序列化格式(序列化仍然使用标准的 UTF-8/Modified UTF-8)。该优化可通过
-XX:-CompactStrings关闭,但在绝大多数场景下应保持开启。
二、不可变性(Immutability):String 设计的基石
String 被声明为 final 类,其内部存储字段 value 和 coder 均为 private final,且没有任何修改内部状态的公开方法。这种彻底的不可变性绝非偶然,而是经过深思熟虑的设计决策。
2.1 为什么必须是不可变的?
安全性保障:String 被广泛用作安全敏感场景的参数,包括网络连接 URL、文件路径、数据库连接字符串、反射中的类名、安全管理器中的权限标识等。如果 String 是可变的,攻击者可以在通过安全检查后篡改字符串内容,导致严重的安全漏洞。不可变性从根本上杜绝了此类 TOCTOU(Time-of-Check to Time-of-Use)攻击。
线程安全的天然保证:不可变对象天然是线程安全的。多个线程可以同时读取同一个 String 实例而无需任何同步措施。这使得 String 可以安全地作为 HashMap 的 Key、ConcurrentHashMap 的键值、以及在多线程间自由传递而无需防御性拷贝。
HashCode 缓存与性能:由于内容不可变,hashCode 只需计算一次即可永久缓存。这是 String 作为 HashMap/HashSet 键时高性能的关键前提。如果 String 可变,每次 hashCode 调用都需要重新遍历计算,或者需要在每次修改时失效缓存,两者都会带来显著的性能退化。
java
// String.hashCode() 源码 ------ 懒计算 + 缓存
private int hash; // Default to 0

public int hashCode() {
    int h = hash;
    if (h == 0 && !value.isEmpty()) {
        h = isLatin1() ? StringLatin1.hashCode(value)
                       : StringUTF16.hashCode(value);
        hash = h; // 写入缓存,后续调用直接返回
    }
    return h;
}字符串常量池的前提条件:只有不可变对象才能被安全地共享。如果 String 可变,常量池中共享同一个引用的多个变量就会互相干扰,常量池机制将彻底崩溃。
类加载与安全框架的基础:Java 的类加载机制、安全沙箱、RMI 远程调用等都依赖 String 的不可变性来保证类型标识和权限描述的完整性。
2.2 final 修饰的多层含义
- 类级别 final:禁止继承。防止子类通过重写方法破坏不可变契约或引入不安全行为。
- 字段级别 final:配合私有访问控制,确保对象构造完成后内部状态永远不会被修改。
- JMM 安全发布保证:根据 Java 内存模型规范,final 字段的初始化在构造函数返回前对其他线程可见。这意味着当一个 String 引用被发布到其他线程时,该线程一定能看到完整、正确初始化的 String 内容,不存在部分构造的问题。
2.3 不可变性的代价与应对
不可变性意味着每次"修改"操作(如拼接、替换、截取)都会产生新的 String 对象。这在频繁修改的场景下会导致大量的临时对象分配和 GC 压力。Java 通过以下机制缓解这一问题:
- StringBuilder / StringBuffer:提供可变的字符序列构建器
- 编译器优化 :JDK 8 的
invokespecial+ StringBuilder 自动转换;JDK 9+ 的invokedynamic+ StringConcatFactory - 常量池折叠:编译期常量表达式直接在编译时求值
- JIT 内联优化:热点代码中的 String 操作被 JIT 编译器深度优化
三、字符串常量池(String Pool)与 intern 机制
3.1 常量池的本质与作用
字符串常量池是 JVM 维护的一个全局唯一的字符串表(Intern Table),其核心目标是去重:相同内容的字符串在池中只保留一份实例,所有引用都指向这同一个对象。这大幅减少了堆内存中重复字符串的数量。
java
String s1 = "hello";           // 字面量,编译期确定,直接从池中获取
String s2 = "hello";           // 复用池中同一对象
String s3 = new String("hello"); // 强制在堆上创建新对象
String s4 = s3.intern();       // 返回池中已有引用

System.out.println(s1 == s2);  // true  ✅ 同一池对象
System.out.println(s1 == s3);  // false ❌ 堆对象 vs 池对象
System.out.println(s1 == s4);  // true  ✅ intern返回池引用
System.out.println(s3 == s4);  // false ❌ 堆对象 ≠ 池对象
3.2 常量池的位置变迁
| JDK 版本 | 常量池位置 | 特点 |
|---|---|---|
| JDK 6 | 永久代 (PermGen) | 大小由 -XX:MaxPermSize 控制,不随堆扩展,易 OOM |
| JDK 7 | 堆内存 (Heap) | 受 -Xmx 控制,可被 GC 回收 |
| JDK 8+ | 堆内存 (Heap) | 元空间(Metaspace)仅存类元数据,字符串仍在堆中 |
这一变迁的意义重大:将字符串移出永久代后,字符串的生命周期完全由 GC 管理,不再存在因常量池满而导致 PermGen OOM 的风险。同时,G1 收集器可以对字符串进行专门的去重优化。
3.3 intern() 方法的正确使用
intern() 是一个 native 方法,其语义是:如果池中已存在内容相同的字符串,则返回池中引用;否则将当前字符串加入池中并返回其引用。
适用场景:
- 解析大量重复文本数据(日志、CSV、JSON 字段名)
- ETL 数据清洗中枚举值的去重
- 自定义协议中高频出现的标识符
禁忌场景:
- 不要对高基数(high-cardinality)字符串调用 intern,这会导致常量池无限膨胀
- 不要在热路径上无条件调用 intern,其本身有哈希查找开销
- 不要假设 intern 后的字符串永远不被 GC(JDK 7+ 中池对象可被回收)
JDK 8u20+ 的 G1 字符串去重 :G1 收集器提供了 -XX:+UseStringDeduplication 选项,可以在 GC 过程中自动检测堆中内容相同但引用不同的 String 对象,并将它们的底层 byte[]/char[] 指向同一数组。这是一种被动、自动、零代码侵入的去重机制,适合无法手动 intern 的场景。
四、字符串拼接的性能模型与编译器优化
字符串拼接是日常开发中最常见的操作,也是性能陷阱最集中的区域。不同 JDK 版本、不同拼接模式下的行为差异巨大。
4.1 编译期常量折叠
当拼接表达式中的所有操作数都是编译期常量时,编译器会在编译阶段直接完成拼接,运行时零开销:
java
// 源码
String s = "Hello" + " " + "World";

// 编译后等价于
String s = "Hello World"; // 常量池中只有一个对象
这适用于字面量、final 基本类型常量、以及由它们组成的表达式。但一旦涉及变量(非 final)、方法调用、运行时计算,就无法在编译期折叠。
4.2 JDK 8 的 StringBuilder 自动转换
JDK 8 编译器会将运行时的 + 拼接转换为 StringBuilder 操作:
java
// 源码
String result = a + b + c;

// JDK 8 编译产物(反编译)
String result = new StringBuilder()
    .append(a)
    .append(b)
    .append(c)
    .toString();
循环中的灾难 :如果在循环体内使用 + 拼接,每次迭代都会创建一个新的 StringBuilder 对象、执行 append、再 toString 生成新 String。时间复杂度退化为 O(n²),空间开销线性增长。
java
// ❌ 错误示范:O(n²) 时间 + O(n²) 空间
String result = "";
for (String item : list) {
    result += item; // 每次循环都 new StringBuilder + toString
}

// ✅ 正确做法:O(n) 时间 + O(n) 空间
StringBuilder sb = new StringBuilder(list.size() * 16); // 预估容量
for (String item : list) {
    sb.append(item);
}
String result = sb.toString();
4.3 JDK 9+ 的 invokedynamic 与 StringConcatFactory
JDK 9 彻底重构了字符串拼接的编译策略。编译器不再生成 StringBuilder 代码,而是生成 invokedynamic 指令,由 StringConcatFactory 在运行时动态选择最优拼接策略:
java
// JDK 9+ 编译产物(反编译)
String result = StringConcatFactory.makeConcatWithConstants(
    lookup, "makeConcatWithConstants",
    MethodType.methodType(String.class, String.class, String.class, String.class),
    "\u0001\u0001\u0001",  // 模板:三个参数占位符
    ""                     // 常量数组
).invokeExact(a, b, c);
运行时策略选择 :StringConcatFactory 会根据参数数量、类型、总长度等因素,从多种策略中选择最优解:
- BC_SB:使用 StringBuilder(传统方式)
- BC_SB_SIZED:预计算大小的 StringBuilder
- BC_SB_SIZED_EXACT:精确预计算大小
- MH_SB_SIZED:MethodHandle + StringBuilder
- MH_INLINE_SIZED_EXACT :直接操作 byte\[\],零中间对象分配(最快)
对于大多数简单拼接(参数少、总长度可控),JDK 9+ 会选择 MH_INLINE_SIZED_EXACT 策略,直接在目标 byte\[\] 上填充数据,避免了 StringBuilder 对象的分配和 toString 时的数组拷贝。这意味着在 JDK 9+ 中,简单的非循环 + 拼接性能已经接近甚至超过手动 StringBuilder。
💡 工程建议更新 :JDK 9+ 中,非循环的简单拼接可以直接使用
+,可读性更好且性能无损。但循环内拼接仍然必须使用 StringBuilder,因为 invokedynamic 优化不适用于累积式拼接。
五、关键方法的底层实现与历史教训
5.1 substring 的内存泄漏问题(已修复)
这是 Java 历史上最著名的 String 陷阱之一:
- JDK 6 及以前 :
substring()不复制底层数组,而是共享原char[],仅记录 offset 和 count。这导致一个从大字符串截取的短字符串仍然持有整个大数组的引用,造成严重的内存泄漏。 - JDK 7+ :
substring()改为始终拷贝新数组。彻底解决了内存泄漏问题,但代价是增加了数组复制开销。对于需要从大字符串中提取大量子串的场景,需要意识到这个成本。
5.2 equals 方法的优化策略
String.equals() 并非简单的逐字符比较,而是包含了多层快速失败优化:
java
public boolean equals(Object anObject) {
    // 1. 引用相等快速返回
    if (this == anObject) return true;

    // 2. 类型检查(instanceof 而非 getClass,允许子类参与比较)
    if (anObject instanceof String aString) {
        // 3. 编码不同时不可能相等(JDK 9+)
        if (coder() == aString.coder()) {
            // 4. 根据编码选择专用比较函数
            return isLatin1()
                ? StringLatin1.equals(value, aString.value)
                : StringUTF16.equals(value, aString.value);
        }
    }
    return false;
}
在 JDK 9+ 中,如果两个 String 的 coder 不同(一个是 LATIN1,一个是 UTF16),可以直接返回 false,无需逐字符比较。这是一个非常有效的快速失败优化。
5.3 compareTo 与字典序
String 实现了 Comparable 接口,其 compareTo 方法按 Unicode 码点逐字符比较。需要注意的是:
- 比较基于 char/codePoint 的数值,不是语言学的排序规则
- 如果需要语言敏感的排序(如中文拼音排序、德语变音字母处理),应使用
Collator - TreeSet/TreeMap 中使用 String 作为键时,排序依据就是 compareTo
六、字符编码:char、CodePoint 与 Unicode 的正确理解
这是许多开发者忽视但极易出错的领域。
6.1 char 不等于"一个字符"
Java 的 char 是 UTF-16 编码单元(code unit),固定 16 位。而 Unicode 码点(code point)的范围是 U+0000 ~ U+10FFFF,超出了 16 位的表示能力。超出 BMP(Basic Multilingual Plane,U+0000~U+FFFF)的字符(如 Emoji、古文字、音乐符号等)需要用两个 char(代理对,Surrogate Pair) 来表示。
java
String emoji = "😀"; // U+1F600
System.out.println(emoji.length());          // 2!不是1
System.out.println(emoji.charAt(0));         // 高代理 \uD83D
System.out.println(emoji.charAt(1));         // 低代理 \uDE00
System.out.println(emoji.codePointAt(0));    // 128512 (0x1F600)
System.out.println(emoji.codePointCount(0, emoji.length())); // 1 ✅
6.2 正确处理 Unicode 文本
| 操作 | 错误方式 | 正确方式 |
|---|---|---|
| 获取字符数 | str.length() |
str.codePointCount(0, str.length()) |
| 遍历字符 | for(i=0;i<str.length();i++) str.charAt(i) |
str.codePoints().forEach(...) |
| 截取子串 | str.substring(0, n) |
按 codePoint 边界截取,避免截断代理对 |
| 反转字符串 | new StringBuilder(str).reverse() |
✅ reverse() 已正确处理代理对 |
| 正则匹配 | . 匹配单个char |
使用 (?s). 或 \X 匹配完整码点 |
⚠️ 严重警告 :在处理用户输入(尤其是包含 Emoji 的消息、昵称、评论)时,使用
length()做长度限制、使用charAt()遍历、使用substring()截取,都可能导致代理对被截断,产生乱码或数据损坏。务必使用 CodePoint 感知的 API。
七、String 相关类的定位与选型
| 类 | 可变性 | 线程安全 | 性能 | 适用场景 |
|---|---|---|---|---|
String |
不可变 | 安全 | 读取极快,修改产生新对象 | 通用文本、Map Key、配置值 |
StringBuilder |
可变 | 不安全 | 单线程拼接最快 | 循环拼接、格式化输出、模板渲染 |
StringBuffer |
可变 | synchronized 安全 | 比 StringBuilder 慢 30%+ | 多线程共享可变文本(极少见) |
CharSequence |
接口 | - | - | 方法参数类型,接受 String/SB/CS 等 |
StringJoiner |
可变 | 不安全 | 封装分隔符逻辑 | 带分隔符的拼接(替代手动 append delimiter) |
Formatter |
可变 | 不安全 | printf 风格格式化 | 复杂格式化输出 |
MessageFormat |
可变 | 不安全 | ICU 风格 | 国际化消息模板 |
关于 StringBuffer 的现代观点:在现代 Java 开发中,StringBuffer 几乎已经没有使用价值。如果真的需要多线程安全的字符串构建,更好的做法是使用 ThreadLocal 或在业务层面做好同步控制,而不是依赖 StringBuffer 的粗粒度 synchronized。
八、安全考量:为什么密码不应该用 String
这是一个经常被提及但很少被真正理解的安全最佳实践。
问题根源:String 是不可变的,一旦创建就无法主动清除其内容。密码字符串会一直存在于堆内存中,直到被 GC 回收。而在 GC 回收之前,这段内存可能被:
- 堆转储(heap dump)捕获
- 内存扫描工具读取
- 交换到磁盘(swap)
- 被 core dump 记录
正确做法 :使用 char[] 或 byte[] 存储密码,使用后立即手动清零。
java
// ❌ 不安全
String password = getPasswordFromUser();
authenticate(password);
// password 在内存中残留,无法清除

// ✅ 安全
char[] password = getPasswordFromUserAsCharArray();
try {
    authenticate(password);
} finally {
    Arrays.fill(password, '\0'); // 立即清除敏感数据
}
注意:许多现代框架(如 Spring Security、Jakarta EE)的认证 API 已经迁移到 char[] 或专门的 Credential 类型。如果你的代码仍在使用 String 传递密码,应视为安全隐患并计划修复。
九、JVM 调优与 String 相关的关键参数
| 参数 | 作用 | 默认值/建议 |
|---|---|---|
-XX:+CompactStrings |
启用紧凑字符串(JDK 9+) | 默认开启,除非有特殊原因否则不要关闭 |
-XX:+UseStringDeduplication |
G1 GC 自动字符串去重 | JDK 8u20+ 可用,默认关闭,高重复率场景建议开启 |
-XX:StringDeduplicationAgeThreshold |
去重触发的对象年龄阈值 | 默认3,可根据实际情况调整 |
-Xmx / -Xms |
堆大小(直接影响常量池容量) | 根据实际字符串负载设置 |
-XX:+PrintStringTableStatistics |
打印字符串表统计信息 | 诊断常量池使用情况 |
-XX:StringTableSize |
字符串表桶数量(JDK 8) | 默认为质数,大量 intern 时可增大以减少冲突 |
十、最佳实践
- 永远不要用
==比较字符串内容,除非你明确知道两边都来自常量池或 intern。 - 循环内拼接必须使用 StringBuilder,并尽可能预估初始容量以避免扩容拷贝。
- JDK 9+ 的非循环简单拼接可直接使用
+,编译器会自动选择最优策略。 - 处理含 Emoji/多语言文本时,使用 CodePoint API,不要用 length()/charAt()。
- 敏感数据使用 char\[\] 并及时清零,避免使用 String 存储密码、密钥、Token。
- 谨慎使用 intern(),仅在高重复率、低基数场景下使用,避免常量池膨胀。
- 预编译正则表达式,Pattern.compile() 的结果应缓存复用,避免每次匹配都重新编译。
- JSON/XML 解析时注意 null 与空串的语义区别,不要盲目 trim() 或 isEmpty()。
- 国际化排序使用 Collator,不要依赖 String.compareTo() 的字典序。
- 日志拼接使用占位符 (
log.info("user={}", user)),避免无条件字符串拼接造成的性能浪费。 - 理解 substring 在 JDK 7+ 会拷贝数组,从超大字符串中提取大量子串时考虑自定义视图或使用 ByteBuffer。
- 单元测试中覆盖 Unicode 边界情况,包括空字符串、纯 ASCII、混合脚本、Emoji、零宽字符等。
附录:Java String 高频面试题
Q1:String 为什么被设计成不可变的?
A: 这是多重设计目标权衡的结果,核心原因有五点:
- 安全性:String 被用作类加载器中的类名、网络连接 URL、文件路径、安全权限标识等关键参数。如果可变,攻击者可在通过安全检查后篡改内容,引发 TOCTOU 漏洞。
- 线程安全:不可变对象天然线程安全,可被多线程自由共享而无需同步,这是其作为 HashMap Key 和并发容器键值的前提。
- HashCode 缓存:不可变性保证 hashCode 计算一次后即可永久缓存,使 String 作为 Map Key 时具备 O(1) 的查找性能。
- 字符串常量池基础:只有不可变对象才能被安全地放入常量池共享引用。若可变,多个变量指向同一池对象时会互相干扰,常量池机制将彻底失效。
- JMM 安全发布:final 字段保证构造函数返回前,其他线程一定能看到完整初始化的对象状态,不存在部分构造问题。
Q2:new String("abc") 到底创建了几个对象?
A: 最多 2 个,最少 1 个,取决于常量池中是否已存在 "abc":
- 若常量池中已有
"abc":仅在堆上创建 1 个新的 String 对象(其内部 byte\[\] 指向池中已有内容的拷贝或共享,取决于 JDK 版本),字面量"abc"直接复用池中实例。 - 若常量池中没有
"abc":先在常量池中创建 1 个"abc"实例,再在堆上创建 1 个新 String 对象,共 2 个。
⚠️ 常见错误说法是"总是创建 2 个"。实际上,在大多数运行时场景中,字面量
"abc"在类加载阶段就已进入常量池,new String("abc")通常只创建 1 个堆对象。
Q3:== 和 equals() 的区别是什么?
A:
==比较的是引用地址(即两个变量是否指向堆中同一个对象)。equals()比较的是内容相等性 。String 重写了 equals(),逐字符比较内容,并包含多层快速失败优化:先比引用(this == anObject)、再比 coder 编码类型、最后才逐字节比较。
⚠️ 永远不要用
==判断字符串内容相等,除非你明确知道两边都来自编译期常量折叠或 intern()。
Q4:String.intern() 的作用是什么?什么时候该用?
A: intern() 是一个 native 方法,语义为:若常量池中已存在内容相同的字符串,返回池中引用;否则将当前字符串加入池中并返回其引用。
适用场景:解析大量高重复率、低基数的文本数据(如日志字段、CSV 枚举值、JSON key),通过去重显著降低堆内存占用。
禁忌 :不要对高基数数据调用 intern(会导致常量池膨胀);不要在热路径无条件调用(有哈希查找开销);JDK 7+ 中池对象可被 GC,但频繁 intern 仍会增加 GC 扫描负担。生产环境中优先考虑 G1 的 -XX:+UseStringDeduplication 作为零侵入替代方案。
Q5:JDK 9 对 String 做了什么优化?有什么影响?
A: JDK 9 引入 Compact Strings(JEP 254),将底层存储从 char[] 改为 byte[] + coder。当字符串内容全部落在 Latin-1 范围时,使用单字节编码;否则回退 UTF-16。
影响 :Latin-1 字符串内存占用减少约 50%,整体平均节省 30%-40%;API 完全兼容,行为不变;JIT 编译器对 String 操作有专门内联优化。该优化默认开启,可通过 -XX:-CompactStrings 关闭,但绝大多数场景应保持开启。
Q6:循环中拼接字符串为什么不能用 +?JDK 9+ 还需要注意吗?
A: JDK 8 及以前,循环中的 + 每次迭代都会 new StringBuilder → append → toString,时间复杂度 O(n²),空间开销线性增长。
JDK 9+ 虽然对非循环 简单拼接做了 invokedynamic 优化(可直接操作 byte\[\],零中间对象),但循环累积式拼接仍然不适用此优化。因此,循环内拼接必须显式使用 StringBuilder,并预估初始容量避免扩容拷贝。
Q7:substring() 在不同 JDK 版本中有何区别?
A:
- JDK 6 及以前:substring 共享原 char\[\],仅记录 offset/count。优点是零拷贝,缺点是短字符串持有大数组引用导致内存泄漏。
- JDK 7+:substring 始终拷贝新数组。彻底解决内存泄漏,但增加了复制成本。从超大字符串提取大量子串时需意识到此开销,必要时可使用自定义视图或 ByteBuffer。
Q8:String 是值传递还是引用传递?
A: Java 只有值传递。对于 String,传递的是引用的副本(即地址值的拷贝)。由于 String 不可变,即使方法内对形参重新赋值,也不会影响实参;且无法通过形参修改原对象内容。这使得 String 在行为上类似值类型,但本质仍是引用类型的值传递。
Q9:为什么密码不应该用 String 存储?
A: String 不可变,一旦创建就无法主动清除内容。密码会一直驻留在堆内存中直到 GC 回收,期间可能被堆转储、内存扫描、swap 或 core dump 捕获。正确做法是使用 char[] 或 byte[],使用后立即手动清零 (Arrays.fill(password, '\0'))。现代安全框架(Spring Security、Jakarta EE)已迁移至 char\[\] 或专用 Credential 类型。
Q10:str.length() 和实际字符数有什么区别?如何正确处理 Unicode?
A: length() 返回 UTF-16 code unit 数量,不等于实际字符数。Emoji 等 BMP 外字符由代理对表示,占 2 个 char。
正确做法 :获取真实字符数用 codePointCount(0, str.length());遍历用 codePoints() Stream API;截取需按 codePoint 边界操作,避免截断代理对产生乱码;正则匹配使用 \X 或 Unicode 感知 Pattern。处理用户输入(昵称、消息、评论)时必须使用 CodePoint 感知 API。
Q11:StringBuilder 和 StringBuffer 怎么选?
A: 优先选 StringBuilder。StringBuffer 的 synchronized 是粗粒度锁,性能比 StringBuilder 慢 30% 以上,且在现代并发编程中几乎无用武之地。若真需多线程安全构建,应使用 ThreadLocal\ 或在业务层做细粒度同步,而非依赖 StringBuffer。
Q12:字符串拼接时,+、StringBuilder、String.format 的性能排序是怎样的?
A: 在 JDK 9+ 环境下:
- 非循环简单拼接 :
+≈ StringBuilder > String.format(invokedynamic 优化使+与 SB 持平) - 循环拼接 :StringBuilder >>
+>> String.format - 复杂格式化:String.format 可读性最佳,但性能最差(涉及反射、Locale 解析、正则匹配);若性能敏感,应使用 StringBuilder + 手动拼接或 MessageFormat
⚠️ String.format 的性能开销通常是 StringBuilder 的 10-50 倍,仅在非热点路径或对可读性要求极高时使用。
Q13:常量池在 JVM 中的位置经历了哪些变化?为什么?
A:
- JDK 6 :永久代(PermGen),大小固定(
-XX:MaxPermSize),不随堆扩展,易因字符串过多导致 PermGen OOM。 - JDK 7+ :移至堆内存,受
-Xmx控制,可被 GC 回收。
这一变迁使字符串生命周期完全由 GC 管理,消除了 PermGen OOM 风险,并为 G1 字符串去重等 GC 级优化提供了基础。元空间(Metaspace)仅存类元数据,不再存放字符串。
Q14:如何诊断和优化字符串相关的内存问题?
A:
- 使用
-XX:+PrintStringTableStatistics查看常量池桶分布、负载因子、冲突情况。 - 堆转储分析工具(Eclipse MAT、JProfiler)检查 String 对象数量、大小分布及引用链。
- 高重复率场景启用 G1 字符串去重(
-XX:+UseStringDeduplication)。 - 大量 intern 场景调整
-XX:StringTableSize(JDK 8)增大桶数以减少哈希冲突。 - 确认 Compact Strings 已启用(JDK 9+ 默认开启)。
- 审查代码中是否存在循环拼接、未预分配容量的 StringBuilder、以及对高基数数据的 intern 调用。