文章目录
-
- 前言
- [第一招:ForEach 换 LazyForEach](#第一招:ForEach 换 LazyForEach)
- [第二招:缩小 item 布局层级](#第二招:缩小 item 布局层级)
- 第三招:组件复用
- 第四招:图片用缩略图
- 优化对照表
- 常见误区(小白必踩)
- 完整可运行示例:长列表性能优化
- 写在最后
前言
列表是性能重灾区。一个聊天记录几千条、商品列表无限滚动------如果用错方式,轻则滑动卡顿,重则内存爆炸直接崩。
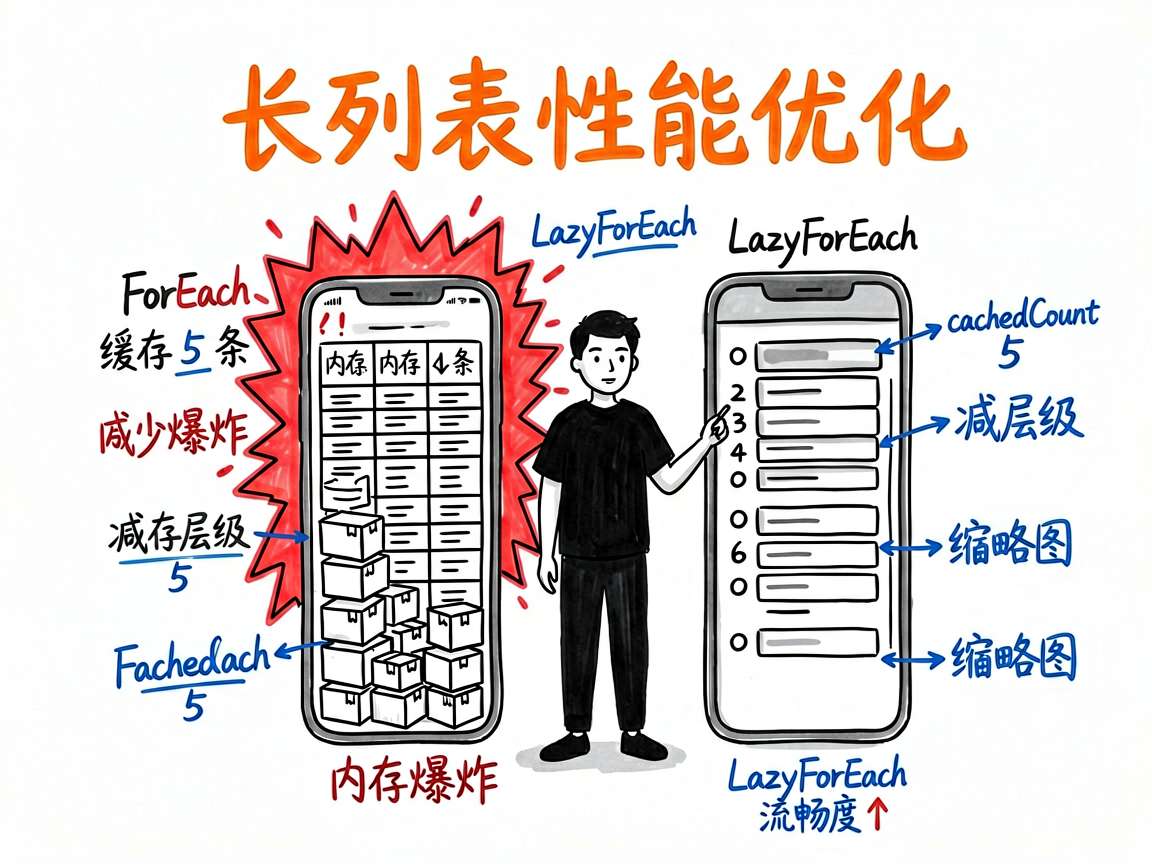
我做过不少列表优化,这篇文章把最实用的几招讲清楚:用 LazyForEach 懒加载、控制单次渲染量、复用组件、减少布局层级。照着做,列表丝滑起来。
第一招:ForEach 换 LazyForEach
普通 ForEach 会一次性把所有 item 都创建出来。1000 条就建 1000 个组件,内存直接起飞。
LazyForEach 只渲染当前屏幕可见 + 少量缓冲的 item,滑到哪建到哪:
代码实现
typescript
import { LazyForEach, IDataSource } from '@kit.ArkUI'

// 数据源要实现一个 IDataSource 接口(提供数据 + 通知变化)
class MyDataSource implements IDataSource {
  private list: Item[] = []
  totalCount(): number { return this.list.length }
  getData(index: number): Item { return this.list[index] }
  registerDataChangeListener(_: DataChangeListener): void {}
  unregisterDataChangeListener(_: DataChangeListener): void {}
}

build() {
  List() {
    LazyForEach(this.dataSource, (item: Item) => {
      ListItem() {
        MyItemView({ item: item })
      }
    }, (item: Item) => item.id)    // 必须唯一键
  }
  .cachedCount(5)                 // 上下各多缓存 5 个,滑动更顺
}
LazyForEach第一个参数是实现了IDataSource的数据源(不是裸数组)。.cachedCount(5):屏幕外多预创建 5 个,滑动时不用现建,减少白屏。- 唯一键必须有,否则报错。
经验值:列表超过 50 条,无脑上
LazyForEach。这是长列表优化的第一杠杆。
第二招:缩小 item 布局层级
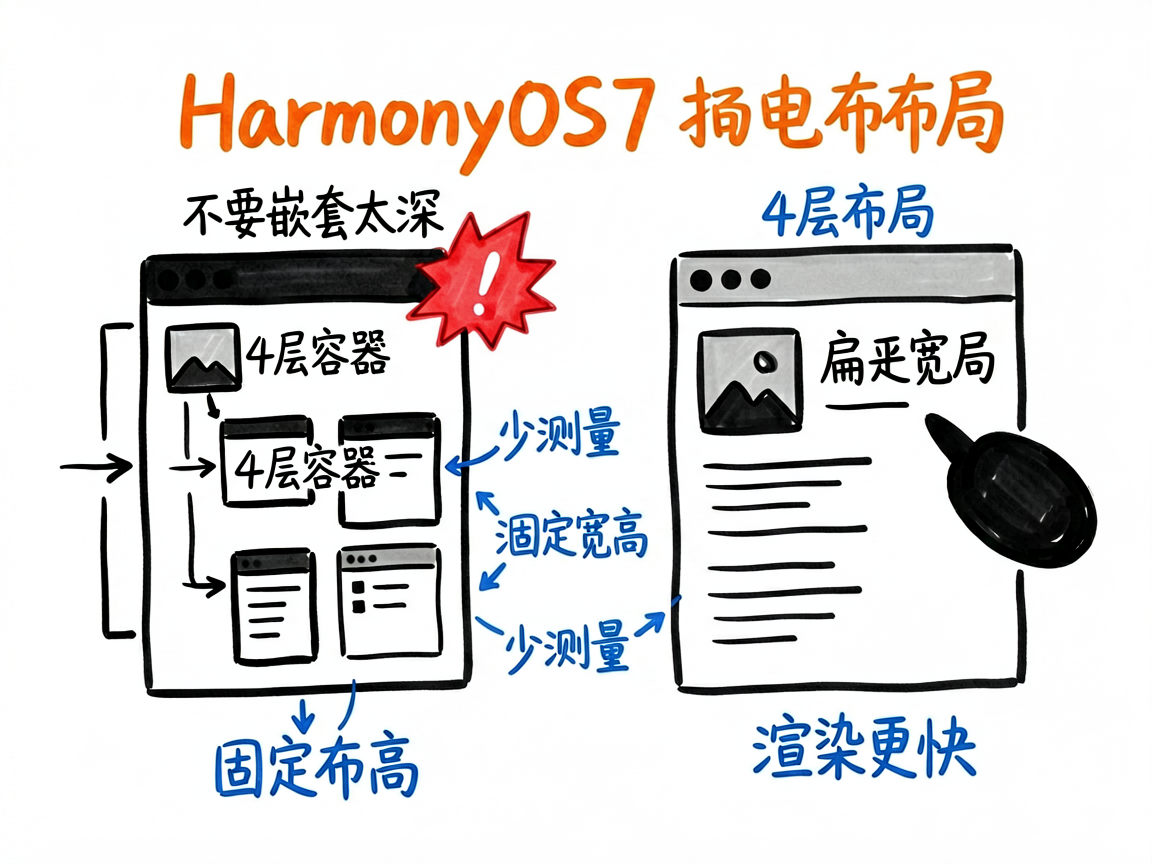
每个 ListItem 的布局越复杂,渲染越慢。能扁平就别嵌套:
核心代码
typescript
// 不好:套了 4 层容器
Column() { Row() { Column() { Row() { Text(x) } } } }

// 好:直接一层
Row() {
  Image(...).width(40)
  Text(x).layoutWeight(1).margin({ left: 8 })
}- 减少无意义的
Column/Row嵌套,少一层少一份测量开销。 - 固定尺寸的元素尽量给具体宽高,避免父容器反复测量。
第三招:组件复用
LazyForEach 默认会复用滑出屏幕的 ListItem 组件(同一类型的),不要在每个 item 里 new 大对象,避免重建开销。
完整示例
typescript
ListItem() {
  MyItemView({ item: item })   // MyItemView 是复用的自定义组件
}
把 item 抽成 @Component 自定义组件,框架能更好地复用其节点,提升滚动流畅度。
第四招:图片用缩略图
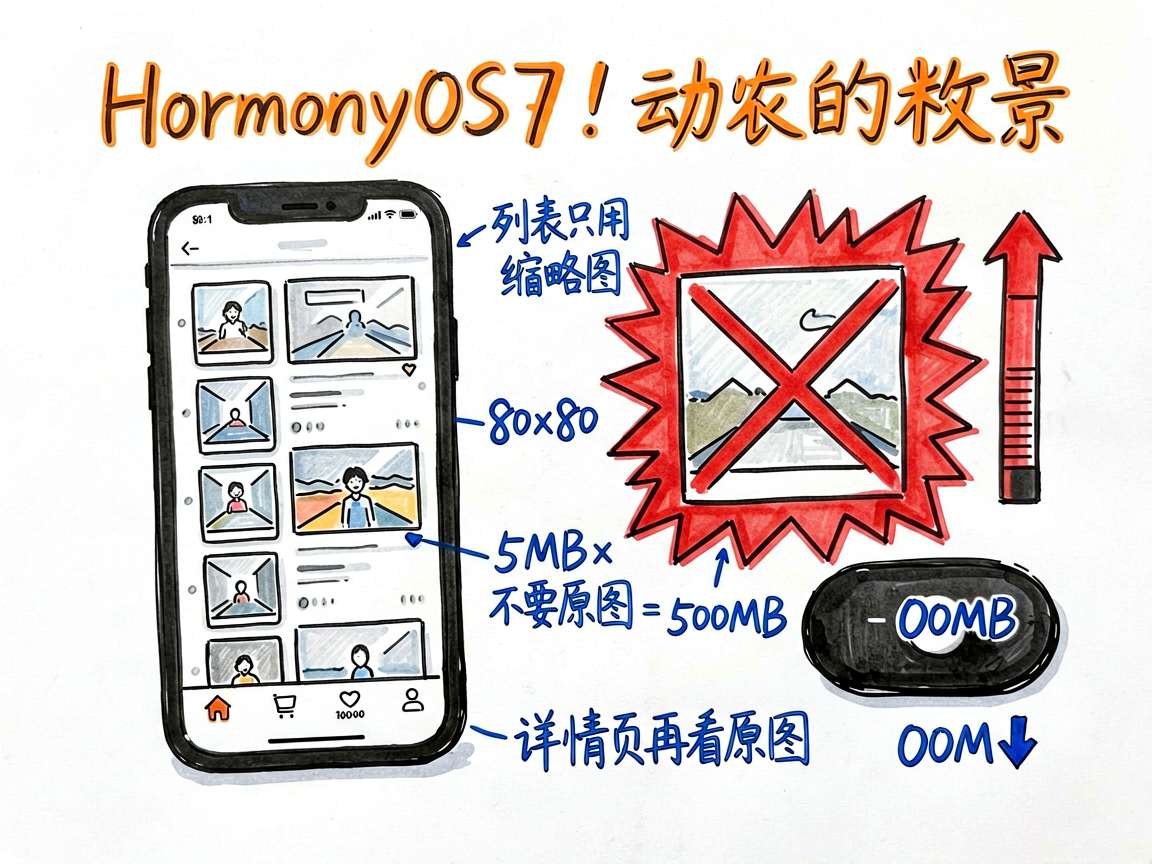
长列表里的大图是内存杀手。网络图用缩略图 URL,本地图控制尺寸:
代码解析
typescript
Image(item.thumbUrl)    // 缩略图,不是原图
.width(80).height(80).objectFit(ImageFit.Cover)- 千万别在列表里加载原图,一张 5MB 原图 × 100 条 = 500MB,必崩。
- 显示用缩略图,点进去详情页再加载原图。
优化对照表
| 手段 | 解决什么问题 | 效果 |
|---|---|---|
| LazyForEach | 全量创建组件 | 内存↓ 启动↓ |
| cachedCount | 滑动白屏 | 流畅度↑ |
| 减层级 | 测量开销 | 渲染↑ |
| 缩略图 | 大图占内存 | OOM↓ |
常见误区(小白必踩)
| 误区 | 说明 |
|---|---|
不用 LazyForEach |
ForEach 一次性建所有 item,几千条直接内存爆炸。超 50 条无脑上 LazyForEach。 |
| 布局嵌套太深 | 每个 ListItem 套 4 层容器,测量开销大。能扁平就扁平。 |
| 列表用原图 | 一张 5MB 原图 × 100 条 = 500MB 必崩,用缩略图。 |
不设置 cachedCount |
屏幕外多预创建几个,滑动才不白屏。 |
下面这段代码可以直接复制到 DevEco Studio 里运行。建议你边读边敲,改一改文末「动手改一改」里的参数,亲眼看看效果。
完整可运行示例:长列表性能优化
用 LazyForEach 替代 ForEach 做万级列表懒加载。
实现拆解
typescript
// LazyForEach:只渲染可视区,内存恒定
import { LazyForEach, IDataSource } from '@kit.ArkUI'

class NumSource implements IDataSource {
  private nums: number[] = Array.from({ length: 10000 }, (_, i) => i)
  totalCount(): number { return this.nums.length }
  getData(index: number): number { return this.nums[index] }
  registerDataChangeListener() {}
  unregisterDataChangeListener() {}
}

@Entry
@Component
struct BigList {
  private source: NumSource = new NumSource()
  build() {
    List() {
      LazyForEach(this.source, (n: number) => {
        ListItem() {
          Text('行 ' + n).padding(12)
        }
      }, (n: number) => n.toString())
    }
    .cachedCount(5)    // 预加载可视区外的 5 个,滚动更顺
  }
}
你会看到什么 :一万个数据项滚动依然流畅,因为框架只创建可视区 + 预加载的少量 ListItem,滚出屏幕的组件会被回收。
动手改一改:
- 把
ForEach换成LazyForEach前后各跑一次,用 Profiler 看内存差异。 - 调
cachedCount大小,权衡内存与滚动顺滑度。 - 给
ListItem加key稳定标识,避免复用错乱。
写在最后
长列表优化记住四招:LazyForEach 懒加载、cachedCount 加缓冲、布局减层级、图片用缩略。其中 LazyForEach 是性价比最高的一招,几乎所有长列表卡顿,第一步都是换它。
回去查你项目里所有 ForEach 渲染的列表,数据量可能上千的,立刻换成 LazyForEach------这一改,内存和流畅度能同时好一个档次。