当AI走进工业、能源等真实业务场景,常常会"水土不服"。一个简单的设备异常判断,AI需要的不仅是当下的读数,更需要理解设备过去的状态变化、关联设备的同步信息,甚至要结合维修记录和故障知识库。这些分散在不同系统中的数据,如何高效打通,成为释放AI价值的关键。
业务数据的"散装"困境 在设备异常检测、故障诊断和预测性维护等场景中,连续的时序数据是重要的数据基础。但要完整理解设备状态,实时指标必须与设备型号、产线位置、维修记录等关系数据,以及专业知识文档等非结构化数据相结合。
然而,这些数据往往散落在监控、资产、工单等多个独立系统中。传统做法是,为不同类型数据引入多套专业系统,但这带来了数据同步复杂、接口开发繁琐、运维成本高昂等问题,导致实时分析和AI应用获取完整数据的链路冗长,且容易出现数据不一致。
融合架构:让数据围绕业务对象"自然连接" 金仓数据库的融合架构设计,旨在从根本上解决这个问题。其核心思路是:不再为不同数据类型建设割裂的系统,而是在同一数据库体系内实现多模数据的原生关联。
金仓时序数据模型KES TimeSeries的时序能力,并非外挂模块,而是构建在KES融合数据库架构中的原生能力。这使得时序数据(状态变化)、关系数据(业务属性)、GIS数据(空间位置)和向量数据(专业知识)能够围绕同一个业务对象(如一台设备)直接建立关联,为上层应用提供完整的数据上下文。
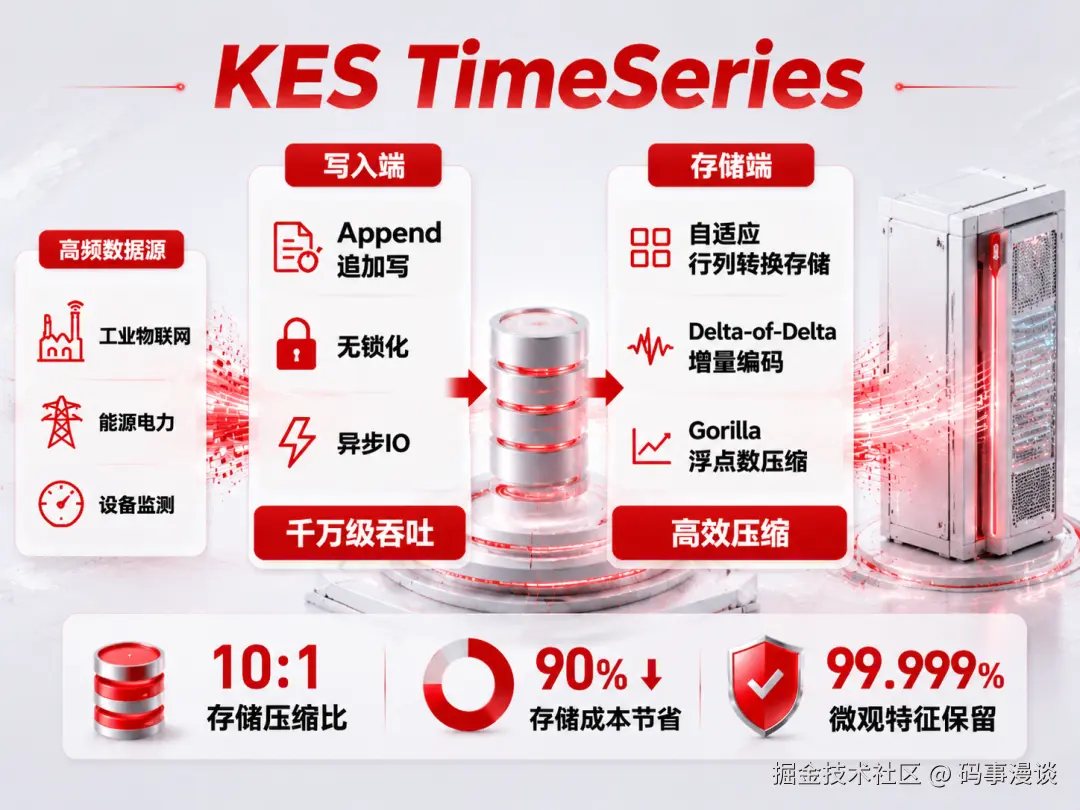
扎实的时序能力:为融合奠定基石 融合的前提是各类数据引擎本身足够强大。针对物联网场景高频写入、海量设备的特点,KES TimeSeries在写入、存储和查询方面进行了深度优化:
- 高性能写入 :通过Append追加写、无锁化、异步IO等机制,减少高并发写入的资源等待。在特定测试环境下,单节点写入性能可达千万级指标点/秒,确保海量数据稳定入库。
- 高压缩比存储 :采用自适应行列存储,并结合Delta-of-Delta、Gorilla等时序专用压缩算法。典型数字型时序数据压缩比可达10:1,存储空间最高可节省约90%,有效降低海量历史数据的保存成本。
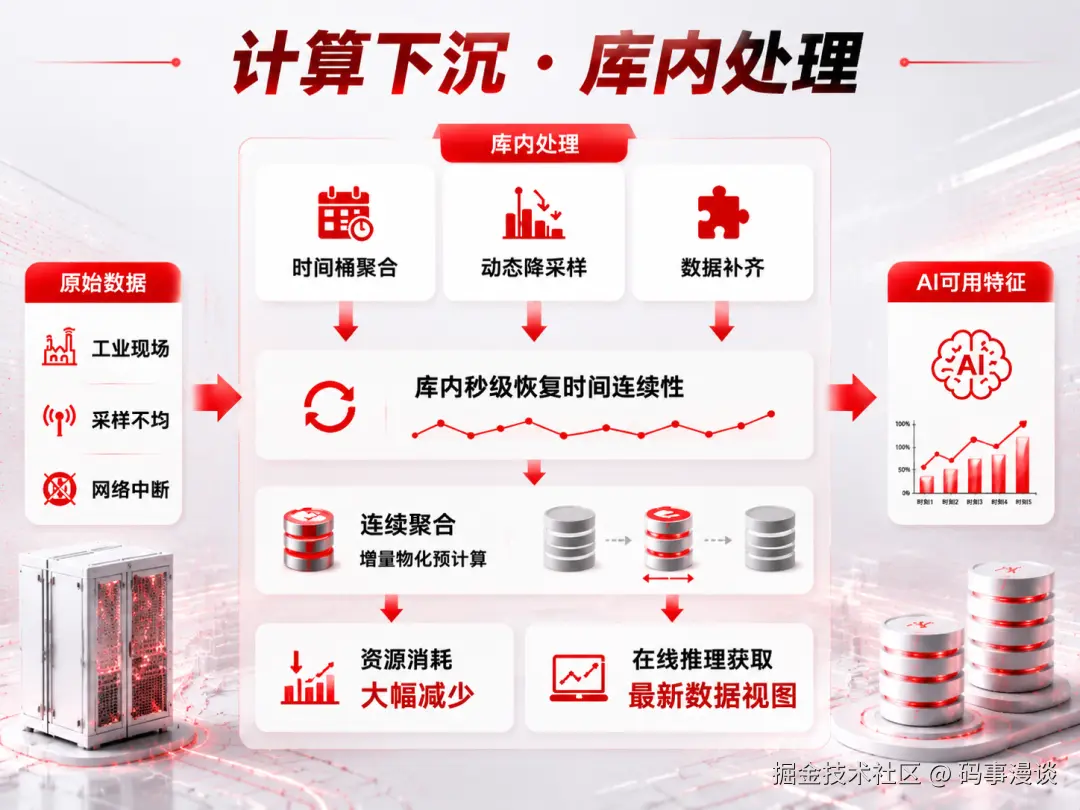
- 库内计算能力:内置时间桶聚合、动态降采样、数据补齐等功能,可在数据库内部直接处理采样频率不一致、数据缺失等工业现场常见问题,恢复连续、可分析的运行曲线。
- 连续聚合加速:针对频繁查询的历史趋势,通过增量预计算分钟、小时等粒度的数据,实现查询的毫秒级响应,避免反复扫描原始明细,为实时监测和在线推理提供高效支持。
实效验证:从地铁线路到千行百业 技术成效已在真实业务场景中得到验证。在北京轨道交通应急指挥调度平台等项目中,金仓时序数据库展现出显著价值:
- 写入性能较原系统提升超过10倍。
- 部分历史数据分析响应时间从分钟级缩短至秒级。
- 时序数据存储空间占用降低70%---80%。
这些能力首先服务于实时监控、故障追溯和运营分析。当业务需要引入预测模型或更复杂的AI应用时,这套架构能提供更完整、及时的数据支持。对于广大行业用户而言,提前构建一套能稳定承载时序数据、完成库内计算并组织多模态上下文的数据底座,是面向智能化转型更务实、更前瞻的选择。