我用 Codex + Remotion,做了一条唐朝纸片分层动画
文章目录
-
- [我用 Codex + Remotion,做了一条唐朝纸片分层动画](#我用 Codex + Remotion,做了一条唐朝纸片分层动画)
- 零、这条视频用了哪些工具
-
- [1\. Codex:整个流程的操作员](#1. Codex:整个流程的操作员)
- [2\. Imagegen:负责生成图片](#2. Imagegen:负责生成图片)
- [3\. F5-TTS:负责克隆旁白](#3. F5-TTS:负责克隆旁白)
- [4\. Remotion:负责让所有图层动起来](#4. Remotion:负责让所有图层动起来)
- [5\. FFmpeg:负责检查和验收](#5. FFmpeg:负责检查和验收)
- [一、用 Codex 先确定镜头,不要直接开始画图](#一、用 Codex 先确定镜头,不要直接开始画图)
- [二、用 Codex 把画面拆成四层](#二、用 Codex 把画面拆成四层)
- [三、用 Imagegen 生成没有人物的背景底板](#三、用 Imagegen 生成没有人物的背景底板)
- [四、用 Imagegen 生成角色,再用 Python 抠图拆层](#四、用 Imagegen 生成角色,再用 Python 抠图拆层)
- [五、在 Remotion 里先排版,再写动画](#五、在 Remotion 里先排版,再写动画)
- [六、用 Remotion 给每类图层设置不同动画](#六、用 Remotion 给每类图层设置不同动画)
- 七、用前后遮挡制造纵深
- [八、用 F5-TTS 生成配音,再加入字幕、音乐和音效](#八、用 F5-TTS 生成配音,再加入字幕、音乐和音效)
- [九、用 Remotion Studio 预览,用 FFmpeg 抽帧验收](#九、用 Remotion Studio 预览,用 FFmpeg 抽帧验收)
- 十、整条工作流总结
我真的调整了好几天才做出来。其实整体做个30秒视频是没问题的,大家可以自己有时间的去测试一下。
很多人做"纸片风视频",只是把一张完整图片放大、缩小,再加一点镜头移动。这样能动,但没有层次。
真正的纸片分层动画,核心不是生成一张漂亮的图,而是把背景、建筑、主角、配角和前景分别做成独立素材,再让每一层按照不同节奏运动。
这篇教程以我做的唐朝视频为例,把完整操作流程拆开讲清楚。
零、这条视频用了哪些工具
这不是靠一个软件完成的,而是一条本地视频流水线。实际使用的工具如下:
| 工具 | 在流程中的作用 | 是否必需 |
|---|---|---|
| **Codex** | 读取文案、设计分镜、生成项目代码、调整人物位置、执行命令和渲染 | 核心控制台 |
| **Imagegen** | 生成唐朝人物、宫殿、水墨山脉、纸片装饰等图片素材 | 可换其他绘图模型 |
| **Python + Pillow + NumPy** | 批量抠图、检查透明通道、把人物素材表拆成独立 PNG | 推荐 |
| **F5-TTS** | 使用参考音频做本地零样本声音克隆,生成中文旁白 WAV | 可换真人录音或其他 TTS |
| **Remotion** | 用 React 代码控制图层、人物入场、镜头、字幕、音效并渲染视频 | 核心视频引擎 |
| **FFmpeg / ffprobe** | 检查音视频时长、抽取关键帧、检查分辨率和音轨 | 推荐 |
| **Chrome / Remotion Studio** | 在浏览器里逐帧预览动画和检查排版 | 推荐 |
1. Codex:整个流程的操作员
Codex 不直接替代绘图、配音和渲染模型,它负责把这些工具串起来:
文案 → 分镜 → 素材清单 → 生成图片 → 抠图拆层
→ 编写 Remotion 动画 → 生成配音 → 加字幕音效 → 渲染 MP4
在这个项目里,Codex 主要修改:
src/ReplicaChapterScene.tsx   人物坐标、大小、层级和动画
src/MainVideo.tsx             配音、背景音乐、音效和字幕
src/script.json               文案、镜头和时长
public/assets/                图片素材
public/audio/                 旁白、音乐和音效
2. Imagegen:负责生成图片
Imagegen 用来生成背景底板和独立人物。生成时使用纯绿色背景,再通过本地脚本转成透明 PNG。不要让绘图模型直接生成整段动画,它只负责提供可控的独立图层。
3. F5-TTS:负责克隆旁白
本机使用 F5-TTS 做零样本声音克隆。它需要一段参考音频和对应文字,然后生成新的中文旁白:
{
  "ref_file": "参考音频.wav",
  "ref_text": "参考音频对应的文字",
  "full_text": "需要合成的唐朝口播文案",
  "full_out": "public/audio/tang-wide.wav"
}
参考音频必须干净、单人说话、没有音乐。生成以后再根据需要用 FFmpeg 调整到目标语速。
4. Remotion:负责让所有图层动起来
Remotion 是真正的视频制作引擎。人物的大小、位置、进入时间、前后遮挡、字幕和音效全部由 React 代码控制。它最大的优势是可以逐帧修改,也能把同一套模板批量用于其他历史题材。
5. FFmpeg:负责检查和验收
FFmpeg 不负责主体动画,但负责最后的技术检查:
# 查看视频分辨率、时长和音轨
ffprobe -v error -show_streams -show_format out/final.mp4

# 抽取第 5 秒画面检查排版
ffmpeg -ss 5 -i out/final.mp4 -frames:v 1 check-05.png
一、用 Codex 先确定镜头,不要直接开始画图
这条测试片只用了两个核心镜头:
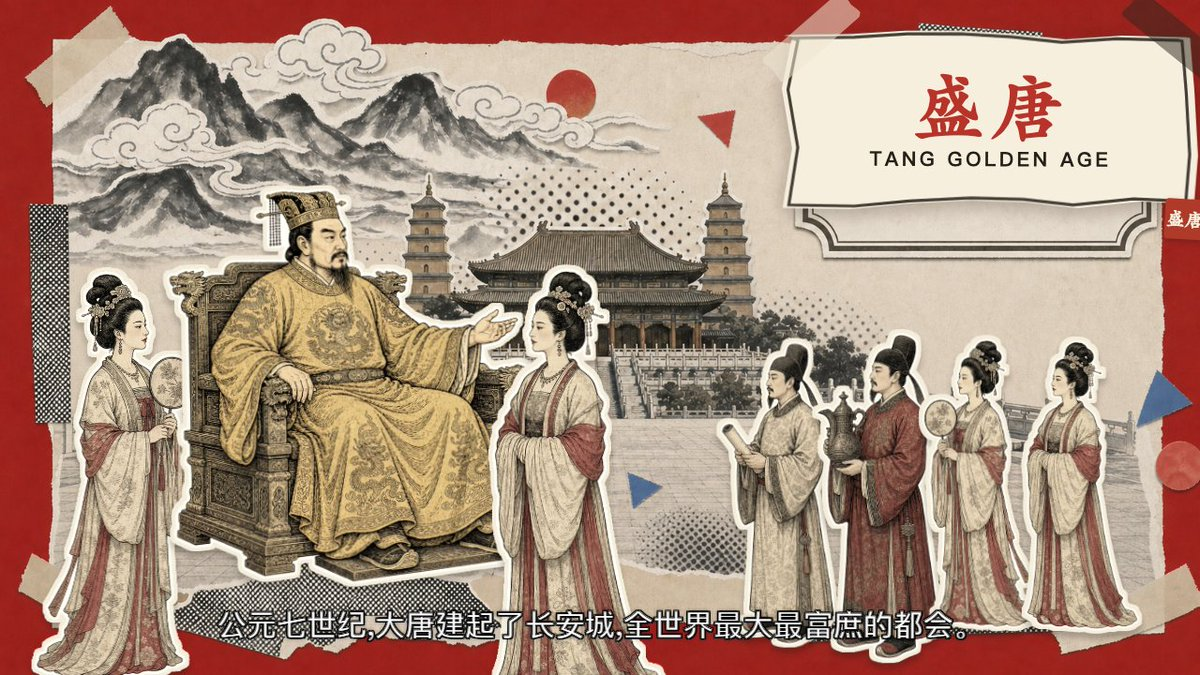
- **全景镜头** :皇帝是最大主体,左右侍女第二,右侧群臣最小,用来交代"盛唐长安"的规模。
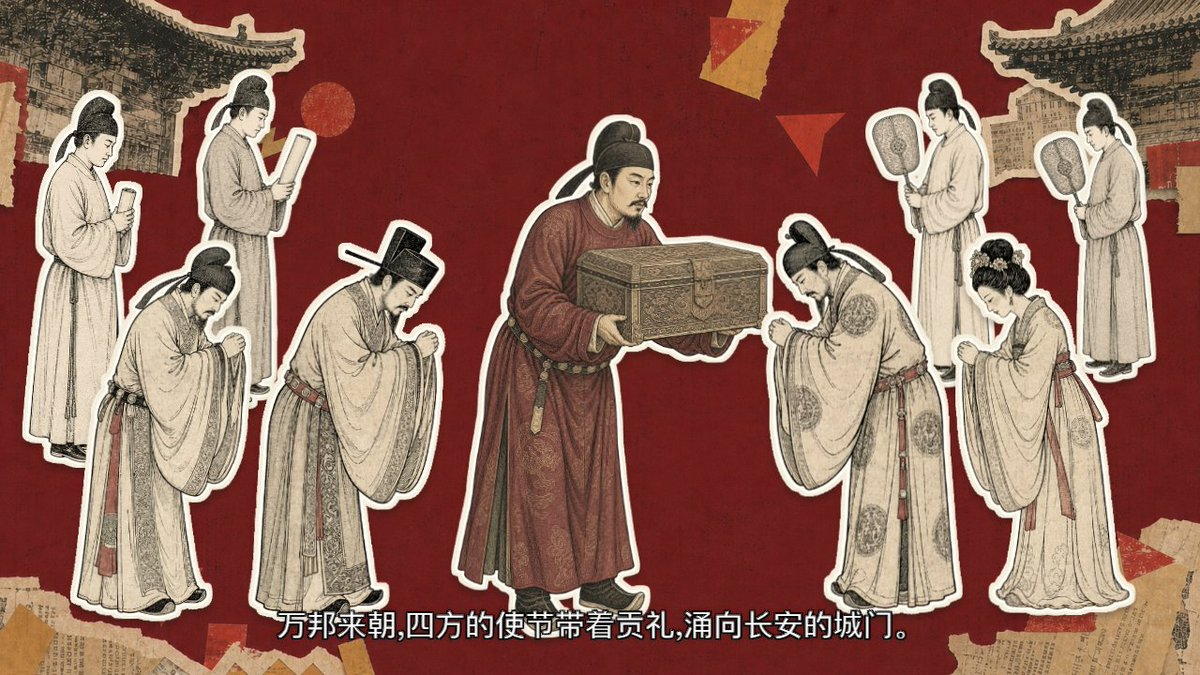
- **特写镜头** :中央捧礼盒的人最大,前排跪拜人物第二,后排侍从最小,用来表现"万邦来朝"。
先定镜头的原因很简单:同一个人物在全景和特写里的大小、位置、朝向都不同。如果先随便生成素材,后面很容易出现人物比例错误、视线方向相反、主次不清的问题。
二、用 Codex 把画面拆成四层
每个镜头至少拆成下面四层:
| 层级 | 内容 | 动画特点 |
|---|---|---|
| 背景层 | 山水、宫殿、城楼、纸张纹理 | 最慢,只做轻微漂移和推镜 |
| 后排层 | 远处群臣、侍从、建筑边角 | 移动幅度小,透明度稍低 |
| 主体层 | 皇帝、捧礼盒的人 | 尺寸最大,入场最有力量 |
| 前景层 | 侍女、跪拜人物、纸屑、胶带 | 移动稍快,用来遮挡并制造纵深 |
重点是: **人物必须是独立 PNG,不能全部画在同一张图里。**
三、用 Imagegen 生成没有人物的背景底板
背景底板只保留环境:
- 红色宣纸底纹
- 水墨山脉
- 长安宫殿和城楼
- 撕纸边缘
- 网点、胶带和印章装饰
不要把主要人物画进背景。人物一旦和背景粘在一起,后面就不能独立飞入、摇摆或调整大小。
这条视频使用两张背景底板:
public/assets/plates/01-tang-wide-bg.png
public/assets/plates/02-tang-close-bg.png
全景底板偏米白,方便突出金色皇帝;特写底板使用大面积深红,方便突出中央礼盒人物。
四、用 Imagegen 生成角色,再用 Python 抠图拆层
生成角色时,不要只写"画一个唐朝人物"。提示词必须同时限制:
- 唐代服饰和发冠
- 古籍线描与手工拼贴质感
- 正面或明确的左右朝向
- 完整人物,不裁掉头、手和脚
- 白色剪纸描边
- 纯色背景,方便抠图
- 不要文字、不要水印、不要复杂场景
示例提示词:
生成一名唐代皇帝全身人物,坐在雕花龙椅上,身体朝右,右手抬起。
中国古籍线描与复古纸片拼贴风,金色龙袍,人物完整,白色剪纸描边。
纯绿色背景,不要宫殿,不要其他人物,不要文字,不要阴影。
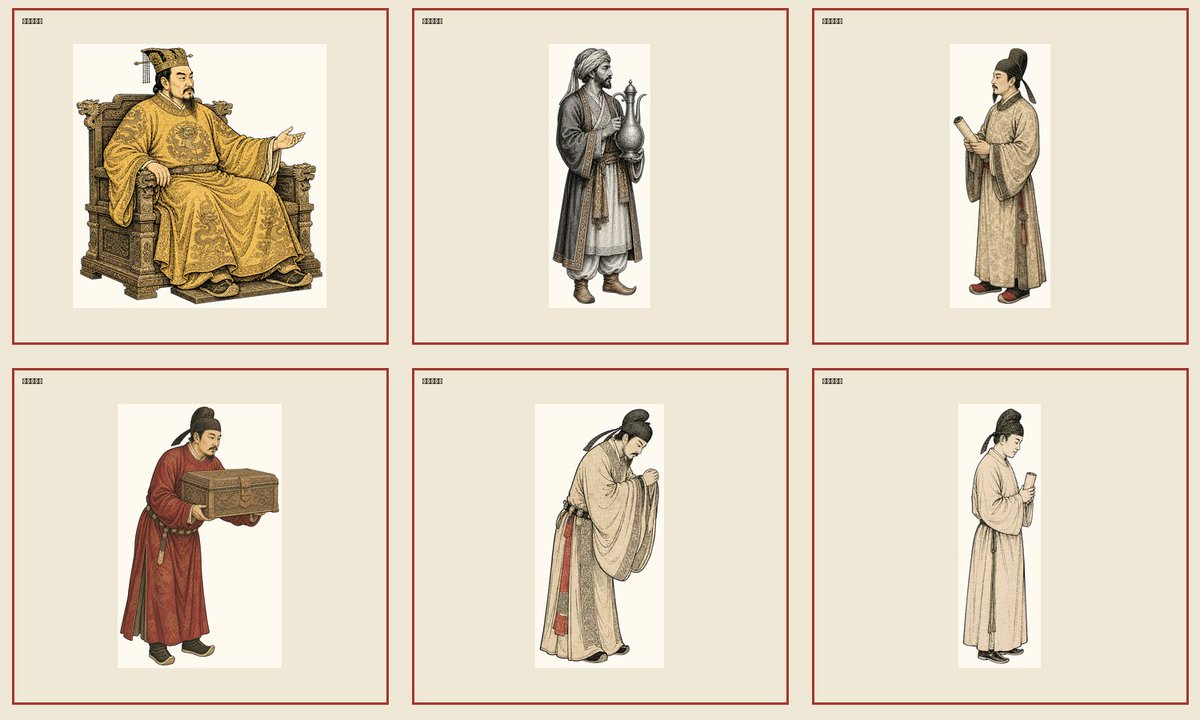
人物组最好先生成一张素材表,再拆成多个透明 PNG。项目里的拆分命令是:
python scripts/split_sheet.py \
  public/assets/tang-10s/source/close-six-alpha.png \
  public/assets/tang-10s/layers \
  close 6
拆完以后,每个人物都能单独控制位置和动画。
五、在 Remotion 里先排版,再写动画
不要一拿到素材就加动画。先把所有人物静止摆好,检查三个问题:
- 主角是不是最大、最醒目?
- 配角有没有挡住主角的脸、手和关键道具?
- 人物脚底是不是落在同一个合理地面上?
全景镜头的实际层级是:
皇帝:宽 650,主角层
左右侍女:宽 235~245,次要层
右侧群臣:宽 158~170,后排层
特写镜头的实际层级是:
中央礼盒人物:宽 575,主角层
前排跪拜人物:宽 285~330,次要层
后排侍从:宽 165~180,陪衬层
这一步决定了画面是否自然。人物不是平均分布,也不是全部一样大,而是按照叙事重要性安排大小。
六、用 Remotion 给每类图层设置不同动画
我把人物分成三种角色:primary、secondary、tertiary。
const roleMotion = {
  primary:   {distance: 78, rise: 55, startScale: 0.86},
  secondary: {distance: 58, rise: 38, startScale: 0.90},
  tertiary:  {distance: 38, rise: 22, startScale: 0.95},
};- 主角移动距离最大,带轻微缩放和落地感。
- 次要人物从左右两侧进入,幅度中等。
- 后排人物只做小幅移动,避免抢戏。
- 背景只做 1% 左右的慢速推镜。
- 所有人物入场后仍保留极轻微上下漂浮,避免画面完全静止。
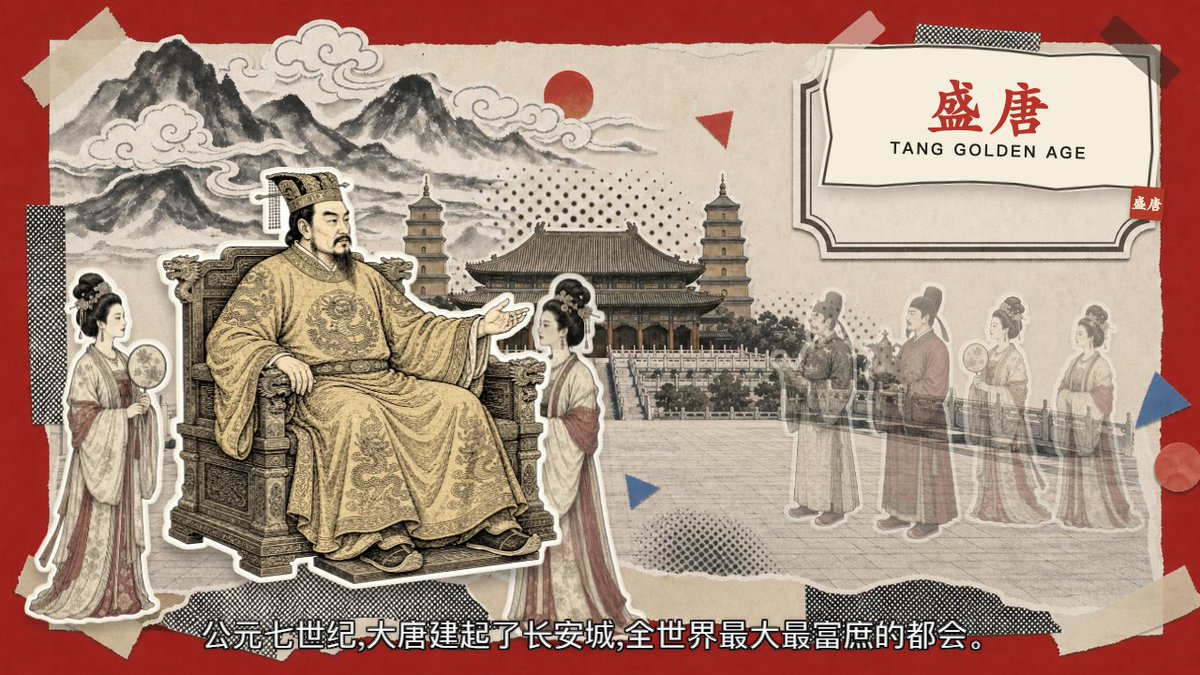
人物不要同时出现。实际使用 delay 错开入场:
{src: "emperor-1.png", delay: 4,  role: "primary"}
{src: "wide-left-1.png", delay: 18, role: "secondary"}
{src: "wide-right-1.png", delay: 34, role: "tertiary"}
这样画面会按照"主角先出现、配角补充、群像完成"的顺序建立,而不是一下子塞满。
七、用前后遮挡制造纵深
纸片动画的立体感主要来自遮挡关系,不是复杂的三维效果。
正确顺序是:
背景底板
后排人物
中排人物
主角
前排人物
字幕和装饰
每个图层都设置独立 zIndex。例如中央捧礼盒人物是 z: 5,前排跪拜人物是 z: 3~4,后排侍从是 z: 1~2。
人物还加了统一的白色纸片描边和阴影:
filter: \`
  drop-shadow(4px 0 #f5eedc)
  drop-shadow(-4px 0 #f5eedc)
  drop-shadow(0 4px #f5eedc)
  drop-shadow(0 18px 9px rgba(20,15,12,.32))
\`
白边负责"剪纸感",深色阴影负责把人物从背景里抬起来。
八、用 F5-TTS 生成配音,再加入字幕、音乐和音效
画面完成后,再按照配音长度切分镜头。
这条视频的音频分为四层:
-
**旁白** :每段单独一个 WAV,直接决定镜头时长。
-
**背景音乐** :循环播放,音量保持在人声下方。
-
**章节音效** :切换镜头时使用 impact 或 riser。
-
**人物入场音效** :主角用 impact,次要人物用 whoosh,后排人物用较轻的 tick 或 pops。
const sound = layer.role === "primary"
? "audio/sfx/impact.wav"
: layer.role === "secondary"
? "audio/sfx/whoosh.wav"
: "audio/sfx/tick.wav";
字幕只保留一层,固定在底部,逐句跟随旁白,避免重复字幕和画面文字互相打架。
九、用 Remotion Studio 预览,用 FFmpeg 抽帧验收
先启动 Remotion 预览:
cd ~/Desktop/vox-videos/20260711-tang-collage-16x9
npm install
npm run start
重点检查:
- 人物头、手、脚有没有被裁掉
- 朝向是否符合场景关系
- 主角和配角大小是否拉开
- 前后排有没有错误遮挡
- 人物进入时有没有同时出现
- 字幕是否挡住人物脚部和关键道具
- 音效是否和人物进入的帧对齐
最后渲染 MP4:
npm run render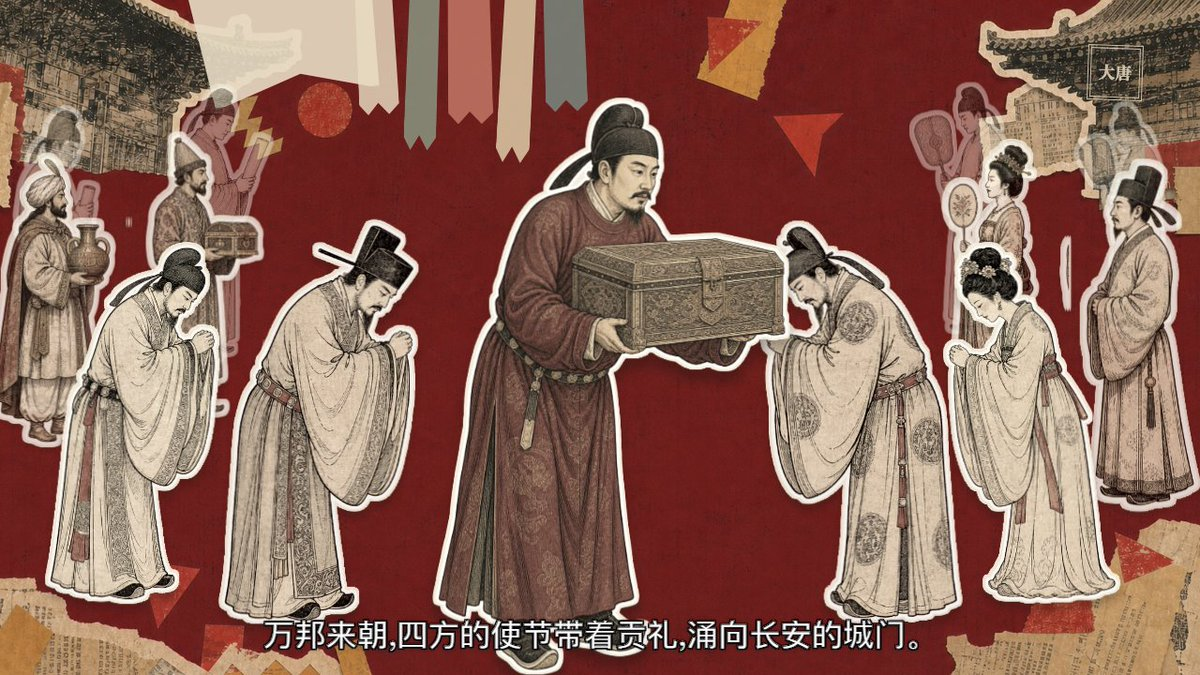
十、整条工作流总结
确定文案和镜头
→ Imagegen 做无人物背景底板
→ Imagegen 生成角色素材表
→ Python 抠图并拆成独立 PNG
→ Remotion 静态排版,确定人物主次
→ Remotion 设置图层顺序和前后遮挡
→ Remotion 按角色类型添加错峰动画
→ F5-TTS 生成旁白并切镜头
→ Remotion 加字幕、背景音乐和入场音效
→ FFmpeg 抽帧检查
→ Remotion 渲染 MP4
这套方法不只适合唐朝题材。历史人物、知识科普、商业故事、人物关系、城市发展,只要画面能拆成"背景、主角、配角、前景",都能用同样的流程制作。
真正让纸片动画变得有层次的,不是多生成几张图片,而是让每一张图片都承担明确的叙事位置。
关注我,大家一起拆解AI新玩法呀。