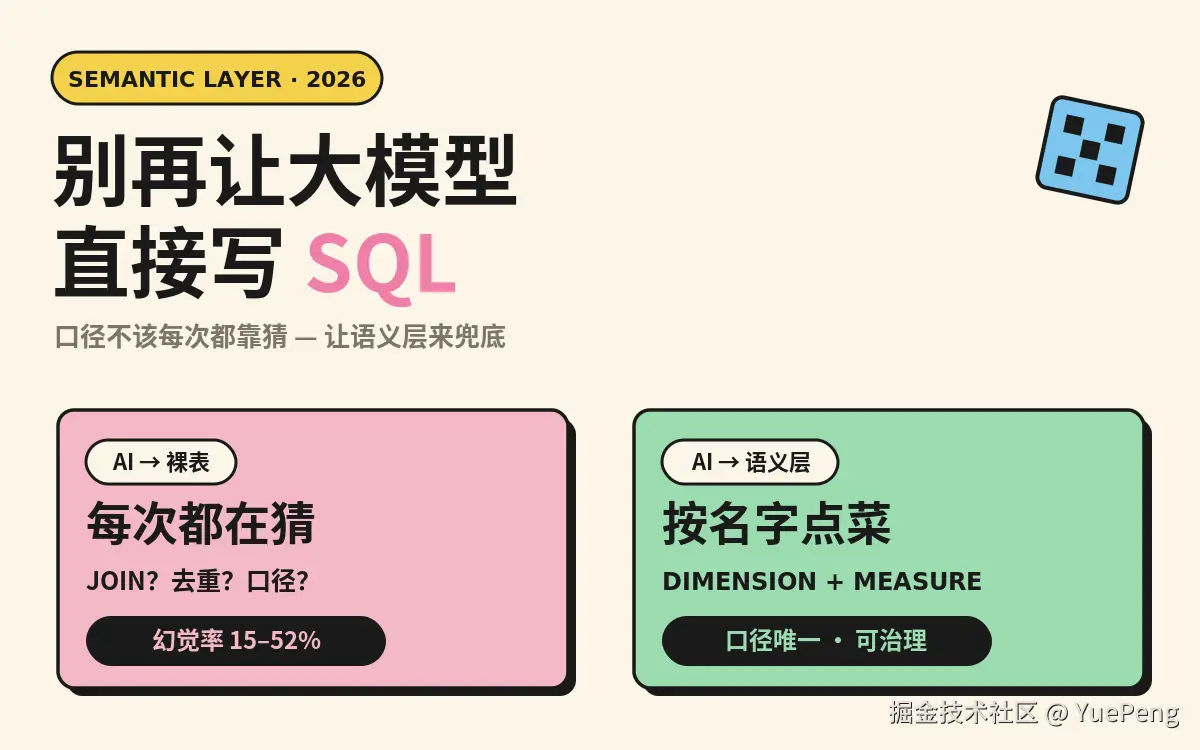
别再让大模型直接写 SQL 了
先说个真实场景。
你给团队接了个「AI 数据助手」,老板问一句「上个月华东区的 GMV 环比涨了多少」,大模型咔咔生成一段 SQL,跑出来一个数,发进群里。第二天他换个问法「华东 6 月销售额比 5 月」,同一个模型、同一个库,又生成一段 SQL------数字对不上了。
到底哪个对?没人知道。因为大模型面对一堆裸表时,它每一次都在重新推断:哪几张表要 join、金额要不要去重、"华东"按省还是按大区、退款减不减......推断的地方,就是幻觉滋生的地方。
这不是危言耸听。2026 年一份跨主流模型的基准测试给出的数字是:直接对着原始表做结构化分析,幻觉率在 15% 到 52% 之间。最差情况下,你每问两个问题,就有一个答案是它编的。
行业的解法高度一致:在大模型和数据库之间,加一层"语义层"(Semantic Layer)。指标怎么算、维度有哪些、口径是什么,全部预先定义好。大模型不再写 SQL,而是像点菜一样,从菜单里挑「维度」和「度量」的名字。
道理都懂。问题是------cube.dev 要你上 Node 和云,dbt 要你写 Python 和一堆 YAML。对国内一大票 Spring Boot 后端来说,这些都是新栈、新负担。有没有一个东西,能让 Java 程序员用最熟的姿势把这层建起来?有,它叫 erupt-cube。
语义层的尽头,是本体论
我们得把话说到根上。
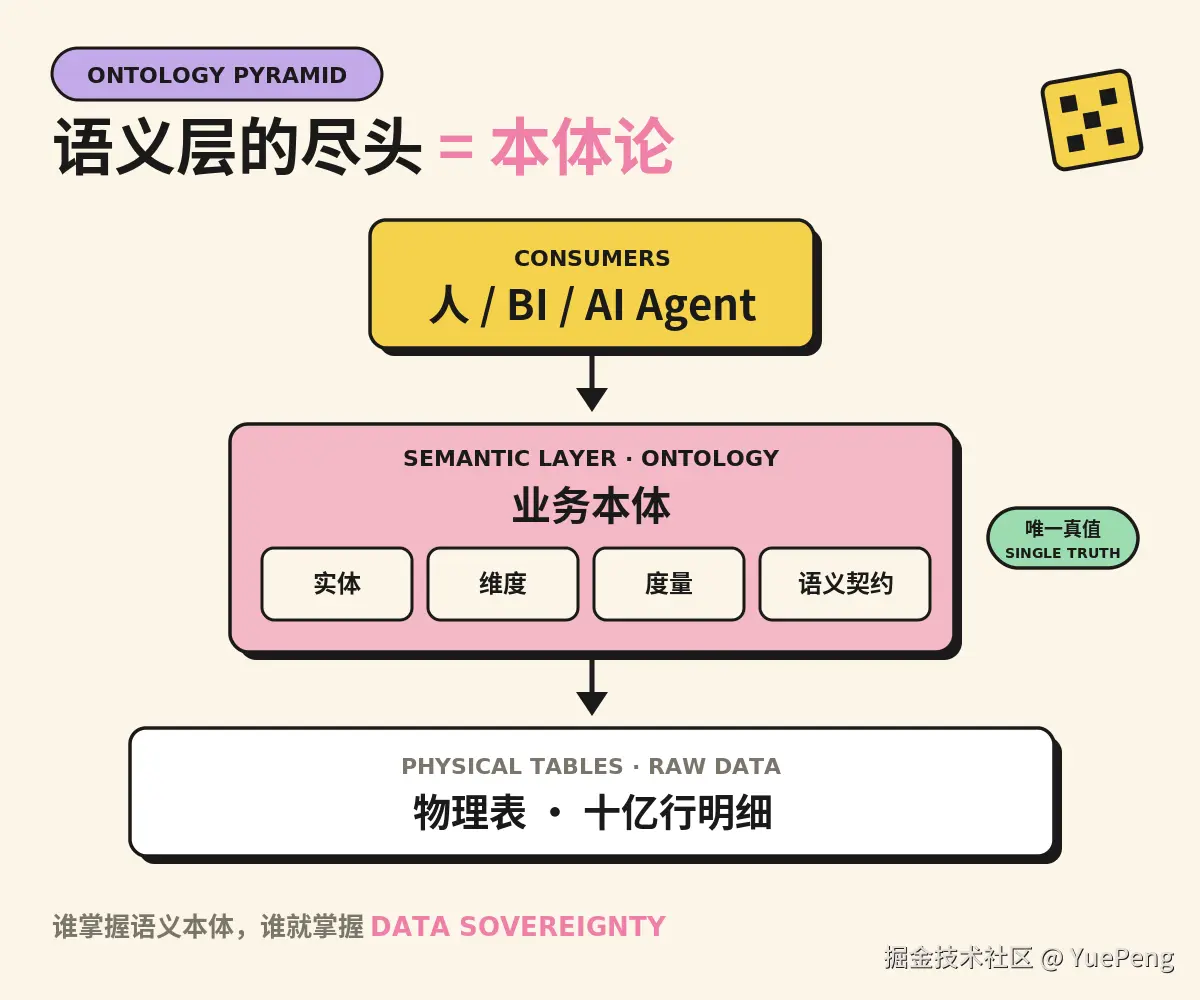
"让大模型别乱写 SQL"只是现象层 的解法。往下挖一层,整个行业在 2026 年集体转向的,其实是一个更古老的词------本体论(Ontology)。
本体论回答的是:你的业务世界里到底存在哪些"实体"、它们是什么关系、每个概念的"唯一真值"是什么。"GMV"不是一个字段,而是一个业务本体 ;"华东区"不是一个字符串,而是一个维度实体 ;"环比"不是一段 SQL,而是一条语义契约(Data Contract)。
过去这些知识散落在每个分析师的脑子里、每段临时 SQL 的注释里------这叫语义熵增 。大模型把矛盾放大到极致:它没有你的业务本体,只能对着裸表做概率性的语义重建,于是幻觉、口径漂移、权限越界接踵而至。
所谓语义层,本质就是把散落的业务本体显式化、代码化、可治理化 ,让它成为:全公司唯一的单一事实源(Single Source of Truth) 、人/BI/AI 共用的语义内核(Semantic Kernel) 、定义与展现解耦的 Headless BI 、以及面向 Agent 的知识本体。
一句话:谁掌握了语义本体,谁就掌握了数据主权。 而 erupt-cube 的答案是------用注解,把业务本体声明成代码。
一个注解,就是一个 Cube
一张事实表,加几个注解,就是一个可查询的 OLAP Cube:
java
@EruptCube(
    datasource = "ch",
    name = "销售分析",
    description = "按区域/时间统计销售 GMV 与订单量",
    sql = "SELECT * FROM fact_sales"
)
public class SalesCube {

    @Dimension(title = "区域")
    private String region;

    @Dimension(title = "下单日期")
    private String order_date;

    @Measure(title = "GMV", sql = "sum(amount)")
    private BigDecimal gmv;

    @Measure(title = "订单量", sql = "count(distinct order_id)")
    private Long orders;

    @Parameter(title = "是否含退款")
    private String include_refund;
}
@Measure 里那句 sum(amount),就是 GMV 这个业务本体的唯一真值定义 ,是写进代码的语义契约 ------全公司从此只有这一个 GMV。@Dimension 自动进 GROUP BY;@Parameter 配合 Velocity 模板,让"要不要减退款"这类逻辑在运行时动态切换。
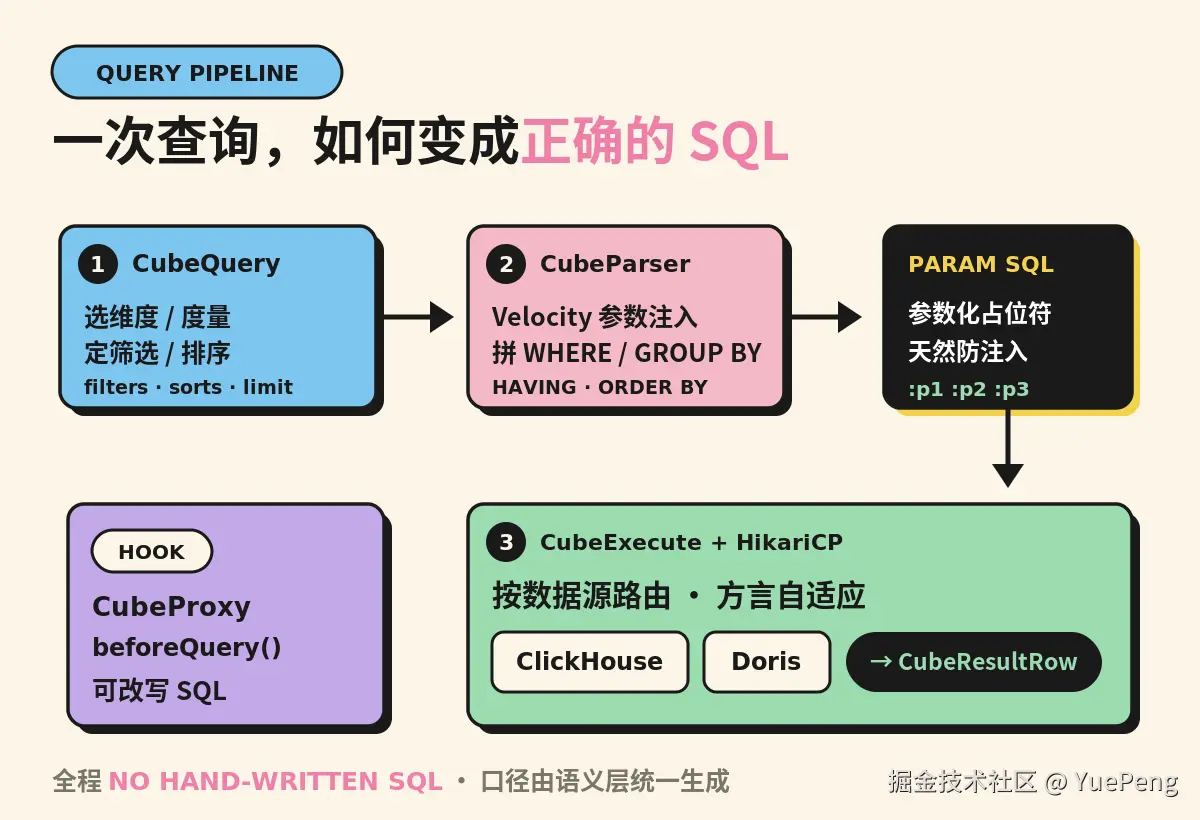
启动时 CubeCoreModel 扫描所有 @EruptCube 类建成内存注册表;查询来了,CubeParserService 拼出带 WHERE / GROUP BY / HAVING / ORDER BY 的参数化 SQL ,CubeExecuteService 路由到对应数据源执行。注意"参数化"三个字------16+ 个操作符(EQ/IN/BETWEEN/GT,还有做报表顺手的 FEW_DAYS 最近 N 天、FUTURE_DAYS 未来 N 天)全走占位符绑定,天然防注入。这点在你把查询开放给大模型时尤其重要。
十亿行,和十四种数据库
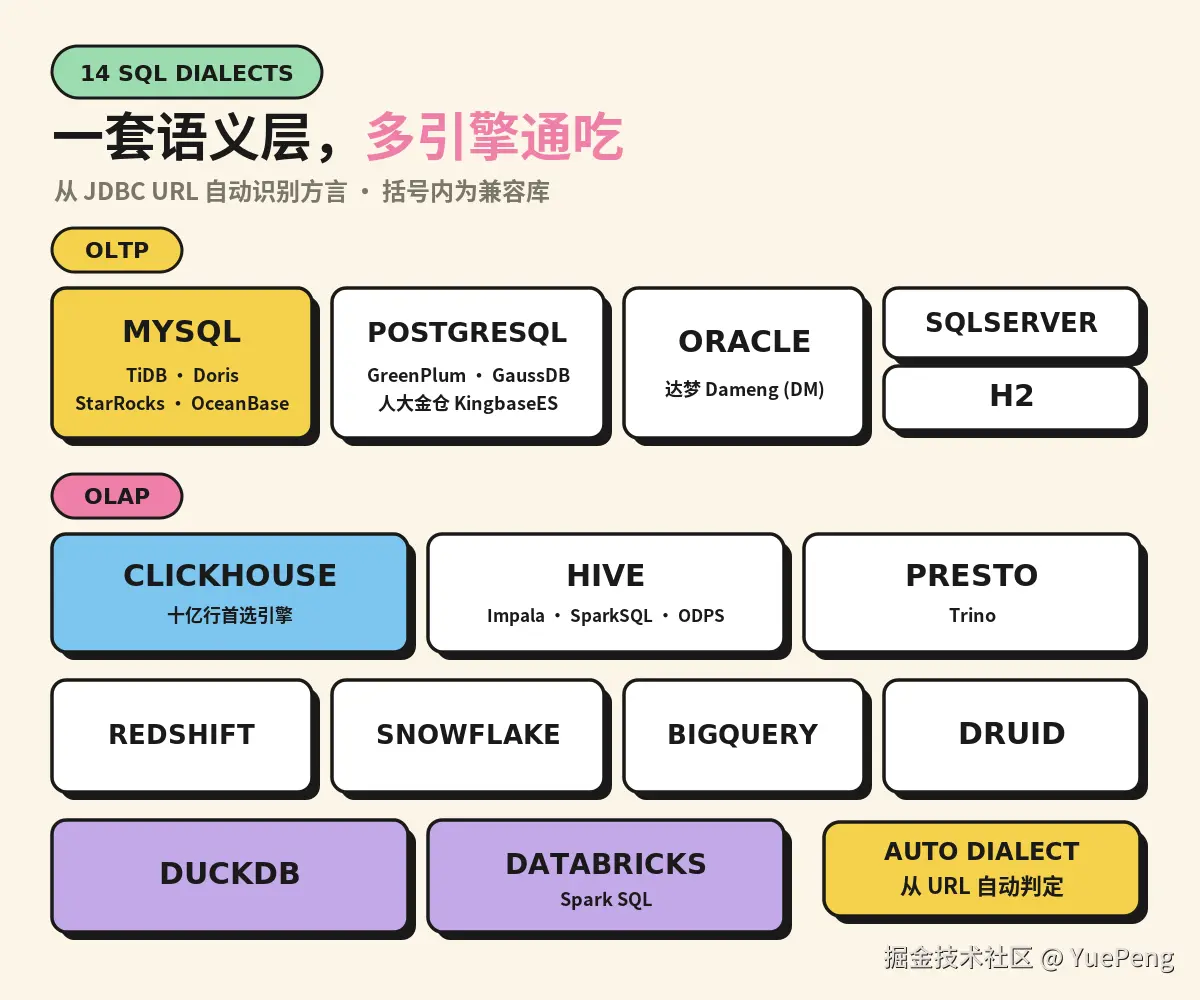
erupt-cube 面向十亿行级别的数据集,通过多数据源路由把查询打到 ClickHouse 这类 OLAP 引擎上,底层由 HikariCP 管理连接池:
yaml
erupt:
  cube:
    show-sql: true
    datasource:
      ch:
        jdbc-url: jdbc:clickhouse://host:8123/db
        username: reader
        password: secret
driver-class-name: ru.yandex.clickhouse.ClickHouseDriver更省心的是方言自动识别 :内置 14 种方言枚举------MySQL、PostgreSQL、Oracle、SQL Server、ClickHouse、Hive、Presto/Trino、Redshift、Snowflake、BigQuery、Druid、DuckDB、Databricks、H2------而且是从 JDBC URL 自动判断。MySQL 那支顺带兼容 TiDB、Doris、StarRocks、OceanBase;PostgreSQL 兼容 GreenPlum、GaussDB、人大金仓;Oracle 兼容达梦。国产化那套库基本都照顾到了。
重头戏:它是为 AI 设计的
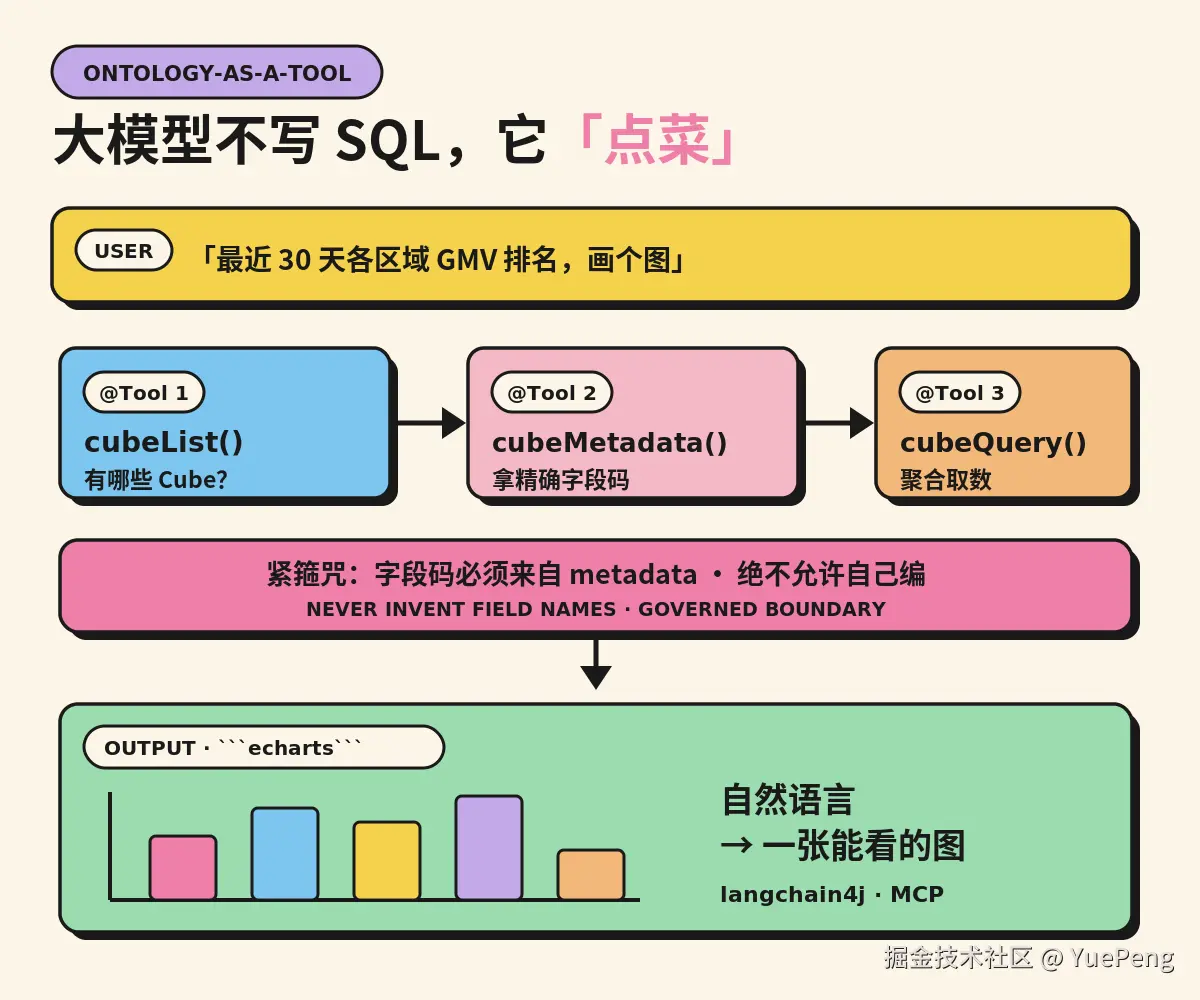
erupt-cube 真正踩在风口上的一点是:它把业务本体直接做成了大模型的工具(Ontology-as-a-Tool)。
在 erupt-cube-puzzle 里,EruptCubeAiTools 基于 langchain4j 的 @Tool 注解,给 AI Agent 串了一条流水线:cubeList() 列出可用 Cube → cubeMetadata() 拿精确字段码 → cubeQuery() 执行聚合。
关键不在于"有工具",而在于工具描述里写死的行为约束 (摘自源码):对任何统计、聚合、绘图任务,永远优先 走这条管线;字段码必须 来自 metadata,绝不允许自己编。翻译成人话:erupt-cube 在 prompt 层面就给大模型上了"紧箍咒"------不许你对着裸表瞎写 SQL,老老实实从我给的菜单里点。这正是把准确率从 90% 拉到 98% 的做法。
不止取数:当用户要图表时,大模型查完数直接输出一段 ECharts option JSON ,前端拿到就能渲染。从自然语言到一张能看的图,中间没有一行手写 SQL。而 @EruptCube 上的 prompt() 字段,还能给每个 Cube 追加业务上下文------语义是给人看的,也是给 AI 看的。
说点中肯的:它适合谁,不适合谁
不适合: 纯零代码、连 Maven 都不想碰的团队(它骨子里是给后端用的);想要成熟大生态的选型者(当前 2.0.5,还年轻,官方文档目前在带密码的语雀上);指望开箱即用物化/缓存加速引擎的场景(性能主要靠底层 ClickHouse 兜底)。
非常适合: 已在用 Erupt / Spring Boot,想低成本加一层可治理指标语义;手上有 ClickHouse / Doris / StarRocks,愁怎么把"十亿行 + AI 问数"安全开放;认同"AI 不该直接写 SQL",想要一个能立刻上手的 Java 实现。
最后
大模型时代,数据的护城河不再是算力,而是本体主权(Semantic Sovereignty):谁的语义唯一且可信,谁就定义了 AI 眼中的世界。语义层就是那道护城河,而 erupt-cube 是它在 Java 世界里一个足够务实的答案。
⭐ Star 一下 erupt