Midjourney 8 月 21 日的更新日志里,有几条很"工程":设置终于不会自己重置;提交后保留 pills 和图片参考;拖图时能选择参考角色;下载重新拥有正确文件名和扩展名。
没有哪一条在提升模型智商,却都在决定一个结果能不能继续做下去。
Prompt-centric 的数据模型不够了
很多生成工具早期的数据模型大致是:
ts
type Generation = {
  prompt: string;
  images: string[];
};它适合一次性演示,不适合生产。只要任务包含人物参考、风格参考、尺寸、个性化、多个候选、人工验收和跨平台派生,prompt + images 就无法解释结果。
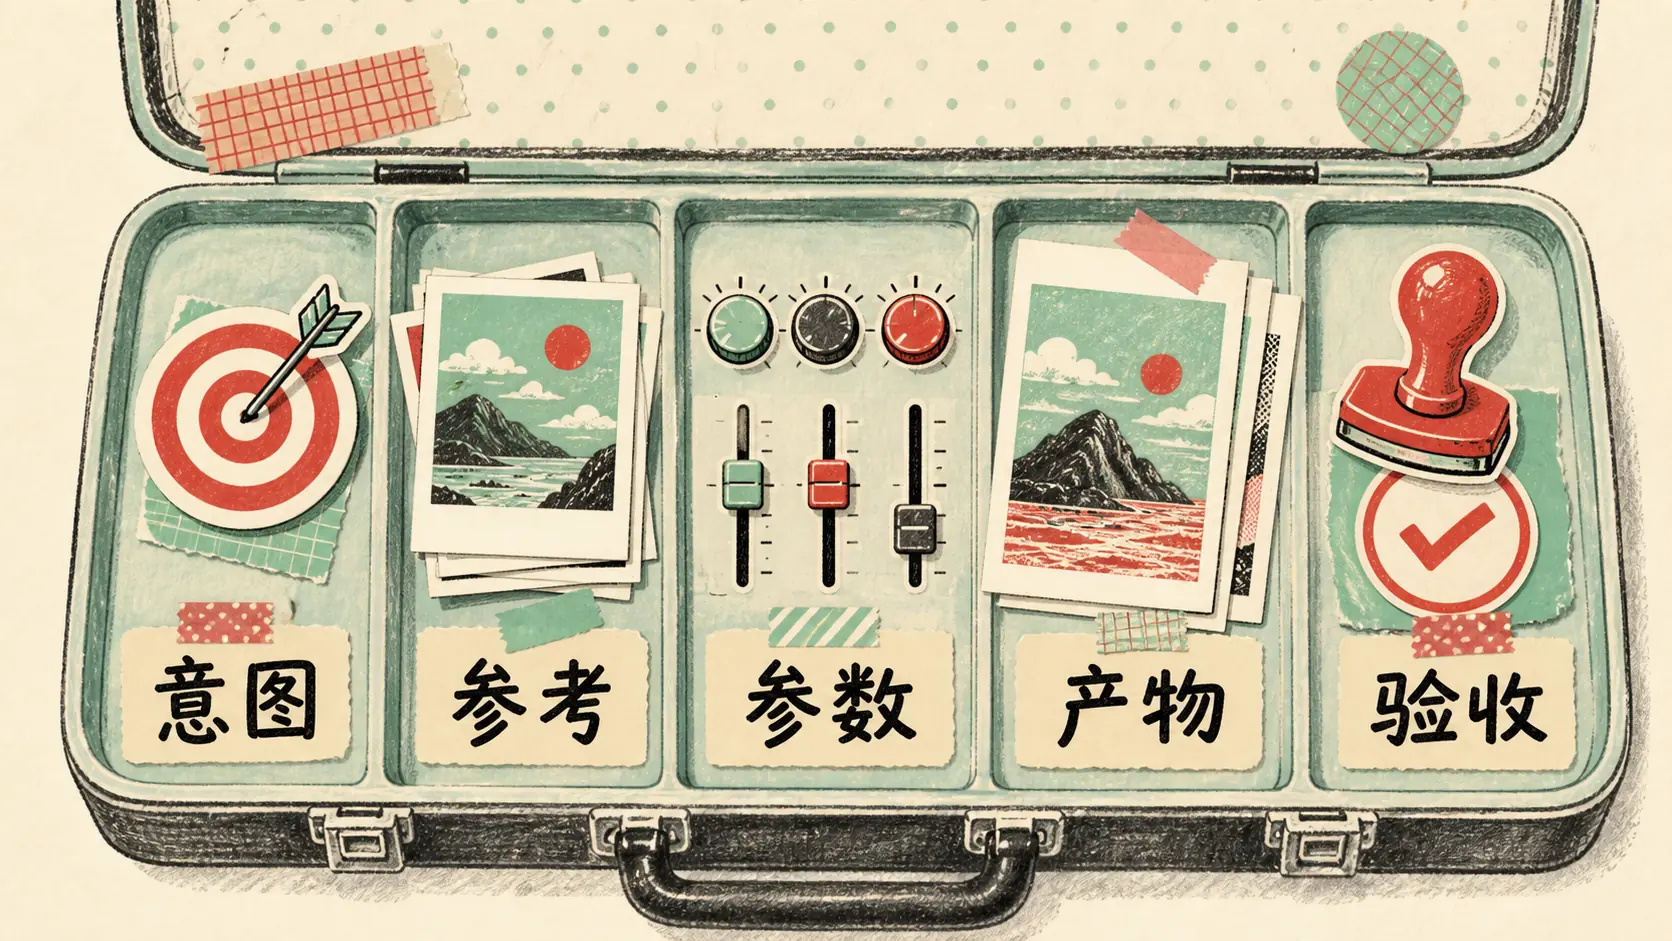
更实用的模型应该围绕任务:
ts
type CreativeJob = {
  intent: Intent;
  references: Reference[];
  settings: GenerationSettings;
  artifacts: Artifact[];
  checks: CheckResult[];
  status: JobStatus;
};
Reference 必须有语义角色
"上传了三张图"不是足够的信息。系统至少要知道:
ts
type ReferenceRole =
  | "subject"
  | "style"
  | "composition"
  | "start_frame"
  | "end_frame";

type Reference = {
  uri: string;
  sha256: string;
  role: ReferenceRole;
  weight?: number;
};
这样换 UI、换模型或让另一个 Agent 接手时,参考关系不会依赖"上传顺序"这种隐含状态。
Settings 需要快照,不能相信默认值
如果 Relax 会切回 Fast、个性化关闭后仍然生效,Prompt 没变也解释不了结果差异。
因此每次生成都应该记录解析后的有效设置,而不是只记录用户点击过什么:
json
{
  "requested": { "speed": "relax" },
  "effective": {
    "model": "pinned-version",
    "speed": "relax",
    "personalization": false,
    "aspectRatio": "16:9"
  }
}
effective 才是复现和排障的依据。
Artifact 要有血缘关系
一次生成可能产生四个候选,选中一个后放大、重绘文字、裁切成多个平台尺寸。每个文件都应该知道它从哪里来:
ts
type Artifact = {
  id: string;
  uri: string;
  parentId?: string;
  operation: "generate" | "upscale" | "edit" | "crop";
  checksum: string;
  approved: boolean;
};
正确文件名只是入口,真正有用的是稳定 ID、父子关系和校验值。
用状态机连接生成与发布
text
DRAFT -> GENERATED -> REVIEWED -> APPROVED -> PREFILLED -> PUBLISHED外部副作用只允许从批准状态继续。发布工具拿到的是 approved artifact,不是"对话里最后一张图"。
这条边界对多 Agent 很重要:创作 Agent 可以继续探索,发布 Agent 只消费确定版本,两者不会互相覆盖状态。
Tipkay 里的对应取舍
我们在 Tipkay 里把岗位、资料、Skill/MCP 和交付动作分开。创作岗位可以使用品牌资料与素材,博客发布岗位接收确认后的稿件和图片,再处理平台字段与页面回读。关键操作继续保留用户确认。
这不是为了让系统看起来有更多 Agent,而是减少隐含状态。每个岗位知道自己读取什么、交付什么、失败后从哪里恢复。
最后
模型输出天然带有随机性,但系统工程不应把随机性扩散到设置、素材、文件和发布记录。
Prompt 是输入。CreativeJob 才是可以继续工作的对象。
官方资料: