摘要:本文从 UDF/UDAF/UDTF 三大函数类型、两种注册方式、弱类型 vs 强类型 UDAF、Aggregator 生命周期、性能陷阱五个维度,配合 2 张架构图 + 完整代码,彻底掌握 SparkSQL 自定义函数实现。
关键词:UDF, UDAF, UDTF, Aggregator, functions.udf, spark.udf.register
一、三大函数类型
css
UDF  一对一: 1 行 → 1 行   (name → UPPER(name))
UDAF 多对一: N 行 → 1 行   (多行 → SUM/AVG)
UDTF 一对多: 1 行 → N 行   (一行 → explode 多行)
二、函数分类 & 注册
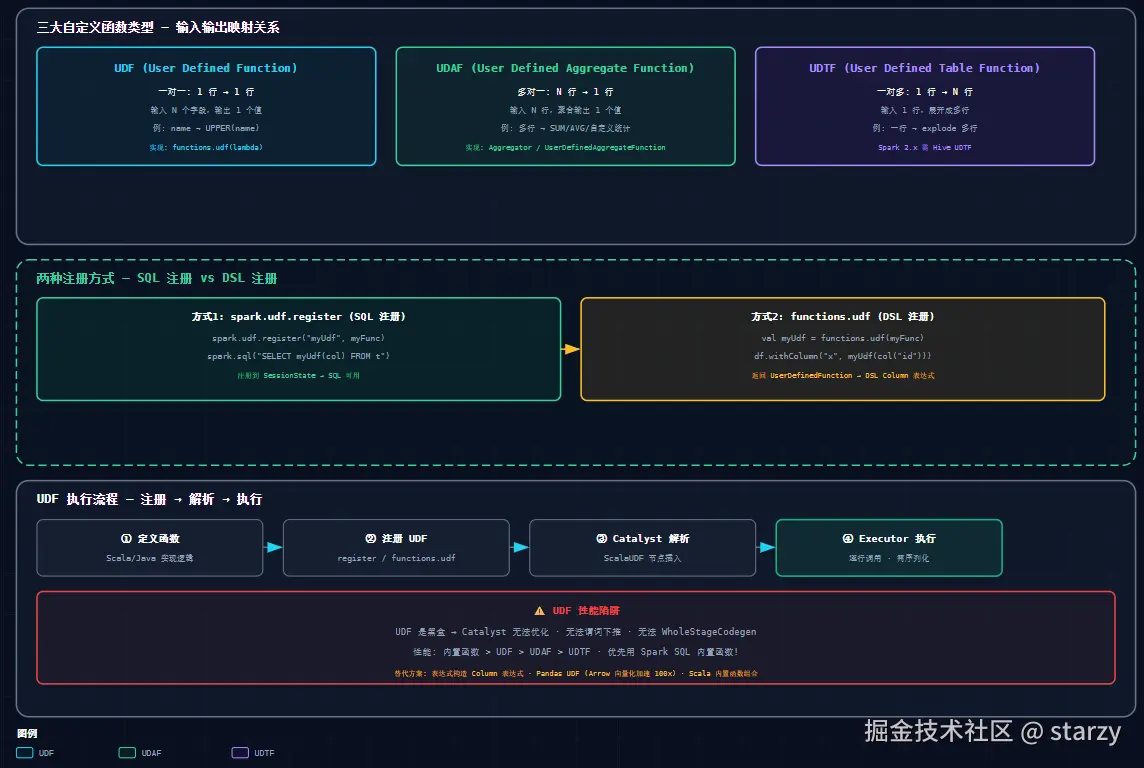
UDF 两种注册方式
scala
import org.apache.spark.sql.functions._

// SQL 注册
spark.udf.register("myUpper", (s: String) => s.toUpperCase)
spark.sql("SELECT myUpper(name) FROM users")

// DSL 注册
val myUpperUdf = udf((s: String) => s.toUpperCase)
df.withColumn("upper_name", myUpperUdf(col("name")))
三、UDAF 深度对比 & Aggregator 生命周期
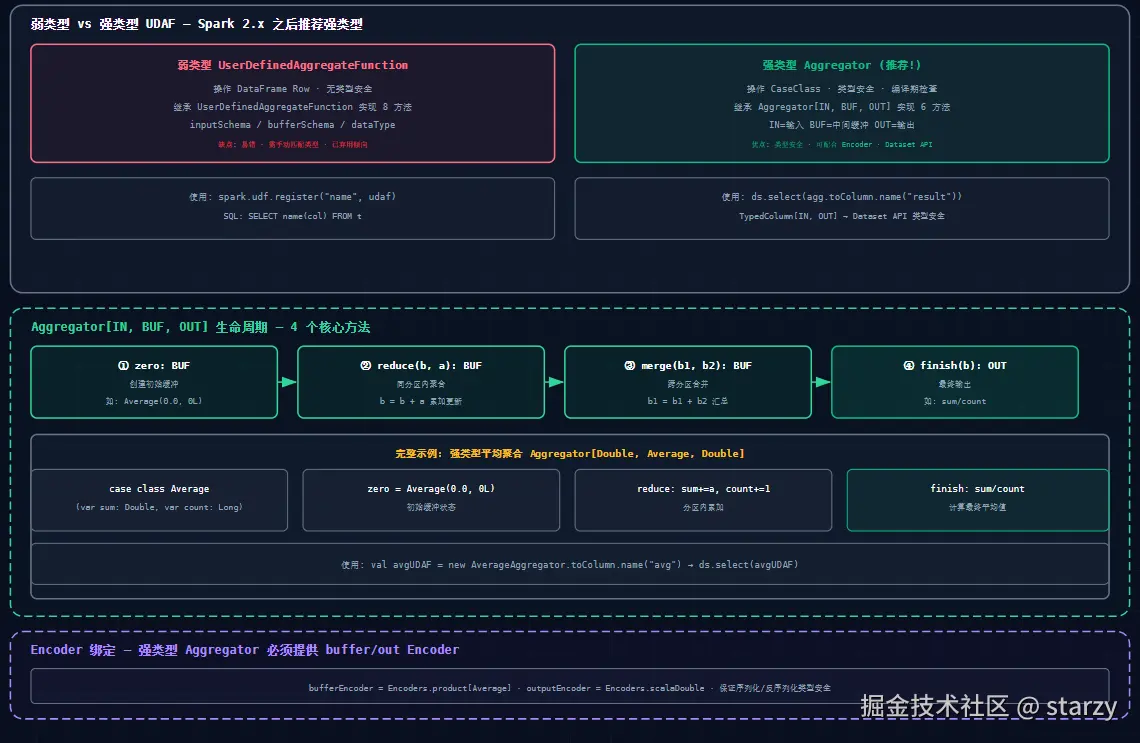
强类型 Aggregator(推荐)
scala
import org.apache.spark.sql.expressions.Aggregator

case class Average(var sum: Double, var count: Long)

object AverageAggregator extends Aggregator[Double, Average, Double] {
  def zero: Average = Average(0.0, 0L)                    // 初始缓冲
  def reduce(b: Average, a: Double): Average = { b.sum += a; b.count += 1; b } // 分区内
  def merge(b1: Average, b2: Average): Average = { b1.sum += b2.sum; b1.count += b2.count; b1 } // 跨分区
  def finish(reduction: Average): Double = reduction.sum / reduction.count // 输出
  def bufferEncoder: Encoder[Average] = Encoders.product
  def outputEncoder: Encoder[Double] = Encoders.scalaDouble
}

val avgUDAF = AverageAggregator.toColumn.name("avg_score")
ds.select(avgUDAF).show()
弱类型 UserDefinedAggregateFunction
scala
class MyAvgUDAF extends UserDefinedAggregateFunction {
  def inputSchema = StructType(StructField("input", DoubleType) :: Nil)
  def bufferSchema = StructType(StructField("sum", DoubleType) :: StructField("count", LongType) :: Nil)
  def dataType = DoubleType
  def deterministic = true
  def initialize(buffer: MutableAggregationBuffer) = { buffer(0) = 0.0; buffer(1) = 0L }
  def update(buffer: MutableAggregationBuffer, input: Row) = { /* 累加 */ }
  def merge(b1: MutableAggregationBuffer, b2: Row) = { /* 合并 */ }
  def evaluate(buffer: Row) = buffer.getDouble(0) / buffer.getLong(1)
}
spark.udf.register("myAvg", new MyAvgUDAF)
四、性能陷阱与最佳实践
markdown
⚠️ UDF 是黑盒 → Catalyst 无法优化
  · 无法谓词下推 · 无法 WholeStageCodegen · 逐行序列化调用

✅ 优化建议:
  1. 优先用 Spark SQL 内置函数
  2. 复杂逻辑用 Scala 表达式组合
  3. 必须用 UDF → Pandas UDF (Arrow 向量化, 快 100x)
  4. UDAF 优先用强类型 Aggregator
五、总结
- 分类:UDF 一对一 / UDAF 多对一 / UDTF 一对多
- 注册:SQL 用 register,DSL 用 functions.udf
- UDAF:强类型 Aggregator 优于弱类型 UDAF
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践