当每个 Agent Skill 都在构建记忆层,记忆就已经成为 Runtime 基础设施
当许多 Agent Skill 都在独立重建存储、来源追踪、校验、上下文加载和降级逻辑时,这些机制其实已经跨过了一条架构边界:领域语义应该留在 Skill 中,确定性的知识访问应该进入 Runtime。
Agent Skill 内部隐藏的重复建设问题
一个招聘 Skill,最初可能只是负责筛选简历。
接着,它开始需要候选人的历史记录。项目开发 Skill 需要过去的需求与决策。学习 Skill 则需要保存那些不应随着当前对话结束而消失的学习进度。
很快,每个 Skill 都长出了自己的存储路径、来源追踪规则、上下文加载器、隐私过滤、校验和降级逻辑。
它们的业务流程各不相同,但重复建设的基础设施却几乎一样。
这种重复暴露出了一条架构边界:
领域语义应该留在 Skill 中,确定性的知识访问应该进入 Runtime。
这并不是在主张构建一个包办一切的巨型 Agent 框架。它是一个范围更窄的系统论点:当许多 Skill 都在独立重建同一套记忆机制时,这套机制就已经成为 Runtime 基础设施。
真正的边界是所有权
最重要的问题,不是某个函数恰好在哪里实现,而是谁拥有这个函数所代表的含义。
一个招聘 Skill 应该负责判断:
- 什么是候选人、职位档案或筛选报告;
- 哪些证据与当前招聘任务相关;
- 哪些内容值得长期保留;
- 某位候选人是否应该进入下一环节。
Knowledge Runtime 不应该替它做这些判断。
Runtime 应该负责那些需要在不同领域中保持一致的机制:
- 配置与作用域解析;
- 声明式的记录与上下文契约;
- 有边界的上下文加载;
- 来源登记与 checksum;
- 路径边界校验;
- 原子写入以及受策略约束的写入;
- 明确的不可用、拒绝或降级状态。
Skill 按照领域需求请求上下文,Runtime 校验请求并返回一个有边界的上下文包,最终仍由 Skill 判断这些上下文意味着什么。
这种划分可以让共享层保持足够小。如果 Runtime 开始判断什么是优秀候选人、什么是有效部署,或者什么是有意义的学习里程碑,那么它就不再是可复用的基础设施,而是悄悄吸收了领域策略。
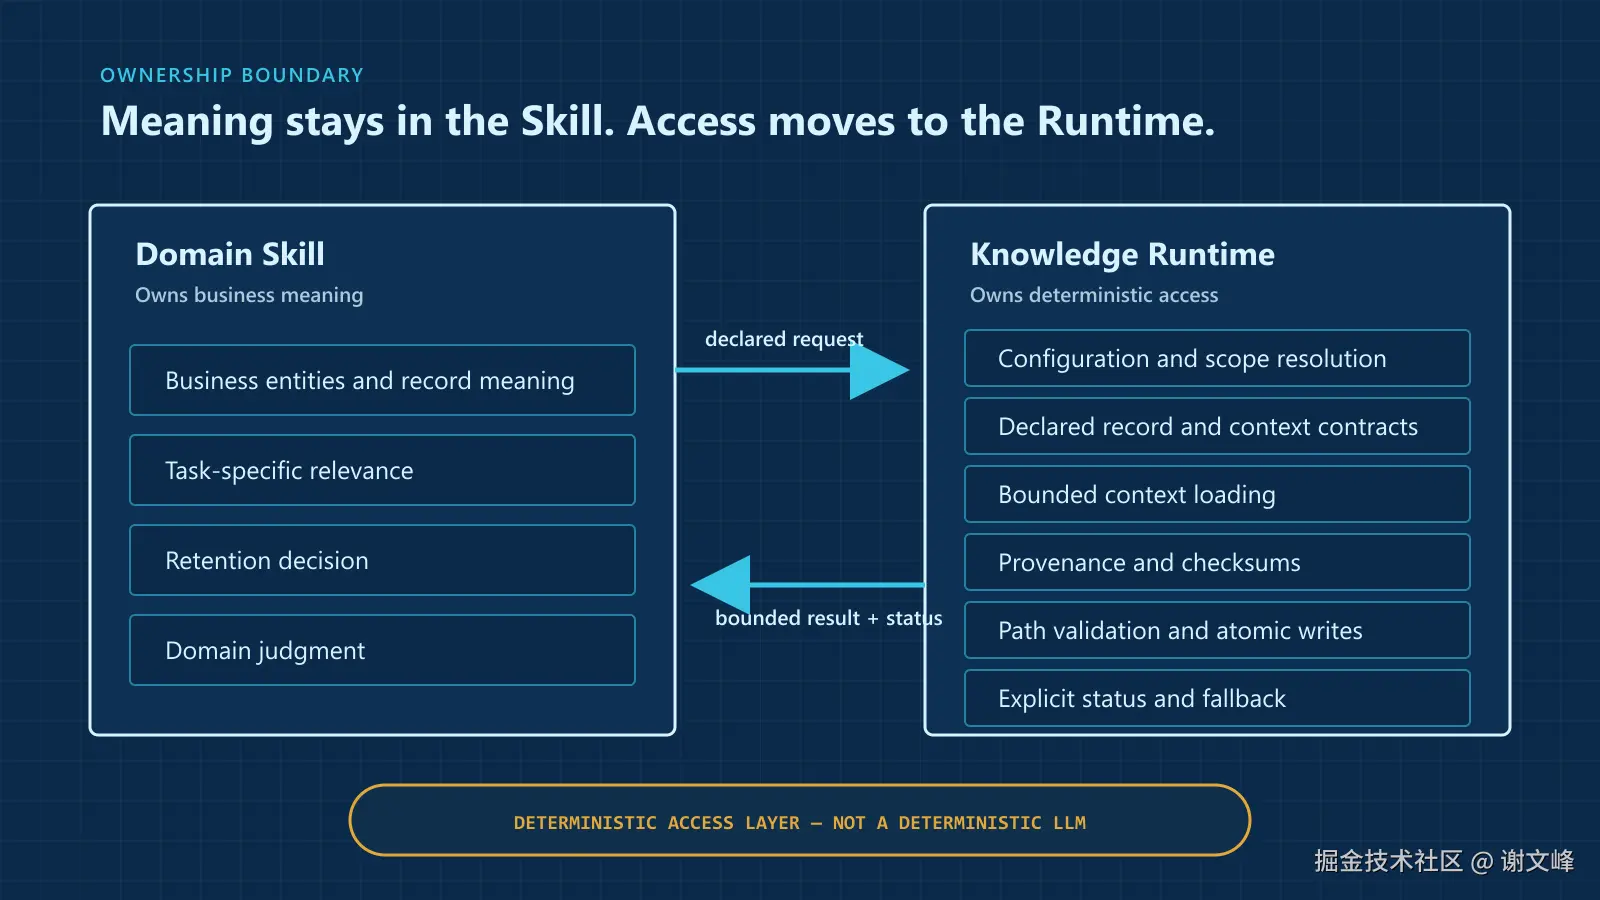
图 1:Skill 拥有业务含义与领域判断;Runtime 拥有确定性的访问契约、来源追踪、校验、存储安全和明确降级。"确定性"修饰的是访问层,而不是 LLM。
"确定性"不是在描述模型
这里很容易发生一种概念混淆。
目标不是让 LLM 变成确定性的系统,而是让围绕 LLM 的系统可以被检查、被测试。
当作用域、profile、记录类型和查询契约都已经声明后,访问层就应该以可预测的方式解析配置。它应该拒绝知识库根目录之外的路径。除非契约明确允许,否则原始资料不应进入普通上下文。当后端缺失或处于不健康状态时,它应该返回清晰的状态。
模型仍然可以进行概率式推理。Runtime 所约束的是:哪些数据能够进入这次推理,哪些持久化结果可以写到哪里,以及系统如何报告失败。
这条边界对企业 Agent 很有价值,因为很多运行问题并不是"模型具有随机性",而是更加普通的工程问题:错误的文件进入了上下文,某个来源丢失了 provenance,两个 Skill 写出了不兼容的格式,或者缺失的后端被悄悄伪装成一次成功读取。
这些都是基础设施问题。
这套架构是抽取出来的,不是预先设计出来的
这条边界并不是从一张自上而下的平台架构图开始的。
Project Developer Copilot(PDC)原本就有一套内嵌的 LLM Wiki,用于管理项目需求、工作上下文、决策和交接记录。另一条线上,obsidian-llm-wiki 围绕已有知识库逐渐形成了受控的初始化、摄取、诊断、维护和查询流程。
长期使用这两类方案之后,一批反复出现的基础设施问题逐渐显现出来:安全的来源处理、配置发现、有边界的上下文、持久记录、校验以及可预测的降级。
llm-wiki-runtime 正是从这些经验中抽取出的独立、可复用基础层。
这段历史很重要。PDC 和 llm-wiki-runtime 不是两个相互连接的 Runtime。PDC 原本就有自己的内嵌 Wiki 方案。PDC 与 obsidian-llm-wiki 提供了实践经验,独立 Runtime 的架构边界由此逐渐形成。
这种自下而上的路径,没有先发明一套完整平台那么漂亮,但它更加诚实:每一个被抽取出来的抽象,都必须能够指向真实工作流中已经出现的问题。
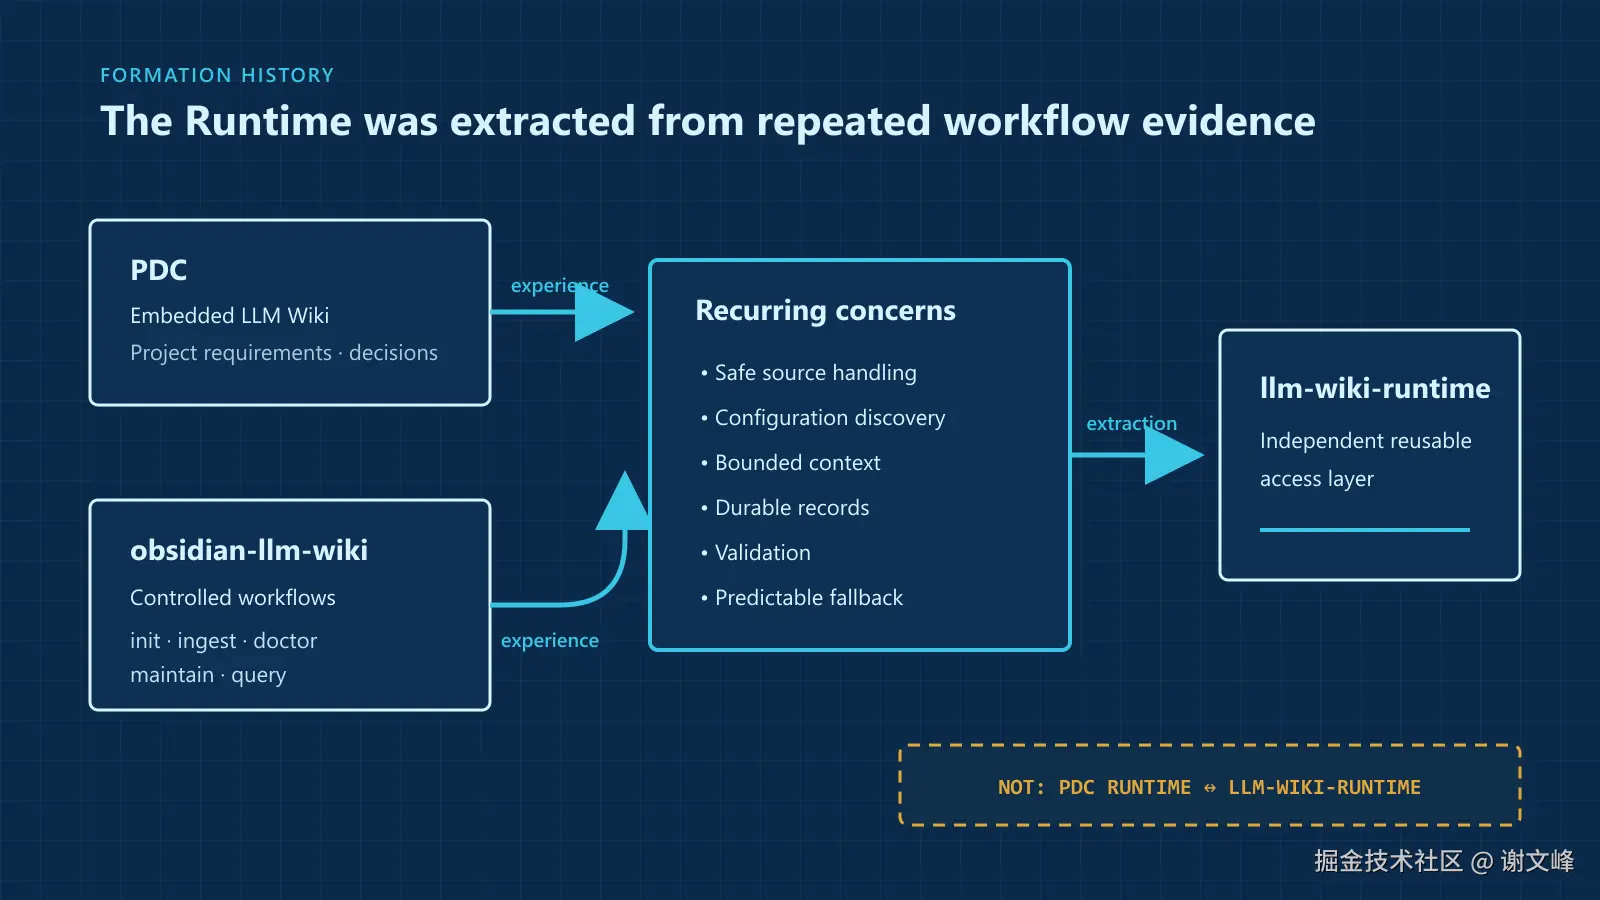
图 2:PDC 的内嵌 Wiki 与 obsidian-llm-wiki 的受控工作流暴露了反复出现的基础设施问题。这些经验促成了 llm-wiki-runtime 的抽取;图中表达的是证据与架构形成过程,而不是两个 Runtime 的连接关系。
当前 Runtime 实际做了什么
固定版本的公开实现提供了一个面向 Agent Skill 与各类 Copilot 的本地确定性访问层。
当前能力包括:领域 profile 快照、路径边界校验、带 checksum 的来源注册表、受控写入模式、带 include/exclude 过滤器的上下文包、Skill Context Protocol(SCP)发现、跨领域读取策略、原子写入,以及结构化的降级状态。
整个集成由三类契约组织起来:
scp.yml声明一个业务 Skill 如何参与:它所属的领域、profile、信任等级、查询依赖、产出记录和降级行为。llm-wiki-profile.yml定义由领域拥有的路径、记录类型、上下文规则和写入模式。- Runtime CLI 负责配置解析、校验、读取与写入。
启用后的工作流可以保持得很简单:
解析配置 → 加载窄范围上下文 → 执行原有领域流程 → 判断什么值得持久化 → 通过 Runtime 摄取
如果 Wiki 被禁用、缺失或处于不健康状态,原有的领域流程仍然应该继续运行。
这种可选性是一项架构属性,而不是无关紧要的错误处理细节。可复用的知识层不应该变成一个隐藏的硬依赖,进而让所有采用它的 Skill 都可能因为它而停止工作。
因此,Runtime 更接近一个本地知识控制平面,而不是自主 Agent 框架。它负责治理访问与持久化,但不负责规划用户的工作,也不提供领域业务含义。
HR Agent Copilot 对这条边界进行了测试
第一个具体的边界测试来自 HR Agent Copilot。
它的三个子 Skill 分别负责简历筛选、候选人详情报告和面试问题生成。每个子 Skill 都保留原有的招聘流程,同时声明自己如何接入共享知识层。
职责划分可以直接从实现中看到:
- HR 定义
candidate_profile、job_profile、jd_version和screening_report的含义。 - Runtime 校验已经声明的路径与记录类型。
- 原始来源默认不会进入普通上下文。
- 候选人查询只返回契约中声明的有限字段。
- 如果 Runtime 不可用,Skill 会继续执行原有流程并报告降级状态,而不是假装上下文已经成功加载。
针对固定的公开修订版本,canonical research record 记录了两组聚焦测试:
- 7 个集成契约测试通过。 它们覆盖共享 profile 与契约、精确的子 Skill 路由、SCP 与降级声明、来源排除规则,以及候选人查询的最小返回字段。
- 1 个端到端候选人查询测试通过。 它覆盖确定性的
found、multiple_matches和not_found结果,同时验证未声明字段不会被返回。
这些是有价值的证据,但证据的边界必须说清楚。
这些测试说明预期的架构边界已经编码在实现中,并且可以复现。它们并不能证明招聘质量得到提升、延迟下降、生产可靠性提高或业务收益出现。
在个人使用中,这项集成的效果不错。但这只是使用观察,不是 benchmark。
不要让 Knowledge 变成 Trace 垃圾场
一旦共享 Runtime 出现,人们很容易继续扩大它的职责。
Knowledge、Trace、Eval 和 Controlled Loop 未来可能共同组成一套更完整的 Agent Runtime 架构,但它们的所有权与生命周期并不相同。
- Knowledge 是经过选择、准备在未来复用的内容。
- Trace 用于重建执行过程中发生了什么。
- Eval 根据证据与验收标准判断执行表现。
- Controlled Loop 提出变更建议、执行回归检查,并要求人工批准。
不能因为它们都会产生数据,就把它们塞进同一个 store。
它们需要不同的保留策略、信任边界、访问模式和失败处理方式。过早合并,只会用一个看似方便的 schema 掩盖这些差异。
在当前这条研究线上,只有本文描述的 Knowledge 边界已经实现并接受测试。Trace、Eval 与 Controlled Loop 仍然是后续研究方向,而不是已经完成的阶段。
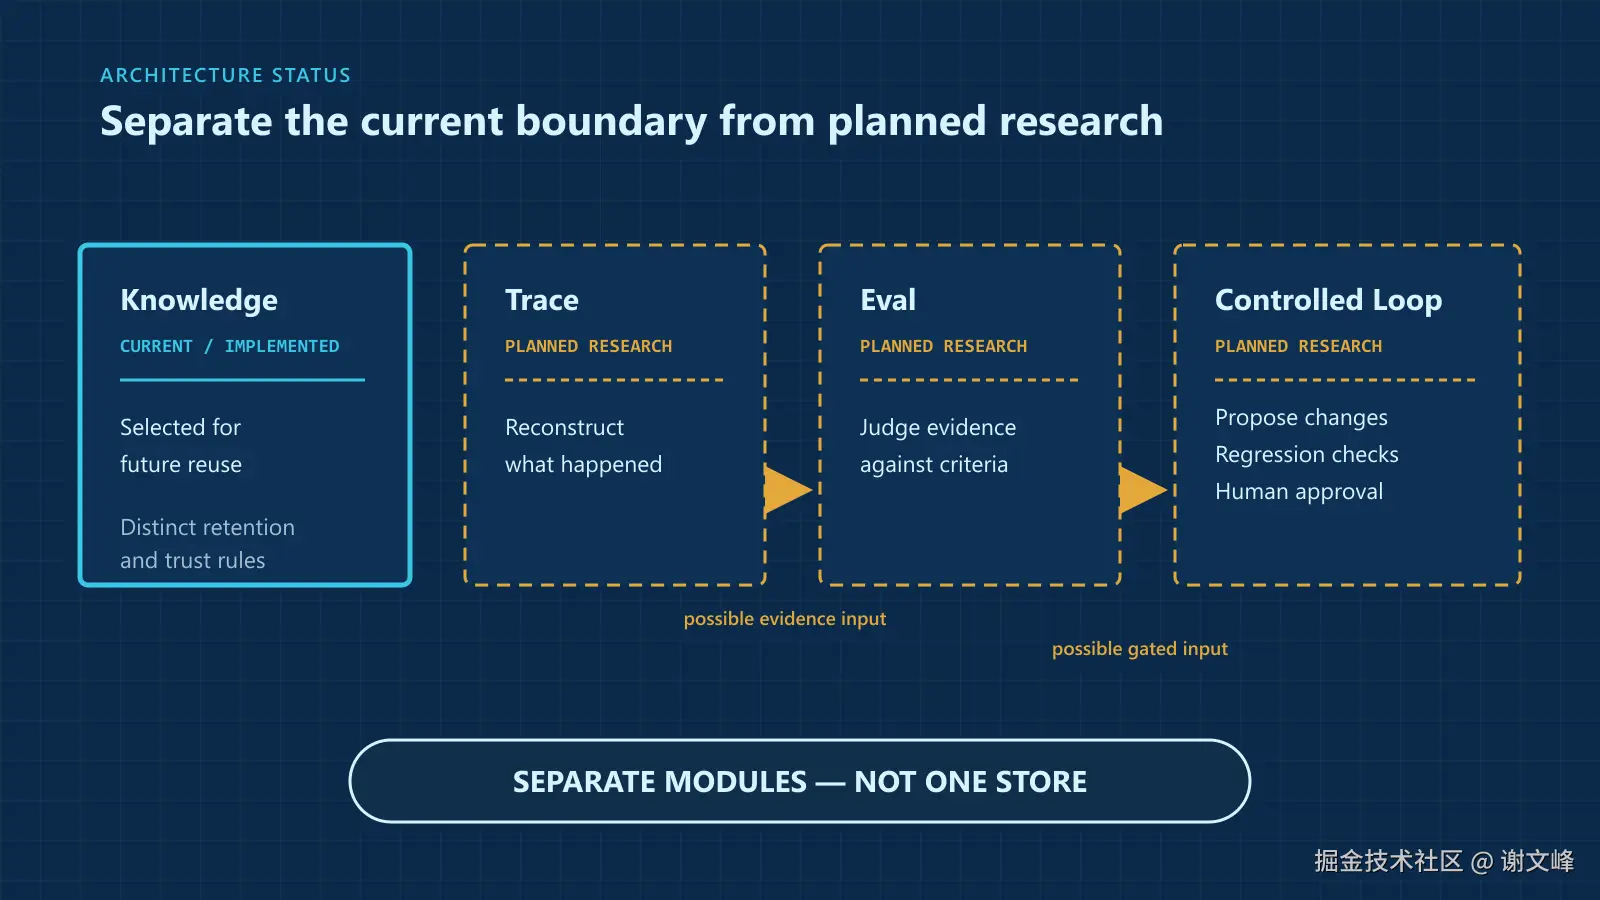
图 3:Knowledge 是当前已经实现的边界。Trace、Eval 与 Controlled Loop 仍是相互独立的计划研究模块;它们既不是已完成阶段,也不是一个共享 store。
下一步是一个证据选择
接下来至少有两条可信的路径。
第一条,是先把 Knowledge 边界集成到另外两三个领域 Skill 中,再进一步稳定协议。
第二条,是从具体调试失败中抽取最小可用的 Trace 契约:究竟需要重建哪一次运行、哪一个步骤、哪一次工具调用、哪一个批准、哪一次降级或哪一个产物?
Eval 应该建立在真实 Trace 与验收标准之上。Controlled Loop 的起点应该是:基于证据提出变更、执行回归检查并取得人工批准,而不是授予系统不受限制的自我修改能力。
我目前更倾向于抵制构建大型统一 Runtime 的诱惑。
让每个模块独立有用;从真实的企业工作流中抽取它;只有当模块的所有权边界在不止一个领域中经受住验证之后,再考虑组合它们。
目标不是在证据出现之前,先发布一套宏大的架构。
目标是积累足够多的工作证据,让这套架构通过证据赢得自己的适用范围。
对于 Agent 与 AI Infra 开发者来说:你会把这条边界画在哪里?在你愿意把知识访问视为 Runtime 基础设施,而不是每个 Skill 内部的一个功能之前,你需要看到哪些证据?
相关项目
llm-wiki-runtime固定于1ebcb04- Project Developer Copilot(PDC)固定于
15f634f obsidian-llm-wiki固定于6d200fd
研究与测试证据
- Canonical research note:Domain Semantics in Skills, Deterministic Knowledge Access in the Runtime
- 边界测试:HR Agent Copilot 固定于
15f634f