关键词:多语言OCR、英文OCR、日文OCR、韩文OCR、小语种OCR、OCR识别
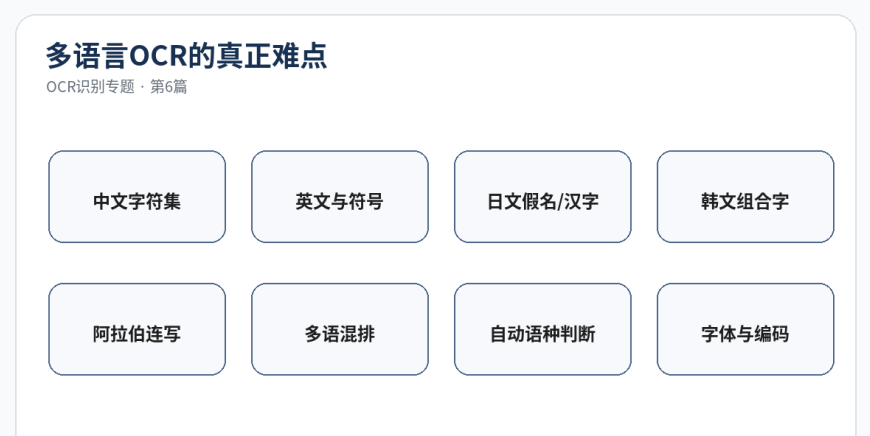
图:多语言OCR的真正难点
全球化业务中,多语言OCR识别越来越常见。外贸单据、护照、物流标签、海外合同、产品说明书和历史档案,都可能同时包含中文、英文、日文、韩文、阿拉伯文、西班牙文、越南文等多种语言。很多OCR产品会宣传"支持几十种甚至上百种语言",但"支持"并不等于"在你的文档上识别得好"。
一、多语言OCR首先是字符集问题
中文本身就包含大量常用字、生僻字、繁体字和异体字;日文同时包含汉字、平假名、片假名;韩文采用组合音节;阿拉伯文存在连写和书写方向问题。不同语言的字符结构差异很大,因此单一模型要覆盖所有语言,需要更大的字符集和更复杂的训练数据。
用户提供的测试报告中特别比较了阿拉伯文、韩文、葡萄牙文、日文、西班牙文和越南文,每种语言使用1000个样本。报告记录的结果显示,SDK15在这六种语言的字符识别率上均高于当时参与比较的PaddleOCR,其中韩文和阿拉伯文差距更明显。这个案例说明,多语言OCR不能只看"语言数量",还要看每个语种的真实准确率。
二、自动识别语种方便,但也可能带来误判
有些OCR系统要求用户手动指定语言,优点是模型目标明确、识别稳定;有些大模型OCR支持自动判断语种,使用更方便。但当文档中只有少量字符、字体特殊或多语混排时,自动语种判断可能出错。
例如数字"0"和字母"O"、拉丁字母与某些小语种字符、中文汉字与日文汉字,都可能在视觉上相似。模型如果先判断错语种,后面的字符识别就会受到影响。因此企业要根据业务选择:固定语种场景可以手动指定,多国家混合场景再考虑自动识别。
三、多语混排比单语识别更难
真实文件经常出现"中文标题 + 英文公司名 + 数字型号 + 特殊符号"的组合。一张进口设备铭牌可能包含英文、德文、数字和单位;一份国际合同可能中英对照;护照和签证又包含拉丁字母与本地语言。
多语混排要求OCR模型在同一行甚至同一个字段内切换字符体系。如果系统采用多个独立语言模型,就需要正确分流;如果采用统一大模型,就需要保证不同语种训练数据足够均衡。
四、生僻字和特殊符号是企业经常忽略的点
企业档案、户籍、医疗和古籍场景中,生僻字非常关键。测试报告中也单独测试了生僻字、上下角标和特殊字符,并指出不同模型字符集覆盖存在差异。一个系统即使常用中文达到99%以上,对人名中的生僻字识别不好,也可能无法进入人口、银行或保险业务。
因此POC时应专门建立"生僻字集""单位符号集""上下标集"和"特殊字符集",不要只用普通新闻文字测试。
五、部署场景同样影响多语言选择
如果企业需要离线、内网或国产化部署,就要关注多语言模型大小、CPU/GPU要求和授权方式。文通OCR识别系统这类专业OCR产品通常提供多语言和SDK形态,适合固定业务系统集成;大模型OCR则更适合需要自动语言理解和复杂文档解析的场景。
多语言OCR的选择标准不是"支持多少种",而是"我的核心语种是否准确、混排是否稳定、生僻字符是否覆盖、部署成本是否可接受"。把这四个问题测清楚,比一张长长的语种支持列表更重要。