给视频换一条音轨------比如重录了旁白要替换原来的声音------很多人的第一反应是「这得重新导出整个视频吧?画质肯定要受损」。其实不用。视频文件是一个容器,视频流和音频流是分开存放的,替换音轨只需要在容器层面操作,视频流可以一个字节都不动。
这篇文章把替换音轨的三个关键技术点讲清楚,帮你理解为什么「换声音」可以是无损的。
关键一:容器是皮,流是馅------替换只动皮不动馅
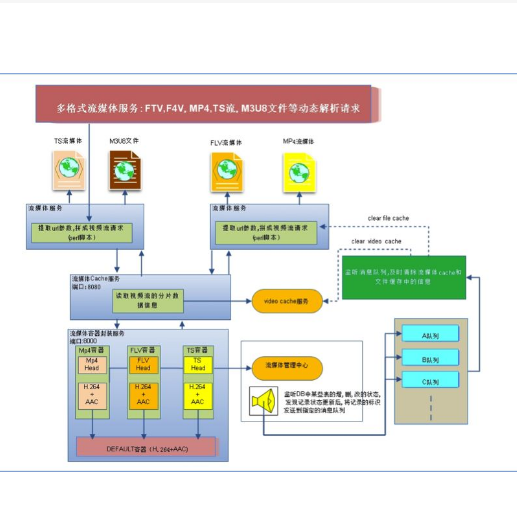
常见的视频文件格式(MP4、MKV、MOV、AVI)本质上都是容器(container)。容器像一个盒子,里面装着多条流(stream):一条视频流、一条或多条音频流、可能的字幕流和元数据。
视频流和音频流在容器里是独立编码、独立存储的。替换音轨的本质是:把容器里原来的音频流删掉,把新的音频流放进去,视频流原封不动。
用 FFmpeg 做这个操作只需要一行命令:
ffmpeg -i input.mp4 -i new_audio.wav -c:v copy -c:a aac -b:a 192k -map 0:v:0 -map 1:a:0 output.mp4
这里 `-c:v copy` 的意思是视频流直接拷贝,不重新编码。整个过程中视频数据只是从输入文件读出来、写进输出文件,没有任何解码-再编码的过程。画质完全不损失。
唯一被重新编码的是音频流(`-c:a aac`),因为新的音频文件(比如 WAV)需要转成容器支持的编码格式(AAC)。这只影响音频,不影响画面。
所以回答标题的问题:换原声不需要重新压缩视频,只需要重新封装(re-muxing)。整个过程几秒钟就能完成,比重新导出快几十倍。
关键二:音轨映射决定新音频替换哪一条
`-map` 参数是替换音轨的核心,但很多初学者忽略它,结果替换出来的文件带着两条音轨------旧的声音和新的声音叠在一起。
FFmpeg 的 `-map` 参数告诉它从哪个输入文件取哪条流:
-map 0:v:0 # 从第 0 个输入文件(input.mp4)取第 0 条视频流
-map 1:a:0 # 从第 1 个输入文件(new_audio.wav)取第 0 条音频流
如果不写 `-map`,FFmpeg 默认会从每个输入文件各取一条「最好的」流。当 input.mp4 自带一条音轨、new_audio.wav 又有一条音轨时,输出文件就会包含两条音频流------旧的原声和新的录音都在里面。
播放时默认播放第一条音轨(通常是旧的),听起来就像没换一样。很多「替换音轨失败」的案例,根因就是漏了 `-map`。
还有一个容易踩的坑:MP4 容器对多音轨的支持有限。 大多数播放器和平台只认第一条音轨。如果你输出的是 MKV 格式,多音轨没问题;但 MP4 场景下最好确保输出文件只有一条音轨。
关键三:时间戳对齐------音画不同步的根因
替换了音轨,结果声音比画面快了一秒或慢了半秒,这是替换音轨时最常见的问题。根因是时间戳(timestamp)不对齐。
视频文件里每条流都有自己的时间戳:
• PTS(Presentation Time Stamp):这一帧应该在什么时刻被显示/播放
• DTS(Decoding Time Stamp):这一帧应该在什么时刻被解码
新录制的音频文件从 0 秒开始,但如果原视频的音轨不是从 0 秒开始的(比如片头有 1.5 秒的黑屏静音),直接替换就会导致新音频从视频开头就播放,而原音轨本该在 1.5 秒后才开始。
解决方法是用 `-itsoffset` 或 `-ss` 参数调整新音频的起始时间:
新音频延迟 1.5 秒开始
ffmpeg -i input.mp4 -itsoffset 1.5 -i new_audio.wav \
-c:v copy -c:a aac -map 0:v:0 -map 1:a:0 output.mp4
或者,如果新音频太长需要截断对齐视频时长:
音频和视频都截取到最短的时长
ffmpeg -i input.mp4 -i new_audio.wav \
-c:v copy -c:a aac -map 0:v:0 -map 1:a:0 -shortest output.mp4
`-shortest` 参数让输出文件的时长等于最短的那条流,防止音频比视频长导致的「视频结束了声音还在播」。
封装格式决定你能装几条音轨
最后补充一个实用知识:不同容器对多音轨的支持程度不同。
如果你做的是需要保留多语言配音的视频(比如教学视频有中文版和英文版旁白),MKV 是最安全的容器。如果最终要上传到视频平台(B 站、YouTube),它们通常只接受单音轨的 MP4。
对于只需要提取视频音轨做进一步处理的场景(比如先在线视频提取音频,做完降噪后再替换回去),整个流程也是无损的------提取是解封装(demuxing),替换是重封装(re-muxing),视频流全程不参与编解码。
理解了容器、映射和时间戳这三个概念,替换音轨就是一个 30 秒的操作,而不是一次重新导出。画质不变,效率提升几十倍。对于频繁需要替换旁白的视频创作者来说,这个知识点值回所有学习时间。