1、 问题
项目中对于以下这种语句写法比较常见
bash
select count(1) from test1 where c1 in ('A1','A2','A3')
and (pcode!='03' or status in (1,2) );
计划:
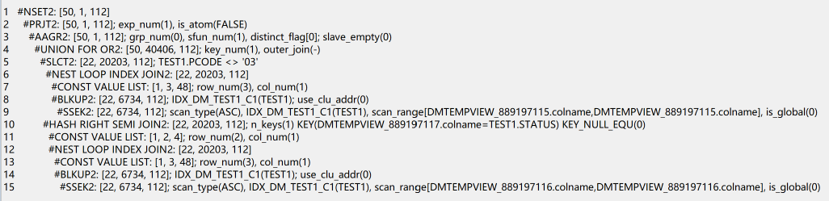
or条件是来自两个不同的列,此时受到optimizer_or_nbexp参数规则影响,做成union_for_or2计划,即拆分扫描两次合并结果集,我们可以看到union 两部分都是索引扫描,用的是c1列的索引,那么or条件合并一起做,肯定比分开快一倍。所以我们可以考虑调整optimizer_or_nbexp参数合并来优化。
bash
select /*+OPTIMIZER_OR_NBEXP(2)*/count(1) from test1 where c1 in ('A1','A2','A3')
and (pcode!='03' or status in (1,2) );
计划:
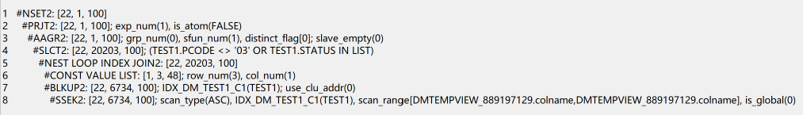
这里索引扫描就一次,达到优化效果。这种计划也可以通过case when写法来实现,即将or条件放入case when作为查询项后,最终作为查询条件去过滤。
2、改写
bash
select count(1) from (
select *,case when pcode!='03' or status in (1,2) then 1 else 0 end as flag
from test1 where c1 in ('A1','A2','A3')
) tt where tt.flag=1;
计划:
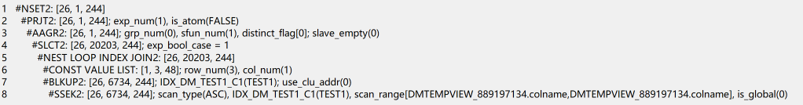
计划和结果都符合预期。
3、小结
像这种写法优化,是从减少扫描次数去考虑。不同列的or运算可以考虑用case when去合并优化。
4、测试数据
bash
create table test1(id varchar2(36) primary key,c1 varchar2(20),c2 varchar2(20),c3 varchar2(20),pcode varchar2(20),status int);
insert into test1 select sys_guid(),
'A'||to_char(round(dbms_random.value(1,100),0)),
'B'||to_char(round(dbms_random.value(1,1000),0)),
'C'||to_char(round(dbms_random.value(1,1000),0)),
'0'||to_char(round(dbms_random.value(1,9),0)),
round(dbms_random.value(1,5),0)
from dual connect by level<=800000;
commit;
create index IDX_DM_TEST1_C1 on test1(c1);
dbms_stats.gather_table_stats(USER,'TEST1',null,100);