如果内容分析服务的第一版接口长这样,后面通常会越来越难收拾:
ts
interface ReaderEvent {
  userId: string;
  contentId: string;
  channel: string;
  action: "view" | "like" | "collect";
  occurredAt: string;
  device?: string;
  region?: string;
}
它很灵活。Agent 可以按用户、设备、地区、时间随意切片,今天做选题复盘,明天做用户画像,后天再把原始轨迹塞进提示词。
问题也正在这里:一个服务原本只想回答"哪类文章值得继续写",却顺手获得了识别个人、拼接轨迹和跨用途使用数据的能力。对于人少、维护能力有限的小团队,这不是免费能力,而是一笔持续的安全与治理债务。
GitHub 在 2026 年 9 月 4 日发布了新的 Star history REST API endpoint。官方给出的能力是:返回带时间戳的历史 Star 数量,但不暴露具体 stargazer 身份。此前相关 stargazer 列表接口已收紧访问,用于保护用户隐私。
这里不讨论 GitHub 内部用了什么匿名化算法------官方资料没有这样说明。值得借鉴的是 API 边界:调用方要的是增长曲线,就给增长曲线,不必顺带给一份身份清单。
从输出开始设计,而不是从事件开始
先假设 Agent 最终只需要生成这种复盘:
json
{
  "pillar": "agent-architecture",
  "window": "72h",
  "samples": 6,
  "medianViews": 128,
  "medianCollections": 9,
  "confidence": "low",
  "note": "样本较少,仅用于下一轮选题"
}
它要比较内容支柱,需要文章维度的窗口快照;它要表达不确定性,需要样本数;它不需要任何一个读者的身份。
因此数据链路可以反过来设计:
text
Decision → Metric contract → Aggregate job → Ephemeral input而不是:
text
Collect everything → Store forever → Let Agent decide later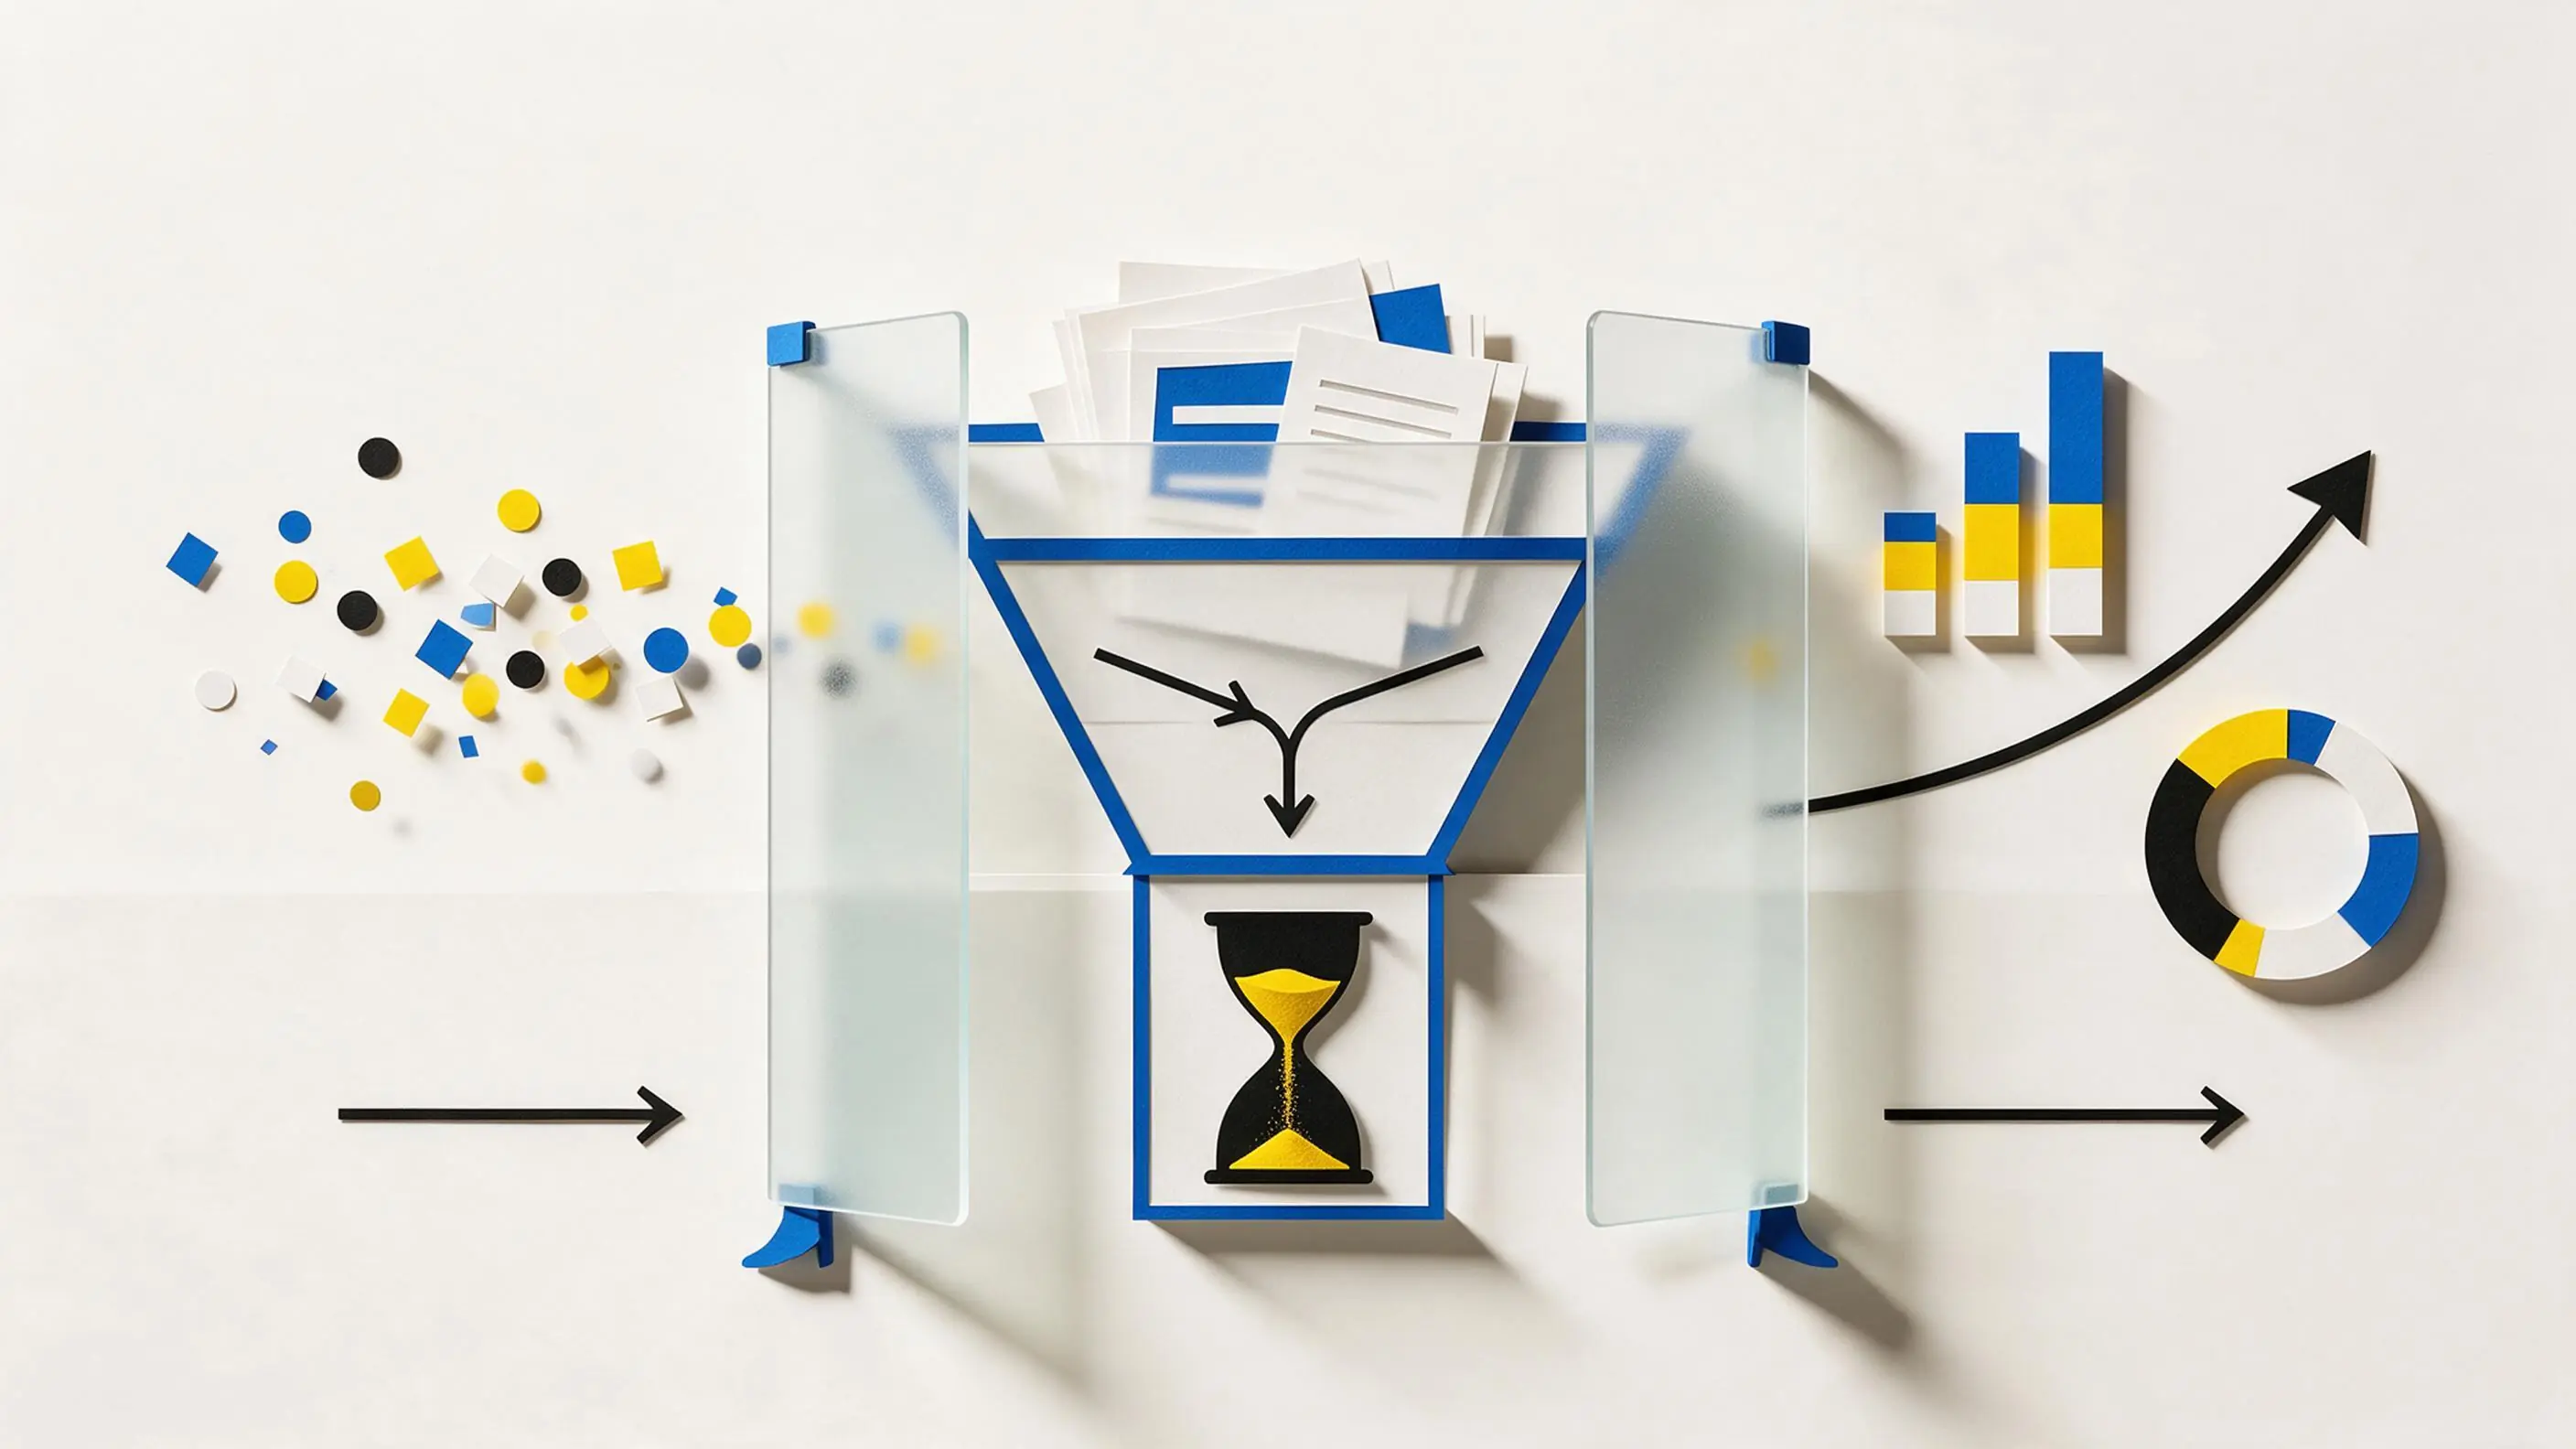
事件只是临时输入
如果平台或自有站点确实以事件形式提供数据,可以让事件只活在聚合窗口中:
ts
type EphemeralEvent = {
  eventId: string;
  contentId: string;
  channel: string;
  action: "view" | "like" | "collect" | "comment";
  occurredAt: string;
  expiresAt: string;
};

type MetricSnapshot = {
  contentId: string;
  channel: string;
  window: "24h" | "72h";
  windowEndsAt: string;
  sampledAt: string;
  status: "available" | "not_due" | "unavailable";
  values?: Partial<Record<EphemeralEvent["action"], number>>;
  schemaVersion: 1;
};
EphemeralEvent 没有 userId,因为这项决策根本用不到它。若另一个业务确实需要身份,应该新建带独立目的、权限和保留期的契约,而不是污染内容复盘服务。
聚合任务也不应该在窗口未结束时抢跑:
ts
function buildSnapshot(now: Date, endsAt: Date): MetricSnapshot["status"] {
  if (now < endsAt) return "not_due";
  return "available";
}
这行看似普通,却能挡住一种常见的数据污染:23 小时 48 分的当前总量,被自动化任务写成"24 小时数据"。
0 不是 unavailable
做跨平台内容复盘时,最危险的默认值可能就是 0。
一个平台公开显示 0 次收藏,是事实;页面没加载出来、指标暂不提供、登录过期导致取数失败,都不是 0。如果 schema 只允许数字,Agent 会把缺失当表现差,从而给出错误选题建议。
所以快照至少要保留状态和来源:
json
{
  "contentId": "post_xxx",
  "window": "24h",
  "status": "unavailable",
  "sampledAt": "2026-09-06T20:45:30+08:00",
  "source": "public_page",
  "reason": "metric_not_exposed"
}
这里的 reason 应该是白名单枚举,不要把 Cookie、页面正文或异常堆栈直接带给 Agent。
小样本必须允许"不回答"
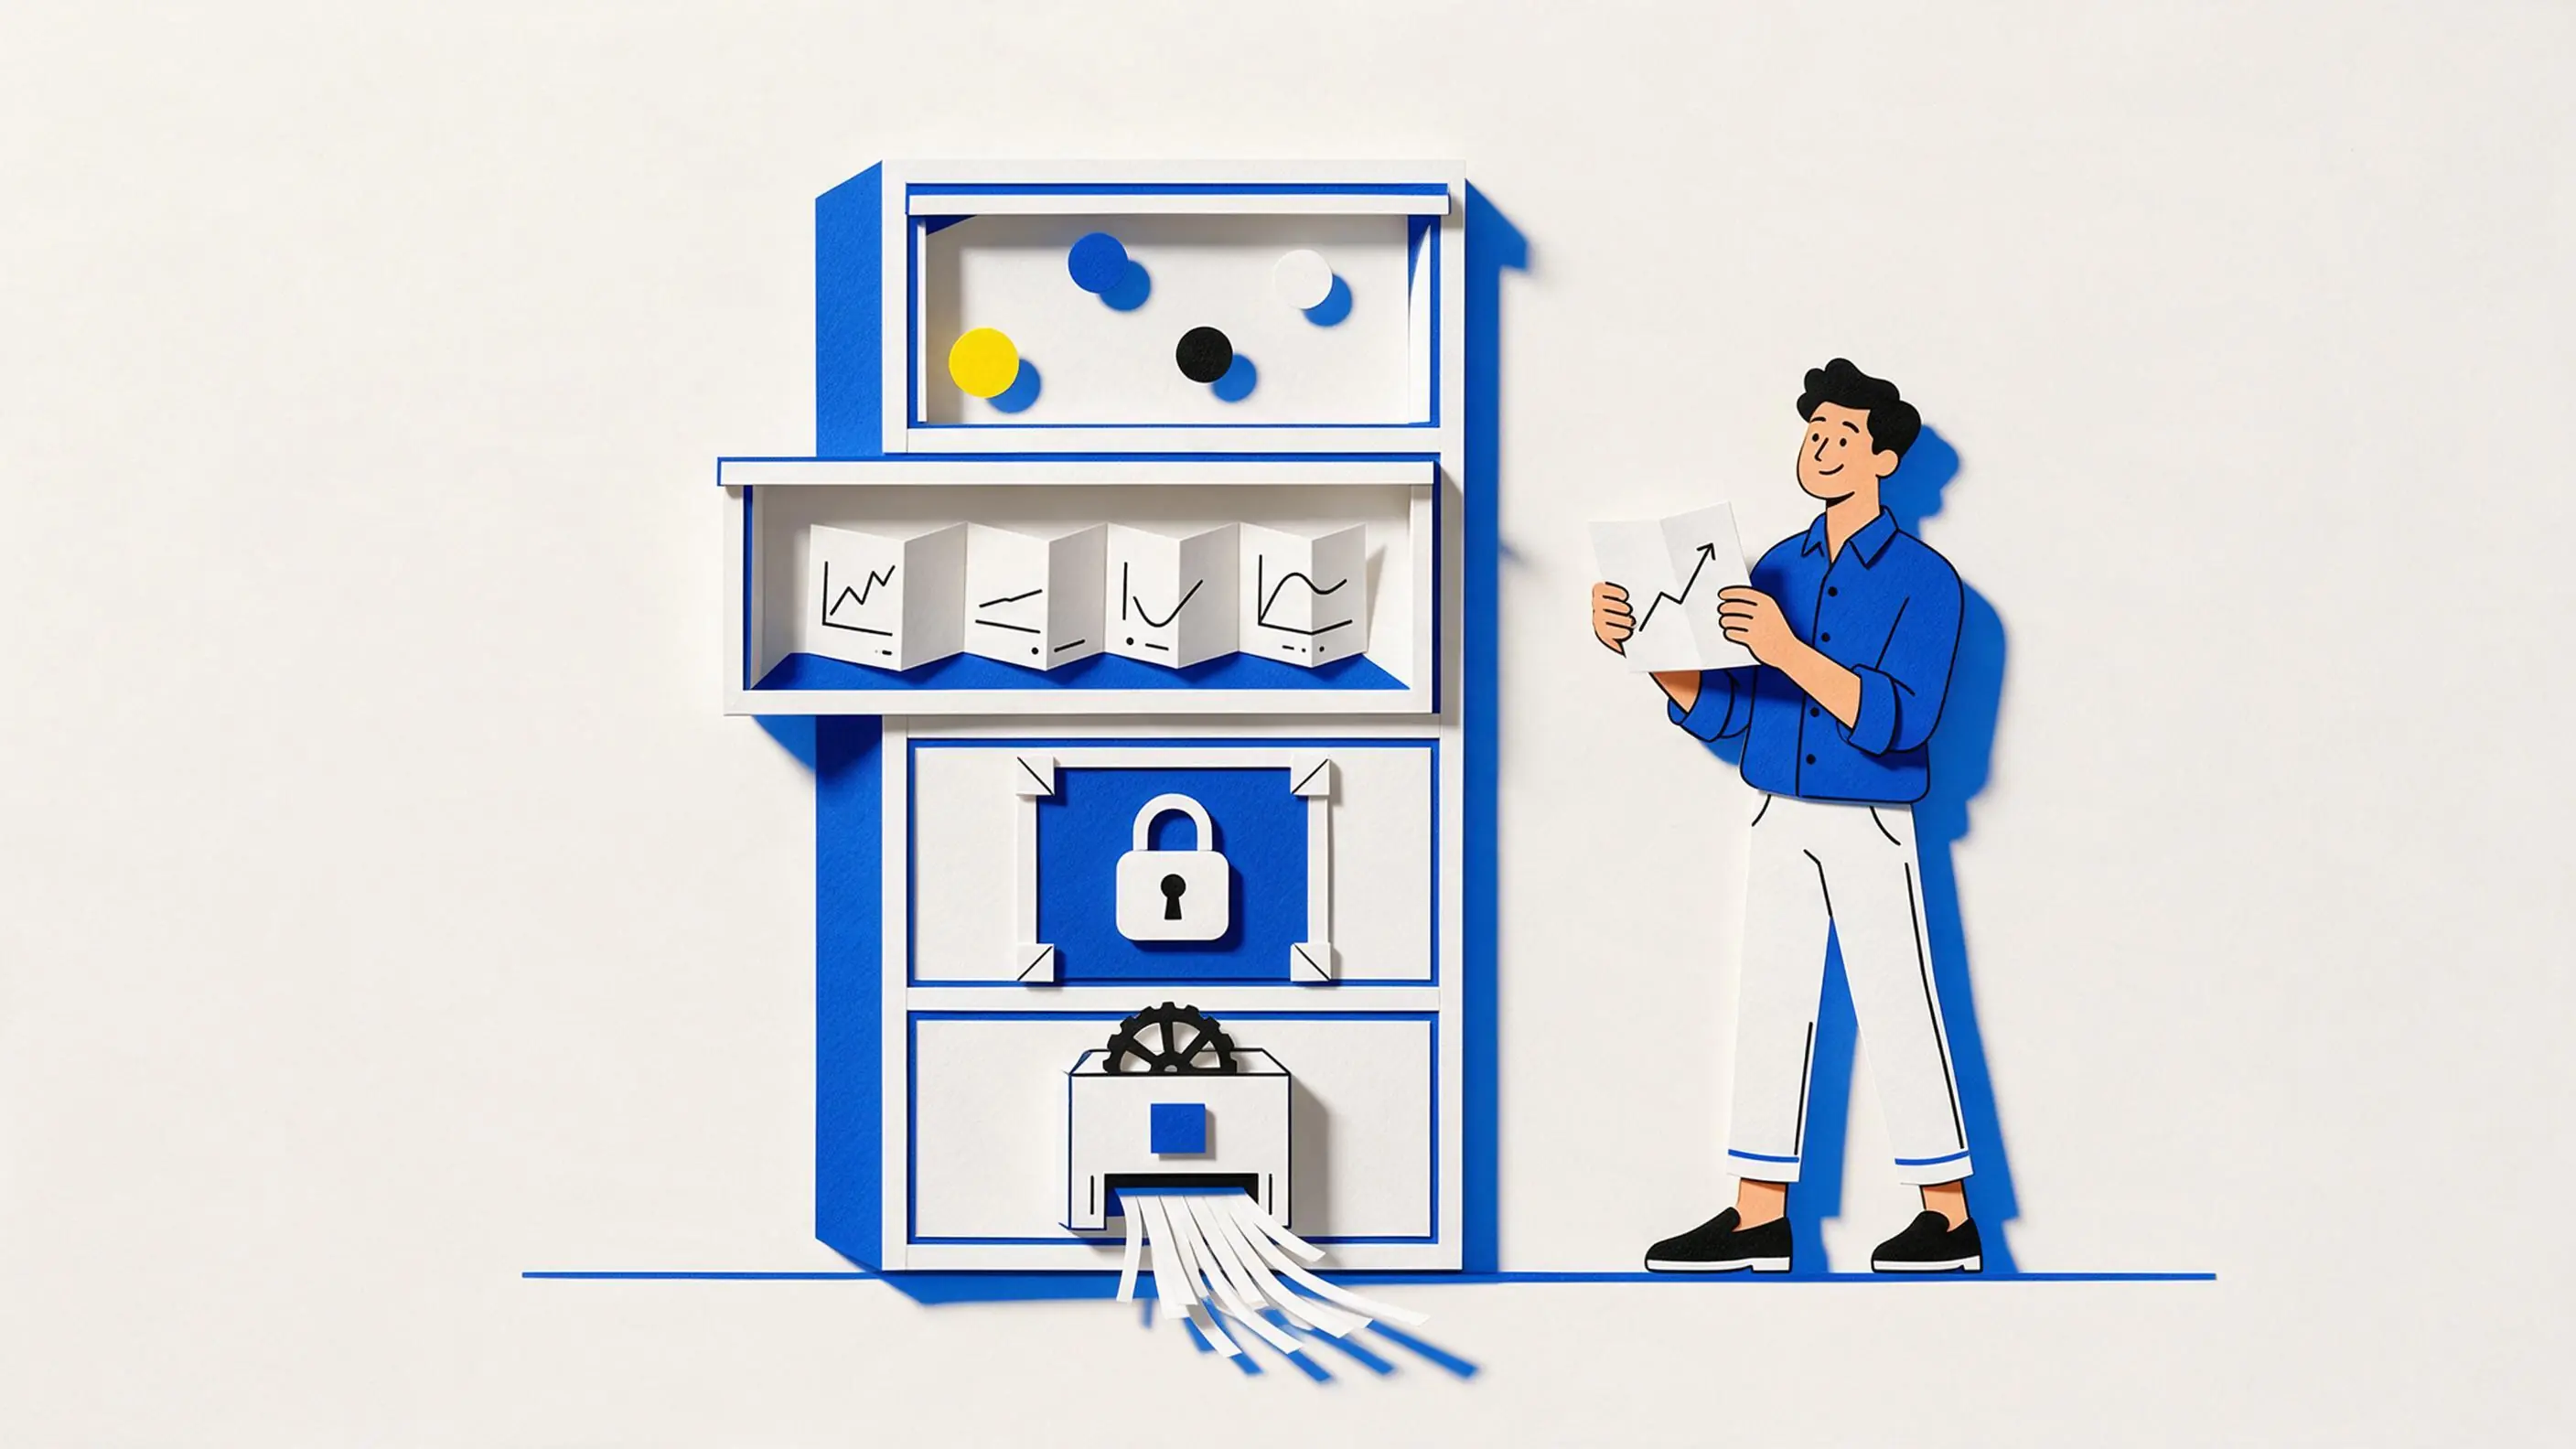
去掉 userId 以后,过细的维度仍可能把人重新找出来。一个只有一次互动的分钟级、地区级、设备级桶,匿名性非常有限。
可以在聚合出口增加抑制规则:
ts
function releaseBucket<T extends { count: number }>(bucket: T, min = 10) {
  if (bucket.count < min) {
    return { status: "suppressed" as const, count: null };
  }
  return { status: "available" as const, count: bucket.count };
}
10 只是示例,不是通用合规阈值。真正的 min 应由数据敏感度、业务规模和可关联性决定。对于数据量本来就小的一人公司,更好的办法常常是直接砍掉地区、设备等低价值维度。
Agent 看到 suppressed 后应停止下钻,而不是换一种分组继续逼近同一批人。
给 Agent 的是任务视图,不是数据库权限
数据权限按"人类 / AI"二分不够用。写作 Agent、复盘 Agent、发布 Agent 的工作不同,能看到的数据也应不同。
yaml
views:
  review_agent:
    allow:
      - content_metrics_24h
      - content_metrics_72h
      - topic_pillar
      - cover_style
    deny:
      - raw_events
      - viewer_identity
      - cross_account_join

  publishing_agent:
    allow:
      - current_draft
      - current_assets
      - publish_checklist
    deny:
      - analytics_raw_store
      - unrelated_projects
每次调用还应记录 viewVersion、用途、读取条数和输出结论。这样口径变化后,才能解释为什么两次复盘结果不一致。
一个最小的可观测记录可以是:
ts
type AgentDataAccessLog = {
  jobId: string;
  role: "review_agent" | "publishing_agent";
  purpose: string;
  viewVersion: string;
  rowCount: number;
  accessedAt: string;
};
它记录"哪项工作读了哪个聚合视图",而不是再复制一份原始用户数据。
四个容易忽略的失败分支
第一,聚合任务失败。不要删除原始输入后才发现快照没写成功;可以采用"快照提交成功 → 标记输入可清理"的两阶段状态。
第二,平台指标延迟。窗口结束不代表数据立刻稳定,允许设置小幅采样延迟,并保留实际 sampledAt。
第三,口径升级。新增指标或修改去重规则时提升 schemaVersion,不要把不同版本直接放在一条趋势线上。
第四,样本太少。系统要能输出"证据不足",而不是为了完成任务强行给标题或封面风格排出胜负。
这对一人公司有什么意义
小团队最缺的通常不是更多原始数据,而是口径稳定、能重复运行的判断流程。少存一个身份字段,意味着少一类权限、少一个泄露面、少一段需要解释的生命周期。
这也是我们做 Tipkay 时坚持岗位拆分的原因。Tipkay 面向一人公司、小微企业和小团队,不同垂类 AI 员工分别处理内容复盘、写作、配图和发布准备。一个岗位能完成工作所需的数据,未必应该自动共享给另一个岗位。按任务给最小视图,比把整套数据塞进一个万能 Agent 更容易长期维护。
一个人的生意,也能有一支专业团队。但专业团队的标志之一,就是有人负责什么、能看什么、什么时候必须停下来,都有清楚边界。
最后
数据最小化不是拒绝分析,而是逼迫系统把问题说清楚。
如果要判断选题,就保存可比的选题快照;如果要判断标题,就记录同窗口的标题实验;如果一个决策不需要知道读者是谁,就别让 userId 进入它的默认契约。
能用趋势回答的问题,不要靠追踪个人来解决。
资料:
- GitHub Changelog: github.blog/changelog/2...
- GitHub REST API documentation: docs.github.com/en/rest/act...