在上一篇文章中,我们使用 BCC 和 bpftrace 这些开箱即用的工具观测了系统行为。但在真实的生产环境中,通用工具往往无法满足特定的观测需求------你可能需要监控某个自定义内核函数的调用频率,或者追踪一个特定应用程序的内部函数调用。这时,就需要编写自定义 eBPF 程序了。本文从 eBPF 程序开发的完整生命周期出发,系统讲解三种开发路径(BCC Python、bpftrace、libbpf C)、CO-RE 的可移植性技术、以及 eBPF 程序的生产级部署考量,最后介绍 OpenTelemetry eBPF Instrumentation(OBI)这一最新的零代码观测标准。
一、eBPF 程序的开发路径
eBPF 程序的开发有多个层次,从"快速脚本"到"生产级程序",各有适用场景:
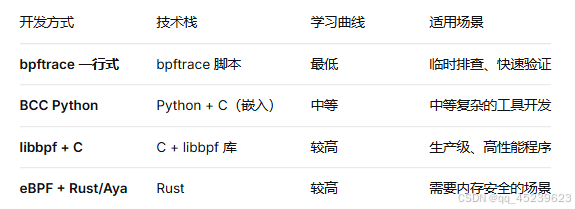
这三种方式并非互斥------同一个 eBPF 程序可以先用 bpftrace 快速验证,再用 BCC 封装为工具,最后用 libbpf 打磨为生产级程序。
二、bpftrace:从一行式到脚本化
bpftrace 是快速开发自定义探针的最高效方式。虽然"一行式"最为人熟知,但 bpftrace 的真正力量在于脚本化------将多个探针、条件和动作组合成一个完整的追踪程序。
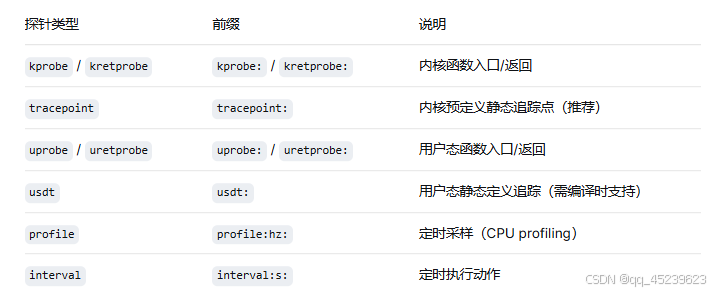
2.1 探针类型速查
bpftrace 支持多种探针类型,每种探针对应不同的观测目标:
2.2 脚本化 bpftrace 示例
以下是一个监控容器内特定系统调用频率的 bpftrace 脚本:
bash
#!/usr/bin/env bpftrace
# filename: container_syscall.bt

BEGIN {
    printf("开始监控容器系统调用...\n");
    printf("%-12s %-16s %-8s %s\n", "时间", "容器", "PID", "系统调用");
}

tracepoint:syscalls:sys_enter_openat
/pid > 0/
{
    @syscalls[comm] = count();
    printf("%-12s %-16s %-8d %s\n",
           strftime("%H:%M:%S", nsecs),
           comm, pid, "openat");
}

tracepoint:syscalls:sys_enter_read
{
    @syscalls[comm] = count();
}

tracepoint:syscalls:sys_enter_write
{
    @syscalls[comm] = count();
}

interval:s:10
{
    print(@syscalls);
    clear(@syscalls);
}
2.3 使用 USDT 探针
USDT(User Statically-Defined Tracing) 是应用程序在编译时预埋的追踪点。如果你的应用支持 USDT,bpftrace 可以直接捕获这些预定义的追踪点:
bash
# 列出二进制文件中的所有 USDT 探针
bpftrace -l 'usdt:/path/to/binary:*'

# 追踪特定 USDT 探针
sudo bpftrace -e 'usdt:/path/to/binary:probe_name { printf("%s\n", arg0); }'
python
#!/usr/bin/env python3
from bcc import BPF

# 1. 定义 eBPF C 程序(嵌入为字符串)
bpf_text = """
#include <uapi/linux/ptrace.h>
#include <linux/sched.h>

// 定义 eBPF Map(用于内核与用户态通信)
BPF_HASH(counter, u32, u64);

// kprobe 处理函数
int trace_execve(struct pt_regs *ctx) {
    u32 pid = bpf_get_current_pid_tgid() >> 32;
    u64 *val, init_val = 1;
    val = counter.lookup_or_init(&pid, &init_val);
    (*val)++;
    return 0;
}
"""

# 2. 加载 eBPF 程序
b = BPF(text=bpf_text)

# 3. 挂载探针
b.attach_kprobe(event="do_execve", fn_name="trace_execve")

# 4. 从 eBPF Map 读取数据并输出
while True:
    for k, v in b["counter"].items():
        print(f"PID {k.value}: {v.value} 次 execve 调用")
    time.sleep(5)
三、BCC Python:生产级工具的开发框架
BCC 提供了 Python 绑定,让你可以用 Python 编写 eBPF 程序的"骨架",将 C 编写的 eBPF 代码嵌入其中。
3.1 BCC 程序的基本结构
一个典型的 BCC Python 程序包含四个部分:
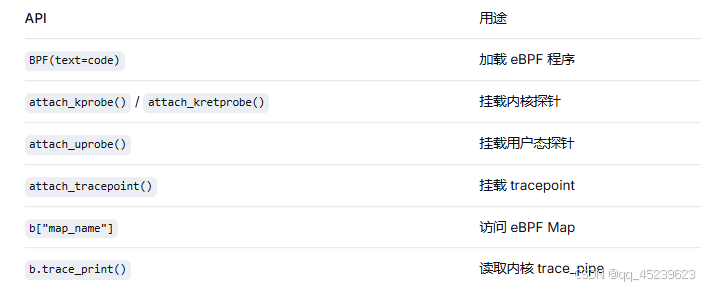
3.2 BCC 的关键 API
四、libbpf + CO-RE:生产级 eBPF 开发
对于需要长期运行、跨内核版本兼容的生产级 eBPF 程序,libbpf + CO-RE(Compile Once - Run Everywhere) 是当前的标准方案。
4.1 为什么需要 CO-RE?
Linux 内核的版本迭代频繁,内核数据结构的偏移量可能随版本变化。传统的 eBPF 程序需要针对每个内核版本重新编译,否则可能因偏移量不匹配而加载失败。
CO-RE 通过以下技术解决了这个问题:
BTF(BPF Type Format) :内核提供类型信息的标准格式
内核验证器的重定位能力:在加载时自动修正偏移量
这意味着:一次编译,处处运行。
4.2 libbpf 程序的基本结构
c
// hello.bpf.c
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>

// 定义 eBPF Map
struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 1);
    __type(key, u32);
    __type(value, u64);
} counter SEC(".maps");

// kprobe 处理函数
SEC("kprobe/do_sys_open")
int trace_open(struct pt_regs *ctx) {
    u32 key = 0;
    u64 *val = bpf_map_lookup_elem(&counter, &key);
    if (val) {
        (*val)++;
    }
    return 0;
}

char LICENSE[] SEC("license") = "GPL";
编译与加载:
bash
# 编译为 BPF 字节码
clang -O2 -target bpf -c hello.bpf.c -o hello.bpf.o

# 加载到内核
bpftool prog load hello.bpf.o /sys/fs/bpf/hello
libbpf 是 eBPF 程序加载的标准方式,与 CO-RE 结合后,可以实现跨内核版本的兼容性。
五、eBPF 的生产级部署考量
5.1 性能开销控制
eBPF 在生产环境中的性能开销是可控的。以下策略可以进一步降低开销:
使用 tracepoint 替代 kprobe:tracepoint 是内核预定义的稳定接口,性能开销更低。
高频探针使用采样:对于高频事件(如网络包),使用采样而非全量采集。
限制 eBPF 程序的复杂度:验证器会检查程序复杂度,复杂程序可能被拒绝加载。
在压测环境中验证开销:上线前用生产级流量测试 eBPF 程序的 CPU 和内存占用。
5.2 安全与稳定性
eBPF 程序在生产环境中运行,必须通过内核验证器的安全检查:
验证器(Verifier) :检查程序是否会在有限时间内结束、不会访问非法内存
沙箱隔离:eBPF 程序运行在安全沙箱中,不会导致内核崩溃
权限控制:加载 eBPF 程序需要 CAP_BPF 或 root 权限
部署建议:
在测试环境中充分验证 eBPF 程序
使用 bpftool prog show 监控已加载的 eBPF 程序
设置资源限制,防止 eBPF 程序消耗过多 CPU
监控 eBPF 程序的错误日志
六、OpenTelemetry eBPF Instrumentation(OBI):零代码观测的未来
2025 年,OpenTelemetry 将 eBPF 自动注入正式纳入标准。Grafana Labs 将其 eBPF 工具 Beyla 捐赠给 OpenTelemetry,成为 OBI(OpenTelemetry eBPF Instrumentation) 项目。
6.1 OBI 的核心能力
OBI 绕过应用层,直接在内核层面捕获数据:
协议识别:自动识别 HTTP/1.1、HTTP/2、gRPC、PostgreSQL、MySQL、Redis 等常见协议
自动关联:将网络 I/O 事件与进程事件对应,生成带 trace ID 的 span
无需修改代码:不重新构建、不更新依赖、不重启服务
6.2 OBI 的定位与边界
OBI 并非要取代 SDK 埋点,而是填补 SDK 无法覆盖的缺口:
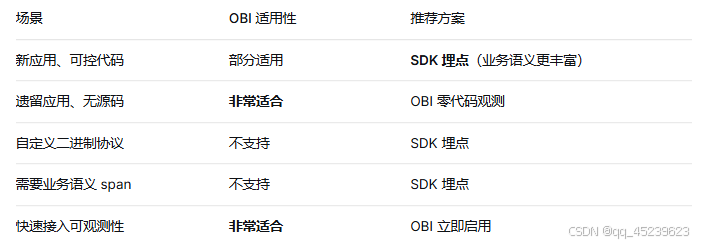
OBI 能看到"系统层面可见"的东西,但无法区分"查询用户余额"和"更新订单状态"这种业务语义。因此,OBI 和 SDK 埋点应该是互补关系,而非替代关系。
6.3 部署 OBI
OBI 以 DaemonSet 形式部署在 Kubernetes 集群中,与 Grafana Beyla 的部署模式类似:
yaml
# OBI DaemonSet 部署(概念示例)
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: obi-collector
spec:
  template:
    spec:
      hostNetwork: true
      containers:
      - name: obi
        image: otel/opentelemetry-ebpf-instrumentation:latest
        env:
        - name: OTEL_EXPORTER_OTLP_ENDPOINT
          value: "http://tempo-distributor:4317"
        securityContext:
          privileged: true
注意:OBI 目前处于 Alpha 阶段,仅支持 Linux 环境,需要内核开启 BPF 相关特性。
七、小结
三种开发路径:bpftrace(快速脚本)、BCC Python(中等复杂度)、libbpf + CO-RE(生产级程序)。
bpftrace 脚本化:将一行式扩展为多探针脚本,支持 USDT 探针。
BCC Python:在 Python 中嵌入 eBPF C 代码,通过 Map 实现内核与用户态通信。
libbpf + CO-RE:一次编译、处处运行,是生产级 eBPF 开发的标准方案。
生产部署考量:使用 tracepoint 替代 kprobe、在压测中验证开销、通过内核验证器确保安全。
OBI(OpenTelemetry eBPF Instrumentation) :2025 年 OpenTelemetry 将 eBPF 自动注入纳入标准,零代码观测补上了 SDK 埋点无法覆盖的缺口。