很多 SQL Server 数据库迁移项目,真正让开发团队犹豫的东西是什么呢?其实往往不是表和索引怎么搬。而是应用里积累多年的那些 T-SQL。存储过程、报表 SQL、批处理脚本,还有 ORM 生成的语句,散落在好几个系统里面。任何一点语法差异,都可能在上线之后才暴露出来,这就很难受了。
那迁移如果变成"数据库换掉,业务重写一遍"的情况呢?成本和风险都会很快失控的。
我把金仓数据库 KES V9R4C019 的兼容能力拆开来看了一遍。发现它的价值其实不只是支持几个常见关键字这么简单。它是在尽量覆盖 SQL Server 应用真正会用到的那套语法组合:MERGE、并行 DML、OUTPUT、窗口函数、PIVOT/UNPIVOT,还有 LIKE 通配符、会话选项这些细节。兼容做得越接近应用的真实写法,迁移就越有可能从"重写项目"变成"验证项目"。这两个东西的工作量,差得可不止一点。 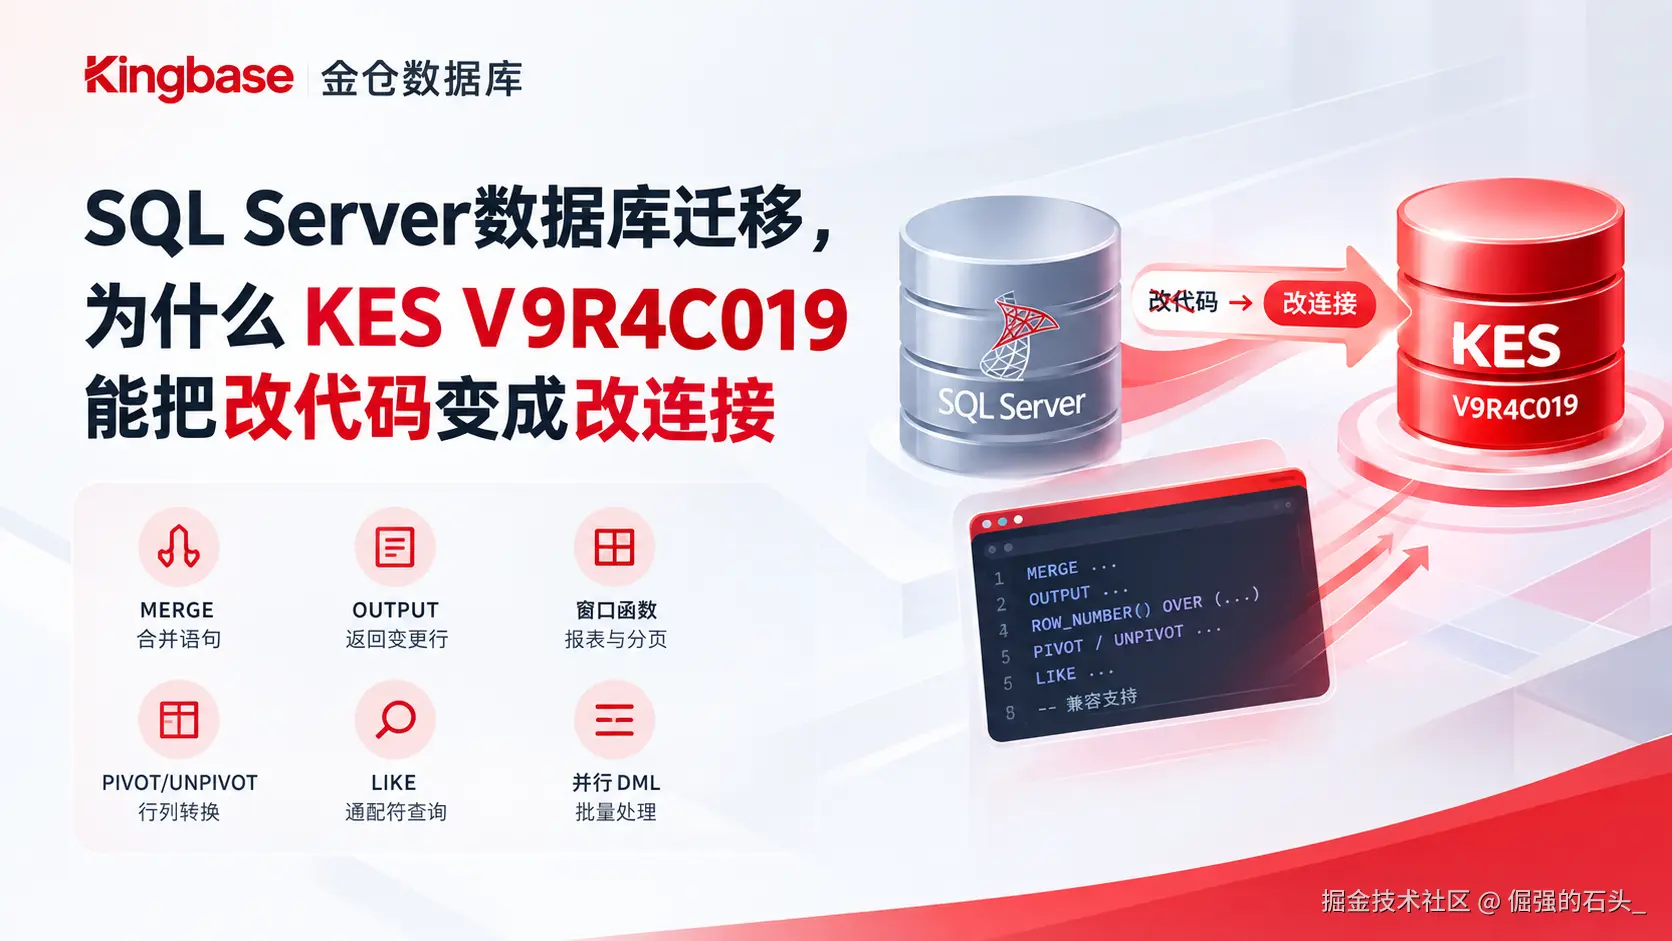
@toc
先把迁移对象分成三层
做 SQL Server 迁移的时候,我通常会把应用先拆成三层来看:
- 数据层:表、索引、约束、序列、分区和数据类型;
- 数据库编程层:存储过程、函数、触发器、视图和作业脚本;
- 应用访问层:连接驱动、参数绑定、事务控制、分页和异常处理。
KES 的深度兼容呢,主要是降低第二、三层的改造量。它没法让不同数据库的存储引擎突然变得完全一样,这一点要清楚。业务对特定 SQL Server 行为的依赖,它也消除不了。但是大量成熟的 SQL 可以直接保留下来,然后先把真正不兼容的部分筛出来。这样事情就简单多了。
MERGE:迁移代码里最容易被低估的语句
很多 SQL Server 应用,是用 MERGE 来同时处理新增和更新的。举个例子,同步客户主数据的时候,目标表里存在就更新,不存在就插入:
sql
MERGE INTO dbo.customer AS target
USING (SELECT @id AS customer_id, @name AS customer_name) AS source
   ON target.customer_id = source.customer_id
WHEN MATCHED THEN
  UPDATE SET customer_name = source.customer_name,
             updated_at = CURRENT_TIMESTAMP
WHEN NOT MATCHED THEN
  INSERT (customer_id, customer_name, updated_at)
  VALUES (source.customer_id, source.customer_name, CURRENT_TIMESTAMP);
那如果目标数据库不支持同样的语法呢?开发人员通常就得改成先查再分支,或者拆成 UPDATE 加 INSERT 两条语句来写。改完之后不光代码变长了,并发窗口和事务行为也会跟着变。这是个隐患。KES V9R4C019 对 MERGE 是有支持的,这类存量 T-SQL 就有机会原样跑起来。至少的话,你的精力可以放在执行结果、锁行为和索引计划上面,而不是耗在改写语法上。
OUTPUT:应用经常依赖的"返回变更行"
SQL Server 的 OUTPUT,经常用在两个地方:一个是新增之后拿回自增键,另一个是记录更新前后的值。典型的写法长这样:
sql
INSERT INTO dbo.orders(customer_id, amount)
OUTPUT inserted.order_id, inserted.created_at
VALUES (@customer_id, @amount);
还有一类写法,是把输出结果直接写进表变量,给后面的业务处理用:
sql
DECLARE @changed TABLE(order_id bigint, old_status varchar(20), new_status varchar(20));

UPDATE dbo.orders
   SET status = @new_status
OUTPUT deleted.order_id, deleted.status, inserted.status
INTO @changed(order_id, old_status, new_status)
 WHERE order_id = @order_id;
那如果迁移的时候只看"SQL 能不能执行",没去验证返回结果呢?应用很可能到下一步才报错。到时候排查起来就麻烦了。所以兼容性验证,应该把返回列名、列顺序、NULL 行为,还有事务回滚,放在一起测。KES 对 OUTPUT 子句是有支持的,这就减少了把这类逻辑搬到应用层的必要。
窗口函数:报表和分页 SQL 的核心
窗口函数这个东西,在排名、分组取最新记录、累计值、分页查询这些场景里出现得非常多。比如每个部门的薪资排名:
sql
SELECT employee_id,
       department_id,
       salary,
       ROW_NUMBER() OVER (
         PARTITION BY department_id
         ORDER BY salary DESC, employee_id
       ) AS rn
FROM employee;
更复杂一点的报表,还会用到 LAG、LEAD、SUM() OVER 和窗口框架。那迁移的时候要注意什么呢?就算目标数据库支持窗口函数,也得留心默认排序、NULL 的排序位置,还有窗口边界这些地方。我的做法是这样的:先保留原来的 SQL,然后用固定的数据集去核对结果集。而不是先凭感觉改写成好几层子查询,那样改错了都不知道。
PIVOT 和 UNPIVOT:少改一段报表逻辑
很多统计系统会做行转列,或者把宽表还原成明细。SQL Server 里常见的 PIVOT 写法是这样:
sql
SELECT department_id, [2024], [2025]
FROM (
    SELECT department_id, fiscal_year, amount
    FROM department_budget
) src
PIVOT (
    SUM(amount) FOR fiscal_year IN ([2024], [2025])
) p;
反向转换的话,用的是 UNPIVOT。那如果没有兼容支持呢?开发人员往往就得改成多个 CASE WHEN 聚合的写法。后者不是不能跑,能跑。但是列名维护、NULL 处理、执行计划,这些都会变。KES 对这两类语句是有支持的,迁移的时候就能先保持业务 SQL 的原貌,然后再针对真正的性能瓶颈去做优化。顺序不要搞反了。
并行 DML 不只是一个关键字
大批量装载、归档、报表中间表这些场景,经常需要并行执行。那迁移到 KES 之后呢?就算 SQL 语法一点没变,也要重新确认并行度、锁等待、日志写入,还有资源上限这些东西。并行 DML 的价值,说白了就是利用多核资源,把批量操作的时间缩短。但是并行度调太高的话,会和在线事务抢 CPU 和 I/O,这也是个问题。
可以先拿会话级参数做小范围的验证,然后再逐步放大:
sql
-- 示意:实际参数名和取值以目标版本手册为准
SET max_parallel_workers_per_gather = 4;

UPDATE fact_sales
   SET settled = 1
 WHERE settle_date < DATE '2025-01-01';
验证的重点不只是总耗时这一个数。业务高峰时的锁等待、WAL/日志的增长,这些也都要看。兼容性解决的是"能不能跑",容量规划解决的是"能不能稳定跑"。这两个事情,不能混为一谈。
LIKE 通配符:最细小也最容易漏测
迁移项目里面,LIKE 往往藏在查询条件、权限过滤、动态搜索框这种地方。%、_、转义字符、大小写敏感性,还有字符串类型转换,全都会影响结果。比如:
sql
SELECT user_id, user_name
FROM app_user
WHERE user_name LIKE @pattern ESCAPE '\\';
那如果应用是把用户输入里的 % 当普通字符来处理的话,就必须正确转义。还有排序规则的问题------源端和目标端不一样的话,同一条 LIKE 'a%' 查出来的结果也可能不一样。所以我会准备一些测试数据,中文、大小写、下划线、百分号都要有,然后逐项核对结果集。只拿一个英文样例来验证,是不够的。
真正接近"零修改"的迁移流程
兼容特性齐全,不代表就可以跳过验证了,这是两回事。我建议按四步来推进: 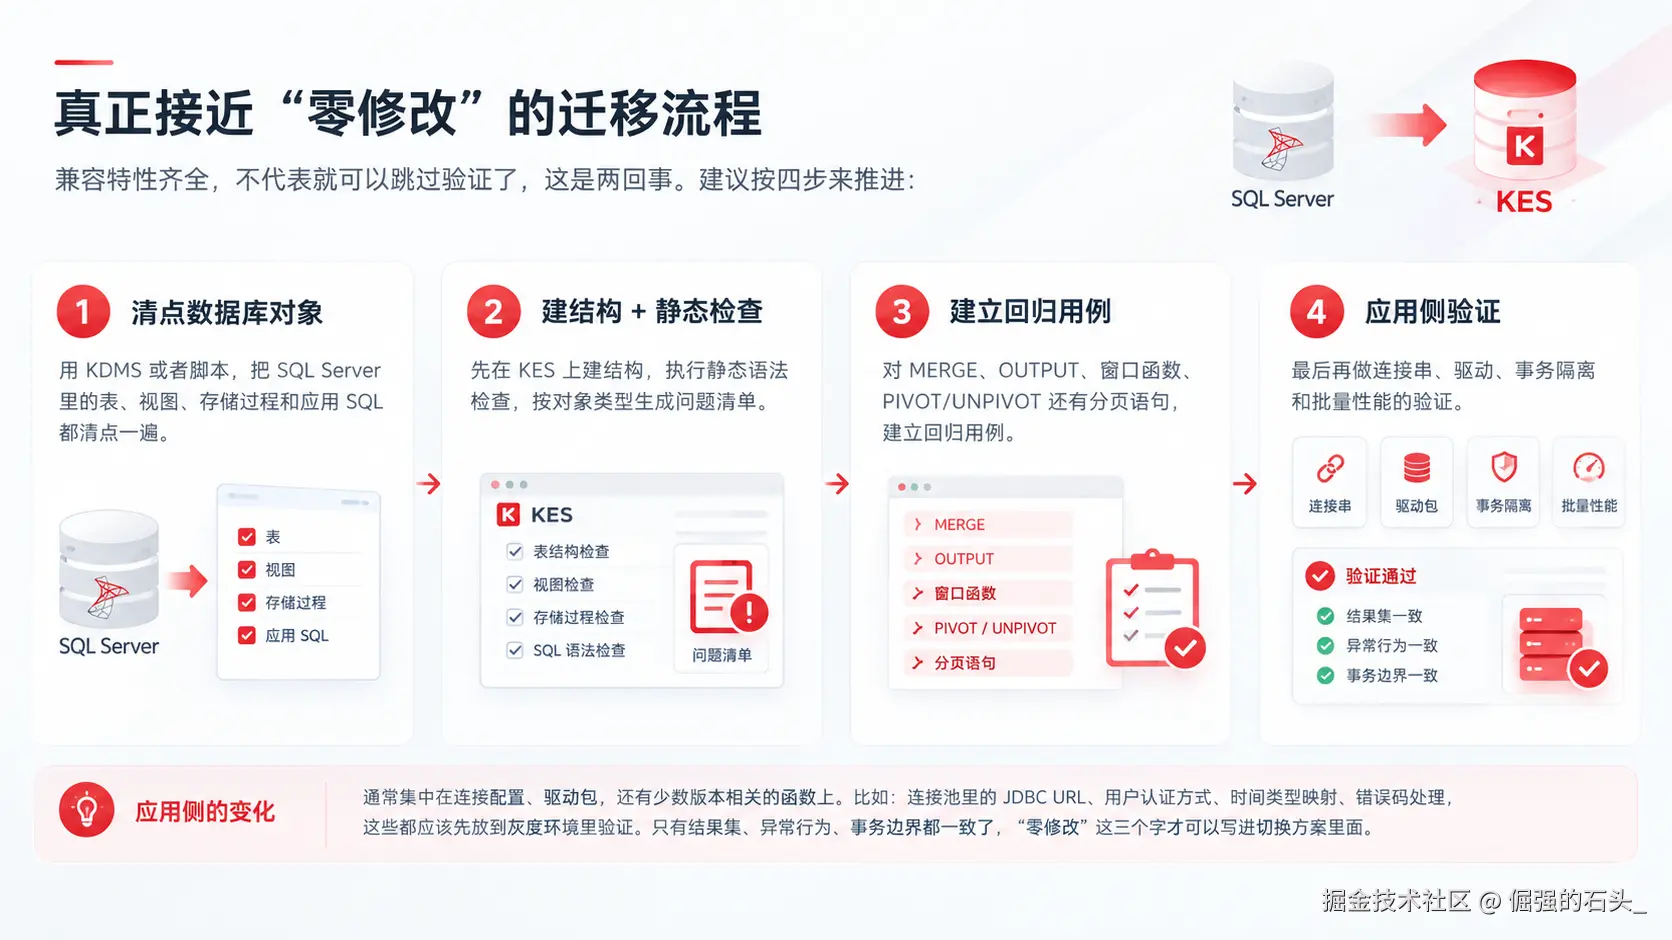
- 用 KDMS 或者脚本,把 SQL Server 里的表、视图、存储过程和应用 SQL 都清点一遍;
- 先在 KES 上建结构,执行静态语法检查,按对象类型生成问题清单;
- 对
MERGE、OUTPUT、窗口函数、PIVOT/UNPIVOT还有分页语句,建立回归用例; - 最后再做连接串、驱动、事务隔离和批量性能的验证。
应用侧的变化呢,通常集中在连接配置、驱动包,还有少数版本相关的函数上。举个例子,连接池里的 JDBC URL、用户认证方式、时间类型映射、错误码处理,这些都应该先放到灰度环境里验证。只有结果集、异常行为、事务边界都一致了,"零修改"这三个字才可以写进切换方案里面。
金仓兼容的边界在哪里
KES 的兼容能力,适合解决大量标准 T-SQL 的迁移问题。尤其是语法密集型的存储过程和报表应用,效果比较明显。但是下面这些内容,还是要逐项检查的:SQL Server 专有的系统表、CLR 集成、Service Broker、特定的作业组件、依赖执行计划的 hint,还有跟 Windows 身份认证绑定的外围程序。
所以"零修改"更准确的理解是什么呢?是核心业务逻辑可以保持不变,改造集中到少数不兼容的对象和部署配置上。它不是任何项目都绝对不改一行代码,这个要说清楚。对迁移团队来说,搞清楚这个边界反而更重要。为什么呢?因为它让风险从"整个应用未知"变成了"清单里的几个对象,可控验证"。这个转变是很实在的。
一份兼容性回归清单
为了避免只验证语法、不验证行为的情况,我会把回归用例分成四组。第一组是结果集,用固定数据验证行数、排序、NULL 和精度;第二组是事务,覆盖提交、回滚、嵌套事务和批量异常;第三组是并发,观察相同表更新时的锁等待和死锁处理;第四组是外围连接,验证连接池重连、字符集、时区还有错误码映射。 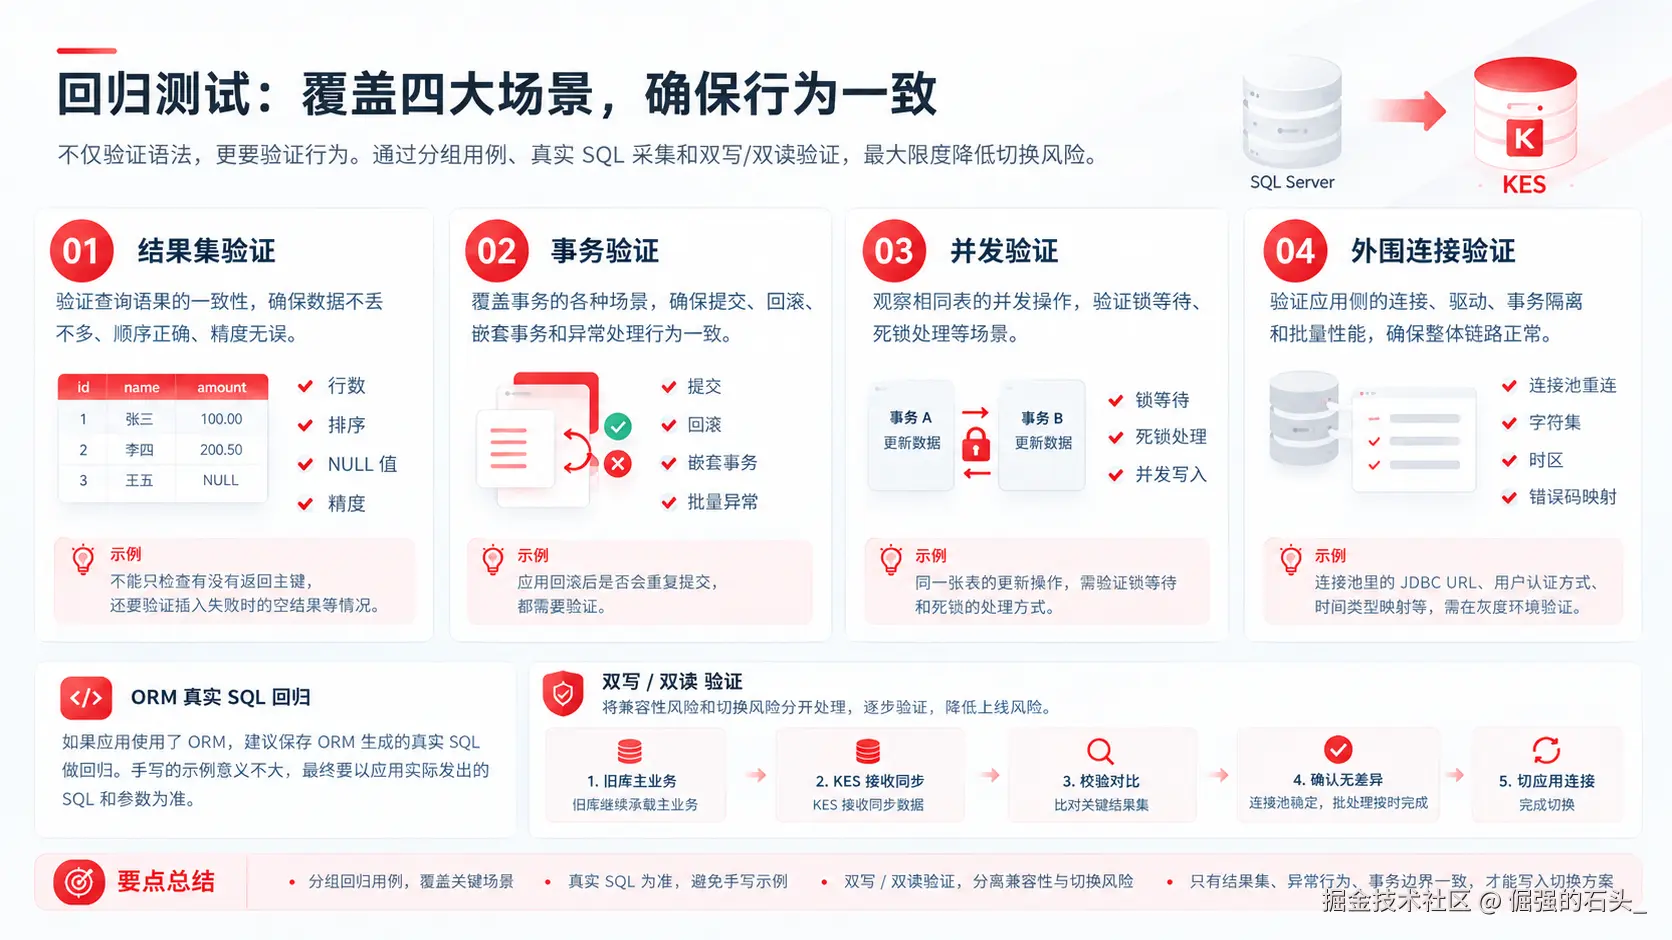
举例来说,OUTPUT 的用例不能只检查有没有返回主键。插入失败时是不是返回了空结果、事务回滚之后应用会不会重复提交,这些也要验证。窗口函数的用例呢,不能用一条数据就完事,同一排序值、NULL 排序、分页边界,都得覆盖到。LIKE 的话,要准备带 %、_、反斜杠和中文的输入,确认转义规则跟原系统是一致的。
如果应用用了 ORM,我建议把 ORM 生成的真实 SQL 保存下来做回归。手写一个看起来差不多的示例,意义不大。数据库兼容层解决的是语句和执行语义,最终还是要以应用实际发出的 SQL 和参数为准。这么做前期整理工作确实会多一些,但是能明显减少上线之后才发现"同一条查询结果少了一页"这种返工,划算的。
在切换之前,我还会安排一轮双写或者双读的验证。具体怎么做的呢?旧库继续承载主业务,KES 那边接收同步数据,然后由校验程序去比较关键结果集。确认差异清单是空的、连接池稳定、批处理能按时完成之后,再切应用连接。这个过程把兼容性风险和切换风险分开了处理,出了问题也好定位。
结语
SQL Server 数据库迁移,最怕的不是发现差异。而是上线之前没有机会发现差异,这才是要命的。
KES V9R4C019 对 MERGE、并行 DML、OUTPUT、窗口函数、PIVOT/UNPIVOT 和 LIKE 这些细节的覆盖,让迁移可以沿着原有的 SQL 资产往前推进。而不是从头把业务逻辑设计一遍。
我更愿意把这种兼容理解成一种工程效率上的东西:先保留能保留的代码,然后用评估、回归和灰度,把真正需要改的部分筛出来。这样的话,SQL Server 数据库迁移就不再是一次不可控的重写了,而是一项可以分阶段验证、逐步收敛的工作。