「高并发实测」系列第 3 篇。
环境:单机笔记本,Docker 跑 MySQL / Mongo / Redis / MinIO,后端服务(Java 17 / Spring Boot 3.4)+ Spring AI 接百炼,Agent 服务单独 8084 端口。k6 开环
constant-arrival-rate100/s × 20s,5 个城市名做热点工作集。这是我自己搭的实验环境,不是生产系统。上一篇讲了线程池在高负载下会把"异步"静默退化成同步;这一篇讲一个 Java 后端眼里的 AI Agent------教程都停在"调通 API",而线上要的那一半:可观测、限并发、熔断、压测,几乎没人教。
〇、一分钟带走版
一个只查真实数据的问答 Agent(工具 → HTTP → 后端 → MySQL/Mongo),我把后端最熟的那几件护栏一件件加上去,同一份压测脚本做 A/B:
| 护栏 | 实现 | 实测效果 |
|---|---|---|
| 可观测 | Micrometer + 应用内自采延迟/成败/token/成本 | 延迟一度算出 5.8e12 毫秒,被迫换口径(第二节) |
| 下游降级 | RestClient 连接/读超时 + 结构化 unavailable |
下游指死端口 → 秒失败、不雪崩,模型如实说查不到 |
| LLM 舱壁 | Semaphore(3) + tryAcquire 失败即 503 |
6/s 打到上限 3 → 65/72 = 90.3% 被秒挡,只有约 7 个真进模型 |
| 熔断 | 手写 Breaker:CLOSED→OPEN→HALF_OPEN |
下游宕机连打 20 次:前 5 次真失败,后 16 次快速拒绝 |
| 本地缓存 | Caffeine,挂在工具层 | p95 836ms → 12.34ms(约 68 倍) ,命中率 97.7% |
但这一篇最值钱的不是那 68 倍。是加缓存之前我先测了一次不含 LLM 的纯编排层 ,发现:网关自己中位数 5.2ms,p95 却 762ms------长尾全在本机后端那一段,Agent 层是无辜的 。这一步推翻了我的默认假设:我以为要优化的是"AI 那一层",结果该优化的是它下面那个普通的 HTTP 调用。
而"再调一下阈值让 p95 变绿"这个诱惑,我忍住了(第六节)。
全文关键词:Spring AI、可观测性、Semaphore 舱壁、熔断器、Caffeine 缓存、k6 开环压测。
一、场景:Agent 跑通了,然后呢?
先摆一下我做的东西。业务背景很朴素:一个数据查询类业务 ,用户问"杭州有哪些""排名第三的是哪个",Agent 不许凭自己的记忆答------必须调工具去查后端真实数据,再组织成人话。
一次请求的链路长这样:
bash
用户提问
  → ChatClient(Spring AI)→ 模型决定调哪个工具
  → 工具层 ToolGateway → RestClient → 后端 /wxma/**  →  MySQL / Mongo
  → 结果回填给模型 → 模型出终答
到"能答对"这一步,一个下午就够了,网上教程全是这一段。但我按后端的标准一看,四个问题一个没解:
- 它到底慢在哪? 一次问答几秒起步,我连"是模型慢还是我下游慢"都说不出来。
- 下游挂了会怎样? 我的第一反应是抛异常,第二反应是更可怕的:模型会不会因为拿不到数据就编一个排名出来?
- 谁来限流? 模型是按 token 付费的,而且一次请求要占住 servlet 线程四秒以上------这不就是我上一篇文章里那个"阻塞 I/O 长期占住线程"的经典场景吗。
- 能扛多少 QPS? 没人告诉我,包括教程作者。
于是我把这四件事,按后端的常规做法一件件补上。补完最大的意外是:这四件事没有一件是"AI 技术",全是十年前的老手艺。
二、可观测:先让它可被度量(不然优化都是玄学)
AgentMetrics 里几类指标:
| 指标 | 类型 | 用途 |
|---|---|---|
agent.tool.invoke{tool,outcome} |
Counter | 工具成败比,下游健康度 |
agent.cache.result{tool,result} |
Counter | hit / miss_ok / miss_fail / circuit-open |
agent.llm.outcome |
Counter | ok / rejected / error,分母是"被挡了多少" |
agent.chat.latency |
应用内自采 mean/max | 模型往返耗时 |
| token 用量 → 成本 | Counter × 单价 | 烧钱速率,进 /snapshot 直接看 |
这里踩了个坑,值得单说。 我一开始用最"标准"的做法:Timer.record(nanos, NANOSECONDS),然后读 takeSnapshot().percentileValues().value()。结果快照里打出一个 5.8e12 毫秒 的延迟------换算下来是一百八十多年。
原因是单位口径打架:record 时显式传了 NANOSECONDS,而读分位数时我按毫秒理解,Micrometer 那边又按它自己的 base unit 解释,三个口径凑一起就没人能对上了。我的处理不是"再调一次单位试试",而是换掉可信源 :应用内只自采 mean/max(AtomicLong 存纳秒,输出时 /1e6),p95/p99 全部交给 k6 这个权威源算。
这条经验我觉得比缓存那 68 倍更通用:分位数是压测工具的活,不是应用埋点的活。应用只需要知道自己"平均多少、最差多少、拒绝多少次"。
还有一个坑更隐蔽:被舱壁拒绝的请求,别把 0 时长灌进延迟分布 。503 是几毫秒返回的,一旦混进 Timer,中位数立刻变得非常好看------你的报表会开始骗你 。我给拒绝单独开了 countOutcome,只计数、不进分布。
三、降级:下游挂了的正确表现,是说"查不到"
Agent 的下游挂了会怎样?普通服务的表现是一串 500。Agent 多一层风险:模型拿到一个异常,它可能照样给你编一个看起来很像样的答案。 在这类场景里,一个编造的数字比一句"查不到"恶劣得多。
所以这里要做两件事,一件在代码,一件在提示词:
scss
// ToolGateway.call() ------ 异常不往外抛,吞成结构化"不可用"
try {
    List<Map<String, Object>> result = loader.get();
    br.onSuccess();  metrics.recordTool(tool, true);
    if (cache != null) cache.put(key, result);
    return result;
} catch (RuntimeException e) {
    br.onFailure();  metrics.recordTool(tool, false);
    return unavailable(tool, e.getClass().getSimpleName());   // {unavailable:true, reason:...}
}
配套的 RestClient 必须带连接超时和读超时 (TOOL_TIMEOUT_MS,默认 2500ms,压测时我调到 1000ms)。没有超时的降级等于没有降级------异常要等 OS 层 TCP 超时才来,那一二十秒里 servlet 线程照样被占着。
然后系统提示里明确告诉模型:拿到 unavailable 就照实说"暂时查不到",不许用自己的记忆补。
验证方式很直接:把后端基址指到一个没人监听的死端口。结果 {unavailable:true, reason:ResourceAccessException},秒级返回,不雪崩,模型回的是"目前查不到该校数据"。这一条是我最满意的实测:它证明的不是我的代码多强,而是"胡说"这条路被堵住了。
四、LLM 舱壁:一个 Semaphore,挡住九成流量
一次真实问答的模型往返,我的埋点量出来是 mean 4665ms / max 4806ms(1393 输入 + 375 输出 token)。
四秒看起来不长,但它就是把 Tomcat 线程一条条借出去不还------这跟上一篇那个"阻塞 I/O 长期占住线程"的坑是同一件事,只是这次不用去翻线程池参数,直接限并发最省事:
typescript
public Result chat(String q) {
    if (!bulkhead.tryAcquire()) {           // Semaphore(llm-max-concurrent),默认 3
        metrics.countOutcome("rejected");   // 只计数,不进延迟分布(第二节那条)
        return new Result("rejected", "系统繁忙(超过 LLM 并发上限),请稍后重试。");
    }
    long t0 = System.nanoTime();
    try { /* 真调模型 */ ... }
    finally { bulkhead.release(); }
}
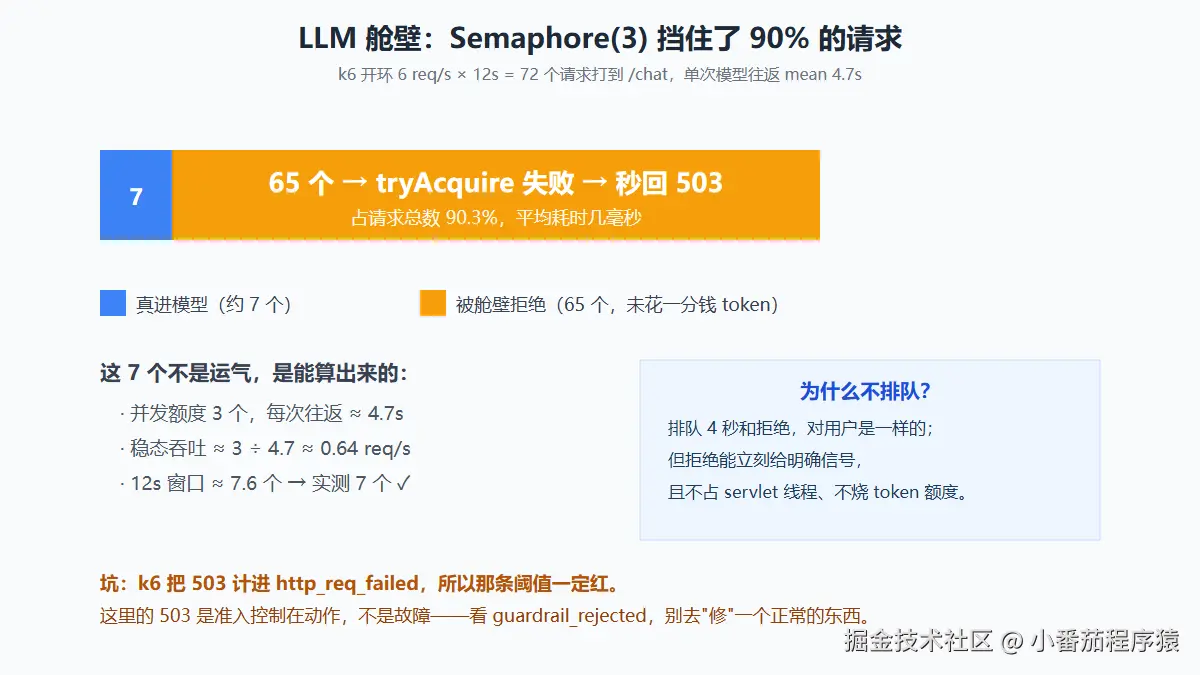
注意是 tryAcquire() 不等待------不排队。Agent 场景下排队四秒和拒绝的本质一样,但拒绝能立刻给用户一个明确信号,还顺手保住了付费模型的额度。
k6 打 6/s × 12s = 72 个请求,舱壁上只留 3 个位置:
| 项 | 数 |
|---|---|
| 总请求 | 72 |
| 被秒挡 503 | 65 / 72 = 90.3% |
| 真进模型 | 约 7 个 |
这 7 个左右完全能从原理复算出来:3 个并发额度、每次往返约 4.7 秒 → 吞吐 ≈ 3 / 4.7 ≈ 0.64 req/s ,12 秒 ≈ 7.6 个。实测 7 个,对得上。
压测里有个坑 :k6 把 503 计入
http_req_failed,所以那个rate<0.01的阈值一定是红的。但这里的 503 是准入控制在动作 ,不是故障。要评估护栏效果,看自定义的guardrail_rejected,别看http_req_failed。否则你会去"修"一个正在正常工作的东西。
五、熔断:手写 60 行,只为把它讲清楚
生产上该用 resilience4j,我手写了一个最小版 Breaker(CLOSED / OPEN / HALF_OPEN),因为我想让状态机在自己眼皮底下是可解释的:
sql
CLOSED    放行,累加连续失败;达到阈值(5) → OPEN
OPEN      冷却期内一律快速拒绝(不让慢/挂的下游继续吃线程);冷却到 → HALF_OPEN
HALF_OPEN 只放一个探针;成功 → CLOSED 复位,失败 → 再 OPEN
allowRequest() / onSuccess() / onFailure() 全 synchronized------demo 里我要的是简单且正确,不是高吞吐,这属于有意识的取舍,不是偷懒。
真实验证(TOOL_TIMEOUT=1000,基址指死端口 59999,连打 20 次):
| 阶段 | 次数 | 行为 |
|---|---|---|
| 真试并失败 | 5 | miss_fail: 5 → 熔断 OPEN |
| 快速拒绝 | 16 | breaker.rejects: 16,返回 reason: circuit-open |
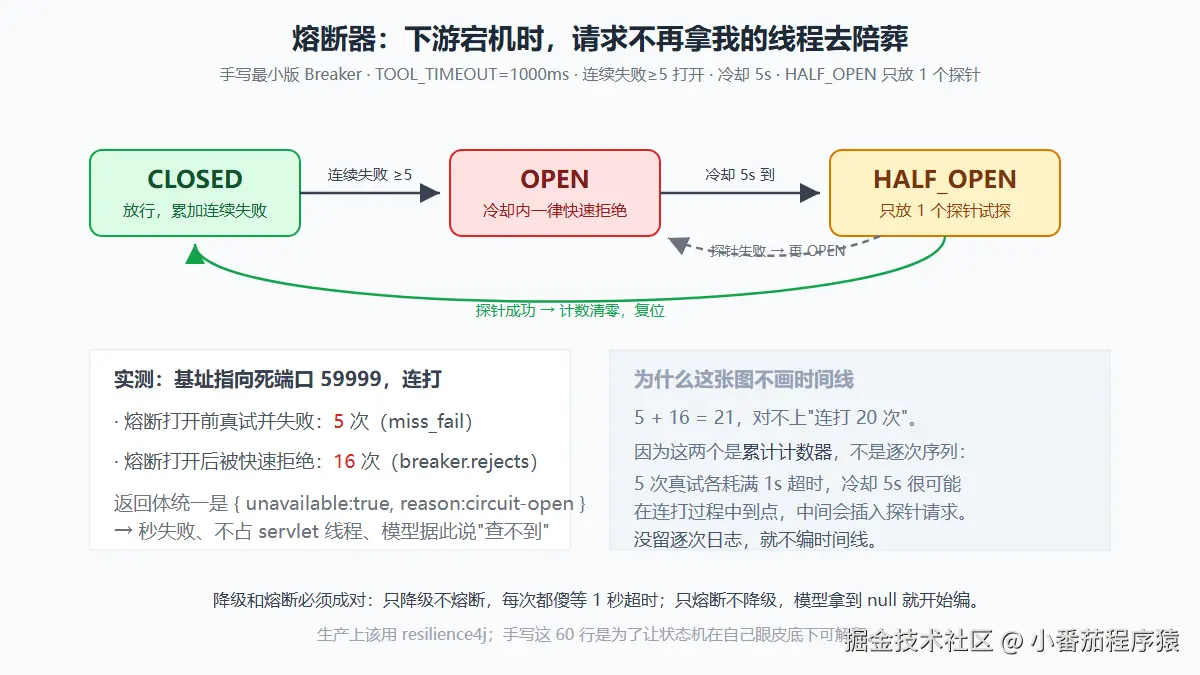
这里得停一下:5 + 16 = 21,跟"连打 20 次"对不上。 因为这两个数是 /snapshot 里的累计计数器 ,不是逐次序列------5 次真试每次都耗满 1 秒超时,而熔断冷却只有 5 秒,所以很可能在我手点还没打完时冷却就到点了,中间会插入探针请求(探针失败会再次 OPEN 并继续累加)。我当时的快照没留逐次日志,所以这里只报两个计数,不给你画时间线。 一个对不上的数字标出来,比我顺手圆过去有用。
价值不在省了那十几次请求,在于下游挂掉时我不再拿自己的线程去陪葬 :请求秒回,servlet 线程不堆积,模型秒拿到"查不到"。熔断和第三节的降级是一对,单独任一个都不完整------只降级不熔断,每次请求都要先傻等 1 秒超时;只熔断不降级,熔断打开时模型拿到的是 null,就可能开始编。
六、压测:先证明"不是我的锅",再决定优化什么
上篇结尾我立了个 flag:固定 VU 的闭环压测有协同遗漏------系统变慢时施压速率会自动掉下来,把长尾藏起来。这次一上来就用开环:
yaml
executor: 'constant-arrival-rate',
rate: 100, timeUnit: '1s', duration: '20s',
preAllocatedVUs: 100, maxVUs: 200,
而且我故意把 LLM 摘出去:单独开一个只走"工具 → 下游 HTTP → 降级"的编排端点,不碰模型。原因很简单------模型按 token 付费、单跳四秒多,拿它压测只会压出模型厂商的限流,压不出我自己的系统。
第一版结果(还没有缓存):
| 指标 | 值 |
|---|---|
| 请求 | 2000,失败 0,checks 100% |
| med | 5.29ms |
| p95 | 762ms |
| p99 | 1.2s |
阈值 p95<250 |
🔴 红 |
中位数 5 毫秒、p95 七百多毫秒 ------这个形状本身就在说话:网关代码不是瓶颈(否则 med 也难看),慢的是一小撮请求卡在下游(本机后端服务在 100/s 下变慢)。
到这里有个很实在的诱惑:把阈值从 250 调到 1000,报告就绿了。我没干。 因为这张表真正的价值是它告诉我下一步该动哪儿------给工具层加缓存、加熔断、加并发上限,而不是给仪表盘换个颜色。
加完缓存,同一份脚本、同一个工作集,A/B:
| 指标 | A:无缓存 | B:Caffeine 开 | 变化 |
|---|---|---|---|
| p95 | 836ms | 12.34ms | ↓ 约 98.5%(约 68 倍) |
| med | 5.2ms | 1.9ms | ↓ 63% |
| max | 1.91s | 676ms | 冷启动 / 缓存过期穿透 |
| 失败 | 0 | 0 | 一致性没变 |
| 缓存 | 关闭 | hit 1954 / miss_ok 46 | 命中率 97.7% |
p95<250 |
🔴 | 🟢 | 由红转绿 |
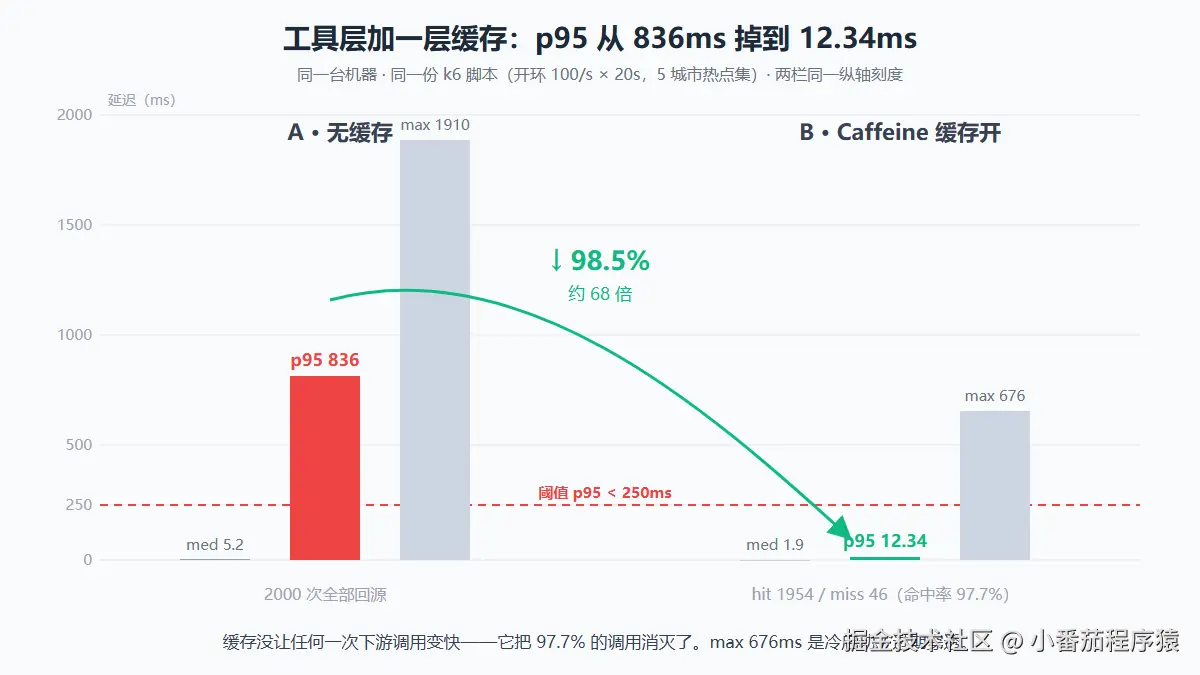
68 倍听起来像吹牛,其实特别朴素:查询结果几乎不变,我却每次都跑一趟后端 。缓存没有让任何一次下游调用变快------它只是把 97.7% 的调用消灭了。这跟"优化"是两回事,是"减少工作量"。
顺手呼应上一篇的结论:在这台 CPU 紧张的单机上,做减法等收益,加并发不等。
七、如果继续做,我会排这几件事
| 方向 | 为什么 |
|---|---|
| 多轮取中位数 + 归档 k6 summary | 见下面的局限,这是我最想补的一条 |
| 闭环 vs 开环对照 | 同一套系统跑两遍,量化协同遗漏到底低估了多少 p95 |
| 缓存加单飞(single-flight) | 过期瞬间会有一波并发一起回源,max 676ms 很可能就是这么来的 |
| 换 resilience4j | 手写的 Breaker 是用来讲机制的,生产要的是被淬炼过的实现 |
| 接 Langfuse | 现在我只知道"慢/成/败",还不知道"这一轮对话烧了多少、在哪一步跑偏" |
最后一条是评测 ,它比上面所有工程活都更"AI 特有",也确实给了我一个意外:只测最终答案是测不出问题的。 模型完全可以不调工具、凭常识就把"排名第三是谁"蒙对------这一次它蒙对了,下一次它就是蒙错。要抓这个,得评测调用轨迹(trajectory:有没有调、参数对不对)。这条线我单独写一篇。
八、局限(照例先说)
- 每个版本只跑了一轮 (100/s × 20s)。68 倍这个效应量远超单机运行间波动,方向不会翻,但精确倍数我不打包票。第二篇那种 ±40% 的跨批次方差在这里同样存在,正确做法是多轮取中位数------已列进第七节。
- 原始 k6 summary 我当时没归档到文件 ,只留了终端输出。这篇文章里的数字来自我自己的实验记录,第三方无法复算。下次起所有压测一律
--summary-export落盘,这条我现在就记下了。 - 命中率是工作集的函数 :5 个城市名、20 秒、2000 请求,是个高度偏斜的热点模型。真实查询分布更平,命中率会更低、收益会更小。这张表证明的是"缓存能消灭长尾",不是"你的系统能有 97.7%"。
- 环境是笔记本 + Docker 单机,下游后端和 Agent 服务抢同一批 CPU。所以 A/B 的差异里混着资源争抢,绝对值不代表任何生产容量。
- 熔断那组(5 真试 + 16 快拒)不是压测,是手工连打的功能验证,别把它当吞吐数据读;而且它只有累计计数、没有逐次日志(第五节那段已标出 5+16 对不上连打次数)。
- 缓存 TTL、超时、并发上限全是环境变量可调,我报的是当次跑的取值,换参数结论会变。
写在最后
这三篇跑下来,我最大的感触是:AI 应用工程化这件事,对后端来说几乎没有新东西。
可观测、超时、舱壁、熔断、缓存、开环压测------每一个都是分布式系统课本里的老词。真正新的只有一点:链路末端那个东西会自己编话,所以"降级"不只是保系统,还得保住"不胡说"。 其余部分,就是把后端那点老手艺,搬到一个新场景里再练一遍。
会做 Agent 的人不一定愿意压测,愿意压测的人不一定碰 Agent。我刚好站在中间。
八股可以被背,结论只能被跑出来。这是「高并发实测」系列第三篇。上一篇:《高并发写入实测:把最重的 MySQL 改回同步,QPS 反而涨了 38%》。再上一篇:《别再死背 44 字节了:Redis String 三种编码压测》。