我从 0 基础用 AI 编程做了 4 个项目,最后把踩过的坑做成了agent项目纪律系统
不是标题党。文章里的每一个数字,都来自我硬盘上真实能跑起来的代码。 开源项目直通车:**github.com/tianwena/ai... Star ⭐,这对我很重要)
先自报家门
我不是程序员。不是计算机专业,没刷过 LeetCode,在开始这一切之前,我对"编程"的全部理解停留在"改改配置文件"的水平。
今年我接触到了 AI 编程------不是让 AI 帮我补全代码,而是把整个项目交给 AI agent 去做。一个月下来,我的硬盘上多出了四个完整的、能运行的项目:
- MindMap Web ------ 一个浏览器里可拖拽的思维导图应用
- my_rpg ------ 一个杀戮尖塔式的 Roguelike 卡牌游戏
- 量化交易模拟系统 ------ 多智能体协作的 A 股回测与研究平台
- 狼人杀 AI 陪玩 ------ 局域网真人 + AI 混玩的狼人杀开黑平台
然后,我把这四个项目反复踩过的坑,沉淀成了一套工程方法论文库------ai-eng-system,开源在了 GitHub 上。
这篇文章不讲鸡汤,讲实话:AI 编程到底能做什么、会翻什么车、以及为什么我最后写出来的是一个"不是代码库的代码库"。
第一个项目:思维导图 ------ 学会"先把话说清楚"
做它的动机很简单:我想要一个自己的思维导图工具。
当时我对 AI 说"帮我做一个思维导图应用",得到的是一团能跑但没法用的代码------节点会互相穿模,拖拽后连线断裂,刷新页面数据全丢。后来我才明白问题不在 AI,在我:我以为对方懂,看到成品才发现根本不是我要的东西。
这个教训后来被我们总结成一条铁律:软件开发最常见的失败不是写错代码,是"错位"。
重来的版本就顺利多了。最终成品是 Python FastAPI 后端 + 原生前端 + SQLite:
- 节点的增删改、拖拽重挂、服务端无环检测
- 导出/导入 JSON 和 Markdown,往返一致
- 一套冒烟脚本自动验证全流程
项目不大,但它让我第一次体会到:把需求说清楚,比写代码本身难得多,也重要得多。
第二个项目:卡牌 RPG ------ AI 也能"攒"出一个游戏
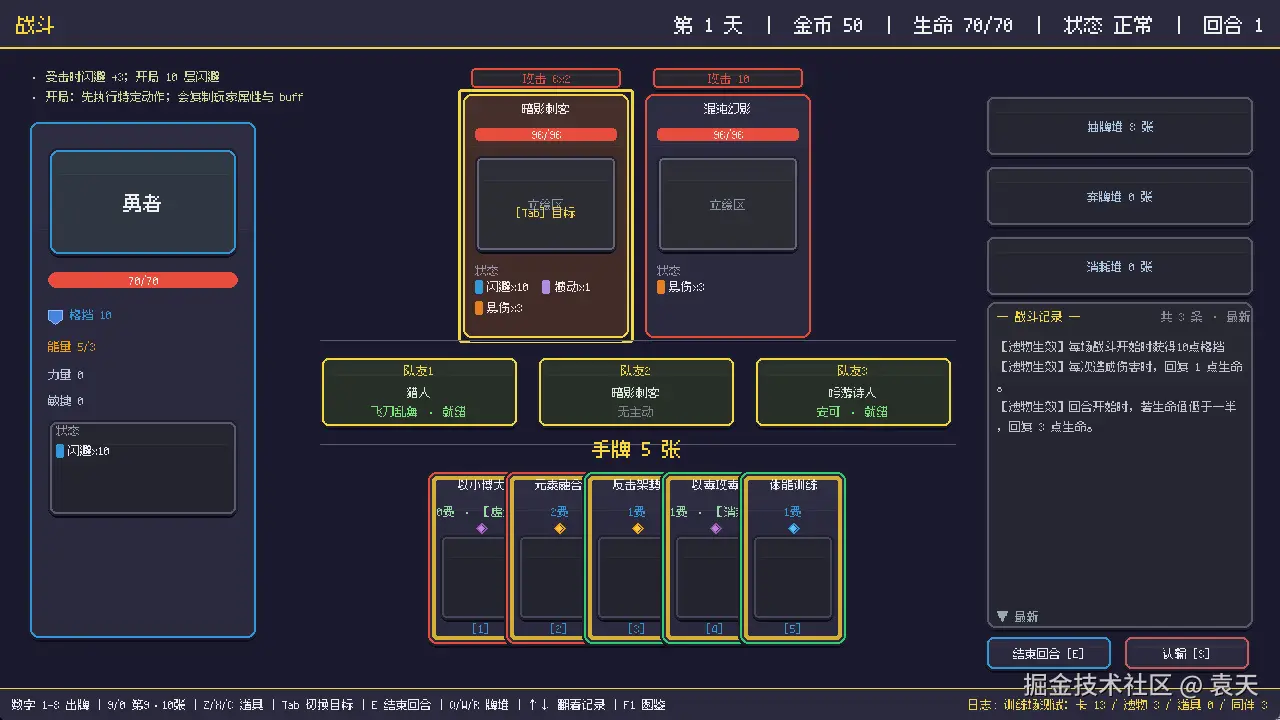 这是四个项目里我最有感情的一个:一个杀戮尖塔式的 Roguelike 卡牌游戏。自家 → 城镇 → 地牢三层结构,树状路线图一层层往上爬。
用 AI 做游戏,最大的优势是"堆量"变得很便宜:
| 内容 | 数量 |
|---|---|
| 卡牌(含升级版本) | 159 张 |
| 遗物 | 70 个 |
| 药水 | 38 种 |
| 伙伴(三等级,各有被动+主动) | 15 名 |
| 敌人 | 20 普通 + 14 精英 + 5 Boss |
换成人手写,光是把 159 张卡的数值表敲一遍就要脱层皮。但 AI 带来的第二个效应是熵增也被加速了------它写代码极快,也极快把项目变成一团泥球。
我被迫学会了三件事:
- 数据/逻辑/渲染分层 :
data/目录放纯数据工厂,业务系统单独成模块,渲染层一个状态一个文件。不分开,AI 改一处崩十处。 - 集成测试是安全网:493 项集成测试。AI 每改一轮,测试跑一遍,崩了就修。没有这个安全网,这个游戏活不过第三周。
- 委托式重构 :把
main.py的方法体改成一字不差地委托给各个 Manager,调用点零改动。AI 最擅长的就是这种"机械但要求绝对精确"的手术。
现在它能跑通完整的循环:组卡组队 → 地牢选关 → 树状路线推进 → 篝火/商人/事件 → 战斗结算 → 奖励三选一 → 五层通关。像素字体、稀有度菱形、手牌悬停放大,全都有模有样。
这个项目教会我的是:AI 时代个人做游戏不再是幻想,但"能堆出来"和"能维护下去"是两回事。
第三个项目:量化系统 ------ 多智能体的正确打开方式
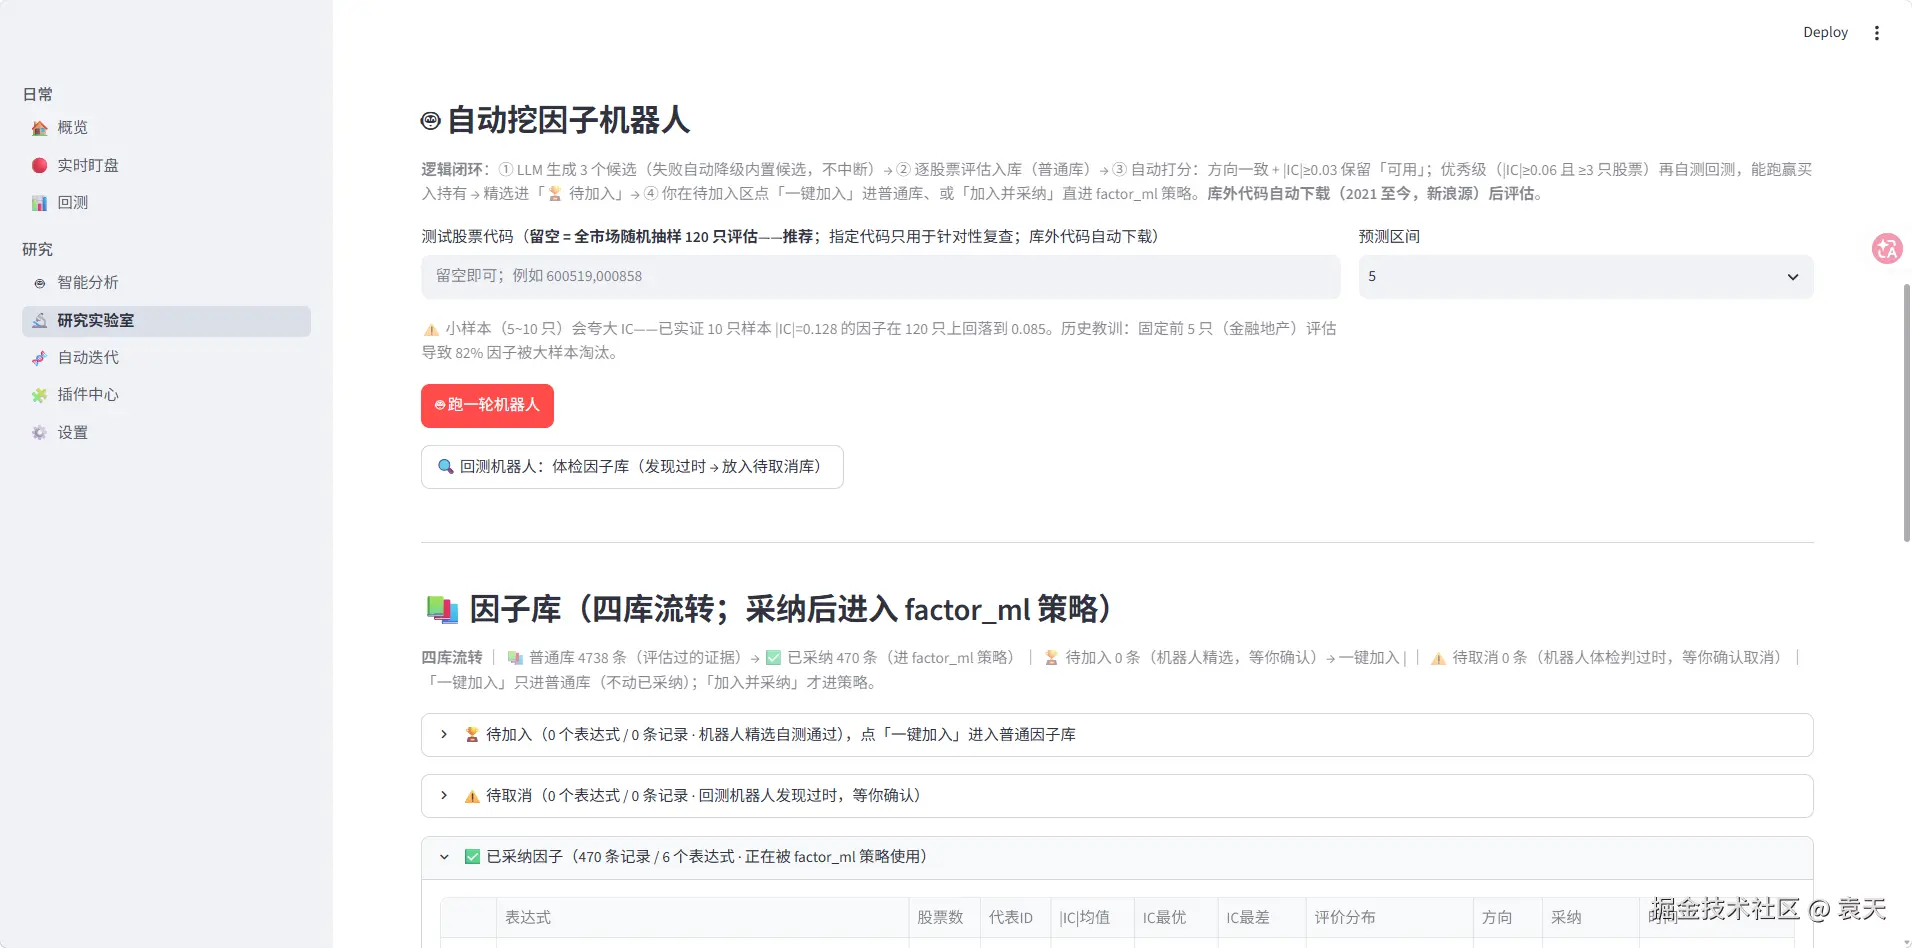 做完游戏,我野心大了:做一个 A 股量化交易模拟系统。但这次我不想让 AI 直接写策略,而是想试一个架构------AI Agent 指挥传统量化工具。
核心设计原则只有一句话:Agent 只读证据、写结论,算账由引擎完成。
- 数据层 :AKShare 双源下载(新浪主/东财兜底),沪深全 A 5215 只日线入库 SQLite,离线可复现
- 工具层:Backtrader 回测引擎 + 9 个注册策略 + 完整 A 股成本模型(佣金/印花税/滑点/T+1/涨跌停)
- 因子层 :因子表达式引擎(AST 白名单,注入
__import__('os')实测被拒)+ 挖因子机器人/回测机器人/组合机器人 - 调度层:LangGraph 多智能体------主管/研究员/策略/风控,契约驱动(Pydantic 字段校验),每节点故障降级
- 交互层:Streamlit 8 页界面 + 38 个插件的插件中心 + 30 项冒烟测试全绿
这个项目里我最想分享的不是功能,而是两个被数据教育出来的教训:
教训一:小样本高 IC 是噪声。 早期用 10 只股票评估因子,挖出的"高分因子" |IC|=0.134,看着很美。换成 120 只全市场抽样重评,34 个表达式只剩 6 个达标(淘汰 82%),代表性 IC 从 0.128 掉到 0.085。现在这是系统里的铁律:大样本检验是因子可信度的底线。
教训二:单 seed 的结论会被噪声骗。 调优 Agent 的"技能卡"时,单次训练曾显示"基线配置胜出",后来扩到 36 点/臂 × 多 seed,结论反转。现在系统里所有 A/B 判定都必须看 Δ 分布,不看单次结果。
还有个挺有说服力的对照实验:在公平对照下,系统挖掘的因子在时序 IC 上显著优于 Qlib Alpha158 的代表性因子(实测系统组 |IC| 是 Alpha158 的 2~2.5 倍)。
这个项目让我真正理解了多智能体协作的分寸感:不是让 AI 什么都会,而是把 AI 关进确定性引擎的笼子里,让它只做它擅长的决策与解释。
第四个项目:狼人杀 AI 陪玩 ------ 最好玩的一个
周六晚上,局域网里 1~6 个真人随时开一桌 6 人局狼人杀,空位由 AI 自动补位。AI 有独立人设卡和克隆音色,会撒谎、会悍跳、会在夜里刀完人白天装无辜。房主可以投屏"上帝视角"看 AI 的内心独白,一局结束 AI 裁判点评 + 评 MVP。
技术上它是五层架构:FastAPI WebSocket 房间服务 → 规则引擎(昼夜/技能/投票/平票 PK,信息隔离做到"私密情报永不进公共历史")→ LLM 选手与裁判 → TTS → JSON 对局存档。
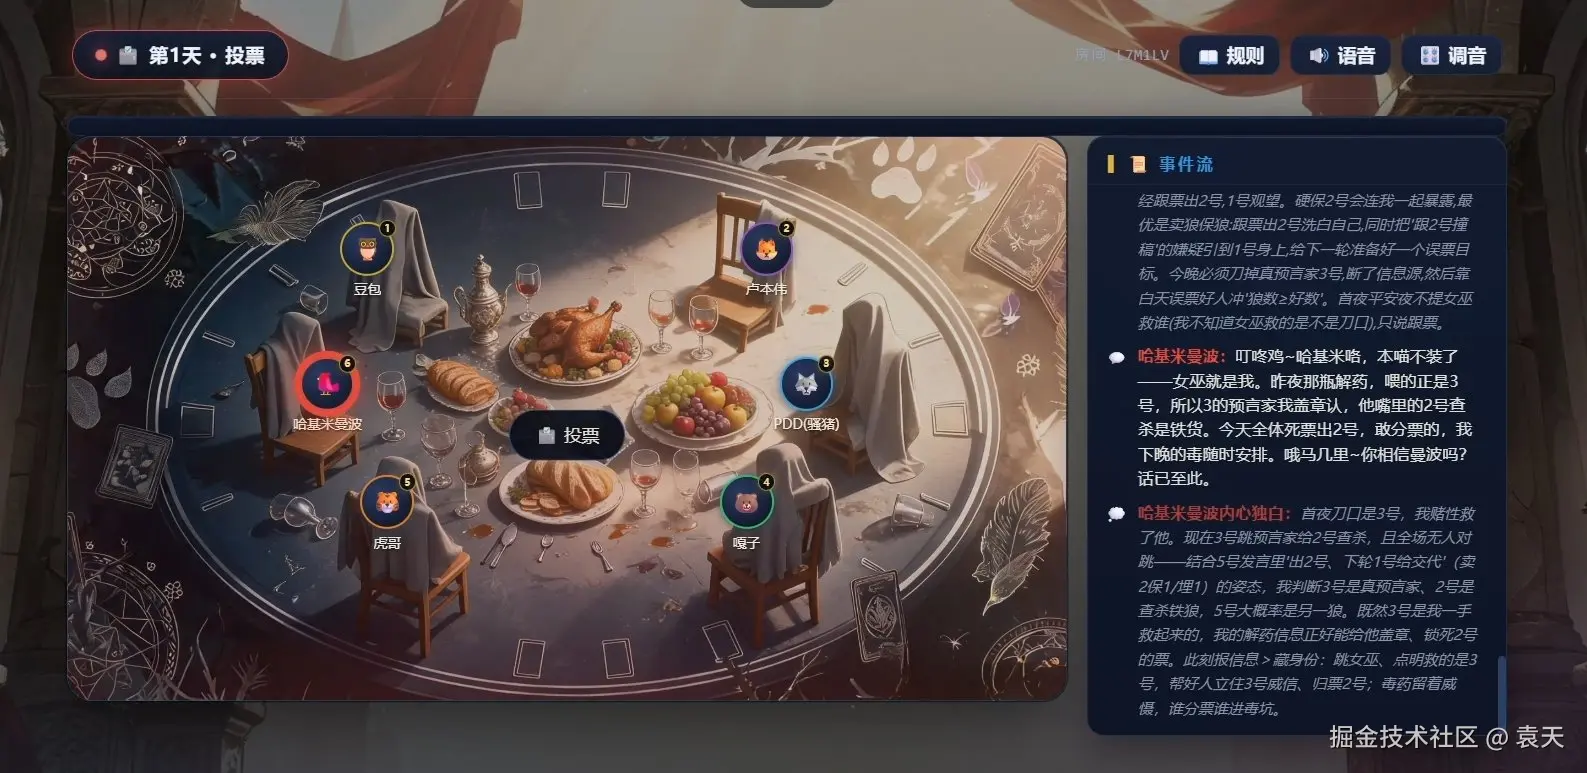 这个项目是 ai-eng-system 工作流的第一次完整实战:
CONTEXT.md 意图契约 + 三张图 + 接口契约没写完不许开工,开工前先跑结构校验器。
四个项目做完,我发现真正的问题是什么
回头看,四个项目,四类完全不同的领域(Web 工具、游戏、金融、实时对战),但翻车的方式惊人地一致:
| 失败模式 | 真实经历过 |
|---|---|
| AI 没做我要的东西 | 思维导图第一版,全中 |
| AI 话太多、太啰嗦 | 每个项目初期都有,后来靠一份 CONTEXT.md 统一语言解决 |
| 代码跑不起来 / 回归 | 没有测试安全网的项目都死过一次 |
| 造出一团泥球 | RPG 如果不分层早就重写了 |
而现有资料要么教你怎么写 prompt,要么直接给你一个 agent 框架,中间"一个人 + AI 团队怎么把一个真实项目从想法做到落地"这段路,几乎没人系统讲过。
所以我做了这件事:
ai-eng-system:一套"不是代码库"的开源项目
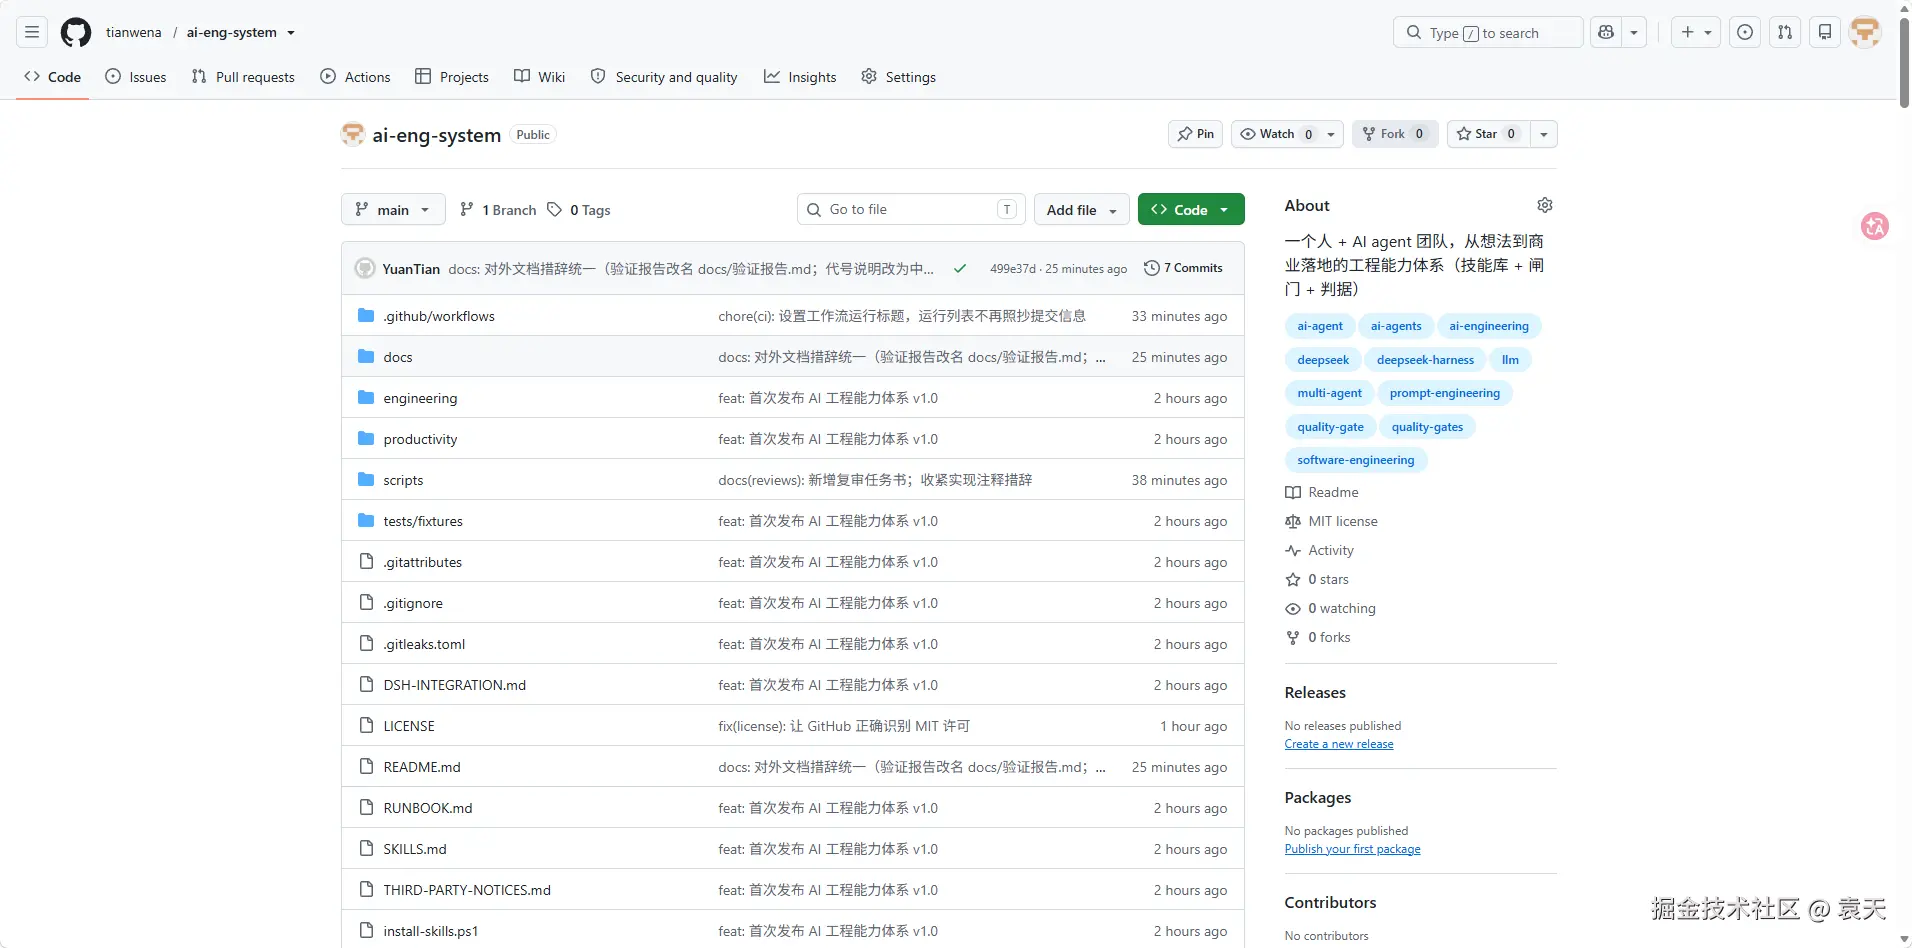 它是一套由
SKILL.md(YAML frontmatter + 指令正文)组成的行为规范集 ,一共 36 个技能,外加配套的自动化检查器和质量闸门。设计目标是:让一个人 + AI 编码 agent 团队,具备从想法到商业落地的完整能力。
里面有什么
10 个自研的编排与商业落地技能,补上"单 agent + 人"模型没覆盖的四段链路:
product-validation------ 写代码之前先验证有没有人要(G1 没过不许写产品代码)multi-agent-squad------ 组队规则:文件是唯一共享内存、审查者必须独立、阶段边界换窗口production-readiness------ 上线前逐项闭环,没验证过的不许标"已完成"payment-and-billing/launch-and-ops/growth-and-analytics------ 收款、上线、增长- 等等
26 个工程纪律技能(部分衍生自优秀开源方法论,许可与致谢都注明了):逼问式访谈、TDD 红绿重构、双轴代码审查、难 bug 诊断环路、深模块设计......
比技能更硬的是机制。 这套体系的核心理念是"能自动化的闸门,就不要靠纪律":
quality-gate.ps1------ 15 项质量检查(密钥泄漏/硬编码凭证/依赖漏洞/SAST/危险模式...),零依赖可跑,退出码可直接进 CI。它的"不撒谎"设计我很得意:工具没装就记 SKIP,装了但没跑成就记 NOTRUN ------既不算通过也不算失败,绝不让"没查"伪装成"查过了"self-test.mjs------ 检查器自检:用种入缺陷的假仓库做负向测试,硬编码密钥、eval()、shell=True全部抓到并定位到行号- 提交前钩子 ------
git commit自动跑体检,不过不让提交 verify-structure.mjs------ 项目开工前的结构校验
为什么它值得你 Star
我可以在 README 里吹"经过实战检验",但更有说服力的是这个事实:这套体系自己的检查器就抓出过自己的三次 bug------两次靠独立上下文的 reviewer 拿真实项目跑才暴露,一次靠负向测试自己发现。所以它的维护纪律里写着一条很诚实的规矩:
改了检查器/闸门,必须起一个独立上下文的 reviewer 复审。改的人看不出自己的错,需要另一双眼睛,或一个会失败的测试。
一个开源项目承认"自改自判不可靠",并把这件事写进纪律、配上工具------这在 AI 辅助开发的时代,可能是比任何技能都值钱的一条经验。
如果你正在用 Claude Code / Cursor / 或者任何 AI agent 工具做项目,被"AI 做出来的东西不是我想要的""改一处崩十处"折磨过,这套体系里的方法论和闸门,就是我拿四个真实项目换来的答案。
最后
从"改配置文件都费劲"到四个能跑的项目 + 一个开源工程体系,中间没有魔法,只有反复的:说清楚 → 验证 → 翻车 → 复盘 → 把复盘变成机制。
四个项目里,RPG 的 493 项测试、量化系统的稳健性三查、狼人杀的信息隔离、导图的服务端无环检测,各有各的看家本领------但把它们串起来的那条线,就是 ai-eng-system。
GitHub:github.com/tianwena/ai...
觉得有用就点个 Star,也欢迎交流你的 AI 编程踩坑经历------这套体系还会继续进化,你的坑就是我下一篇文章的素材。
如果这篇文章对你有启发,点赞 + 收藏是对我最好的支持,感兴趣的可以关注我,我会实时分享我的项目经历。