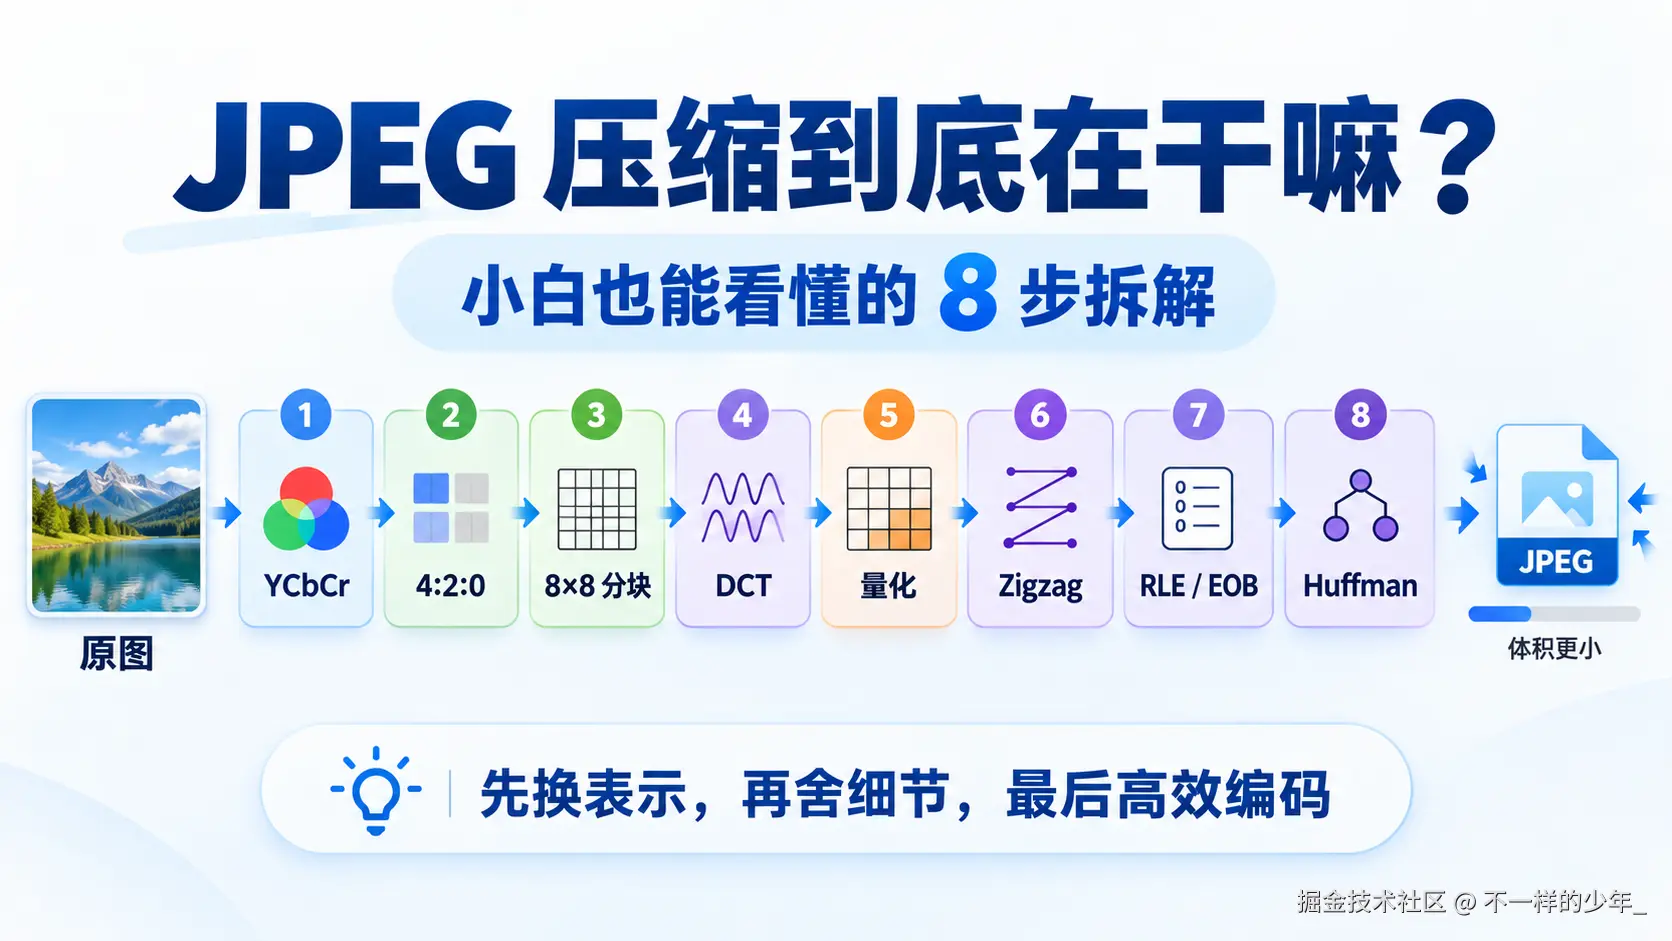
图:先整理图像信息,再做有损取舍,最后高效编码。
平时用 libvips 压缩 JPEG,你是不是也这样调参数?
80 太大了,试试 75。75 还是大,再降一点。怎么文字开始糊了?赶紧调回去......
想调得有依据,我们得先弄懂:JPEG 到底省掉了什么?
先记住三句话:换一种表示方式,舍弃一部分信息,再把剩下的数据写得更省。
本文讲的是常见的 8 位、DCT 型有损 JPEG,以 YCbCr、4:2:0 和 Huffman 编码这条路线为例。4:2:0 很常见,但不是所有 JPEG 都必须用。
第 1 步:RGB → YCbCr,先把亮度和颜色拆开
我们熟悉的 RGB,是用红、绿、蓝三个值描述一个像素。转换成 YCbCr 后,可以通俗地理解为:把"有多亮"和"偏什么颜色"分开记录。
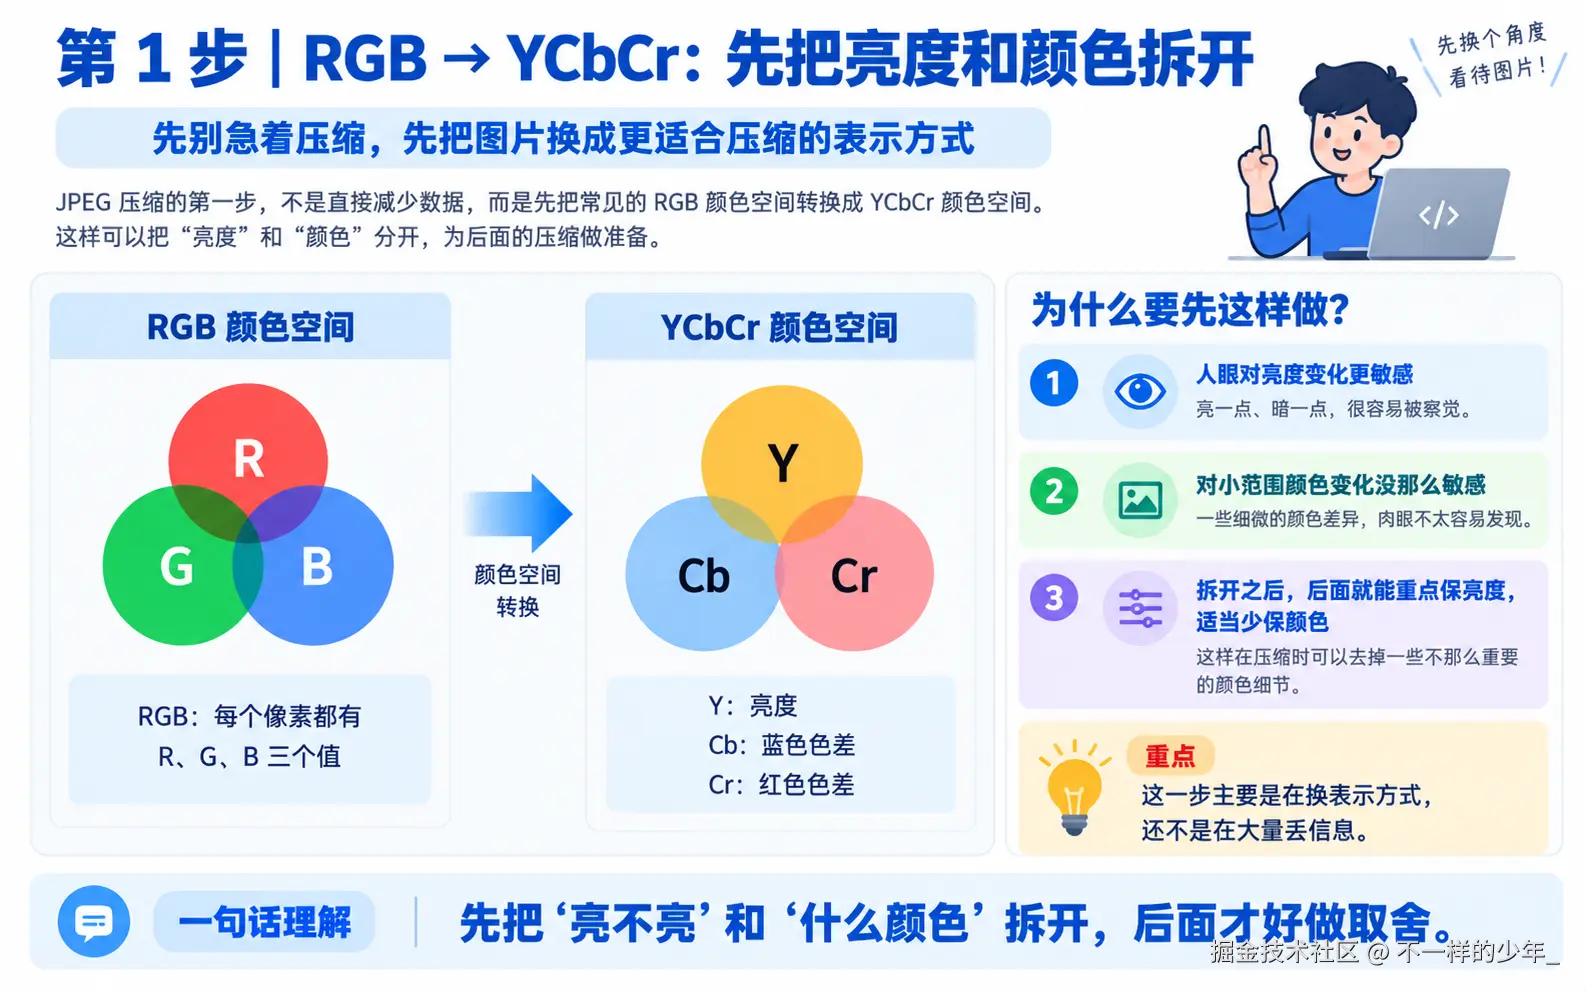
图:Y 近似描述亮度,Cb、Cr 描述蓝色色差和红色色差;不是三张独立的彩色原图。
为什么要拆?人眼通常对精细的亮度变化,比对同样精细的色度变化更敏感。比如黑字白底的笔画稍微糊一点,我们就容易察觉。
拆开以后,编码器就能区别对待:亮度认真记,颜色在合适的时候少记一些。
这里的 Y 严格说是 luma,本文为方便理解称作"亮度"。颜色转换主要是在换表示方式,不是后面大规模丢细节的那一步;实际计算也可能有舍入误差。
第 2 步:4:2:0 色度降采样,颜色少记几份
4:2:0 不是把四个像素合成一个,而是降低 Cb、Cr 的采样密度。
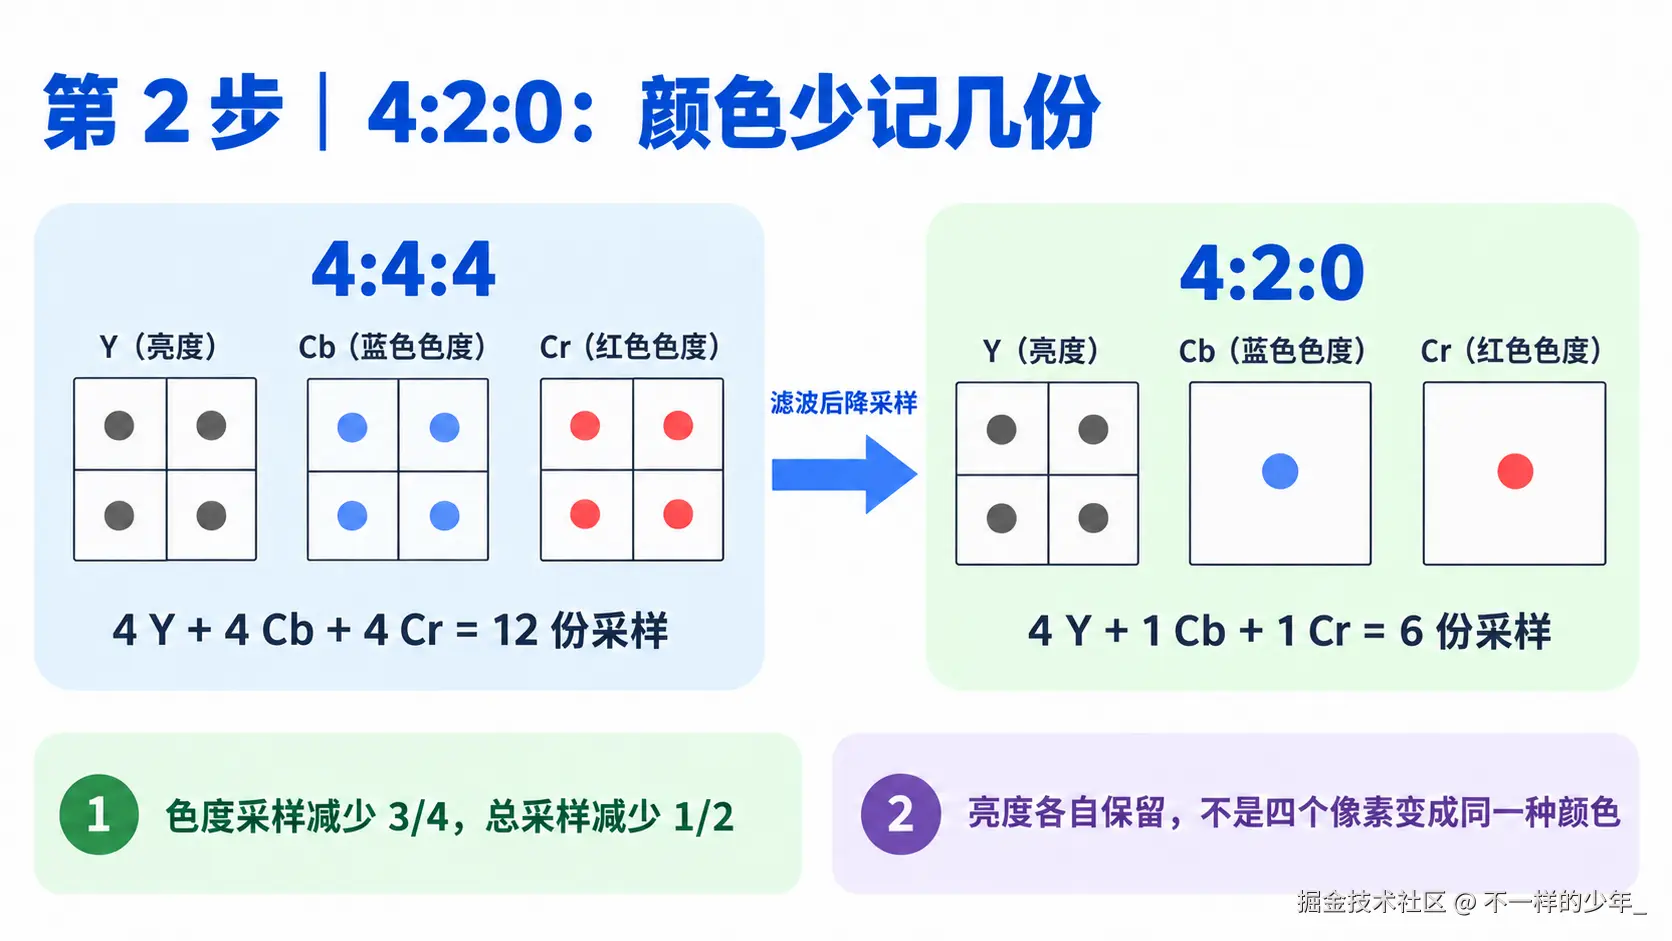
图:相对 4:4:4,色度采样减少 3/4,三分量的总采样数减少一半;这不等于最终文件体积减半。
看一个 2×2 区域,区别就清楚了:
| 采样方式 | Y | Cb | Cr | 合计 |
|---|---|---|---|---|
| 4:4:4 | 4 个 | 4 个 | 4 个 | 12 份 |
| 4:2:0 | 4 个 | 1 个 | 1 个 | 6 份 |
这一个 Cb、Cr 通常由附近的色度值经过滤波、降采样得到。可以理解成"附近几个颜色信息,合成一份有代表性的记录",不是随便挑一个,也不一定只对这四个值做简单平均。
解码时,再用插值等方法把色度扩展回需要的尺寸。四个位置仍有各自的 Y,因此不是四个像素变成同一种 RGB 颜色。但颜色信息确实损失了,重建后的 RGB 值也可能改变。
很多自然照片不容易看出差异;彩色小字和锐利的颜色边界,却可能出现颜色发糊。不是人眼一定察觉不到。
例如一张 1920×1080 的图,在 4:2:0 下:Y 是 1920×1080,Cb 和 Cr 各是 960×540。色度的宽、高都减半了。
第 3 步:Y、Cb、Cr 各自在自己的平面里按 8×8 分块
这里的一个块,是某一个分量平面中的 64 个采样值,不是同时装着 RGB 三种值的 64 个像素。
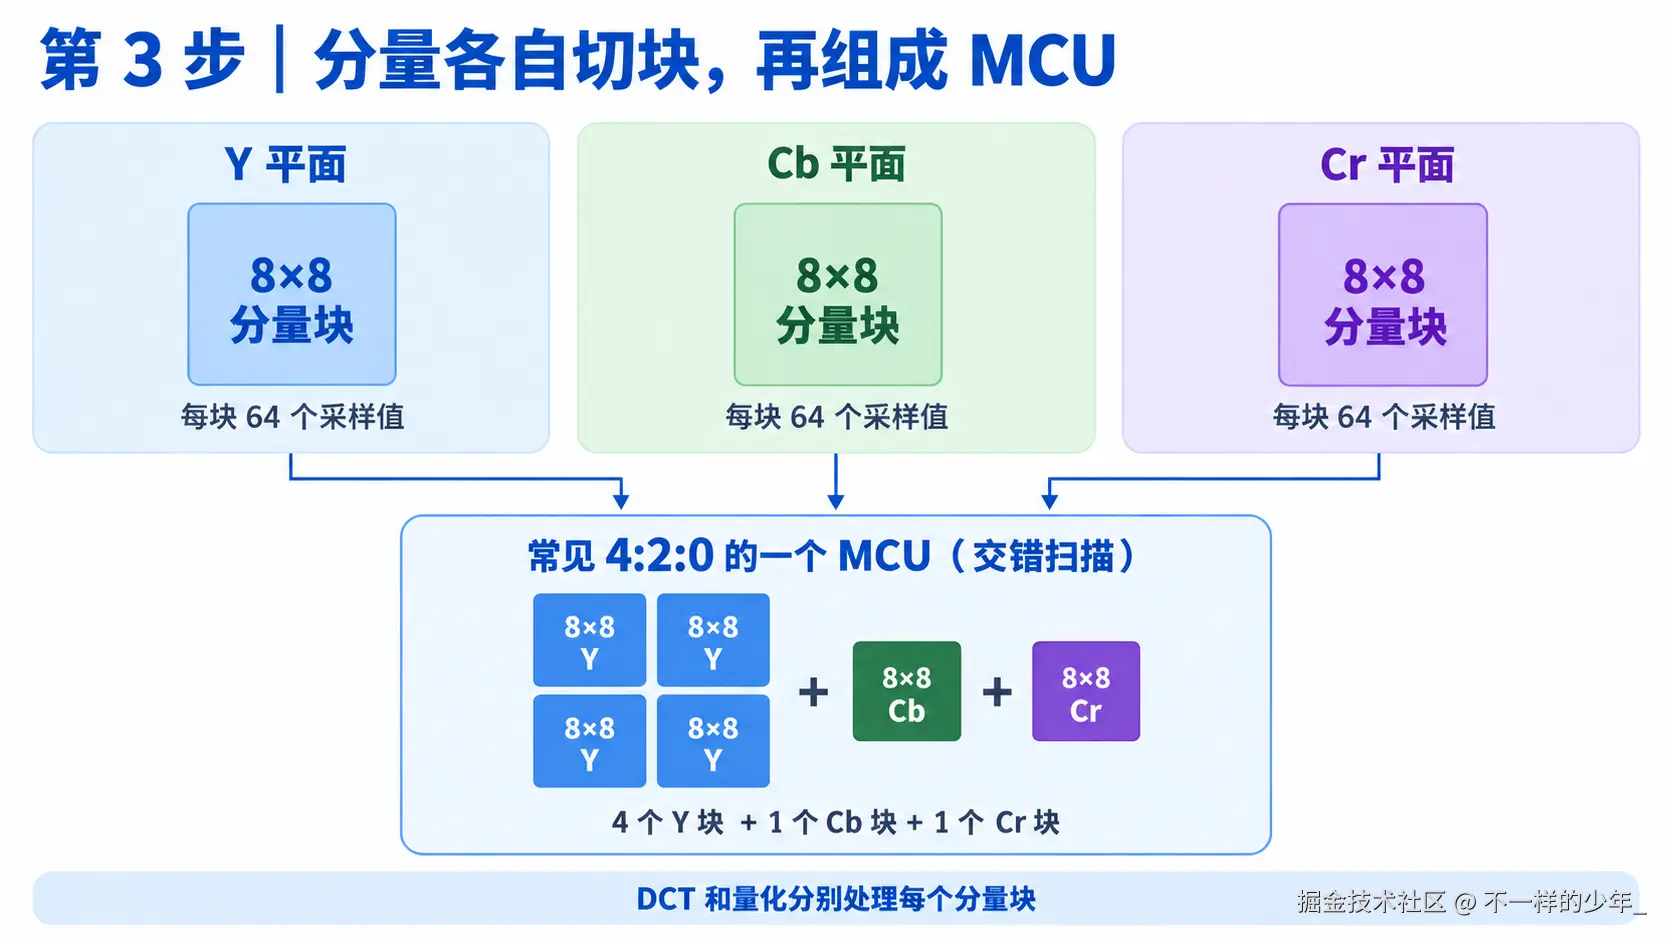
图:分块是各做各的;MCU 则按照采样关系,把相关的块组织在一起。
后面的 DCT、量化和 Zigzag,都会分别处理这些 8×8 的 Y、Cb、Cr 分量块。边缘不足一个完整块时,编码器会补齐处理,解码后的显示尺寸仍是原尺寸。
为什么经典 JPEG 选择 8×8?
不是整张图不能做 DCT,而是小块便于利用局部规律,也方便控制计算量和内存。比如天空和文字,不必放进同一个巨大的变换里处理。
8×8 是压缩效率、计算成本和失真表现之间的工程折中,并不是"只有这个尺寸才能分出高低频"。
顺便补充:这些块怎样组成 MCU?
JPEG 编码时,还会按照采样关系,把相关的数据块组成 MCU(Minimum Coded Unit,最小编码单元)。
在常见的 4:2:0 交错扫描中,一个 MCU 通常包含:
text
4 个 8×8 的 Y 块
1 个 8×8 的 Cb 块
1 个 8×8 的 Cr 块
它对应原图中一个 16×16 的亮度区域。先记住这个组合就够了,不必把 MCU 和单个 DCT 块混为一谈。
第 4 步:DCT,把分量采样值翻译成频率系数
像素位置上的值,不会直接告诉我们"哪里是缓慢变化,哪里是快速变化"。DCT(离散余弦变换)就是换个角度描述它们。
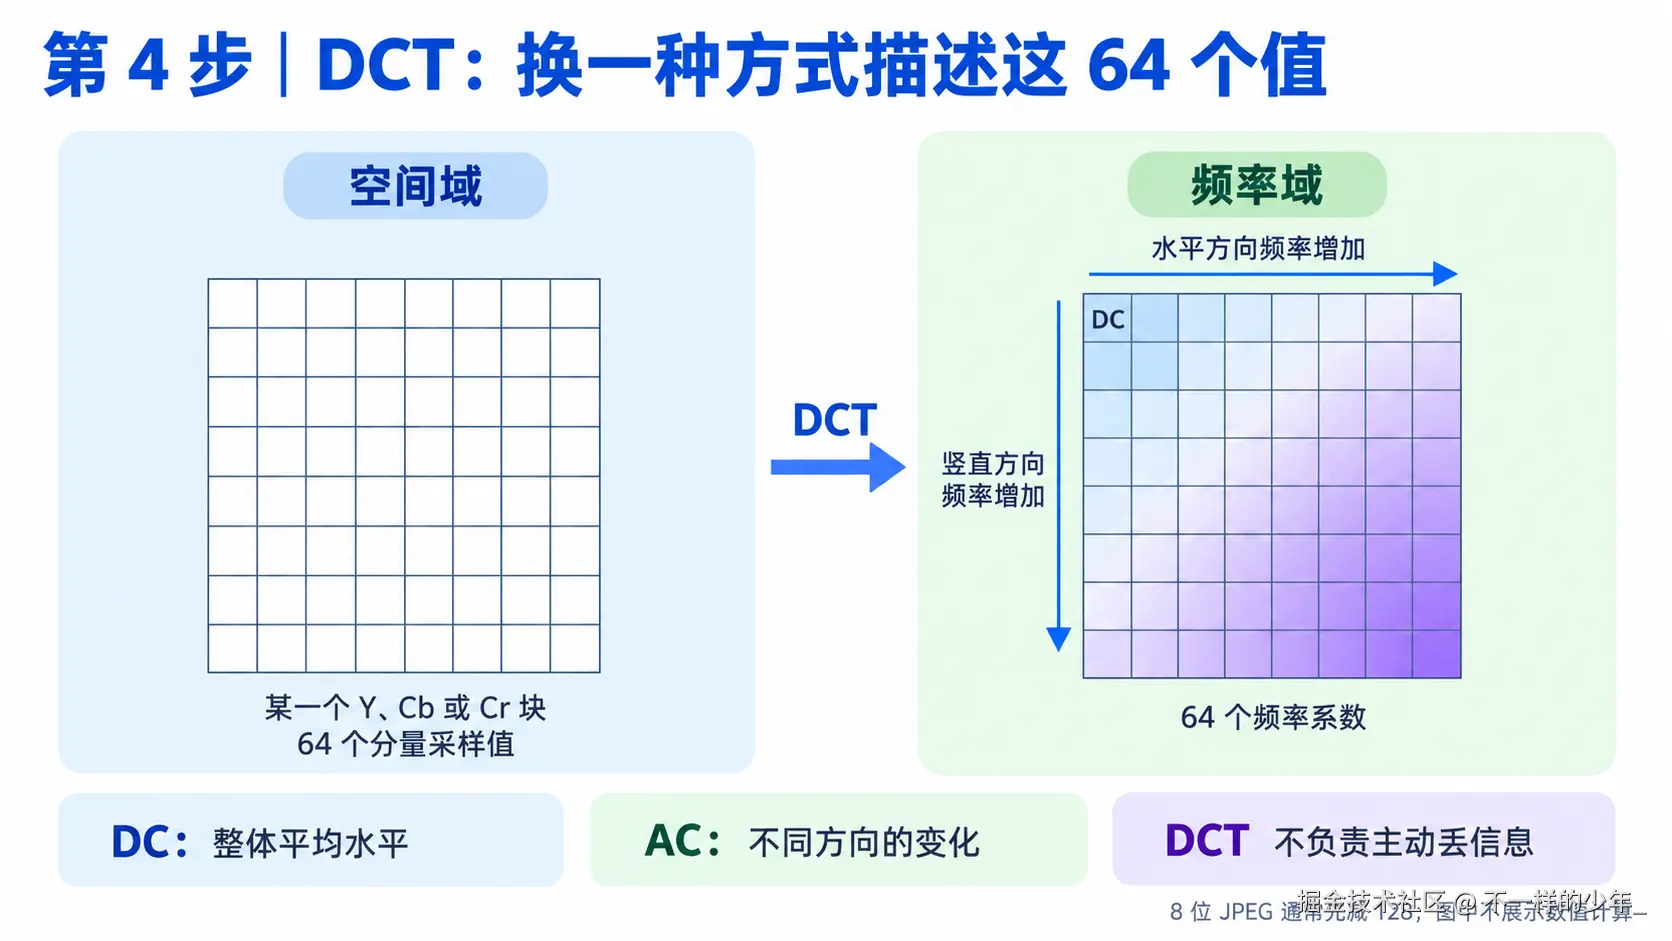
图:输入与输出都是 64 个数,但含义变了;右边不是另一张像素图。
- 变换前,空间域:每个位置的 Y、Cb 或 Cr 采样值是多少?
- 变换后,频率域:这个块的整体水平怎样?有哪些不同方向、不同快慢的变化?
常见 8 位 JPEG 在 DCT 前,还会先把采样值减去 128,让数据以 0 附近为中心。这里先不展开公式,重点看这些数的含义如何变化。
左上角和右下角是什么意思?
最左上角的 DC 系数 对应块的平均水平;另外 63 个是 AC 系数,描述不同方向和频率的变化。
沿矩阵向右,水平方向频率增加;向下,竖直方向频率增加。左上附近是低频,右下是两个方向都较高的频率。不是只有右下角才有高频。
频率看的不是"颜色总共差多少",而是"在多短的距离里变化":
- 从黑到白慢慢过渡,总差值很大,但平滑渐变主要是低频。
- 文字边缘、细线和密集纹理在很短距离内快速变化,通常包含较多高频。
- 纯色色块内部变化很少,高频主要来自它的边界。
如果处理的是 Y 块,讲的是明暗变化;如果处理 Cb、Cr 块,讲的是色度变化。
DCT 会删信息吗?
DCT 本身不负责主动丢信息。理想数学变换可以逆变换回去;实际实现有有限精度误差,DCT 系数也不天然都是整数。
自然照片的局部区域通常比较平缓,变换后往往能用少量低频系数承载较多能量。把信息分开表示以后,下一步才方便有针对性地降低精度。
第 5 步:量化,频率信息的精度在这里丢失
量化的做法,可以先理解成:每个 DCT 系数除以对应的量化步长,再取整。
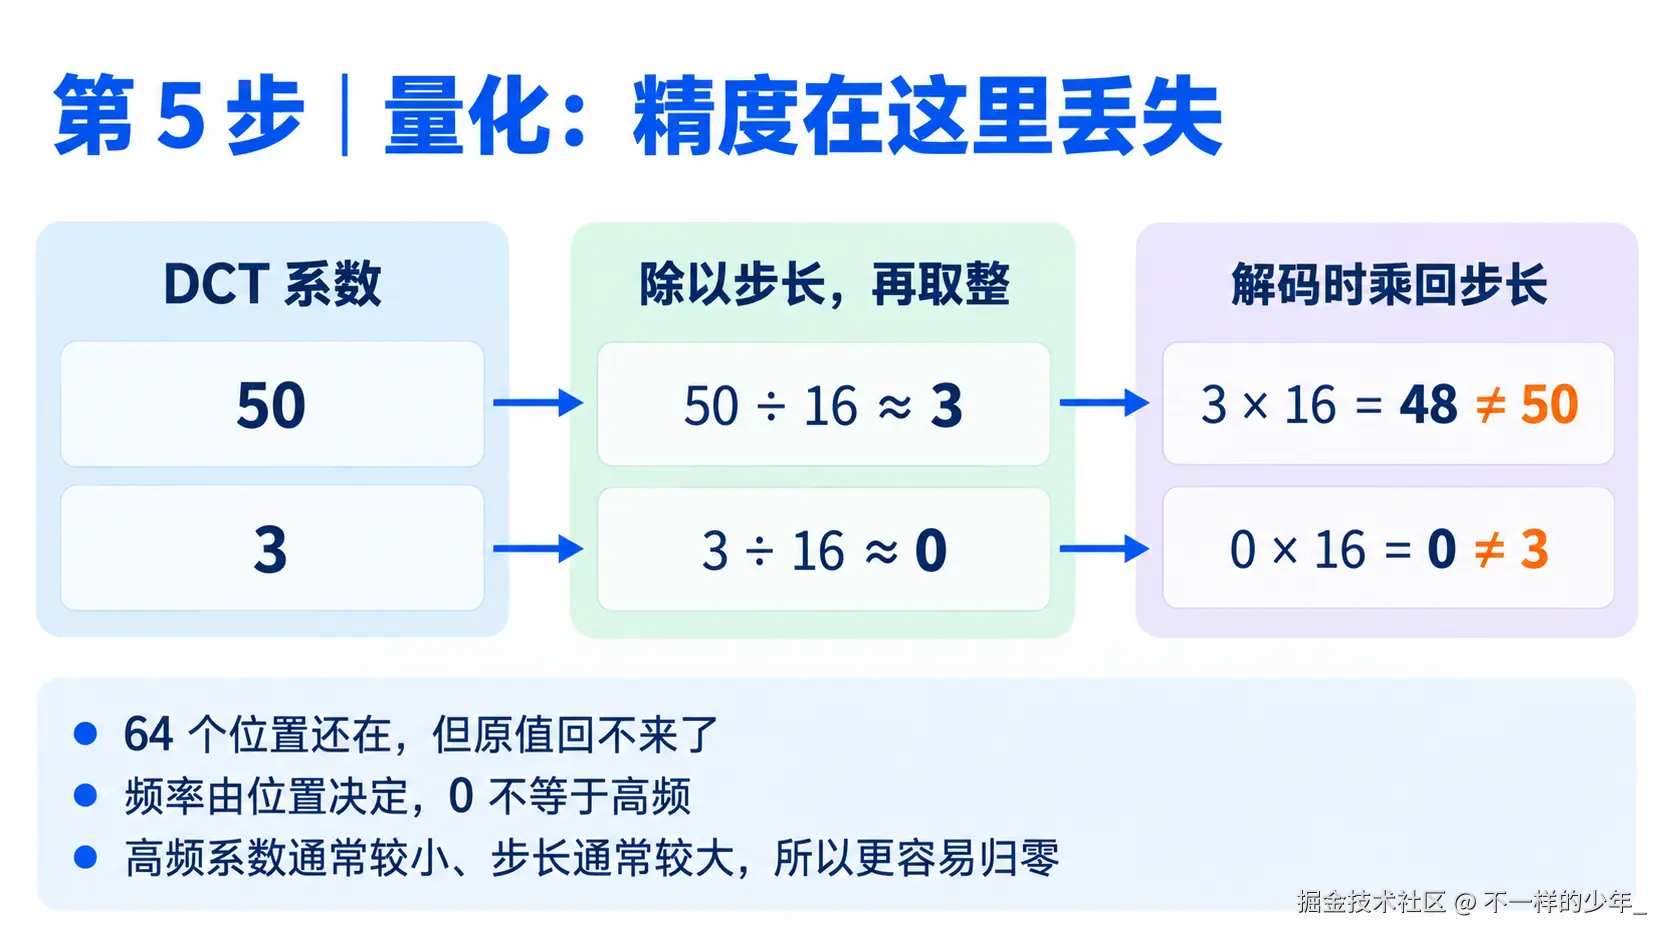
图:50 除以 16 后取整成 3,解码时乘回去得到 48,而不是原来的 50。
先看一个小例子
下面用 4×4 缩小示意,便于阅读;实际 JPEG 块是 8×8。这不是上一节某张图的真实 DCT 计算结果。
text
DCT 系数          量化步长           取整后的结果
50 20 10 5        16 11 20  40       3 2 1 0
20 10  5 2        12 15 30  60       2 1 0 0
10  5  2 1        20 30 60 100       1 0 0 0
 5  2  1 1        40 60 100 120      0 0 0 0
这里按正数四舍五入计算,例如 10÷20=0.5,取整得到 1。很多小系数则变成了 0。
到底丢掉了什么?
**不是删除矩阵的位置,而是丢掉系数的精度。**实际的 8×8 矩阵仍然有完整的 64 个位置。
例如,50÷16 取整后是 3,恢复时只能算出 3×16=48;3÷16 取整后是 0,恢复时只能得到 0。解码器不知道原来到底是 3,还是另一个也被取整成 0 的数。
所以不仅变成 0 的系数会损失信息,仍然非 0 的系数也可能丢失精度。
为什么高频区域更容易出现大量 0?
通常有两件事叠在一起:
- 自然照片的局部能量往往集中在低频,高频系数的幅度通常较小。
- 常用量化表对高频位置使用的步长通常较大。
本来就小,再除以一个较大的数,取整后自然更容易变成 0。例如 3÷16=0.1875,取整就是 0。
**0 本身不代表高频,矩阵位置才决定频率。**低频也可能为 0,高频也完全可能保留非 0 值。
这样设计,是为了利用人眼对许多细微变化相对不敏感的特点。但文字轮廓也包含高频,不能理解成"高频都没用,删光也没关系"。
质量参数主要在调什么?
libvips 保存 JPEG 时用的是 Q。在其他条件相近时,通常可以这样理解:
Q较高:量化较轻,精度保留得更多,文件通常更大。Q较低:量化较粗,细节损失更多,文件通常更小。
Q=80 不代表"保留了 80% 的画质"。而且 libvips 在自动色度采样模式下,Q 还会影响是否启用色度降采样,后面会具体说。
到这里,主要的有损取舍已经发生了。接下来的步骤是在把量化后的数据写得更省,不是继续删高频。
第 6 步:Zigzag,按固定顺序重排系数
不改任何值,不删除任何位置,只把二维矩阵排成一维序列。
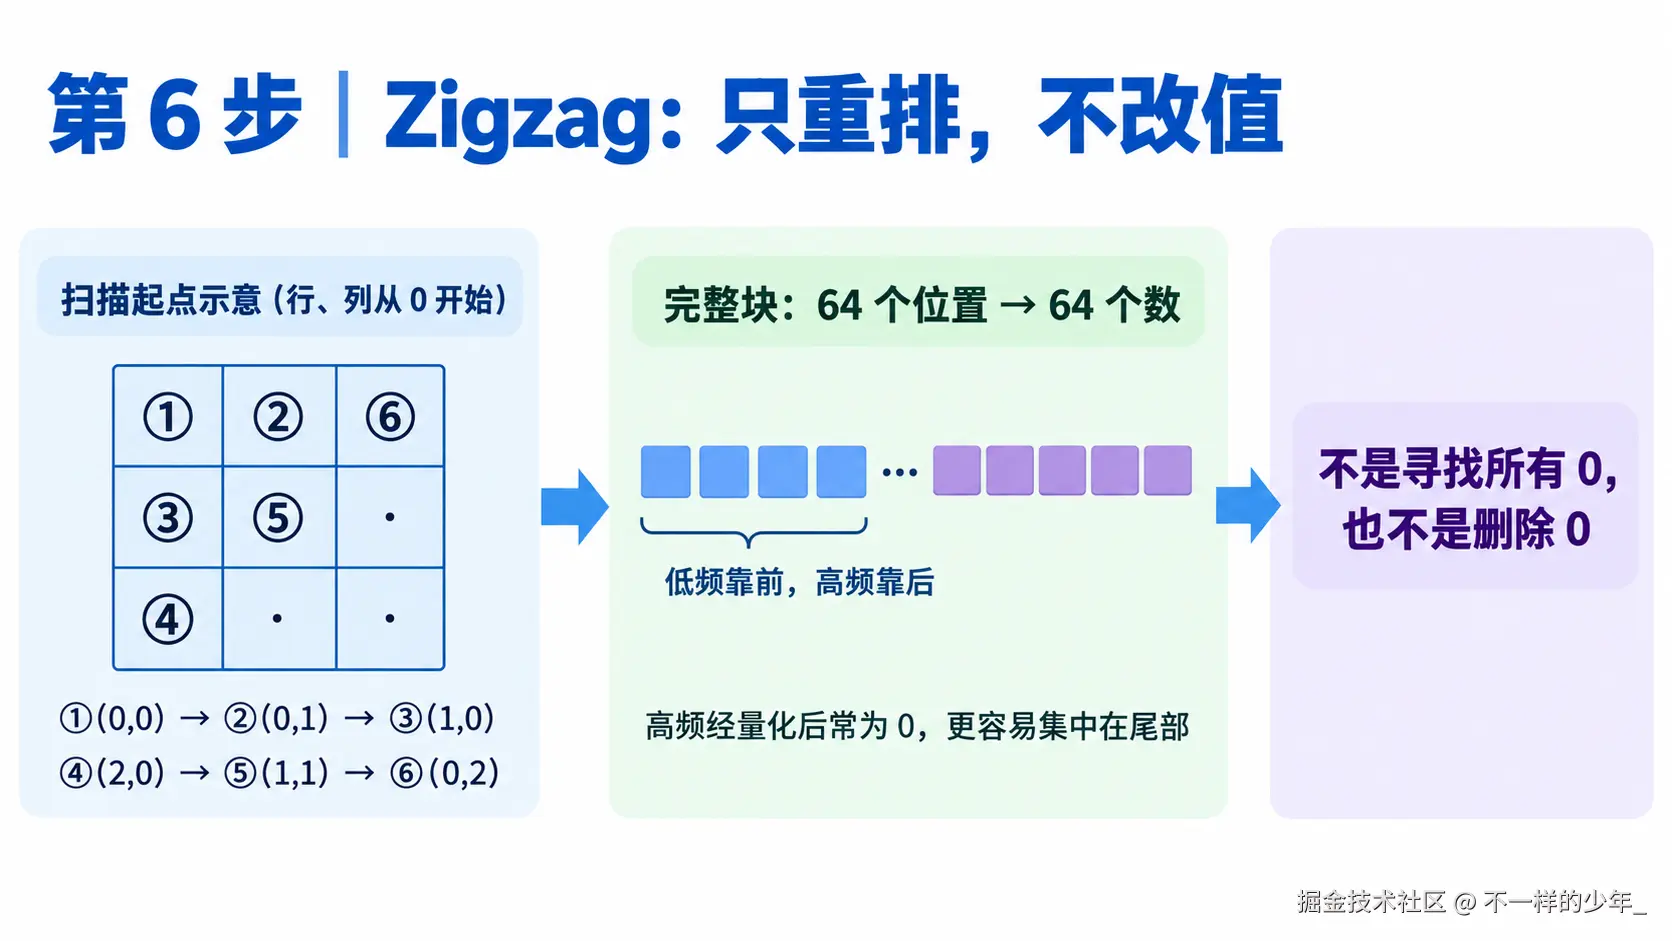
图:左边只画了扫描起点;实际会按固定顺序遍历完整的 8×8 块。
例如一个量化后的块是:
text
8 4 2 1 0 0 0 0
4 2 1 0 0 0 0 0
2 1 0 0 0 0 0 0
1 0 0 0 0 0 0 0
0 0 0 0 0 0 0 0
0 0 0 0 0 0 0 0
0 0 0 0 0 0 0 0
0 0 0 0 0 0 0 0
按 Zigzag 顺序读取后,前 10 个数是:
text
8, 4, 4, 2, 2, 2, 1, 1, 1, 1后面接着 54 个 0,总共仍然是 64 个数。
这个顺序大体上让低频靠前、高频靠后。由于量化后的高频经常为 0,连续 0 就更容易出现在后半段。
注意,Zigzag 不是按数值大小排序,也不是专门搜出所有 0 再搬到末尾。它的扫描路径是固定的,不保证每个块的 0 都连续。
第 7 步:RLE / EOB,零不用一个个写
有了连续的 0,就可以少写一些重复记录,但不能让解码器搞不清它们原来在哪。
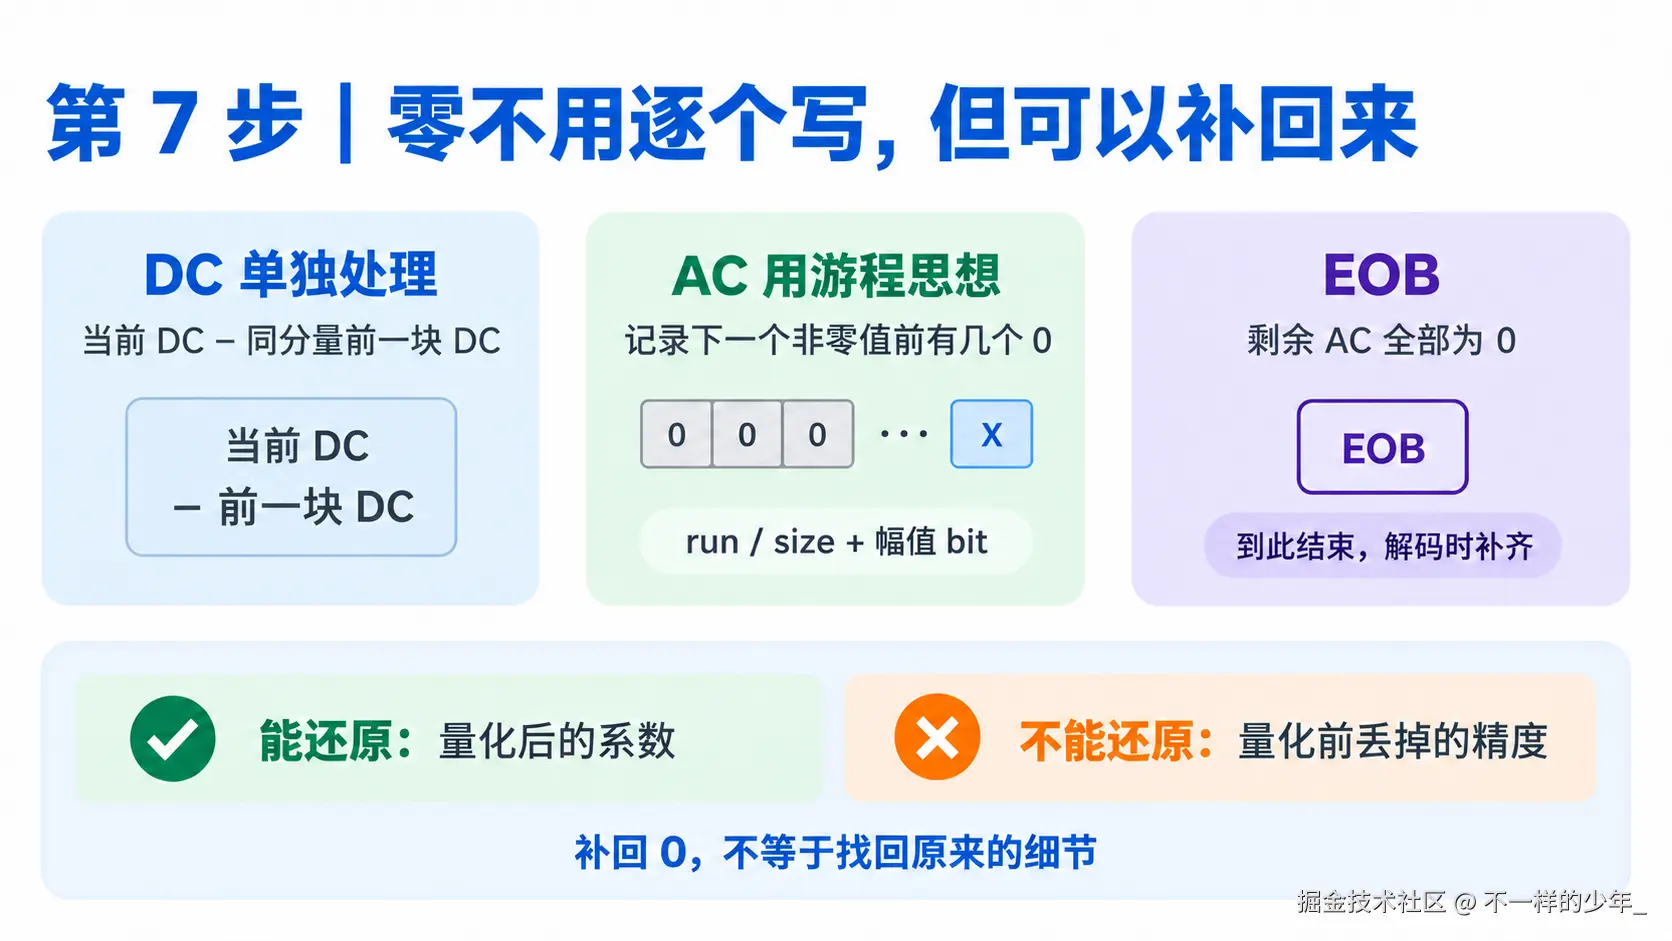
图:能补回的是量化后的系数,不能找回的是量化前已经丢掉的精度。
先把 DC 和 AC 分开:在常见的顺序编码里,DC 通常记录它与同一分量前一个块 DC 的差值;后面的 63 个 AC 才使用这里讲的游程编码和 EOB。
RLE(游程编码)的思想是:不必逐个写连续的 0,可以记录"下一个非 0 值前面有几个 0"。JPEG 实际用 run / size 符号描述零的个数和下一个非零值的幅值类别,再附上幅值 bit。连续 16 个 0 也有专门的 ZRL 符号。
EOB(End Of Block,块结束)更直观。假设 AC 序列开头是 3, -2, 1,剩下的 60 个 AC 都是 0,就可以用"3, -2, 1,后面全是 0"来理解它,而不必逐个写下那 60 个 0。这是概念表达,不是实际文件里的原样语法。
补回了 0,为什么图片还是回不到原样?
因为补回来的是量化后的 0。
原来的某个系数可能是 3,量化时已经变成了 0。后面的编码能保证这个 0 不丢,却不知道它原来是 3。
就像把"约等于 3"记得再准确,也找不回四舍五入前的 3.14。后半段无损,不等于整张图片无损。
解码器把 DC 和 AC 合起来,可以恢复量化后的完整 64 个位置;再做反量化、逆 DCT 等步骤,得到的是重建图像,不保证与原图一致。
第 8 步:Huffman,常见符号用更短的 bit
最后再省一次:经常出现的符号用短编码,较少出现的符号用长编码,降低总体长度。
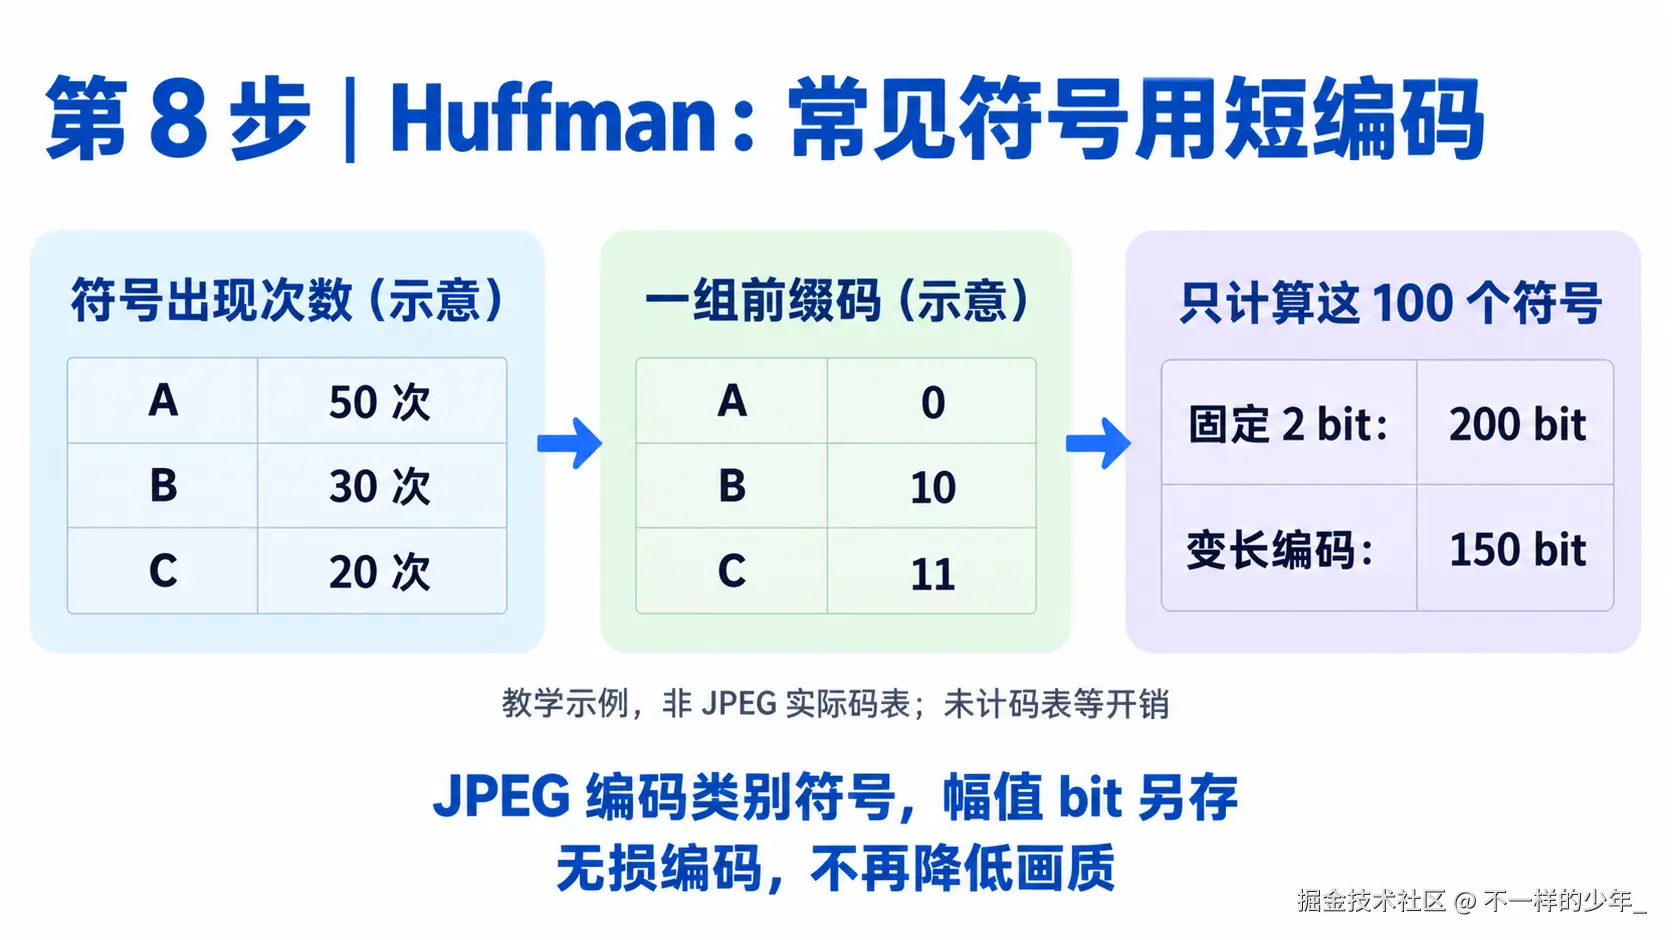
图:A/B/C 是通用教学示例,不是 JPEG 实际码表;计算只包含符号,不包含码表等开销。
例如 A 出现 50 次、B 出现 30 次、C 出现 20 次:
- 都用 2 bit,需要 200 bit。
- 用
A=0、B=10、C=11,需要 50×1+30×2+20×2=150 bit。
这些编码不会互相成为前缀,解码器可以分清每个符号。这里说的"出现频率",是符号出现的次数,和前面图像里的高频、低频不是一回事。
JPEG 的 Huffman 主要编码 DC 的幅值类别、AC 的 run / size、EOB 等符号。具体幅值所需的额外 bit 仍要保存,不是只留下一个 Huffman 符号就够了。
Huffman 不再降低画质,只改变存储方式。编码数据还要连同量化表、码表、尺寸等必要信息组织起来,才成为可解码的 JPEG 文件。
为什么照片通常合适,UI 截图却容易出问题?
自然照片常有平缓区域和连续渐变,小误差也容易被丰富的画面掩盖。JPEG 通常能在文件大小和观感之间取得不错的平衡。
UI 截图不同:文字、细线和图标往往靠干净利落的边缘传达信息,稍微变糊就很明显。
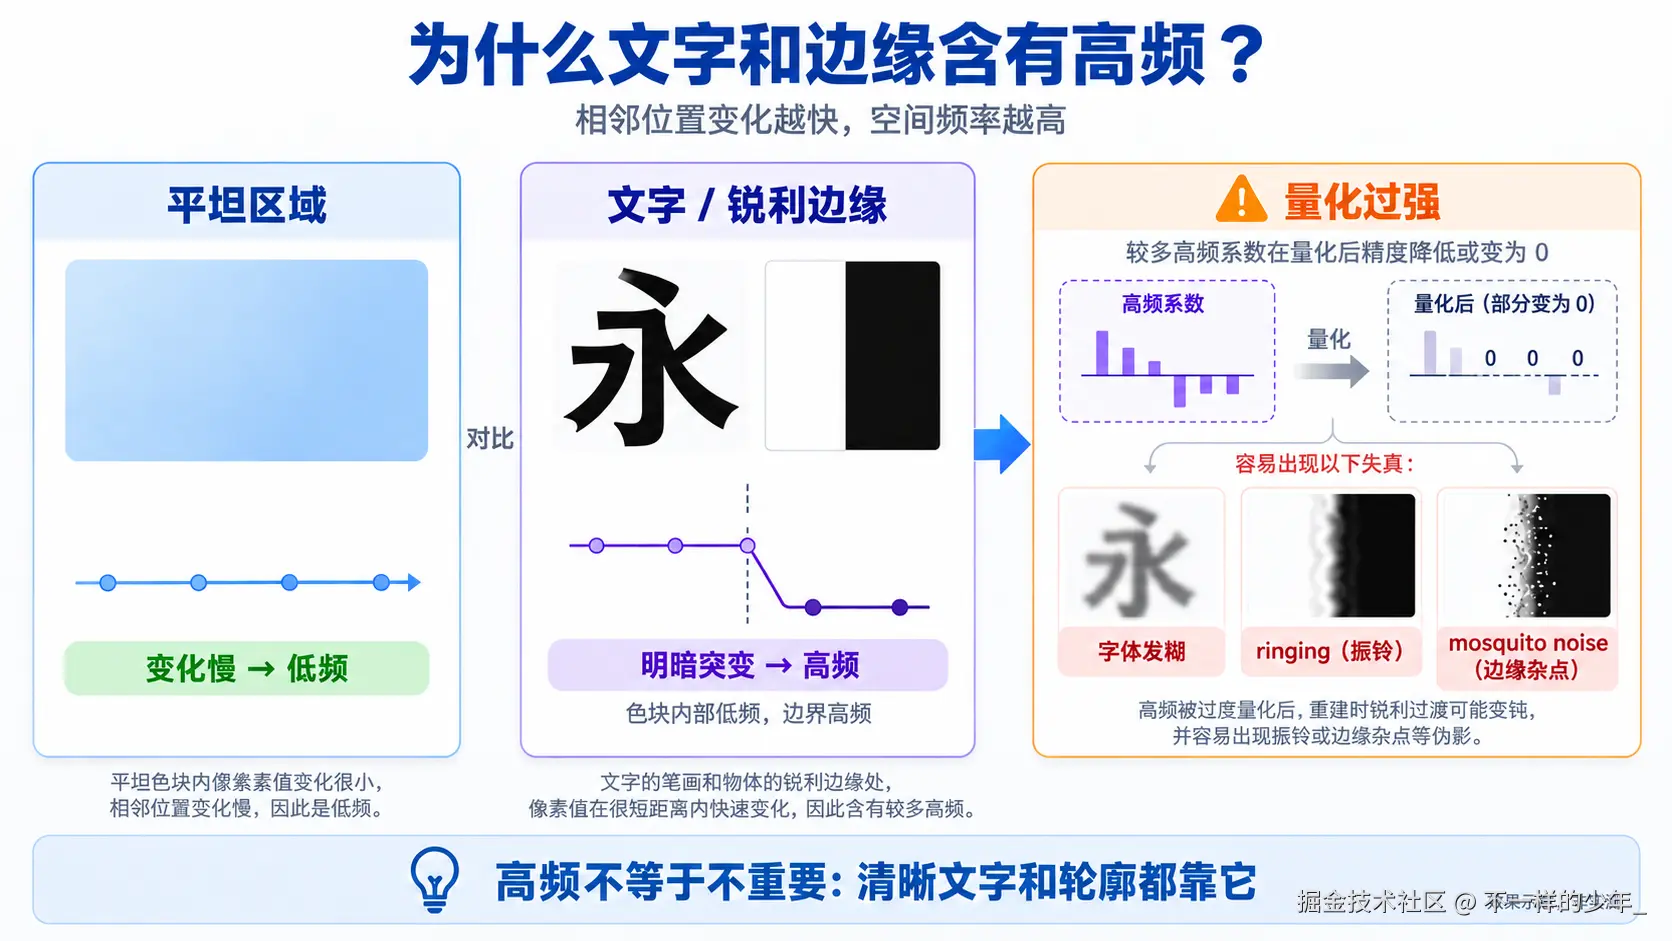
图:高频与失真的效果示意,非 libvips 实测压缩对比。纯色色块内部平缓,边界才包含快速变化。
量化过强时,描述快速变化的系数损失精度,重建就难以拼回原来的锐利边缘:
- 模糊:陡峭的边界被还原得更平缓,字就糊了。
- 振铃(ringing):边缘附近出现明暗波纹,像多了一圈影子。
- 蚊式噪声(mosquito noise):高对比度边缘附近出现细小、杂乱的痕迹。
- 块状感:相邻块重建后的边界不够连贯,压缩很重时能看出小方块;不只会出现在文字边缘。
色度降采样也可能让彩色细线、彩字边缘发糊。纯色色块内部本身并不难压,难的是把它的边界保持干净。
回到 libvips:这几个参数分别在调什么?
以 libvips 的 JPEG 保存操作 jpegsave 为准,实际参数名是下面这些。不要把通用说法 quality 当成它的参数名。
| 参数 | 通俗理解 | 主要影响 |
|---|---|---|
Q |
精度留多少,默认 75 | 主要控制量化;自动采样时也影响色度采样选择 |
subsample_mode |
色度要不要少采一些 | auto 自动选择,off 禁用,on 启用 |
optimize_coding |
为这张图优化 Huffman 表 | 通常能省一些体积,不额外损失画质 |
interlace |
使用渐进式 JPEG | 改变扫描组织和显示方式,不是提高图像质量 |
一个容易漏掉的细节:按 libvips 文档,subsample_mode=auto 时,Q >= 90 会禁用色度降采样。因此,只改 Q 跨过这个阈值,可能同时改变量化和采样方式。见 libvips jpegsave 官方文档。
如果只是想比较量化强弱,先固定 subsample_mode,再调整 Q,结果会更容易解释。对文字或彩色细线敏感时,可以对比关闭色度降采样的效果;但关闭它不等于消除量化失真。
Q=100 也不应当当成无损保存的保证。需要精确保留原始像素值时,不要靠提高 JPEG 质量参数代替无损格式。
PNG 压到 256 色,和 JPEG 有什么区别?
两者通常都不改变图片尺寸和像素格子数量,但格子里的 RGB 值都可能改变。区别是怎么减少信息。
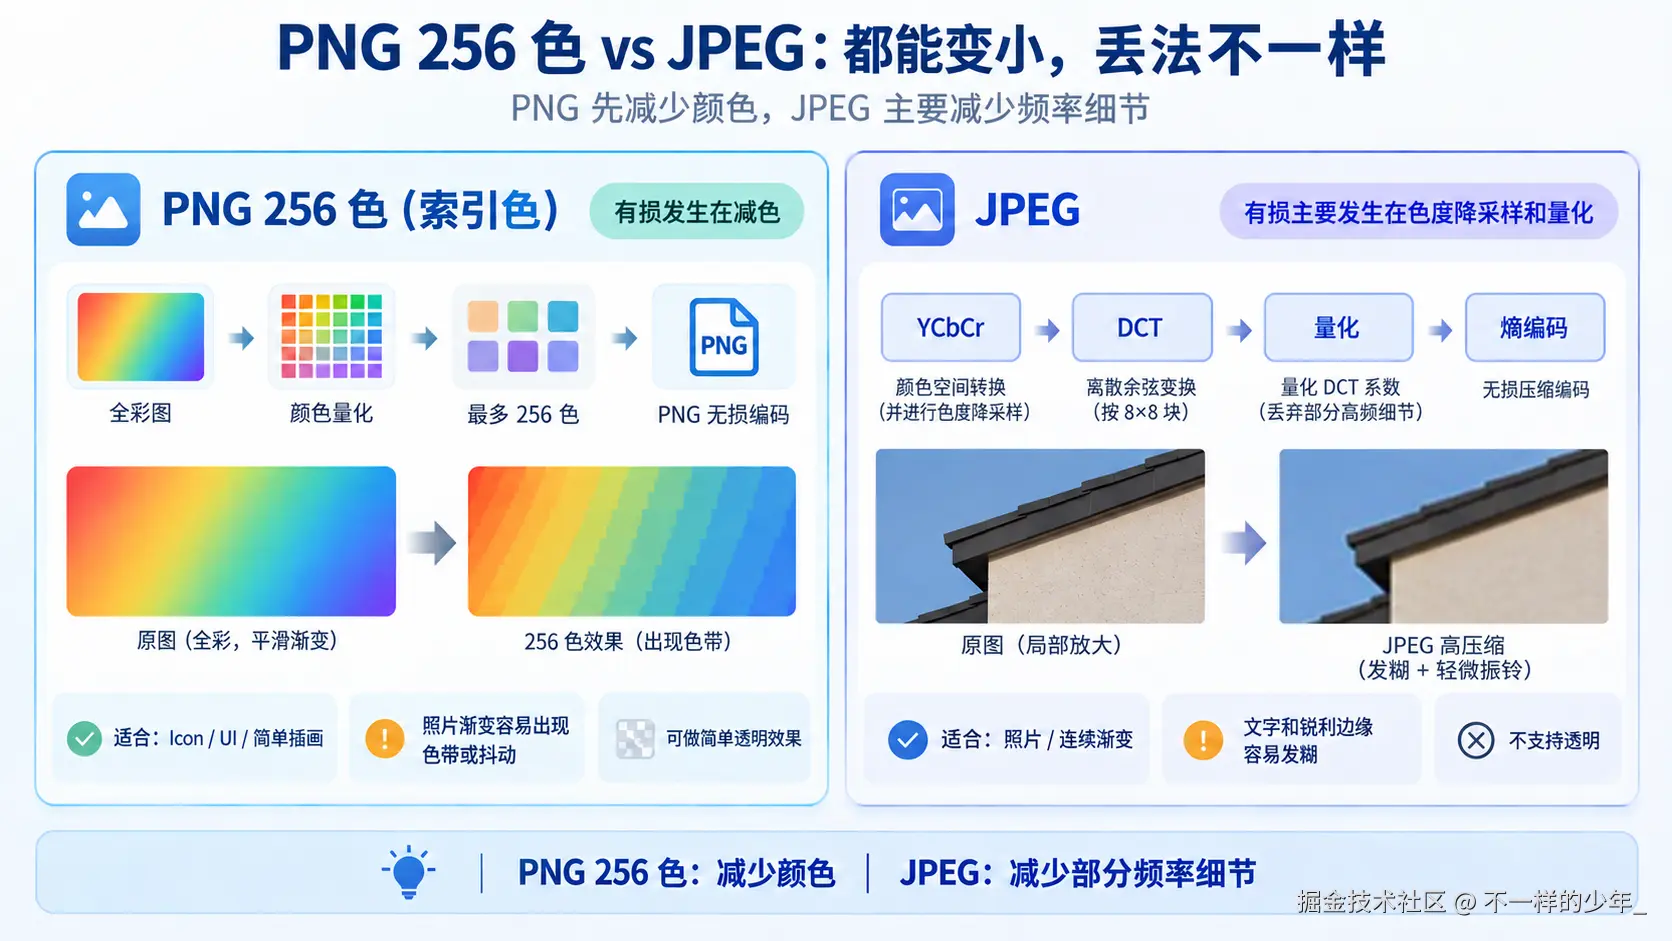
图:两种压缩思路的效果示意,非实测结果。JPEG 一侧展示同一处建筑边缘的示意对比。
- JPEG:把颜色和细节记得更粗。可能减少色度采样,再降低频率系数的精度;文字、细线、锐利边缘和密集纹理处容易出现模糊、振铃或蚊式噪声,重压缩时也可能有块状感。
- PNG 256 色:像素格子还在,但只能从最多 256 种颜色里选择。原来的大量颜色被合并成代表色,照片和渐变可能出现色带;也可以主动加入抖动,用细小点阵模拟缺少的颜色。
PNG 格式本身是无损的。有损发生在保存前的减色 ,PNG 再把减色后的结果无损存下来。如果原图本来就不超过 256 种颜色,转成索引色也不一定丢信息。PNG 的索引色调色板最多 256 项,见 PNG 规范的调色板说明。
那和 Cb、Cr 降采样不是差不多吗?
都在简化颜色,但简化的是两个不同维度:
- 4:2:0:附近的色度采样合成较少的代表值,减少空间上的采样密度;不限制整张图只能使用 256 种 RGB 颜色。
- PNG 256 色:每个位置仍有自己的颜色索引,但整张图可选的颜色最多 256 种。
所以不能说"JPEG 像素没变,PNG 像素才变了"。它们都没必然删掉像素格子,却都可能改变最终的像素颜色。
照片通常可以先试 JPEG;颜色较少的图标、简单插画可以试索引色 PNG;需要精确保留丰富颜色、文字或透明细节时,可以考虑全彩 PNG。不要仅凭格式名判断,最好看实际图片效果。
一句话:JPEG 是把颜色和细节记得更粗;PNG 256 色是把可用颜色减少到最多 256 种。
最后总结
把这 8 步串起来,核心就清楚了:
- 颜色转换、分块、DCT:把信息整理成更方便处理的形式。
- 色度降采样和量化:主要的有损取舍发生在这里。
- Zigzag、RLE / EOB、Huffman:重排、简写、编码,把量化后的数据写得更省。
后面的步骤不用"再删除高频 0"。原来的细节在量化时已经损失了,后面只需要把这些 0 省着记。解码能补回 0,却补不回量化前的精度。
下次调 libvips 参数时,先问一句:"我是在少保留一些信息,还是在把相同的数据编码得更省?"比只盯着文件大小反复试,更容易找到合适的取舍。
进一步了解 DCT、DC/AC 与 JPEG 编码流程,可阅读 Wallace 的 JPEG 原理介绍。