前面我们已经聊过 PNG、JPG、WebP 的压缩原理。
在开始之前,先认识一下本文反复提到的 libvips。它是一个高性能的图片处理库,也可以理解为图片处理引擎,能完成图片的读取、缩放、裁剪、压缩,以及 PNG、JPG、WebP 等格式之间的转换。
简单回顾一下:
- PNG:无损压缩,比较适合 UI、文字、透明图片
- JPG:有损压缩,比较适合照片
- WebP:既支持有损,也支持无损,还支持透明通道
但这里很容易冒出另一个问题:
PNG、JPG、WebP 的压缩方式明明完全不一样,那 PNG 到底是怎么"变成" WebP 的?
难道只是:
md
image.png
↓
改个后缀
↓
image.webp
当然不是。
接下来我们就借助 libvips,简单讲清楚:
图片格式转换,背后到底发生了什么?
一、先说结论:格式转换其实就是"拆开,再重新打包"
先记住这一句话:
图片格式转换的本质,就是先把原来的图片解码成像素,再使用目标格式重新编码。
比如:
md
PNG
 ↓
解码
 ↓
RGBA 像素
 ↓
WebP 编码
 ↓
WebP
所以:
md
PNG → WebP并不是直接把 PNG 内部的数据"修改一下",让它变成 WebP。
而是先:
md
把 PNG 拆开
↓
得到图片像素
然后再:
md
拿这些像素
↓
按照 WebP 的规则重新压缩
↓
生成新的 WebP 文件
你可以把它理解成:
内容还是这张图片,只是换了一种保存方式。
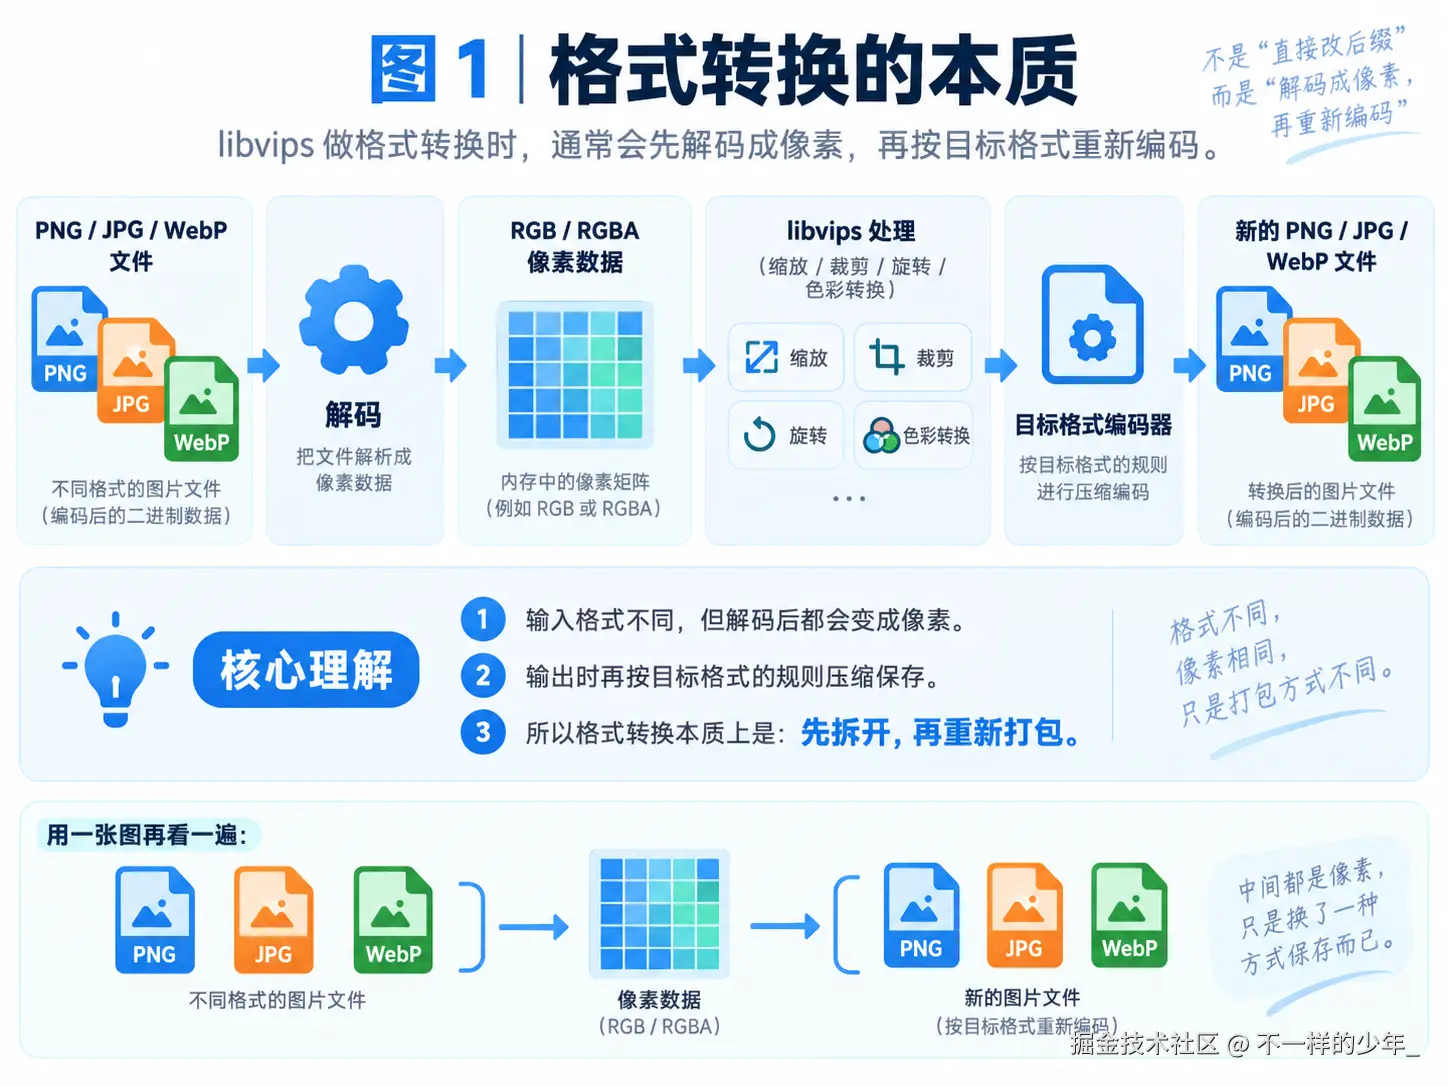 核心流程:
md
PNG / JPG / WebP
        ↓
      解码
        ↓
   RGB / RGBA 像素
        ↓
   libvips 处理
        ↓
    目标编码器
        ↓
PNG / JPG / WebP
二、为什么不同格式最后都能互相转换?
因为 PNG、JPG、WebP 的区别,主要是在:
这些像素到底怎么存进文件里。
比如前面我们讲过:
md
PNG
→ Filter
→ DEFLATE
JPG 大概是:
md
JPG
→ DCT
→ 量化
→ 熵编码
WebP 又有自己的一套预测、变换和压缩方式。
所以在文件里,它们长得完全不一样。
但是一旦解码之后,就不一样了。
三、到了 libvips 这一层,可以先把它们理解成"像素"
假设我们现在有三张图片:
md
a.png

b.jpg

c.webp
libvips 读取它们时,会根据图片格式调用对应的解码器。
可以简单理解成:
md
PNG ──┐
      │
JPG ──┼→ 解码 → 图像像素
      │
WebP ─┘
解码之后,中间操作的已经不是:
md
PNG 的 DEFLATE 数据也不是:
md
JPG 的 DCT 系数而是图像本身。
比如:
md
宽:1920
高:1080
通道:RGB
或者:
md
宽:1920
高:1080
通道:RGBA
里面可以理解成是一堆像素:
md
(255, 120, 80)
(252, 119, 81)
(250, 118, 79)
...
所以对于我们理解格式转换来说,可以先建立这样一个心智模型:
md
文件格式
   ↓
 解码器
   ↓
图像像素
然后输出时:
md
图像像素
   ↓
目标格式编码器
   ↓
新的图片文件
这就是为什么 PNG、JPG、WebP 可以互相转换。
四、比如 PNG 转 WebP,到底发生了什么?
我们来看最常见的情况。
假设用户上传:
md
logo.png现在我们希望服务器输出:
md
logo.webp整个流程大概就是:
md
PNG
 ↓
PNG 解码器
 ↓
RGBA 像素
 ↓
WebP 编码器
 ↓
WebP
但这里又分成两种情况。
五、PNG → WebP Lossless:只是换一种无损保存方式
第一种:
md
PNG
→
WebP Lossless
也就是:
PNG 转 WebP 无损。
流程可以理解成:
md
PNG
 ↓
无损解码
 ↓
RGBA 像素
 ↓
WebP Lossless 编码
 ↓
WebP
如果中间没有:
md
resize
调色
裁剪
这些会改变像素的操作,那么从像素内容来看:
md
PNG 解码出来的像素
=
WebP Lossless 再解码出来的像素
也就是说:
这次格式转换本身没有把图片细节丢掉。
只是原来:
md
用 PNG 的方式保存现在变成:
md
用 WebP Lossless 的方式保存所以可以把它理解成:
像素没变,只是换了一种打包方式。
六、PNG → WebP Lossy:这时候才开始真正丢信息
如果我们选择:
md
PNG
→
WebP Lossy
情况就不一样了。
流程还是:
md
PNG
 ↓
解码
 ↓
RGBA 像素
到这里都没有问题。
但接下来用了:
md
WebP Lossy也就是 WebP 的有损编码。
于是:
md
RGBA 像素
 ↓
WebP 有损编码
 ↓
丢掉部分视觉信息
 ↓
更小的 WebP
所以:
PNG 转 WebP 会不会掉画质,并不是"转 WebP"这件事情本身决定的。
真正决定它的是:
你最终使用的是 WebP Lossless,还是 WebP Lossy。
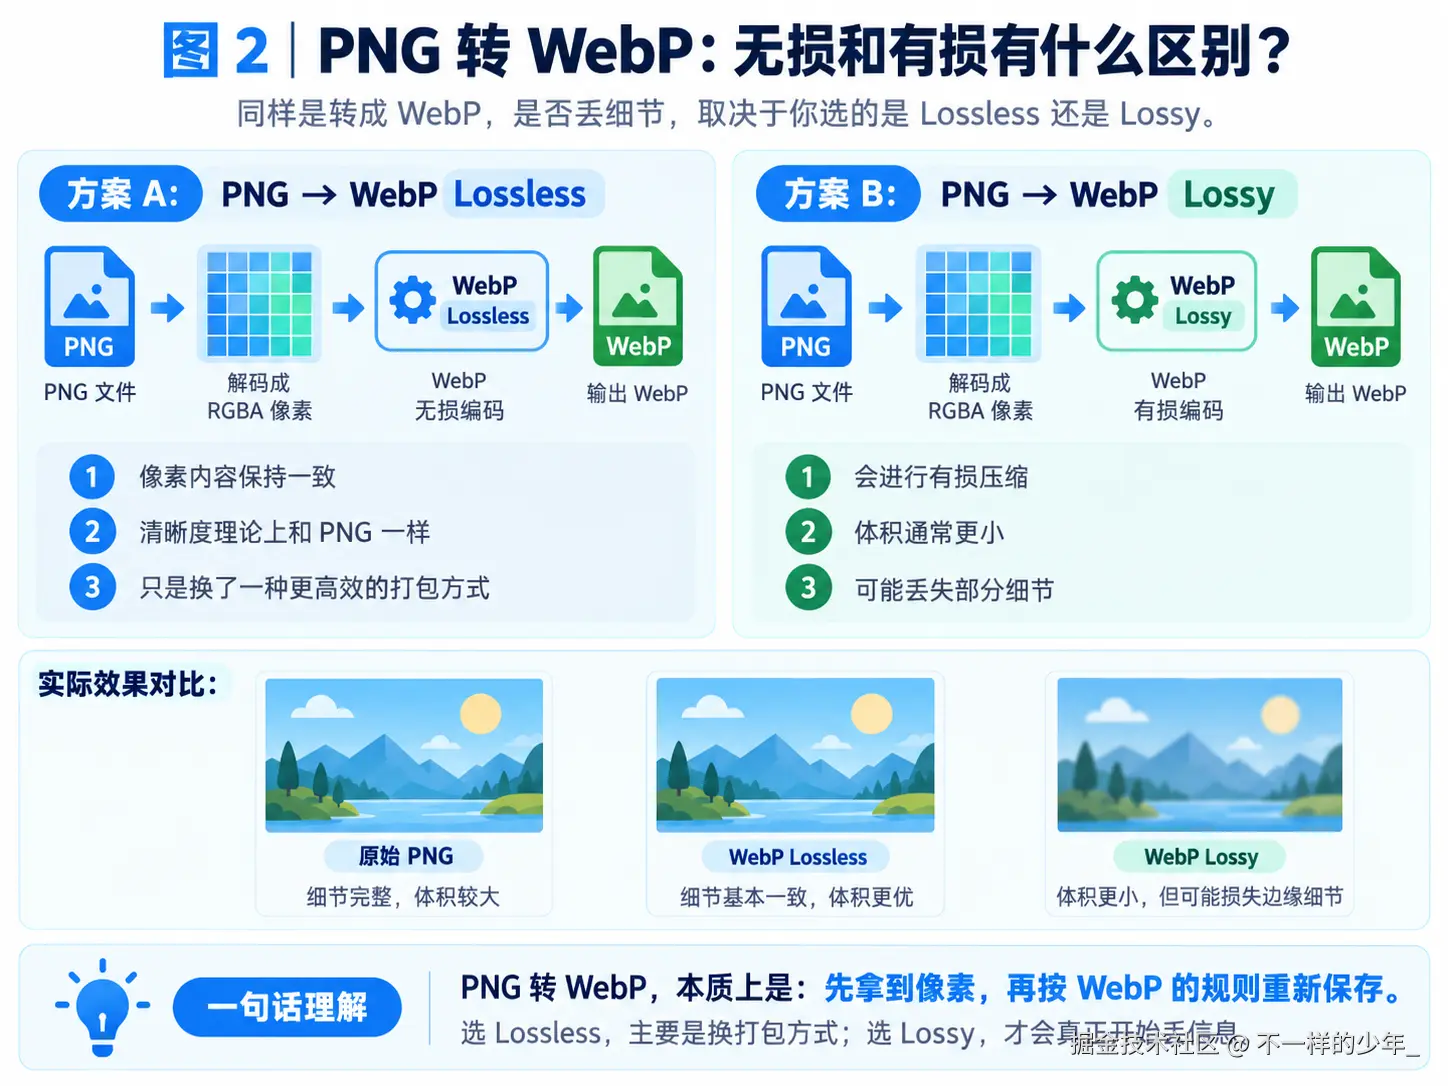
左边:
md
PNG
↓
像素
↓
WebP Lossless
↓
像素保持一致
右边:
md
PNG
↓
像素
↓
WebP Lossy
↓
丢掉部分细节
这一张图基本就能把 PNG → WebP 讲明白。
七、那 JPG 转 WebP 呢?
逻辑其实完全一样。
md
JPG
 ↓
JPEG 解码器
 ↓
RGB 像素
 ↓
WebP 编码器
 ↓
WebP
但是 JPG 有一个很重要的特殊点:
JPG 本身就是有损格式。
比如一张原始照片:
md
原始图片
 ↓
JPEG 有损压缩
 ↓
JPG
生成 JPG 的时候,其实就已经丢掉了一部分信息。
所以我们再用 libvips 读取 JPG:
md
JPG
 ↓
解码
 ↓
RGB 像素
这里拿到的是:
当前 JPG 所代表的像素。
而不是 JPG 压缩之前那份真正的原始图片。
这个区别非常重要。
八、所以 JPG → 有损 WebP,可能属于"二次有损"
假设:
md
原图
 ↓
第一次有损
 ↓
JPG
然后我们又:
md
JPG
 ↓
解码
 ↓
WebP Lossy
 ↓
第二次有损
 ↓
WebP
整个过程就变成:
md
原图

 ↓ 第一次有损

JPG

 ↓ 解码

当前 JPG 的像素

 ↓ 第二次有损

WebP
所以经常会说:
JPG 再转有损 WebP,可能会产生二次有损。
尤其是你反复:
md
JPG
→ WebP
→ JPG
→ WebP
每次都使用有损编码的话,图片质量就可能一点一点下降。
这个其实和:
md
视频反复导出很像。
你每导出一次有损格式,都有可能再损失一点信息。
【插图 3:JPG 转 WebP 二次有损】
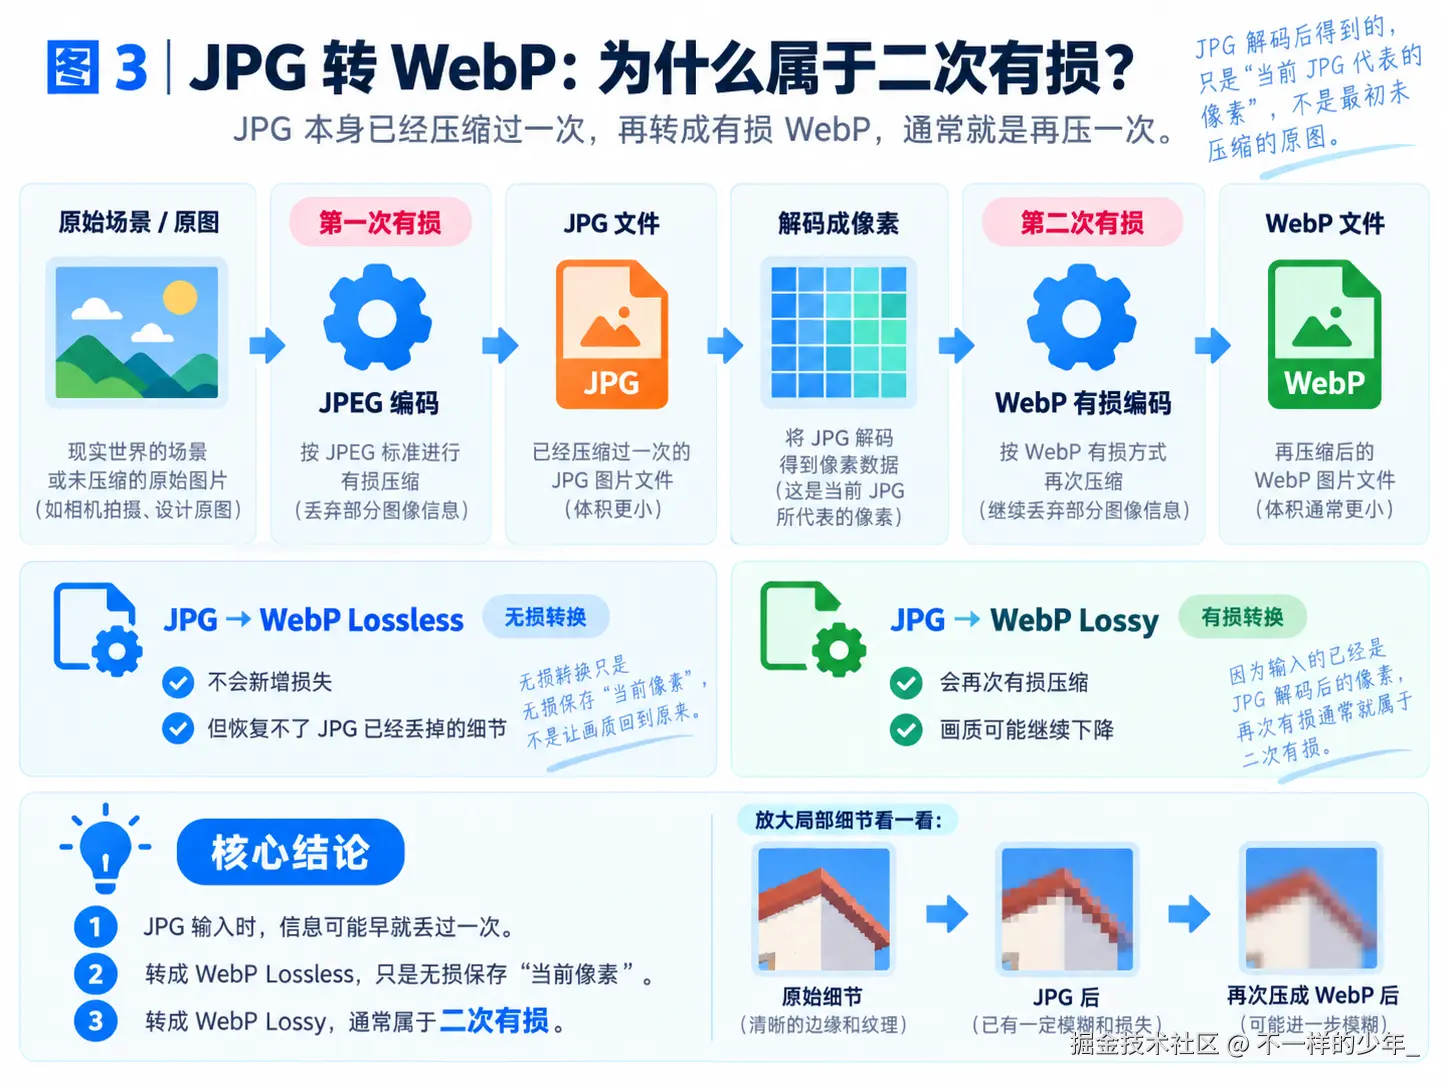
重点突出:
md
原图
↓
JPEG 第一次有损
↓
JPG
↓
解码
↓
当前 JPG 的像素
↓
WebP 第二次有损
↓
WebP
九、那 JPG 转 WebP Lossless 呢?
这里有个很容易绕进去的地方。
如果:
md
JPG
→
WebP Lossless
是不是就变无损图片了?
答案是:
不能这么理解。
因为 JPG 在生成的时候:
md
原始图片
↓
JPEG
已经丢过信息了。
这部分信息已经回不来了。
所以:
md
JPG
 ↓
解码
 ↓
当前 JPG 的 RGB 像素
 ↓
WebP Lossless
这里所谓的 Lossless,是:
从"当前 JPG 解码后的像素"开始,不再继续丢信息。
并不是:
把 JPG 恢复成它压缩之前的原图。
所以一定要分清楚:
md
无损编码
≠
恢复已经丢失的信息
这个概念非常重要。
十、所以 libvips 到底做了什么?
讲到这里,其实整个模型已经非常简单了。
可以把 libvips 的图片处理链路抽象成三个单词:
md
decode
   ↓
transform
   ↓
encode
也就是:
md
解码
 ↓
处理
 ↓
编码
比如:
md
PNG
 ↓
decode
 ↓
RGBA 像素
 ↓
resize
 ↓
crop
 ↓
rotate
 ↓
WebP encode
 ↓
WebP
中间的:
md
resize
crop
rotate
颜色转换
甚至都不是必须的。
如果单纯做格式转换:
md
PNG
 ↓
decode
 ↓
encode WebP
 ↓
WebP
就够了。
十一、所以"格式转换"和"图片压缩",其实没有想象中那么割裂
这一点我觉得很有意思。
以前我们可能会觉得:
md
图片压缩和:
md
格式转换是两件完全不同的事情。
但站在 libvips 这条处理链路来看,它们其实非常接近。
比如:
md
PNG → PNG可以理解成:
md
PNG
↓
decode
↓
PNG encoder
↓
PNG
属于:
PNG 重新编码 / 压缩。
而:
md
PNG → WebP则是:
md
PNG
↓
decode
↓
WebP encoder
↓
WebP
属于:
格式转换 + WebP 压缩。
再比如:
md
JPG → JPG是:
md
JPG
↓
decode
↓
JPEG encoder
↓
JPG
而:
md
JPG → WebP只是最后:
md
JPEG encoder换成:
md
WebP encoder而已。
所以从代码设计的角度,其实可以把两件事统一成:
md
输入图片
   ↓
decode
   ↓
transform
   ↓
选择目标 encoder
   ↓
输出图片
十二、那用 libvips 做格式转换,代码是不是也不用改很多?
如果你的项目本身已经在使用 libvips 做图片压缩,那通常确实不用重新写一整套逻辑。
原来可能是:
md
读取图片
 ↓
处理
 ↓
按照原格式编码
 ↓
输出
增加格式转换之后:
md
读取图片
 ↓
处理
 ↓
根据用户指定的目标格式选择 encoder
 ↓
输出
比如用户传:
md
format = webp那最后就走:
md
WebP encoder用户传:
md
format = jpeg就走:
md
JPEG encoder用户传:
md
format = png就走:
md
PNG encoder所以从整体架构来看:
格式转换真正需要变化的地方,主要集中在输出编码阶段。
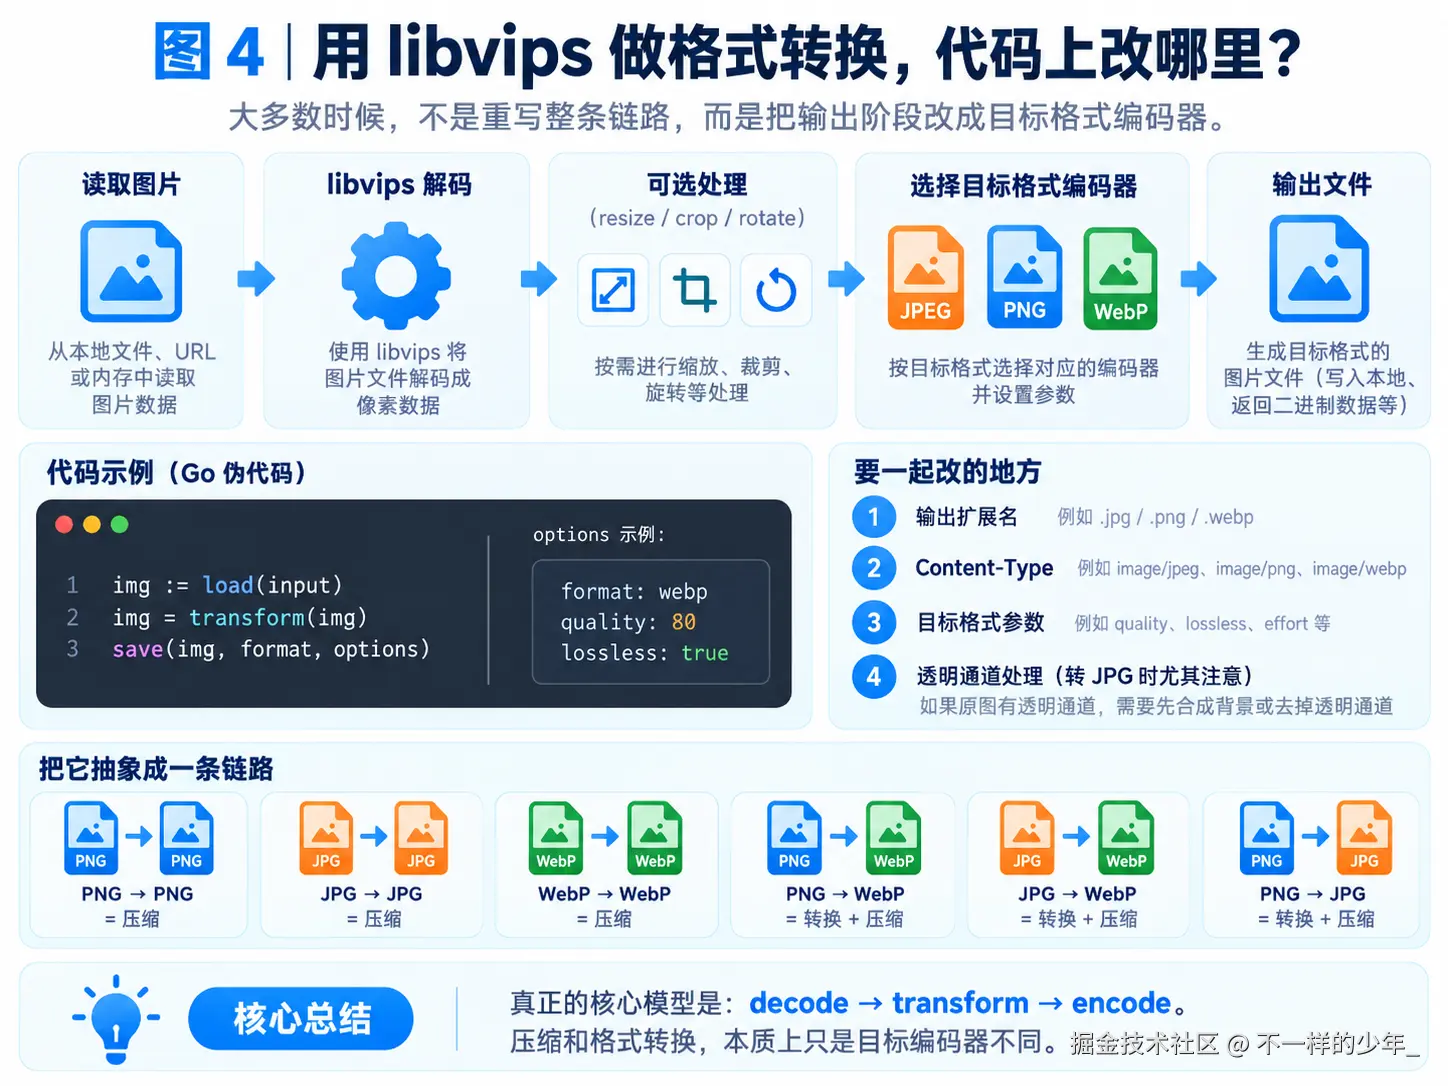
重点展示:
md
读取图片
  ↓
libvips 解码
  ↓
resize / crop / rotate
  ↓
选择目标格式 encoder
  ↓
PNG / JPG / WebP
十三、不过还有几个小坑要注意
虽然核心逻辑很简单,但实际做服务时还是有几个细节。
1. 不同格式的压缩参数不一样
不能简单搞一个:
md
quality = 80然后觉得 JPG、PNG、WebP 全部都一样。
比如:
md
JPEG
→ quality

WebP
→ quality / lossless / effort

PNG
→ compression level 等
不同编码器有自己的参数。
所以代码里最好还是:
md
目标格式
↓
选择对应 encoder
↓
使用对应参数
2. PNG 转 JPG 要注意透明通道
PNG 支持:
md
RGBA也就是有 Alpha 透明通道。
但 JPG 不支持透明。
所以:
md
透明 PNG
↓
JPG
不能直接理解成透明还会保留。
通常要先:
md
透明区域
 ↓
铺一个背景色
 ↓
RGB
 ↓
JPEG
比如铺白底。
这一点实际做图片服务的时候一定要考虑。
3. 文件后缀和 Content-Type 也要跟着变
比如:
md
PNG
↓
WebP
输出文件不能还叫:
md
image.png而应该是:
md
image.webpHTTP 返回时:
md
Content-Type也应该对应:
md
image/webp这些属于工程层面的细节。
十四、libvips 真的是"先把整张图片全部放进内存"吗?
前面为了方便理解,我们一直画:
md
图片文件
 ↓
整张像素图
 ↓
处理
 ↓
输出
作为理解模型,这样完全没问题。
但 libvips 实际实现还要更聪明一点。
它采用的是比较偏:
按需计算、流水线处理
的方式。
所以很多时候,并不是:
md
一次性把整张超大图片
全部展开到内存
然后再处理。
而更像:
md
需要哪一部分
↓
读取 / 解码哪一部分
↓
处理
↓
继续下一部分
这也是 libvips 很适合用在服务端图片处理场景里的一个原因。
不过对于刚开始理解格式转换来说,这部分知道有这么回事就够了。
不用继续往底层钻。
最后总结
这篇其实只需要记住一个核心模型:
md
PNG / JPG / WebP
        ↓
      解码
        ↓
   RGB / RGBA 像素
        ↓
   libvips 处理
        ↓
   目标格式编码器
        ↓
PNG / JPG / WebP
所以:
格式转换的本质,就是先解码成图像,再按照目标格式重新编码。
比如:
md
PNG → WebP不是"修改 PNG"。
而是:
md
PNG
↓
像素
↓
WebP
如果:
md
PNG → WebP Lossless那么可以理解成:
像素不变,只是换了一种无损的保存方式。
如果:
md
PNG → WebP Lossy则是:
拿 PNG 的像素,再使用 WebP 的有损规则重新压缩。
而:
md
JPG → WebP Lossy因为 JPG 本身已经有损过一次,所以:
还可能产生第二次有损。
理解到这里,其实图片格式转换已经没有那么神秘了。
最后再用一句话概括:
图片还是那张图片,格式决定的只是:这些像素最终怎么被保存下来。
而 libvips 做的,就是把:
读取 → 解码 → 处理 → 重新编码
这一整条链路串起来。