前几天被问到一个问题:RAG 是不是过时了?
我想了一下,好像确实。三年前搭一个 AI 应用,不做 RAG 几乎不好意思跟人打招呼;现在 Claude Code 这类 coding agent 在你的代码库里改 bug,从头到尾没碰过向量库------它就是 grep。
顺着这个念头往下想,不对劲的地方不止一处。当年做 Agent 的明星产品 Coze、Dify,现在很少被认真讨论了;LangChain 还在,但很多团队已经学会绕开它:框架照装,真正干活的循环自己写。这三件事看着各说各的,其实是同一件事。
Agent 的控制权,正在一路从人写的脚手架,回到模型自己手里。
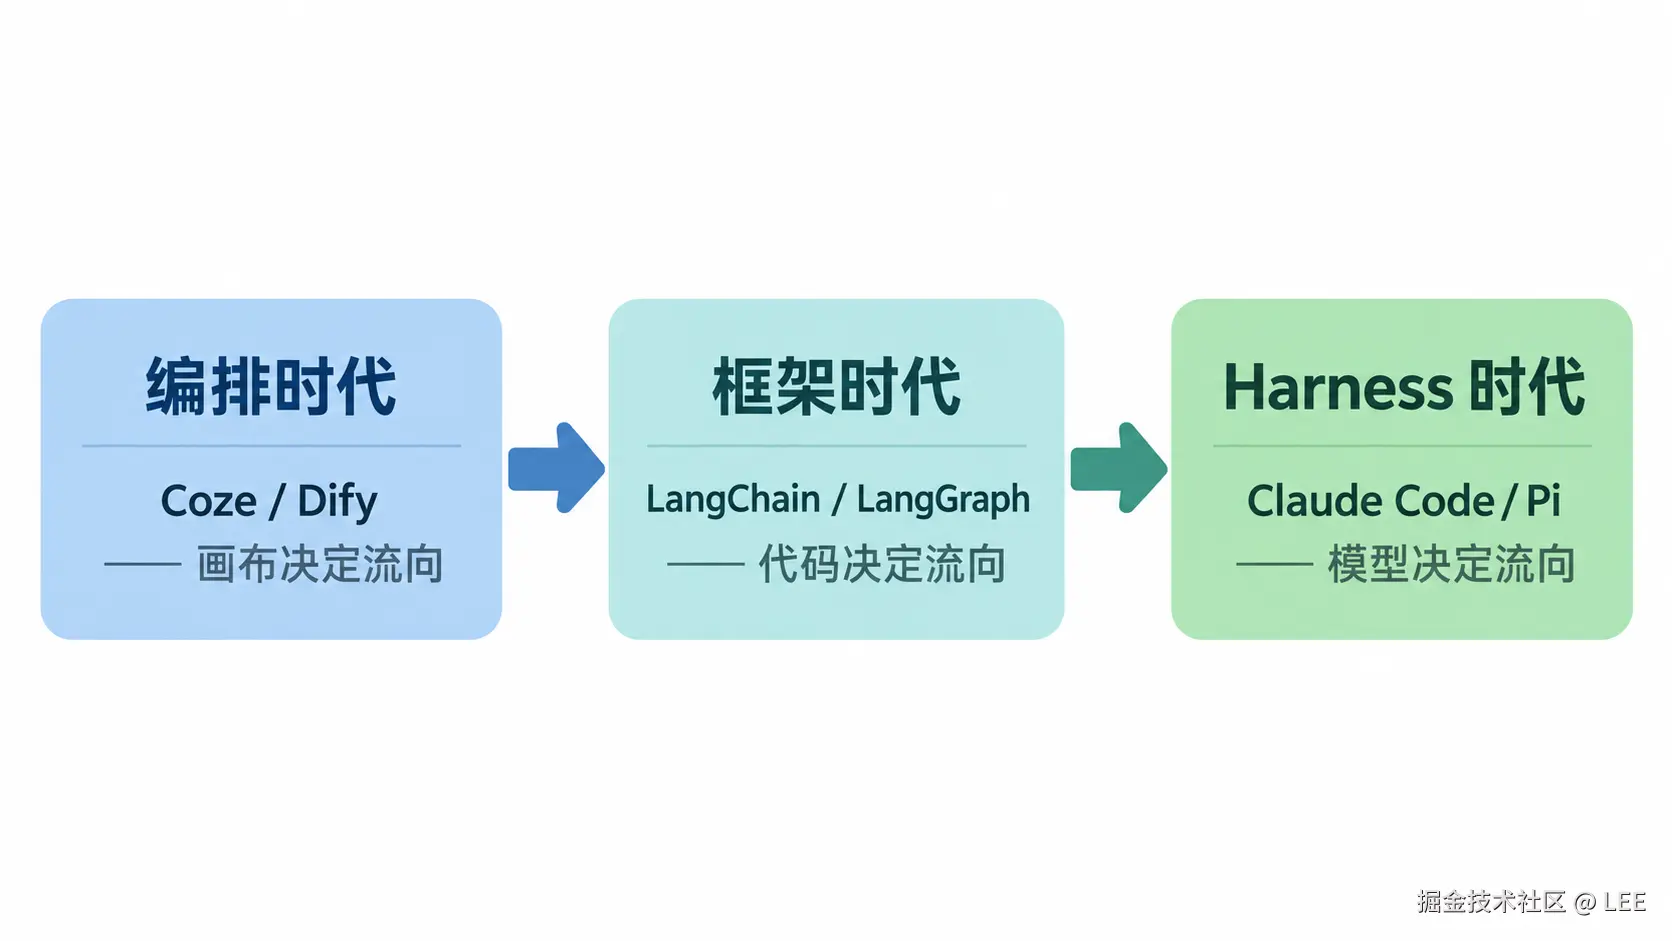
Coze 把控制流画在画布上,LangChain 把它写进代码里,而 Harness 把它交还给模型。Harness 就是那层围绕模型搭起来的运行时。RAG 的退场,是同一个故事在"检索"这个环节上的翻版。
先说清楚"控制权"指什么
一次 LLM 调用,永远要回答两个问题:这一步做什么 ,和下一步去哪。
前者是决策,后者是控制流。早期的模型两个都答不好:你让它"看着办",它要么一本正经地胡说,要么原地打转。所以人替它答:把"下一步去哪"提前写死,把"这一步做什么"约束在一个小盒子里。
这两个问题由谁回答,就是本文说的"控制权"。 演进就是人答得越来越少、模型答得越来越多。三个时代,三种"谁来回答"。
编排时代:Coze / Dify 用画布替模型做决定
Coze、Dify 这类平台给的是一张画布。你把节点拖上去:一个 LLM 节点、一个知识库节点、一个条件分支、一个 HTTP 请求,再用线连起来。连完的这张有向无环图,就是"Agent"。
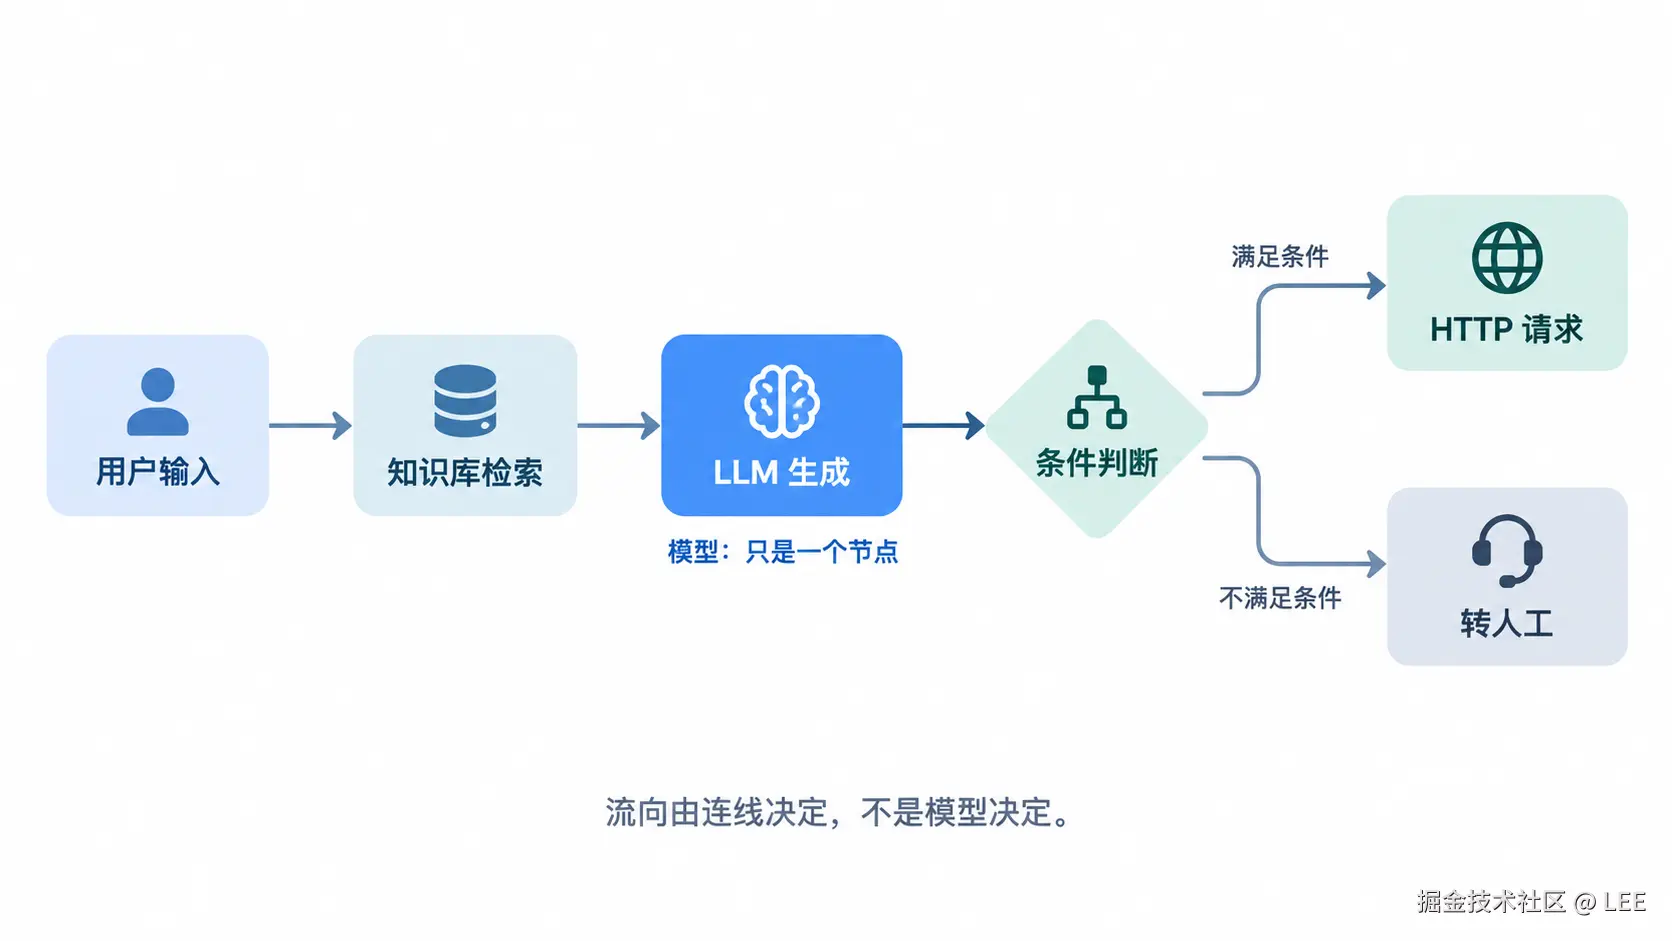 按今天的话说,它更像一个带 LLM 节点的工作流引擎。但在当时,这个设计很合理,因为它绕开了模型最弱的三块:
| 模型当时最弱的地方 | 画布的对策 |
|---|---|
| 不会规划"先查订单、再判断能不能退、不能退就转人工" | 把这条路径在画布上画出来 |
| 不会稳定地调用工具 | 用节点规定它什么时候调、调完去哪 |
| 上下文装不下 | 挂一个知识库节点,检索完再拼进去 |
画布不是笨办法,是当时的模型配不上更聪明的办法。
问题是,画布只能覆盖你想得到的分支。
真实的对话不会照着你的图走。用户可能问半句退款,突然转去投诉物流,又绕回来说要改地址。你的画布得为每一条路都画一个分支。可你没想过的那些路,图里没有,模型也不能自己走出来。
在这套架构里,模型没有"决定"任何东西。它像个计算节点,输入什么就处理什么,走到哪儿由外面那张图说了算。是人在编排,不是 Agent 在编排。
于是它撞上三堵墙:
- 图外的路径走不了。
- 规模一大,图就不可读,"为什么走了这条分支"要靠人肉复盘。
- 每加一个场景,就得回去改图、重新发布。
Coze 这类平台不是做错了,它们的方案是那个时代的最优解:模型还不够强,就得有人在外面替它把每一步编排好,画布就是为这个生的。模型一变强,这层编排就不再必要了。
框架时代:LangChain / LangGraph 把控制流写进代码
画布的问题,逐渐暴露了出来:不能版本管理、不能测试、不能 code review,想做个稍微复杂点的判断,就得跳出图形界面。
于是控制流从画布挪进了代码。
2023 年的 LangChain 几乎成了默认答案。它给了一整套开箱即用的积木:PromptTemplate、Retriever、Tool、Memory、Chain,你像搭乐高一样把它们拼起来。那一年,"我会 LangChain"是个简历加分项。
然后它开始变重。
本来很朴素的一件事:"把问题丢给模型,它想用工具就用,用完把结果喂回去,循环到它说结束。"就这么个循环,在 LangChain 里被包了好几层,你想知道它到底怎么转的,得读框架源码。这不是说抽象没价值:把 prompt、检索、工具做成组件,确实让最初的"拼起来"快了很多。只是它把复杂度挪到了你看不见的地方,而模型越强,你越需要看见它。
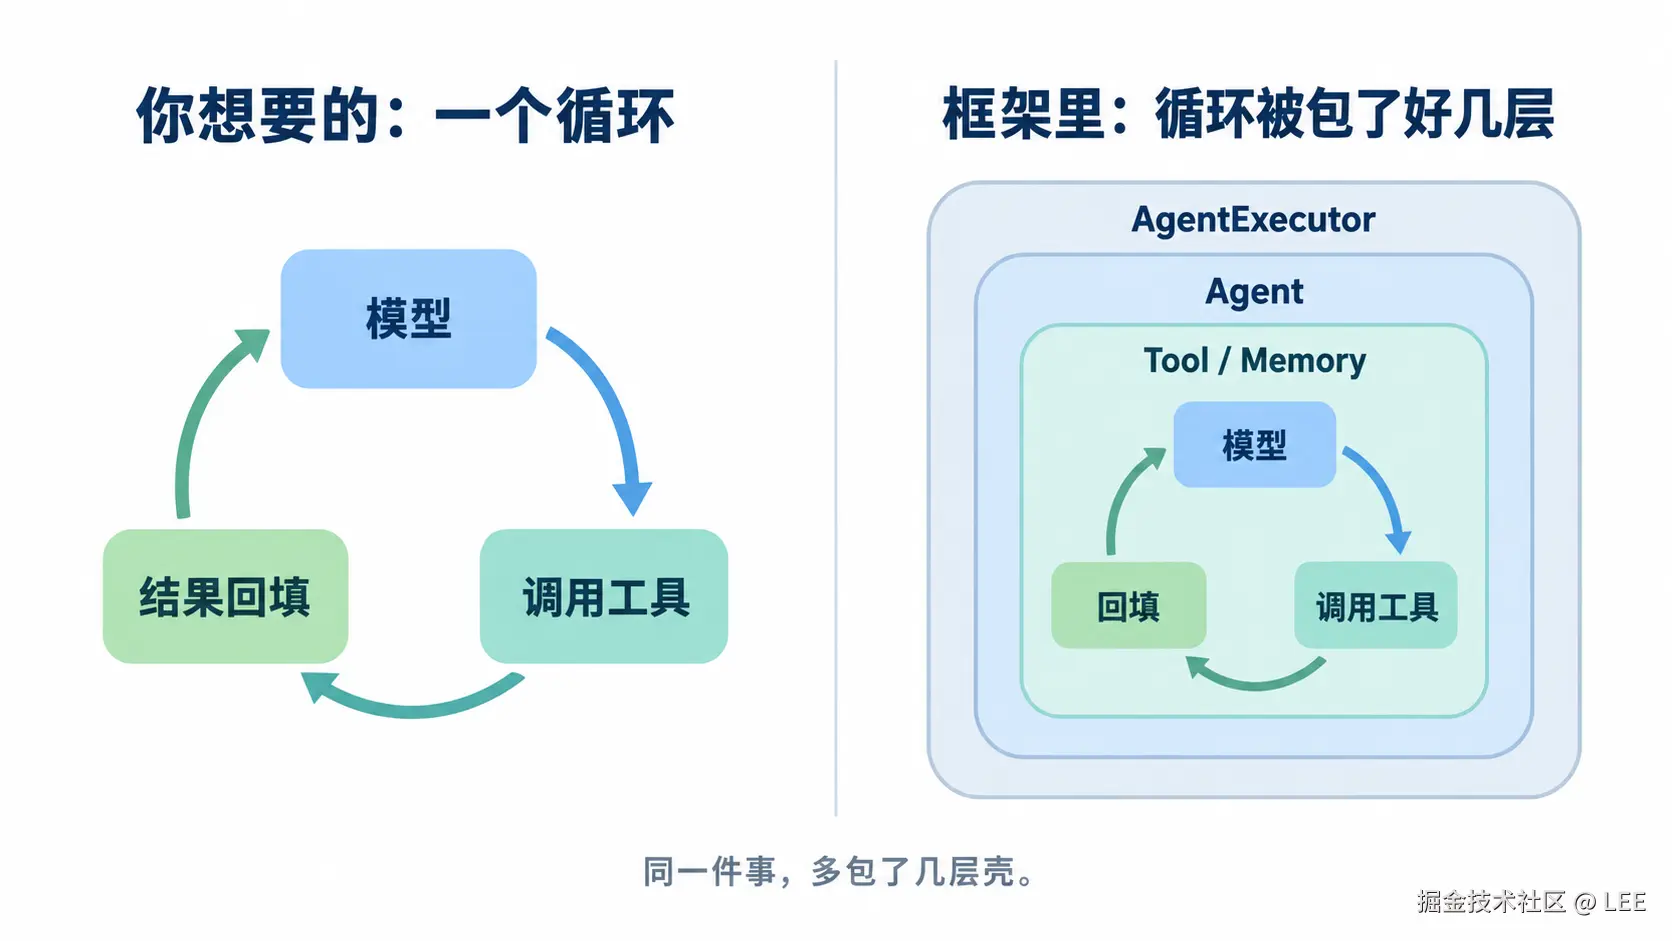 我的判断是:LangChain 把抽象划在了一条会一直移动的线上。 Agent 最需要掌控的恰恰是那个循环,而 LangChain 早期的 AgentExecutor 把它整个封装了起来。你不用自己写循环也能把链跑通,这在当时是实打实的便利。可模型每强一分,循环里需要你亲手调的地方就多一分,这层封装也就从便利慢慢变成了约束。
LangGraph 是同一个团队对这个问题的正面回应。它不再把循环藏在封装里,而是给你一台显式的状态机:节点、边、条件边、环、checkpoint、human-in-the-loop。它把三件此前被封装挡住的事摆到了台面上:Agent 有状态,会循环,也需要被人掌控。
到这一步,框架时代已经成熟了。但它还有一个更根本的上限:框架为共性优化,而 Agent 大多是边角案例。
几乎每个真上线的 Agent,最后都要在框架里做同一件事:找到合用的部分,fork 它,或者干脆自己写循环。因为抽象边界一直在动:模型一换代,框架的"增值"(prompt 模板、输出解析、记忆管理)就可能变得多余,或者需要重新设计。
还有一层更朴素的道理:你没法为一个还在快速变化的东西,一次性地设计好抽象。 Agent 太年轻,正确的原语还没有定论,任何提前定下来的接口,都可能很快就得重画。
再往上抽一层。Rich Sutton 在 2019 年那篇 "The Bitter Lesson" 里讲过一个规律:能随算力一起放大的通用方法,最终总会打败把人工知识写进系统的做法。手写的 chain、画好的 graph,就是那份"人工知识";而强模型加一层简单外壳,才是能随算力放大的那条路。
Harness 时代:把控制权交还给模型
先解释 Harness 是什么,因为这个词在不同人嘴里指的东西不完全一样。
在本文里,它指的是模型之外、让它成为一个 Agent 的一切:循环、工具、上下文管理(何时压缩、压什么)、记忆、权限与沙箱、子 Agent、环境。
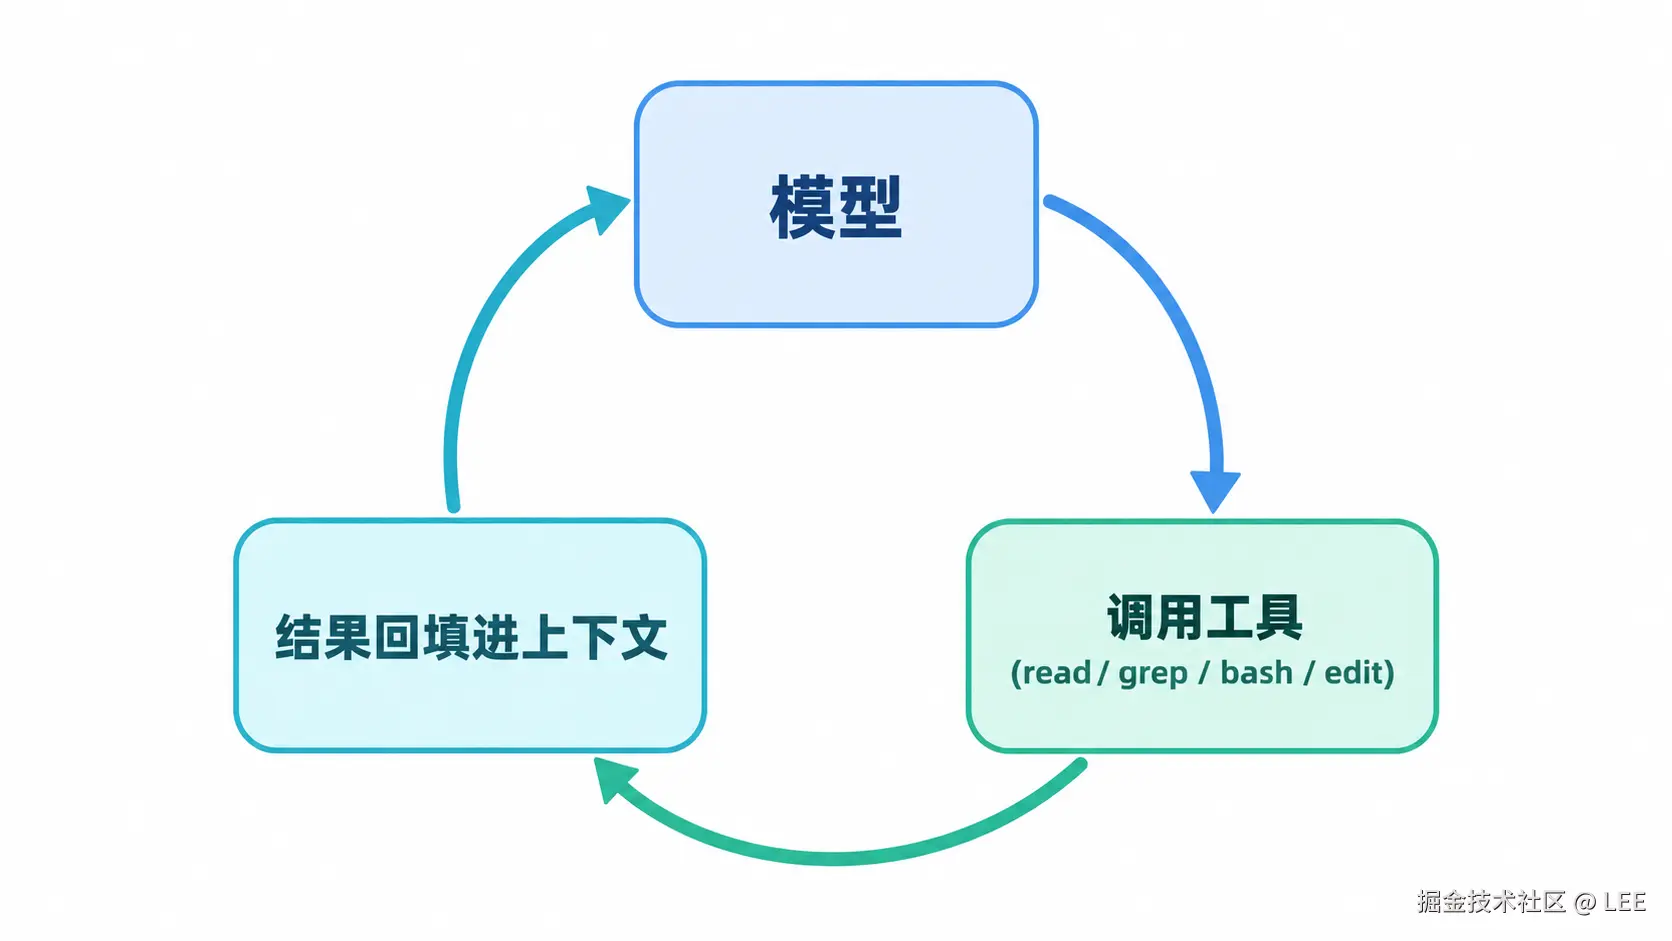
代表是 Claude Code、Codex CLI、Cursor、OpenCode、Pi 这一批 coding agent。它们看着差别很大,共享的假设只有一个:
模型是 Agent 的大脑,Harness 是它的身体。
智能在权重里,Harness 负责给它手和眼睛(工具)、给它记忆(上下文和文件)、给它边界(权限)。你不再用 chain 去"编写"Agent 的行为,而是给它好用的工具、干净的上下文、一个可靠的循环,然后------让它自己决定。
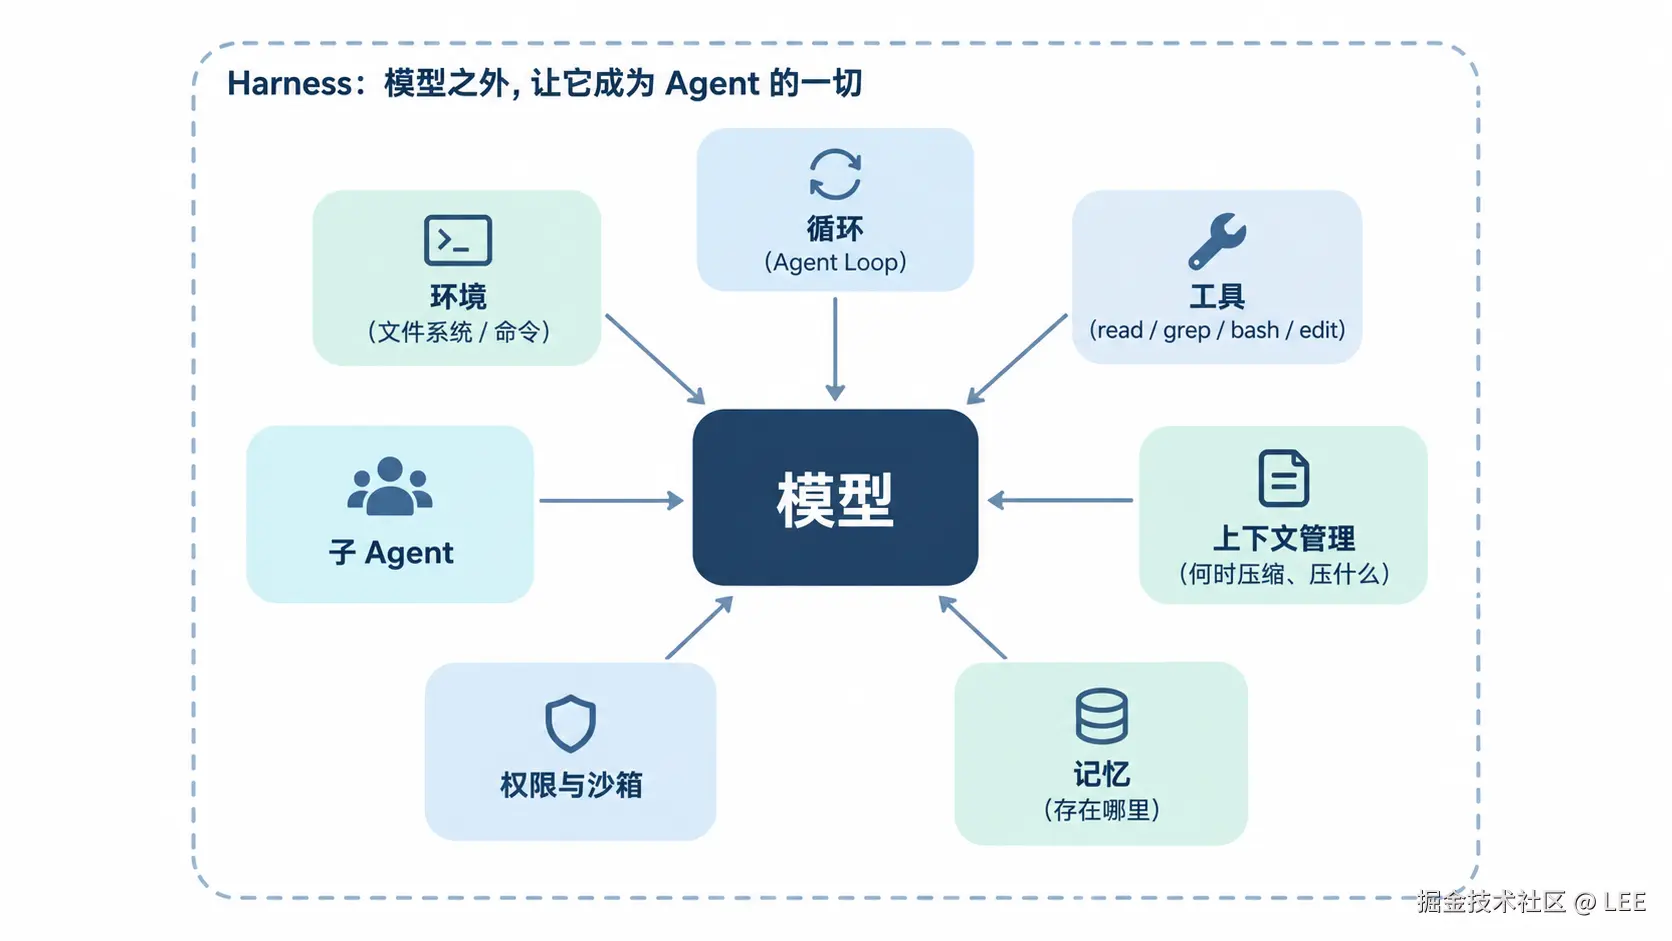 这个循环,就是 Harness 的心脏。它简单得过分,却恰恰是它能跑通的关键:模型自己决定要不要调工具、调哪个、调几次、什么时候停。
Harness 能成立,是因为几件事同时到位了:模型在规划和工具调用上终于够用;长上下文和 prompt caching 让"把该给的都给到"变得可行;"上下文工程"(往上下文里放什么、什么时候放、怎么压缩)开始取代"提示词工程",成为核心手艺。
跟框架比,最大的区别在于复杂度搬到了哪儿:
| 框架(LangChain) | Harness | |
|---|---|---|
| 智能在哪 | 你写的 chain / graph | 模型 |
| 控制流谁定 | 你,显式写死 | 模型,跑的时候涌现 |
| 抽象层 | 多(Chain / Agent / Tool...) | 少(shell / read / write / search) |
| 你的活 | 拼装组件 | 设计上下文和边界 |
| 典型失败 | 抽象边界和需求对不齐 | 上下文喂坏了、工具设计得差 |
最反直觉的是,Harness 会"吃掉"框架:模型越强,Harness 反而越薄。
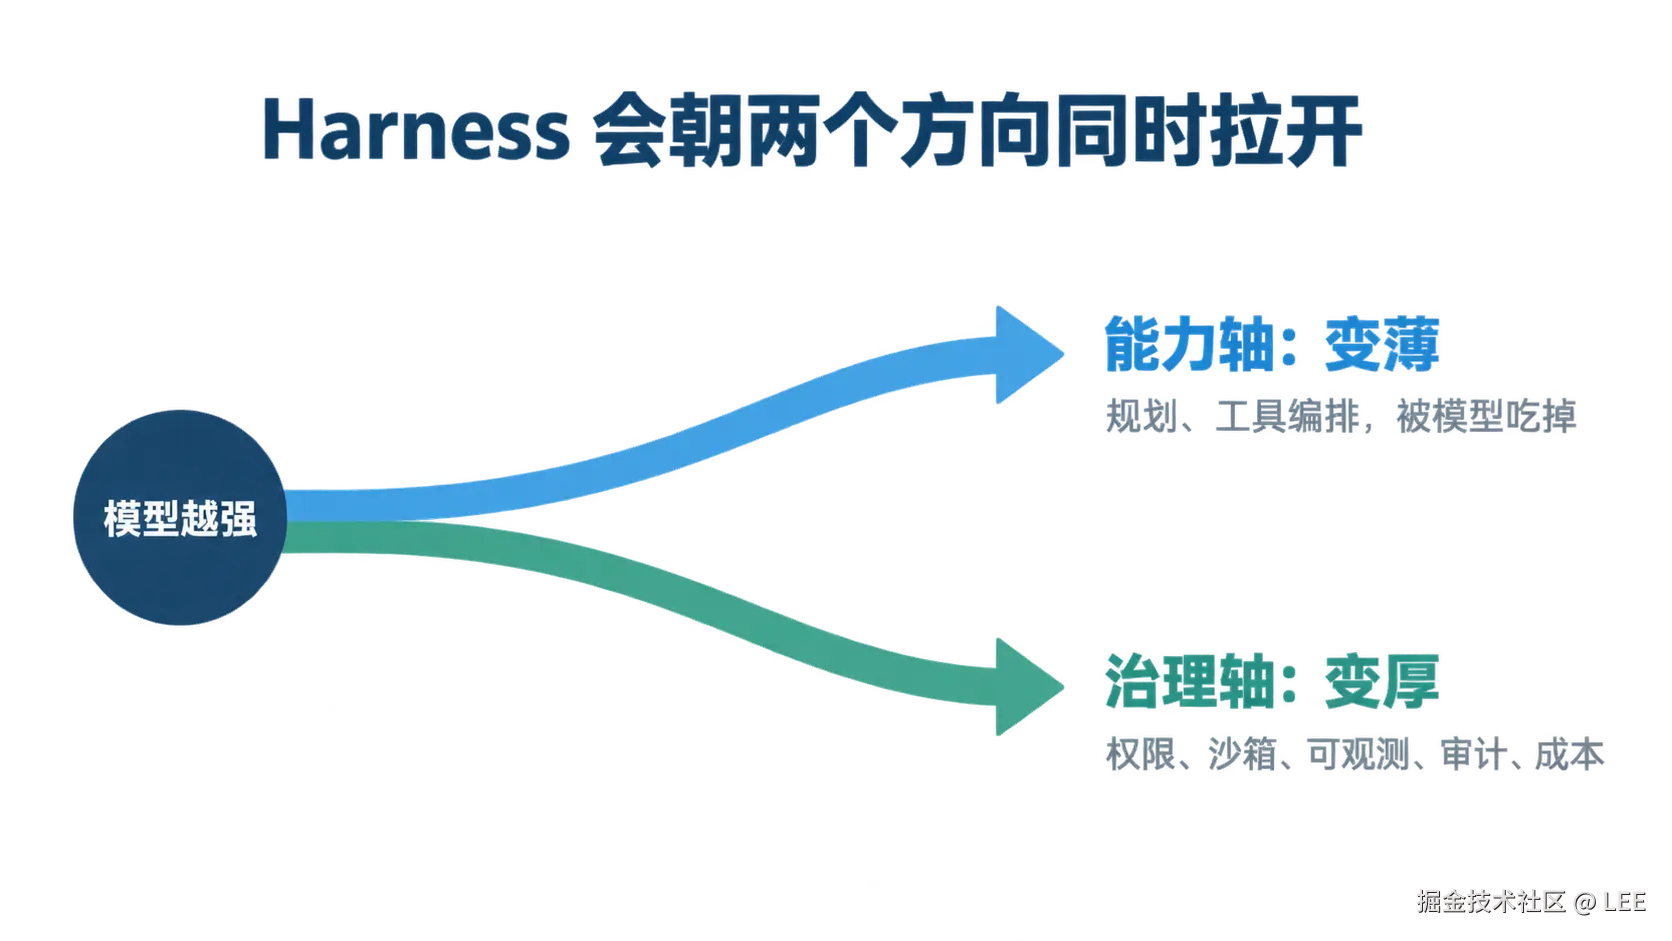
软件通常是越往上堆越厚,Harness 却越堆越薄。写在 Harness 里的压缩、记忆、工具编排、规划,明天很可能被训进模型本身。最好的 Harness 因此正在收敛到一个极小的原语集:一个 shell、一个文件系统,剩下的交给模型自己搭。Pi 是这条路的极端样本,154 行 System Prompt、4 个工具就能干活;作为对照,同一时期的 Claude Code 有 1600 多行 System Prompt、20 多个工具。两边都没让复杂度消失,只是把它换了个地方扛。
那 RAG 呢
现在回到开头那个问题。
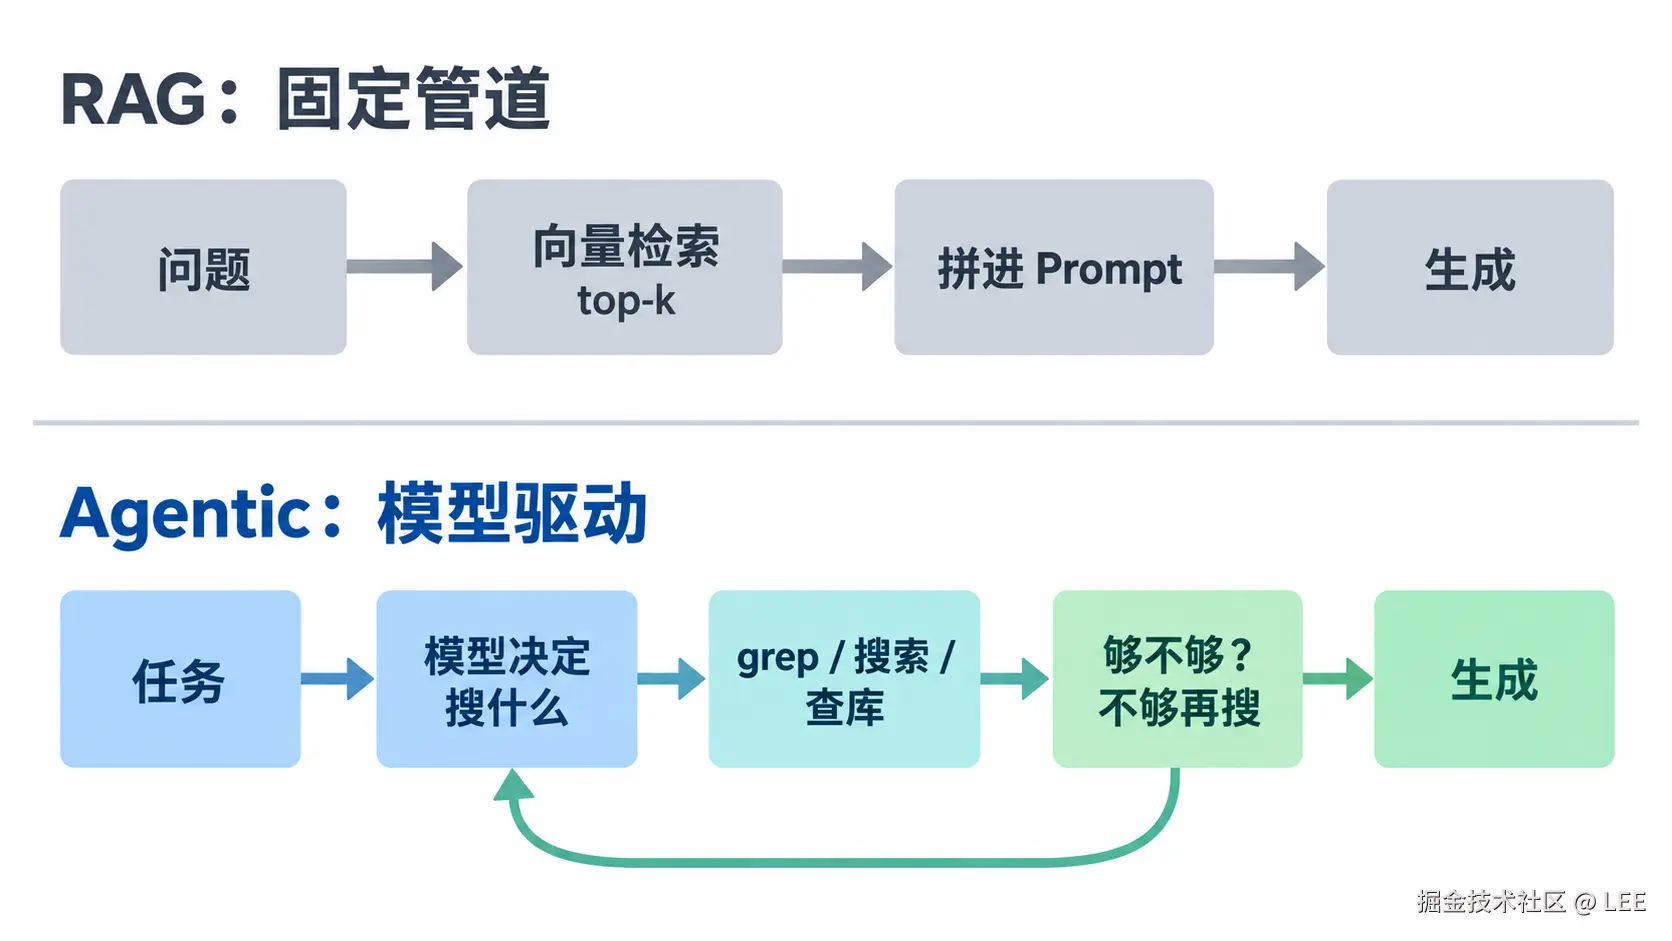
先说清楚 RAG 当年为什么赢。它的模式是:把文档切块、向量化、存进向量库,问题来了就按余弦相似度取 top-k,拼进 prompt 再让模型生成。在上下文只有 4k--32k 的年月,这是唯一能让模型"知道"外部知识的办法。不夸张地说,2023 年"做 RAG"和"做 AI 应用"几乎是同义词。
RAG 现在安静下来,是因为有好几件事同时挤兑它。
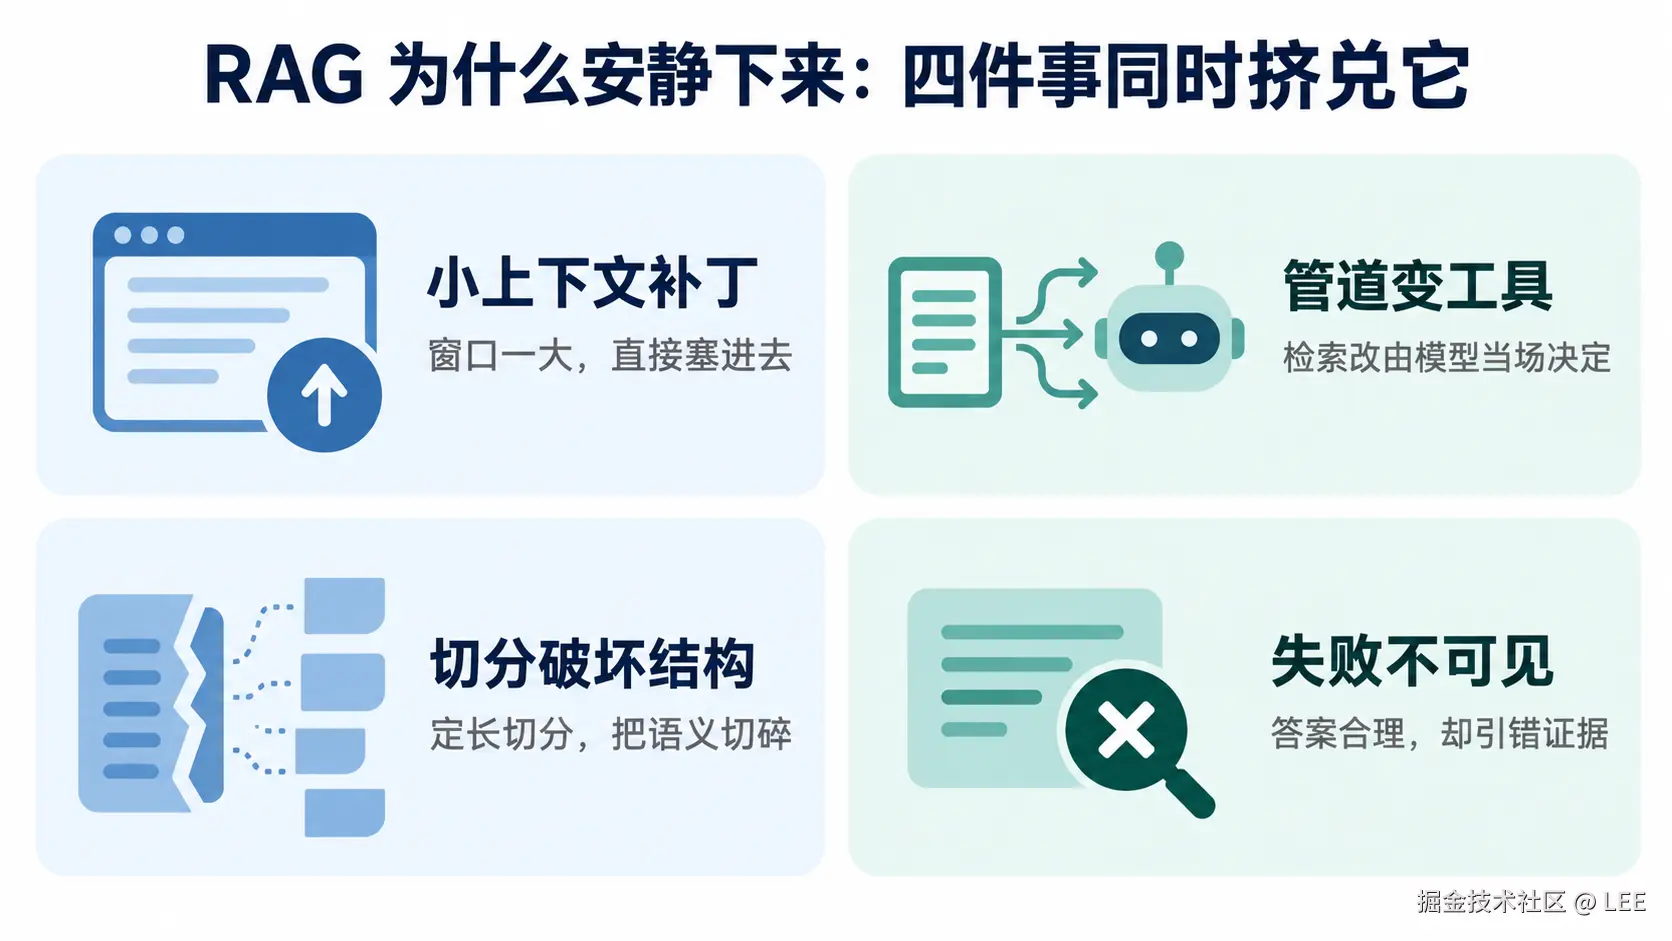 一,它本来是在给小上下文打补丁。 当上下文窗口涨到 20 万、100 万 token,加上 prompt caching 让长上下文变便宜,中等规模的语料,比如一个代码库、一套产品文档,直接塞进去,反而比检索更稳。检索不是不需要了,是"必须检索"的边界在往后缩。
二,检索从"管道阶段"变成了"模型选的工具"。 这是最关键的一条,因为它和前面三个时代的迁移是同构的。过去是人在架构图上画一个"检索节点";现在是模型自己决定搜什么、去哪儿搜、搜几次。Claude Code 不在你的代码库里跑向量检索------它 grep、它 glob、它读文件。检索从人写死的管道,变成了模型当场选用的能力。
三,切分本身就在破坏结构。 定长切分把一段函数、一张表、一个论证切得七零八落。语义相似不等于相关,而 embedding 恰恰不擅长精确匹配:标识符、错误码、函数名,这些工程任务里最要命的东西。你只好再叠上混合检索、重排、结构化切分,用一大堆机器去逼近 grep 天生就会的事。
四,RAG 的失败是不可见的。 它给你一个读起来很合理的答案,只是引错了证据,或者漏了那份关键文档,而没有一个便宜的办法让你知道它失败了。Agent 不一样,它可以回去读原文、重新搜、核对引用,当场修正自己。
 还有一个软性的原因: "RAG"变成了一个什么都往里装的桶。 后来它被拉长到指"任何把外部数据放进上下文的行为",而那基本就是"上下文"本身。一个词一旦指代一切,就不再指代任何东西。
需要把边界说清楚:消失的只是"RAG"这个架构名字,"检索"这项能力还在。 语料大到塞不进上下文(企业级知识库)、要求低延迟高并发的场景,检索依然是刚需,只是它变成了 Agent 的一个工具,常常是混合检索加重排。所以"RAG 已死"是句偷懒的话;准确的说法是"RAG 不再是那个要写在架构图顶端的词了"。
而把视角拉高,你会发现 RAG 的退场和 Coze 的退场根本是同一件事:一条人写死的管道,让位给了模型的临场决定。
往后看,会怎么走
下面说几个方向,变化已经比较清楚。
| 方向 | 变化 |
|---|---|
| Harness 朝两个方向拉开 | 能力轴变薄(规划、工具编排被模型吃掉),治理轴变厚(权限、沙箱、可观测、审计、成本控制)------所以更准的说法是"能力部分变薄,责任部分变厚" |
| 上下文工程成为手艺 | 从"怎么写提示词"转向"怎么设计上下文的生命周期":什么常驻(记忆、规则)、什么临时(会话)、何时压缩、压掉什么 |
| "多 Agent"去芜存菁 | 各自失效模式不同的那种(规划 / 检索 / 执行 / 审校各管一摊)在变多;五个 bot 凑一起聊天的,在退潮 |
| 接缝标准化 | 工具与模型(MCP)、上下文与仓库、权限与操作之间长出协议,让 Harness 可替换、可组合 |
| 瓶颈移到"能不能信" | 从"做对一次"到"稳定做对 + 错了看得出来",轨迹评估(看它怎么走的)成为刚需 |
 最深的一层:模型会再一次吃掉 Harness。 那 Harness 里不可被训练掉的残余是什么?
我的答案落在两个词上:环境和责任。 你可以把工具调用训进模型,但你没法把"这是谁的系统、里面什么是它能碰的、这么做是否安全"训进模型。模型是一个智能,而 Harness 长久的活,是充当这个智能与一个它并不拥有的世界之间的接口。
真实的历史,不是一条直线
把话说回来。这是一条被简化过的主线:三个阶段的更替,是重心的迁移,不是接力棒。真实演进是并存、反复的。今天依然有人用 Coze 做出有价值的东西,Dify 也在往 Harness 的方向长;LangGraph 在需要持久化和人工介入的生产场景里仍然好用。我说"框架时代"过去,指的是它不再是默认起点,而不是说它没有位置了。
长上下文也不是银弹。Liu et al. 的 "Lost in the Middle" 发现,塞得越满,模型对中间部分的利用反而越差,上下文里噪声堆得越多,推理质量越糟。所以"直接全塞进去"同样有边界------这条边界,恰恰是检索还有位置的地方。
所以这篇文章真正想说的,落在了那个一直在动的东西上:每当模型变强一点,就有一块原本由人代劳的决定,被还回给模型。 Coze 的画布、LangChain 的 chain、RAG 的检索管道,都是被还回去的那部分。
想清楚"下一块被还回去的是什么",比记住这三个时代有用。
参考
| 来源 | 本文用途 |
|---|---|
| The Bitter Lesson(Rich Sutton) | "通用方法胜过手工结构"的类比;文中已明确标注为类比,非定论 |
| LangGraph 文档 | 状态机、checkpoint、human-in-the-loop 的事实依据 |
| Model Context Protocol | 工具协议标准化的例证 |
| Lost in the Middle(Liu et al.) | 长上下文利用的位置偏差,用于"长上下文不是银弹"一节 |
| Pi:一个极简 coding agent(Mario Zechner) | 154 行 System Prompt / 4 工具的极简 Harness 样本 |
| Claude Code System Prompt 版本快照(Phistory) | 对照用的 System Prompt 行数与工具数口径(版本快照,非产品能力评分) |