先问一个做 RAG / 文档流水线的朋友大概率经历过的事:解析器在基准上表格分数 93、94,你信心满满接进生产------然后一份财务 PDF 里的跨页大表被拦腰截断,一份扫描合同里的无边框表格整列错位,用户投诉单就飘进了你的工单池。
这不是幻觉。浙江大学和上海人工智能实验室的新论文 TableParseMap / DEC(arXiv 2608.09842)把这件事量化了:MinerU2.5-Pro 和 PaddleOCR-VL-1.6 在 OmniDocBench v1.6 上表格 TEDS 分别高达 93.42 和 94.76(TEDS 是表格还原准确度,越接近 100 越好),可在他们收集的 916 张真实复杂表格上,最强的解析器只拿到 85.03。落差接近 10 分,这就是「榜单体验」和「生产体验」的距离。
想看原文?
- 📄 论文:arXiv 2608.09842
🔍 这篇论文到底想解决什么问题?
论文干了两件事:先体检 (表格解析到底差在哪),再开药(不重训能不能补上)。
体检的结论来自实打实的交叉审计------拿 MinerU2.5-Pro、PaddleOCR-VL-1.6、GLM-OCR、Qwen3.5-397B 四个模型跑真实表格数据,人工比对输出和原图,把反复出现的失败归成两大类。
- 输入侧(在哪翻车):5 类高危场景------隐式语义表、视觉证据退化、高度相似模式、不规则/罕见结构、大表;
- 输出侧(怎么翻车):9 类失败模式------文本类(字符、换行、公式、特殊符号)和结构类(遗漏、错位、冗余、重复输出、合并单元格错误)。
为什么会这样?作者归因出三个互补的根源:大表超出单次可靠处理的规模上限(输入分辨率、视觉 token 容量、输出长度三重限制);无边框、低质量扫描里的结构线索太弱,「看得见」但「读不准」;重建出来的 HTML 渲染后和原图对不上。而想靠「持续采数据重训」来修,对已部署或闭源的系统根本不可行------这就是药方要解决的问题。
🛠️ 它的思路是什么?
药方叫 DEC(Decompose--Enhance--Correct,分解-增强-纠正):解析器全程冻结,一个通用 VLM 当控制器,在推理时做三步干预。
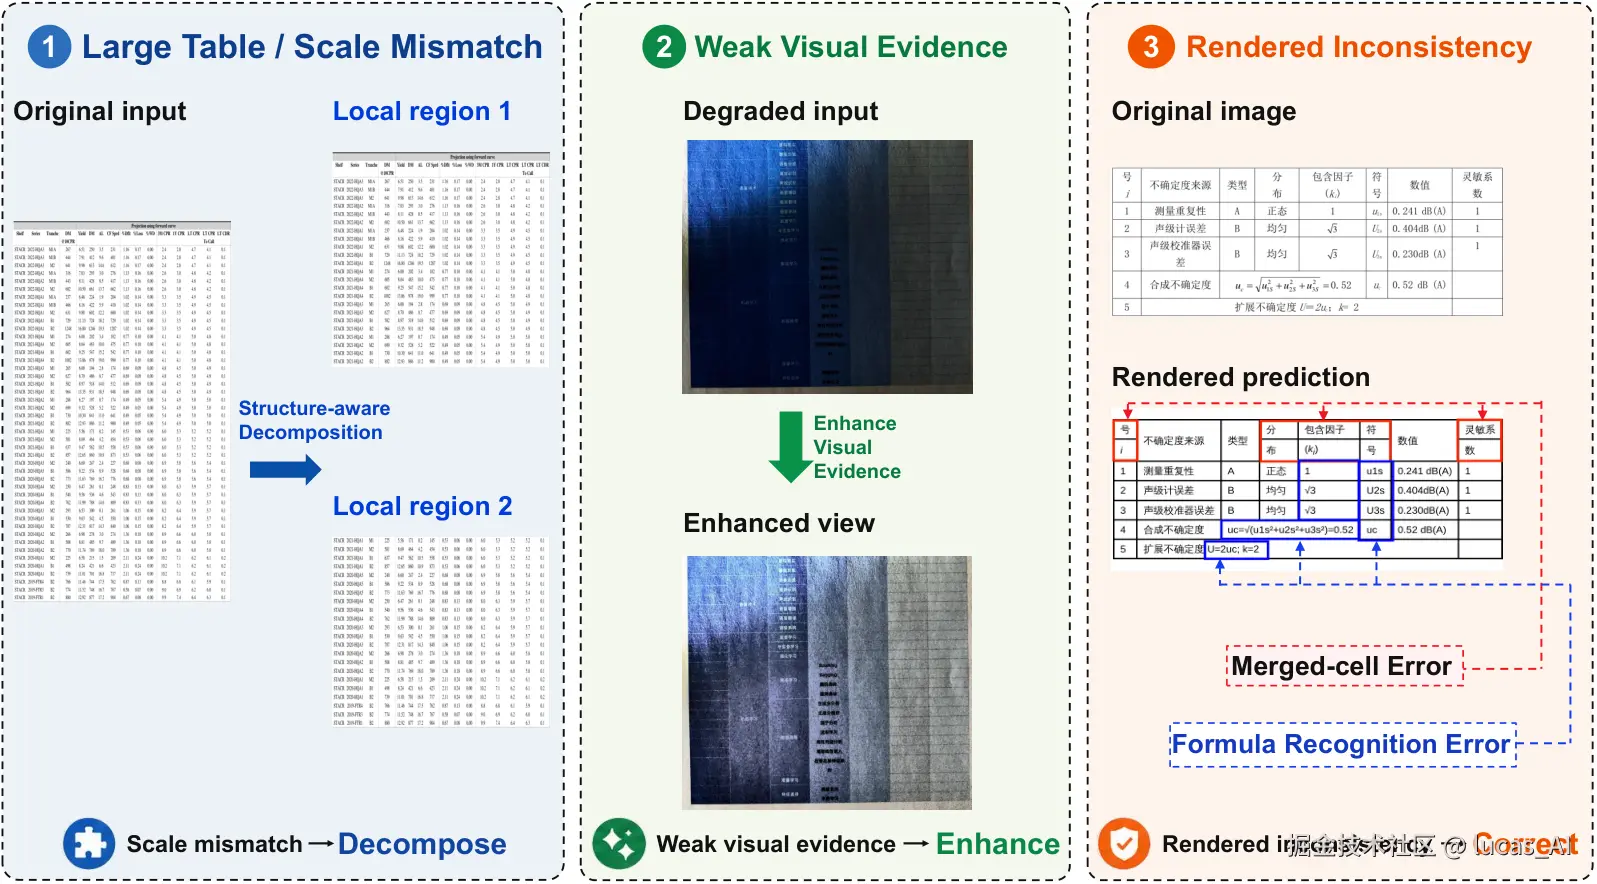 图说:三类失败各有一套对症动作------大表沿结构安全边界切块、弱证据用图像工具增强后重新解析、渲染不一致就对照原图修复。
- Decompose(切):对超大表格,智能体沿空白带和子表线索找「结构安全边界」切块,绝不切穿单元格或合并区域,每块单独解析;
- Enhance(增强):对「看得见读不准」的弱证据,用图像工具做区域精修、质量归一化、结构脚手架等变换,再让冻结解析器重新解析------注意工具只「暴露既有证据」,不添加任何文字、不直接改 HTML;
- Correct(修):对照原图、工作图、当前 HTML 和它的渲染四件套,先诊断哪里不一致,再生成修正版完整 HTML。
听起来很美好?问题来了:没有标准答案(ground truth)的情况下,凭什么判断「改了更好」? 这是全文最关键的设计。
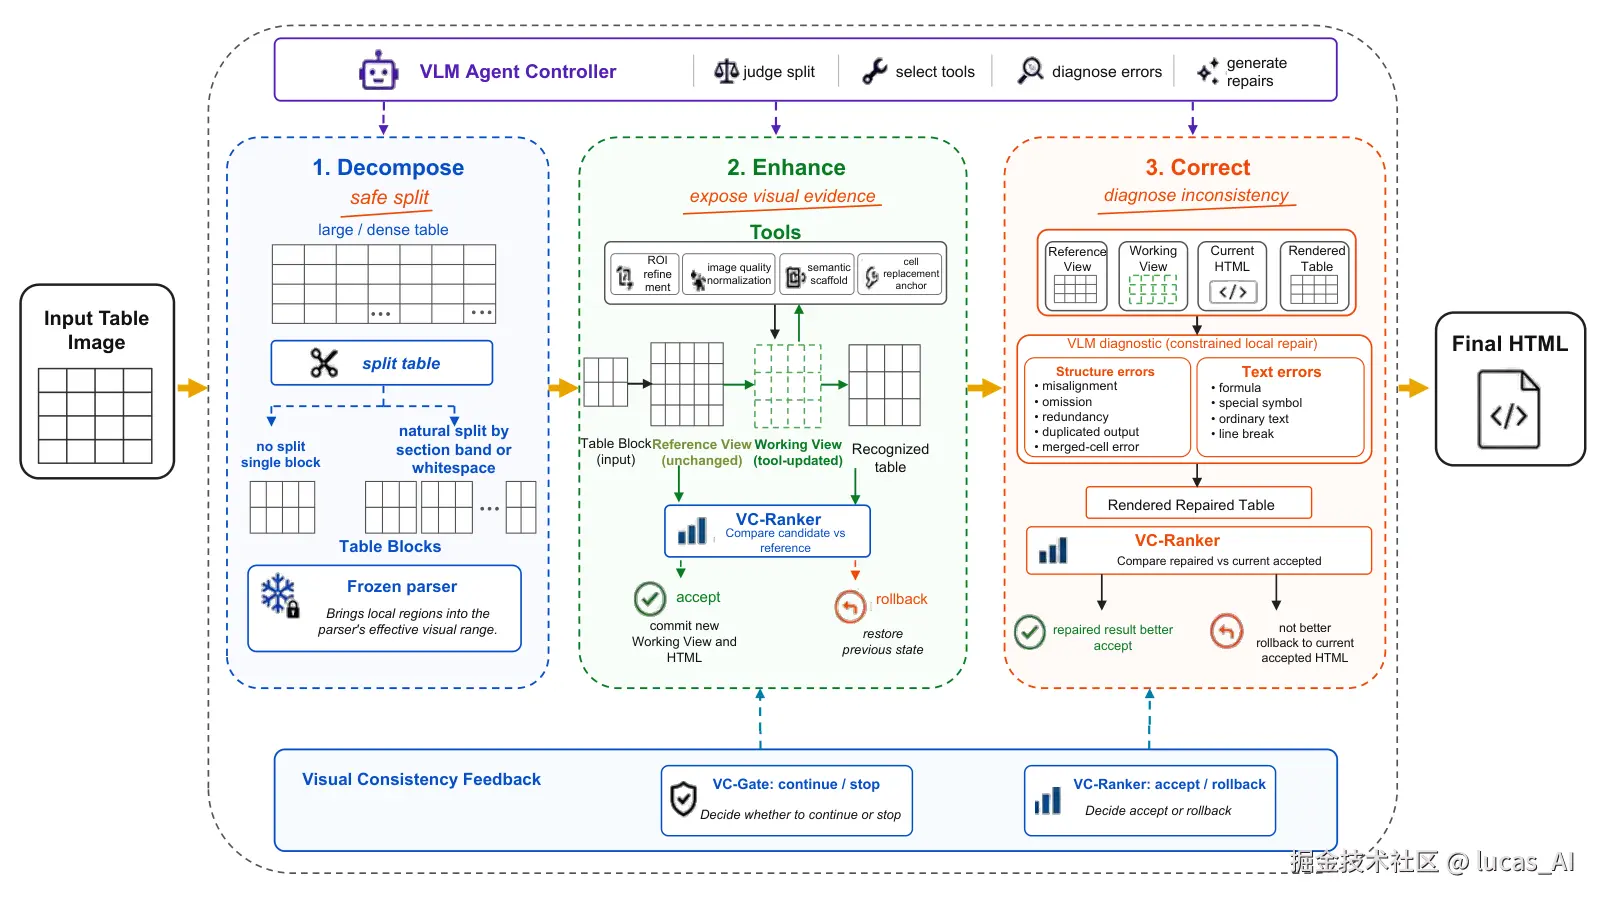 图说:解析器只当「识别执行器」,通用 VLM 当「控制器」;两个视觉一致性模型分管「要不要动手」(VC-Gate)和「改完是否更好」(VC-Ranker)。
答案是两个守门模型。VC-Gate 看着「原图 vs 渲染结果」决定要不要进入 DEC、增强后还要不要修正;VC-Ranker 给候选结果打视觉一致性分,只有新结果比旧结果高出 0.05 的余量才接受,否则回滚。消融实验证明这套闸门不是摆设:无条件接受所有智能体提议,最终 29.34% 的样本不升反降;换上 VC-Ranker 加回滚,回归率压到 12.65%。大表切块的结果最后还要经 OTSL 中间表示按空间位置拼接,拼完拿整图对照初版再验一遍,输了整体退回初版------敢动手,也敢收手。
还有一个经济性设计:VC-Gate 路由让 DEC 只对 43% 的输入触发,却保住 97.5% 的收益,额外解析器调用减少 47.3%。多数表格根本不需要折腾,闸门先把不需要的挡在门外。
📈 效果到底怎么样?
最亮眼的是大表:三个解析器全部提升约 5~6 个 TEDS 点------这正是 Decompose 的主场(虽然只触发了 9% 的样本,但那 9% 上平均 +3.2)。整体上:
- MinerU2.5-Pro +1.16、PaddleOCR-VL-1.6 +1.90、GLM-OCR +2.61(TableParseMap 总体);
- 三解析器在 1977 张跨模型困难集上平均 +1.57;换成 35B 的小控制器也有 +1.18,说明不依赖最大的模型;
- 结构类错误平均 +2.62,收益明显大于文本类。
对照组同样有信息量:直接让 Qwen3.5-397B 裸解析表格,成绩远差于专用解析器------「换个大模型」解决不了这个问题,得靠「专用解析器 + 智能体补给」的组合。
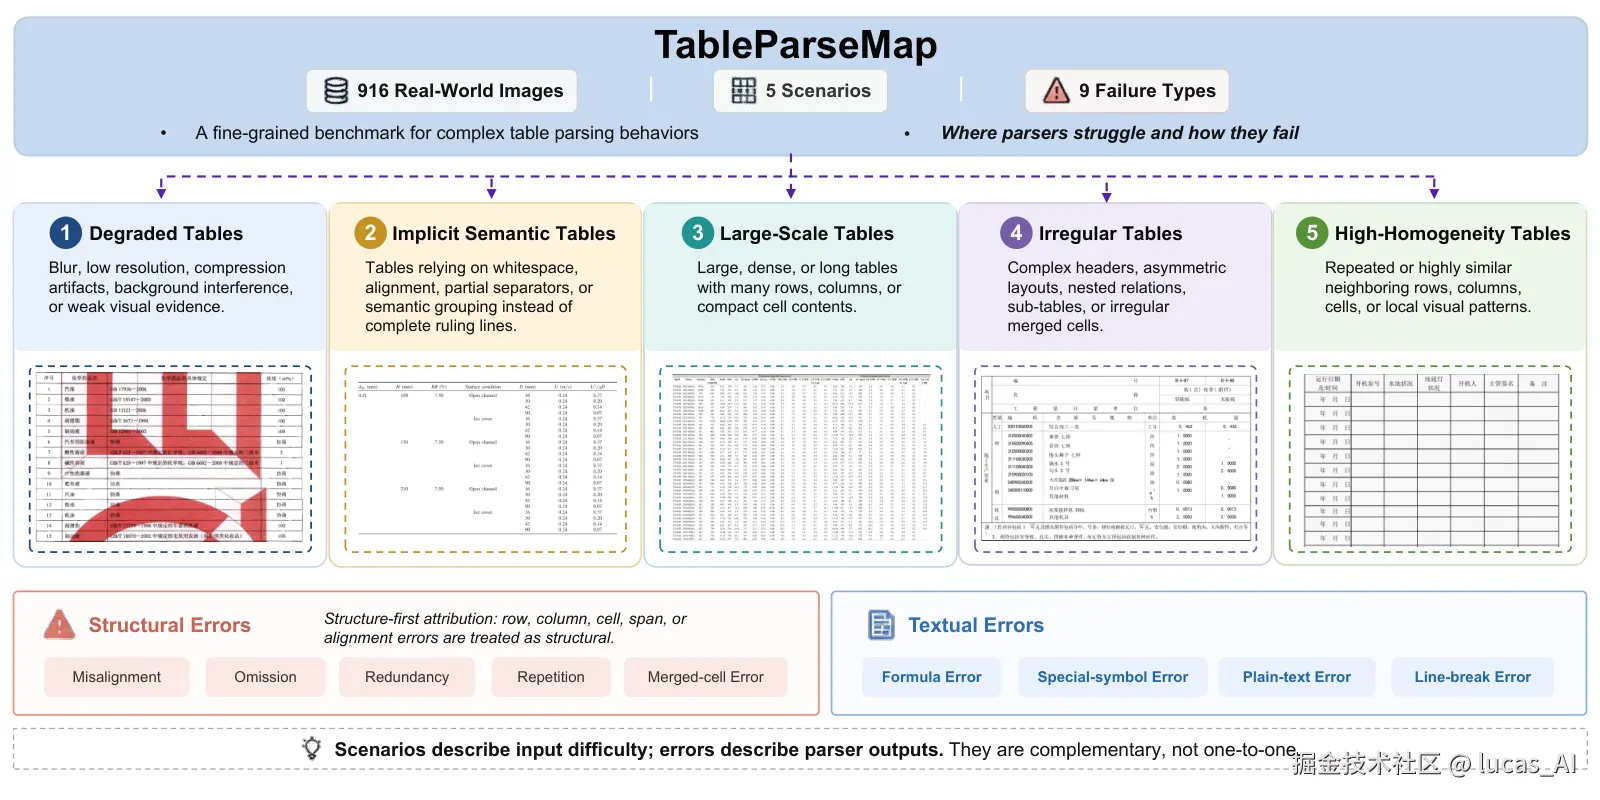 图说:这个基准本身也是论文的交付物------场景标签回答「什么样的表会翻车」,错误标签回答「翻车长什么样」,916 张表全部人工标注。
💡 为什么你要关心?
- 闭源/已部署系统的长尾修补有了标准姿势:不能重训、拿不到权重,照样能用「冻结模型 + 推理时受验证的智能体干预」把最难的那批表格救回来------这比「等下一版模型」主动得多;
- Gate + Ranker + 回滚三件套可移植:任何「输出可渲染对照」的结构化任务(版面、公式、甚至前端代码)都能套这个「干预要有闸门和退路」的模式,29.34% 的回归率数据就是最好的理由;
- 评测方法本身值得抄:与其迷信聚合分数,不如用「至少两个模型同时翻车」的交叉共识规则给自己的业务数据造一个 hard set,场景化分数进选型报告------这套方法对你的私有数据同样成立。
🤔 理性看待
几点冷静的提醒。平均增益 +1~2 分是「困难集」上的数字,代价是触发样本要跑 397B 级控制器加两轮推理决策------论文给了调用次数账,没给 token 成本和绝对时延账,采纳前要自己算。「免训练」只免了解析器:VC-Gate 和 VC-Ranker 本身是要专门训练的两个模型,换到财报、医学表等新领域能不能打是开放问题。另外 TableParseMap 既是基准又是困难集的来源之一,而修正环节用的失败分类学与基准同源------虽然在六个来源上都有增益可以部分对冲,但这层轻微的自我确认关系值得留意。基准与代码的开源情况论文中未见明确说明 (uncertain),想复用要跟踪作者仓库。