这篇 SIGIR 2026 的工作,试图解决一个很有意思的问题:推荐模型学到的是连续的用户偏好,而 LLM / Diffusion 接收的是离散 Token,那么能不能把"用户喜欢什么"直接变成 Token,喂给生成模型?
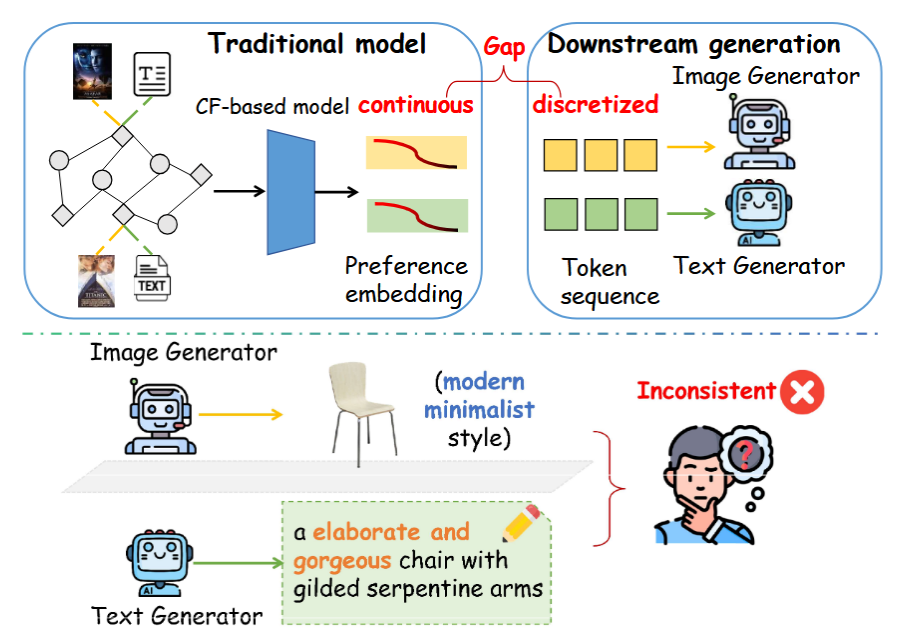
传统个性化生成的问题(传统方法不能准确学习用户偏好;用户偏好本身是多模态的,但生成结果容易出现图片/文本不一致。)
前言:DPPMG干的事:验证/解决一个问题:如何把"用户偏好"真正传给生成模型,并且同时生成个性化、跨模态一致的内容?
传统个性化生成主要有两个问题:①传统方法不能准确学习用户偏好;② 用户偏好本身是多模态的,但生成结果容易出现图片/文本不一致。
所以DPPMG:用推荐模型学习用户偏好 → 用 RQ-VAE 离散化成 Preference Tokens → 注入 LLM / Diffusion → 用 Personalized + Cross-modal Reward 优化。
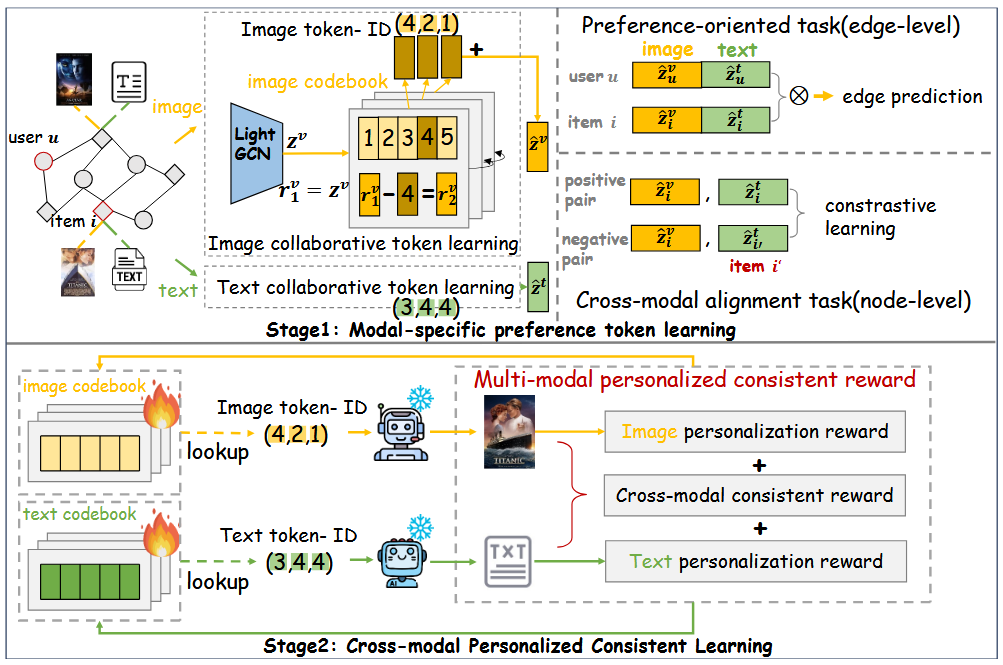
DPPMG概述。阶段1通过边缘级面向偏好和节点级跨模态对齐任务学习特定于模态的偏好令牌。阶段2将令牌注入下游模型,通过跨模态个性化一致性奖励进行优化。文本协作令牌学习遵循与图像分支相同的逻辑。为了简洁起见,仅显示令牌ID,省略生成器指令。
💡创新1:Modal-specific Preference Token Learning(模态特定的离散用户偏好 Token)
**核心思想:**不要直接把用户的连续 embedding 塞给 LLM / Diffusion。而是:先用推荐模型学习用户偏好 → 再用 RQ-VAE 把连续偏好离散化 → 得到 Preference Tokens → 再交给生成模型。
📌好处:解决了一个非常关键的:Continuous Preference → Discrete Token的鸿沟。
让推荐模型学到的用户偏好embedding,变成生成模型可以使用的Preference Token ID,同时保留协同过滤和跨模态信息。
因为推荐模型通常得到:user preference → zᵤ ∈ R^d也就是一个连续向量。但是生成模型天然处理的是:token ID →embedding →LLM / Diffusion,所以 DPPMG 做了一个非常关键的"接口":
     推荐模型
Continuous Preference
        ↓
      RQ-VAE
        ↓
Discrete Preference Token
        ↓
     生成模型
论文明确把 RQ-VAE 定义为解决 continuous-discrete mismatch 的组件。
🏃♀️做法
① 分别建立 Text / Image 两套 Preference Model
用户的交互本身就是多模态的。例如电影:用户→电影A(包括简介和海报),所以论文没有简单把所有信息混成一个 embedding,而是分别构建:
Text Interaction Graph     Image Interaction Graph
        ↓                            ↓
    LightGCN                     LightGCN
        ↓                            ↓
       zᵗᵤ(用户的Text Preference)    zᵛᵤ(用户的Visual Preference)
同样物品也会得到zᵗᵢ、zᵛᵢ。论文中明确使用两个 modality-specific graph,并分别通过 LightGCN 得到用户/物品表示。
② 用 RQ-VAE 把连续 embedding 变成离散 Token
例如:
zᵤ
 ↓
RQ-VAE
 ↓
(c₁, c₂, c₃, c₄)(hierarchical discrete tokens)
每一个C都不是普通embedding,而是一个codebook中的离散索引。比如论文默认L=4,K=96,也就是用户→Token1、Token2、Token3、Token4,每个Token从96个code中选择一个,因此理论上的组合空间达到96⁴ = 84934656,而不是只有96种用户偏好。c₁到c₄一次比一次拥有更细的粒度(后一层专门负责补前一层没有表达好的 residual。)。论文后面的分析也验证了这个 hierarchical structure:高层 Token 更多表达 broad attributes,低层 Token 表达 fine-grained details。
③ 再设计两个监督:不只是"量化",还要保证 Token 真的是 Preference
这里是 DPPMG 很重要的一点。如果只是:LightGCN→RQ-VAE→Token,那么RQ-VAE 只是在压缩 embedding。并不能保证这个Token真的是"用户喜欢什么"。所以作者额外设计了两个监督。
a.Preference-oriented Task:BPR(要求score(用户u,正样本i) > score(用户u,负样本i'),保证Token 不能只是"压缩得像",还必须保留用户-物品交互中的偏好信息。)
b.Cross-modal Alignment Task:保证图片和文字对同一个 item 的语义是对应的。例如:
电影 i:

text representation          电影 i 的 text
       ↕                           ↕
image representation        电影 i' 的 image

        正样本                    负样本
所以第一阶段最终干的事:LightGCN负责从用户-物品交互中学习偏好,RQ-VAE负责把连续偏好变成离散 Token,BPR保证 Token 保留协同过滤偏好,Cross-modal Contrastive Learning 保证不同模态之间保持语义对应。最终得到:
用户 u
 ├── Pᵗᵤ = (cᵗ,1, cᵗ,2, cᵗ,3, cᵗ,4)(Text Preference Tokens)
 └── Pᵛᵤ = (cᵛ,1, cᵛ,2, cᵛ,3, cᵛ,4)(Visual Preference Tokens)

物品 i
 ├── Pᵗᵢ(Text Semantic Tokens)
 └── Pᵛᵢ(Visual Semantic Tokens)
💡创新2:Preference Token → Generator(把"用户偏好"变成生成模型能够使用的条件)
第一阶段解决:
怎么学到用户偏好?
第二阶段解决:
学到之后怎么真正让生成模型利用它?
这也是 DPPMG 非常关键的一步。
📌好处:
让已经训练好的:LLaMA3和 Stable Diffusion能够直接利用用户 Preference,而且不需要重新训练整个大模型。
🏃♀️做法:
①Image Generation
传统方法:               DPPMG:
Prompt                           User Visual Token
↓                                        +
CLIP Text Encoder                Item Visual Token
↓                                        ↓
Stable Diffusion                Placeholder U* / I*
↓                                        ↓
Image                            Codebook Lookup
                                         ↓
                                 CLIP Text Encoder
                                         ↓
                                 Stable Diffusion(❌ 冻结)
                                         ↓
                                Personalized Image
也就是:Token ID → Codebook Lookup → Embedding → CLIP Text Encoder → Diffusion
②Text Generation
文字生成逻辑类似,
User Text Token
        +
Item Text Token
        +
System Prompt
        ↓
     LLaMA3(❌ 冻结)
        ↓
Personalized Text
论文把:Pᵗᵤ 、Pᵗᵢ通过 textual codebook lookup 转换成 embedding,然后和 system prompt 一起送进 LLM。
💡创新3:Multimodal Consistent & Personalized Reward(个性化 + 跨模态一致性联合优化)
📌好处:
解决了一个非常典型的 trade-off:只优化 Personalization,而DPPMG实现了Personalization ↑ + Cross-modal Consistency ↑,所以最终目标是:既像用户喜欢的东西,又让生成的多模态内容彼此对应。
解决问题:
单纯追求个性化:
图片/文本可能符合用户喜好,但彼此不一致。
单纯追求跨模态一致:
图片和文本虽然匹配,但不一定符合用户喜好。
🏃♀️做法:
这是第二阶段里面真正解决"图片和文字可能不一致"的关键。前面得到:
User Preference Token
        ↓
┌──────────────┐
↓              ↓
Image          Text
Generator      Generator
↓              ↓
Vg             Tg
问题来了:
图片可能很符合用户喜欢的风格,但是文字说的是另一个东西。
或者:
图片和文字很匹配,但是根本不像这个用户喜欢的内容。
所以作者设计两个 Reward。
① Personalization Reward(和用户历史图片 V₁,V₂,...,Vₙ 分别做 CLIP similarity再平均得到Rᵛₚ,文字同理:将生成Text和用户历史文本送入CLIP similarity得到Text Personalization Reward)
② Cross-modal Consistency Reward(将上面两个Generated Image Vg和Generated Text Tg计算:Rcrs = CLIPSim(Vg,Tg),也就是生成图片和生成文字必须相互匹配。)
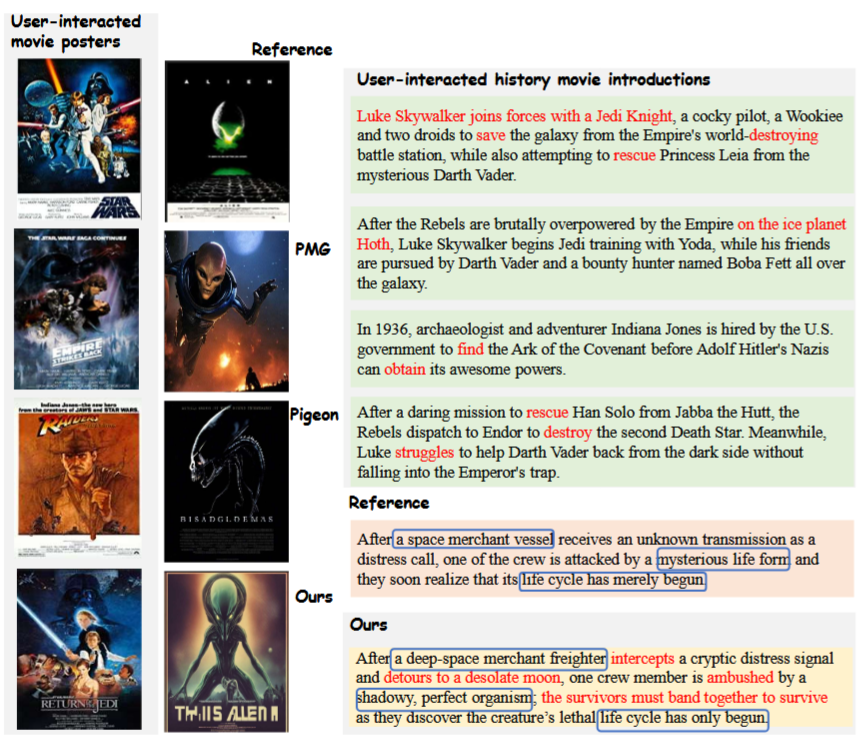
一个为电影生成图像和文本的例子。
🔬实验验证
① Preference Token 有效
加入 Preference Token 后个性化指标提升
→ 证明 Token 确实编码了用户偏好。
② Multimodal 有效
去掉另一模态后,个性化性能下降
→ 用户偏好确实具有多模态特征。
③ RQ-VAE 的 hierarchical Token 有意义
共享 Token prefix 越长:User / Item similarity ↑
→ 离散 Token 具有层级语义结构,并能够解释 collaborative filtering effect。
④ Reward 各司其职
Preference Token
    → Personalization ↑

Unimodal Reward
    → Personalization ↑

Cross-modal Reward
    → Consistency ↑

两者联合
    → Personalization + Consistency
⑤ 效果
DPPMG 在个性化图像/文本生成的大多数指标上优于对比方法;人工评测中,参与者也更偏好 DPPMG 的个性化结果及跨模态一致性。
| DPPMG | GenRank / HSTU方向 | |
|---|---|---|
| 输入 | 多模态用户-物品交互 | 用户行为序列 |
| 偏好建模 | LightGCN | HSTU |
| 表示 | 连续 preference embedding | sequential representation |
| 离散化 | RQ-VAE | Semantic ID 等 |
| Token 表达什么 | 用户偏好 | 物品/行为序列信息 |
| 生成什么 | 图片 + 文本 | Item / 推荐结果 |
| 核心问题 | preference → generation | sequence → generation |
| 共同思想 | 推荐表示 → 离散 Token → 生成模型 |
补充:DPPMG 的 Preference Token ≠ Semantic ID。
DPPMG 的 Token 主要回答:
"这个用户喜欢什么?"
Semantic ID 主要回答:
"这个 item 是什么?"