直播间要用一段 AI 视频,生成任务应该在什么时候发生?
设计同学提前做一段礼物特效,可以挑选结果、调整画面,再交付使用。观众送出礼物后,才根据主播当下的画面生成故事,等待就进入了这次互动。再往前走,如果整个节目都由 AI 持续生成,观众还能影响后续剧情,业务侧就需要同时组织内容、接收音视频和处理新指令。
在花椒这轮 H3 Max 调研中,我们测试了设计素材生成和主播截图生成礼物,也梳理了持续生成节目的接入构想。
这些场景给出的一个判断是:先确定内容什么时候必须生成,再选择接入方式。生成速度会影响体验,但三个场景里的等待位置、交付内容和成本口径各不相同。
一、提前生成:把等待留在素材制作环节
先看一个直接的需求:设计同学已经有图片和提示词,希望把它们制作成可用的礼物视频。
这次我们沿用设计提供的输入,生成了麒麟变装、银发法师、月下情侣三组视频,每组分别测试 480P、768P 和 1080P。
| 素材 | 视频长度 | 480P 处理耗时 | 768P 处理耗时 | 1080P 处理耗时 |
|---|---|---|---|---|
| 麒麟变装 | 6 秒 | 约 9 秒 | 约 12 秒 | 约 16 秒 |
| 银发法师 | 6 秒 | 约 7 秒 | 约 10 秒 | 约 13 秒 |
| 月下情侣 | 14 秒 | 约 9 秒 | 约 22 秒 | 约 26 秒 |
这组计时从任务接收后开始,到结果返回结束,不含图片提交阶段。数据来自 2026 年 9 月的本地测试,各格为对应样本记录。
三组 1080P 样本获得了设计侧认可,生成结果可以直接查看:麒麟变装、银发法师、月下情侣。
如果把这种方式接进素材制作流程,可以在生成后检查人物、动作、清晰度与视频规格,通过后再交付给展示端。生成不满意,也有机会在交付前调整。
以月下情侣为例,1080P 样本约 26 秒返回。这段等待发生在制作阶段,观众使用成品时不必再次等待模型生成。对这个场景,值得比较的是:多花一些制作时间,能否换来符合展示要求的画面,以及最终交付一份可用素材需要多少工作量。
它适合主题和主要内容已经确定、成品能够复用的场景。如果视频必须包含某次互动才会出现的信息,生成就需要移到后面。
二、按次生成:让主播成为这次礼物的主角
我们做的音乐盒 Demo,正好属于后一种需求。
输入是一张主播截图和一份提示词,输出是一段 15 秒的故事:主播在房间打开音乐盒,盒内出现带有她外观特征的人偶,画面切到宫殿里的真人形象,最后回到房间合上音乐盒。
提示词的精简内容如下:
保留人物的黑长发、银色发卡和白色碎花裙。先用稳定特写展示音乐盒里的瓷质人偶,再直接切到宫殿中的真人形象,最后回到房间。优先保证人物清晰、比例自然,减少复杂动作,不使用人物变形转场;全片 15 秒,配轻柔音乐盒旋律。
展示样本中,开盒、展示人偶、进入宫殿等动作由 AI 生成,主播无需实际完成这些表演。观看音乐盒 Demo:15 秒、480P
这种方式保留了模板里的故事框架,把人物外观留给当次输入。如果目标是呈现主播当下的样子,业务侧就要在互动发生后取得画面,再提交生成要求。
我们梳理的接入方案,是把生成视频送入现有礼物展示链路:视频准备好后排队、分发,在礼物层覆盖播放;真人直播继续运行,礼物结束后恢复显示当前直播画面。
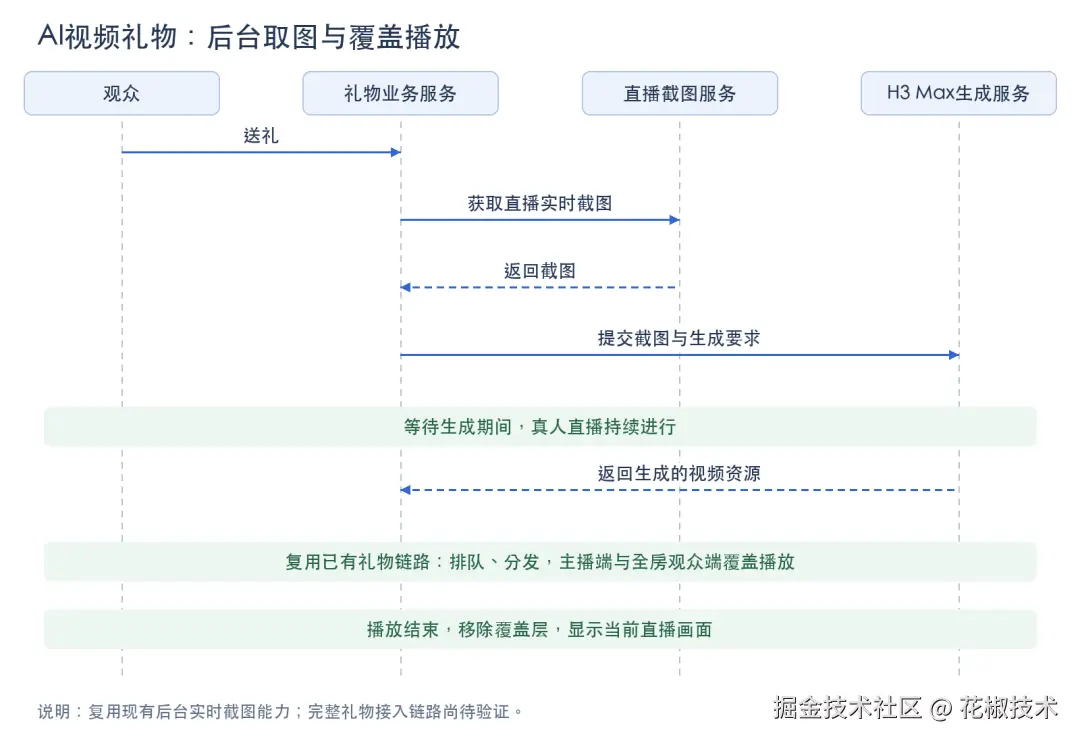
图中需要关注的是生成任务与播放队列的位置。两处等待都可能影响观众什么时候看到结果。本地测试先用截图代替实时取帧,记录到的时间如下:
| 本地样本 | 提交至结果返回 | 提交至首次可播放 |
|---|---|---|
| 海边礼物,5 秒、480P | 约 8 秒 | 约 9.7 秒 |
| 海边礼物,10 秒、480P | 约 9 秒 | 约 10.8 秒 |
| 音乐盒清晰人偶版,15 秒、480P | 约 12 秒 | 未测 |
这一组从本地提交开始计时,与上一节"任务接收后"的起点不同。海边两条记录还测了首次可播放时间:结果返回后,仍要再等一段时间,才能看到视频。
接入真实互动时,可以用四个时刻定位等待:观众触发、生成请求提交、视频结果返回、观众端首帧播放。它们分别对应取帧与准备、生成调用,以及结果返回后的排队、分发和播放准备。
这也解释了为什么音乐盒"约 12 秒返回",还不能直接变成"送出礼物后约 12 秒播放"。交互设计需要让观众知道任务已被接受、结果仍在准备;视频轮到播放时,也要判断它是否还与当前直播情境相关。
采用按次生成,需要同时接受两项代价:观众要等待当次内容,业务也会随生成任务增加而持续付出模型费用。它换来的价值,是让视频包含这次互动才有的人物或内容信息。
三、持续生成:交付一场节目,需要维持一个会话
音乐盒故事播完,一次生成任务就结束了。持续生成节目的需求则是:当前内容还在播放,后续内容继续生成,观众的输入还可以改变接下来的走向。
我们调研时体验过 Infinite Slop。提交"延续白猫场景,保留红围巾和蓝色桌子,加入绿色纸杯"的要求后,被采用的画面中出现了白猫、红围巾和绿色杯子。这个体验把观众输入与后续画面联系了起来。
要支持这种交互,生成端需要保留前后文,并在运行中接收新要求。H3 Max Director 采用持续会话:通过 WebRTC 返回音视频,通过数据通道接收控制消息;前面的图生视频接口则返回完成的视频文件。Director 官方说明
由此,业务侧接收的对象也发生了变化:按次礼物接收一份结果文件;持续节目需要维持会话、接收音视频,并把观众参与形成的内容要求送回生成端。
下面的逻辑时序图展示了这组协作关系,省略了连接建立和媒体分发细节。
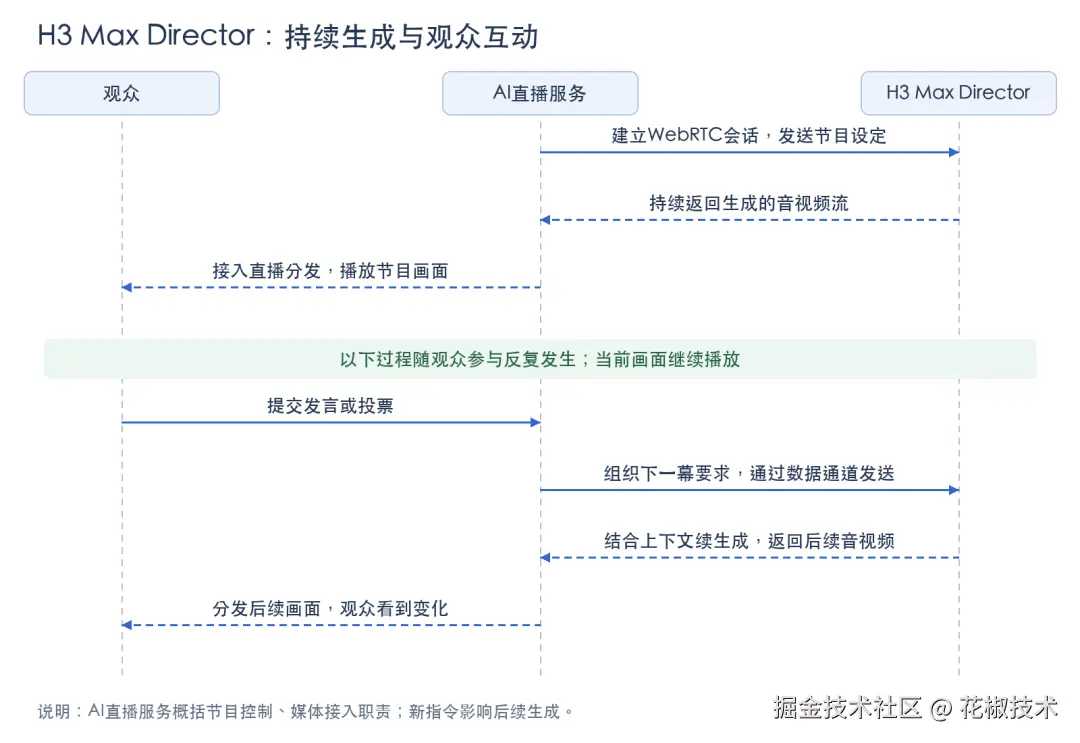
这里还有一个会影响交互设计的细节:新指令从哪一段生效。
Director 的提示更新默认使用重规划方式,新方向作用于下一个尚未派发给生成器的片段;也可以选择把新方向排到已经规划的片段之后。因此,提交指令、生成相应内容、观众看到变化,是不同的时间点。Director API:提示更新
业务侧需要分别观察两件事:播放有没有连续,观众采用的指令多久后体现在画面里。前者关系到观看是否被打断,后者关系到观众能否感受到参与。
节目组织也要有自己的处理方式。自由提议需要决定采用哪些想法;投票则先给出候选方向,再把结果交给生成端。人物设定、故事推进和观众选择怎样协调,都需要在节目中设计。
对花椒而言,目前梳理的是利用 Director 生成节目,再通过现有直播系统提供观看与互动的方案。持续音视频的接收、推流与观众输入处理,尚未完成实际搭建。
四、放在一起,怎样选择接入方式
三种方式可以用在同一个业务里,但各自接入的位置不同。
| 判断项 | 提前生成素材 | 按次生成礼物 | 持续生成节目 |
|---|---|---|---|
| 内容何时确定 | 制作阶段已确定主要内容 | 触发后补入当次人物或互动信息 | 随节目推进不断更新 |
| 生成端交付什么 | 完整视频文件 | 完整视频文件 | 会话中的音视频流 |
| 主要等待发生在哪 | 制作与交付前 | 触发到开始展示之间 | 启动播放、片段接续和指令响应过程中 |
| 接入工作集中在哪 | 制作、检查与素材交付 | 取帧、任务状态、排队与礼物播放 | 会话、内容组织与直播分发 |
| 优先看什么结果 | 可用素材的质量与交付效率 | 个性化效果与完整等待体验 | 连续观看与互动响应体验 |
成本也应按各自的使用方式评估。提前生成,可以把制作一份可用素材的投入放到后续复用中考虑;按次生成,需要看每次互动消耗多少生成任务,以及重试后得到一条可用视频的成本;持续生成,则需要按生成时长和同时运行的节目路数评估。Director 的模型费用按生成视频的秒数计费,实际预算还要计入会话最低计费等条件,以及媒体处理与分发费用。Director 计费说明
选择时,可以先回答两个问题:
- 这段内容必须用到互动发生后才有的信息吗?如果主要内容提前就能确定,先放在素材制作阶段完成;确实需要当次信息,再考虑按次生成。
- 观众需要持续改变同一场节目的走向吗?如果需要,就要进一步评估持续会话、内容接续和节目组织。
依照这次测试与调研,我们对已有直播间更倾向于先选择一个按次生成礼物的场景。音乐盒 Demo 已经提供了具体的输入、输出和生成耗时,适合围绕一次完整互动评估接入;设计素材则可以沿制作流程单独推进。持续节目需要先明确节目本身要提供什么观看价值。
目前能确认的是本地生成样本与设计侧的样本评价,真实直播间的完整等待、批量效果稳定性和用户参与情况还没有验证。本文的选择依据来自这些样本和接入方式分析;不同样本的提示词、画面与规格存在差异,不能据此推算统一速度或线上效果。