一套能稳定运行的插件化体系,不仅仅靠一套能替换的插件系统,更重要的是一个不动的真相源。DeepSeek Harness 用仅追加的 Session 事件日志,把可插拔建立在可重建之上。
最近在 DSH 上写一个工具,我要算 TTFT 和吞吐量。但是查看轨迹页面时发现,界面上首token时间不可用。
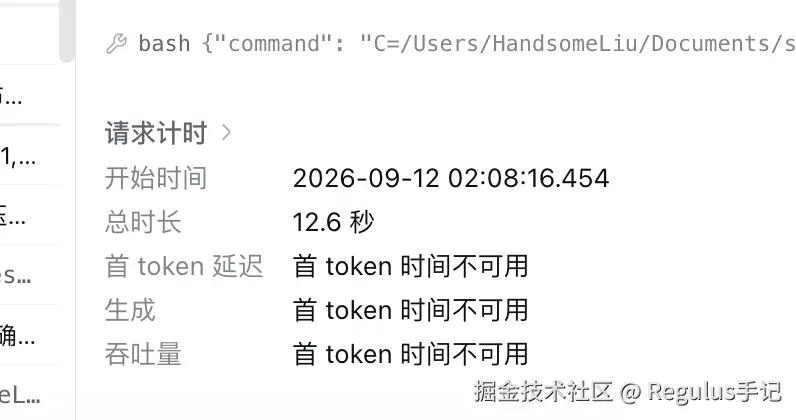
拉日志
第一反应是:这个数据是不是压根没记?那就把日志拉下来看。
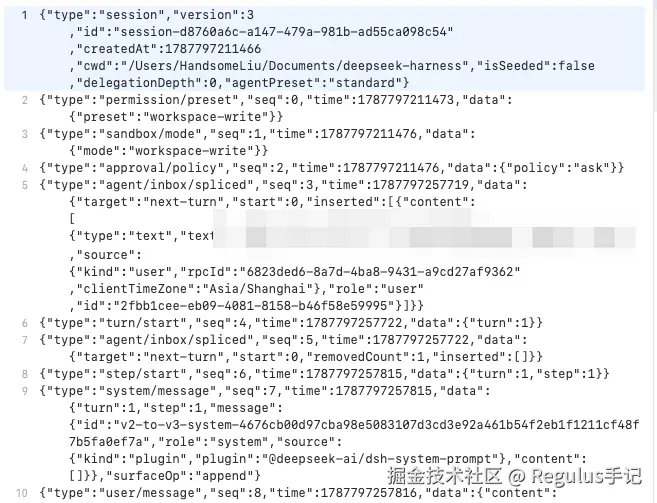
日志是 JSONL,一行一个事件,带 seq / time / type / data。我要的东西在 assistant/message 事件的 data.stream 里。
但它不是我预期的那种「一行一个 token」的裸增量,而是压缩批:
json
{"type": "reasoning-chunks", "time0": 1787797260198, "index": 0,
 "dt": [147, 49, 1, 0, 0, ...],
"texts": ["The", " user", " wants", " me", ...]}texts是逐 token 的文本dt是每个 token 相对上一个的时间增量time0是这一批的基准时间
写了个脚本,发现数据都在
按 time0 逐项累加 dt[i-1],就能还原出每个 token 的绝对时间;首个非空文本或推理成员的时间,就是首 token 时间。
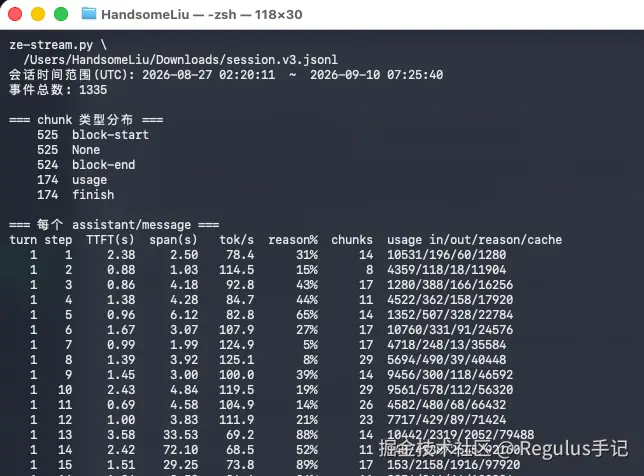
跑完之后,得到一份真实会话的账单:
- 175 个请求 ,TTFT 平均 3.47s(最小 0.69s,最大 17.86s)
- 总生成 2795.2s ,输出 307,128 token ,平均吞吐 109.9 tok/s
- 其中 207,949 token 是推理 ,占 68%
信息全都在日志里。 并不需要额外采集。
而且我注意到,推理占了输出的三分之二,这和我当前会话的思考深度有关。
但同一个界面里,有的能算,有的不能
数据既然在,那问题就变成了:谁没用上它。
继续往下看,轨迹面板的首 token 时间来自一个状态字段 firstTokenTime,而它唯一的赋值点 是处理实时增量块时的判断------只有块类型是 text-delta / reasoning-delta / tool-call-delta 时才会被设置:
ts
// /packages/client/ui-trajectory/src/client/trajectory-assistant-definition.ts
...isTokenDelta(chunk) && state.firstTokenTime === undefined
  ? { firstTokenTime: time }
  : {}
而它消费的 chunk 来自客户端合成的 assistant/live-chunk 事件------这个事件只在流式进行中存在 。会话结算之后,往 firstTokenTime 赋值的那条实时路径断了。
这会导致现象:直播的时候正常,历史会看就是undefind。
我找了个对照组:
| 消费者 | 是否解码压缩批 | TTFT |
|---|---|---|
dsh-session-stats |
✅ 调 assistantStreamFirstTokenTime |
正常 |
dsh-client-connection |
✅ 本地 expandAssistantStream |
正常 |
dsh-client-ui-trajectory |
❌ 只认裸 delta | 不可用 |
同一份日志,有的reader解码了,有的没解码。
我在Discussions看了下,之前的问题已经有人在讨论,分析也透彻,感兴趣的可以看下#6129,这篇不重复那些答案。
而且我翻阅了源码note,发现这是一次处于性能优化导致的缺口,那么为什么一次为性能做的优化,能让一个能力静默消失?
仓库里有一份 2026-09-06 的 Agent Note:Embedded Assistant stream consumers read compact records。它解释了这次改动的动机。
所有折叠嵌入流的消费者都先调 expandAssistantStream()(这是个会把整个压缩批完整物化成成员数组)。可消费者常常只需要小量数据(找首 token、找最后一个 usage、拼一段文本),却付出了 O(members) 的分配和时间:每个成员大约多两个对象。
改后的收益很可观:
| 阶段 | 改前 | 改后 |
|---|---|---|
| 首次打开 · 投影 | 28.0 ms | 5.9 ms |
| 首次打开 · 总计 | 76.9 ms | 53.8 ms |
| 首次打开 · 峰值内存 | 137.2 MB | 94.6 MB |
dsh-llm 直接支持从压缩记录回答问题,并造了一批提前退出 的记录级读取器------runFirstTokenTime、assistantStreamFirstTokenTime、lastAssistantStreamChunk 等等。只取一个事实,不展开整个数组。
同一份 note 里还有一句记录:
Chat and Trajectory sections settled directly from it.
也就是说,Chat 和 Trajectory 改成直接从嵌入流结算,不再先物化后折叠。
所以首token时间的数据源没了,这也是为什么新版本出现了这个问题。
我翻了提交记录,commit 84c11c7243 有对测试的改动。
它把轨迹面板的一个断言,从「期望有值」改成了「期望为空」:
diff
scss
- expect(finalNode?.timing?.firstTokenTime).toBe(1_999)
+   timing: { firstTokenTime: null },
同时新增了一个用例,名字里写了:
sql
uses live Assistant deltas without replaying settled embedded streams这意味着:
- 行为变化是有意的,「不重放已结算的流」是这次提交的目标,这是有实质收益。
- 空值被编码成了期望,测试不再报警。至于产品上显示「不可用」是未被识别的副作用,还是被接受的取舍,单看 diff 推不出来。
这才是这类问题最难被发现的地方:当测试跟着实现一起改,测试用例不能保证用户可见的结果。
最后,落到 DSH 的设计思路
这不是一次孤立的疏忽,而是一套设计取向的必然副产品。
第一,解码被定义成「读者的责任」。 Agent Note Session format v2 里写着:
Ordinary Session restoration validates the settlement fields needed by the runtime without expanding every historical stream; consumers that expand a compact stream validate its records when they read it.
这条设计的合理性很明显:如果恢复会话时展开所有历史流,成本会随会话长度线性增长;而绝大多数时候,打开一个会话根本用不到每一段流。所以「谁要读,谁自己解码」是省资源的选择。
第二,时间信息原本有一个更持久的归属,但被推迟了。 2026-08-04 那份(现已归档的)Note Web turn and window latency/throughput metrics 里,有一个被推迟的方案:
A durable session projection (token-meter shape) ... would survive compaction and window paging and cover the whole log. Deferred, not rejected.
一个持久化投影,能让时序活得比加载窗口久、覆盖整条日志。它被推迟了,理由是投影状态必须保持 O(1)------存均值,而不是分位数。
于是现在的时序,完全挂在节点上的 firstTokenTime 上。而节点,是实时路径的产物。
第三,规则被集中了,谁必须调用这些规则,仍然没人强制。之前依赖的部分没有被完全收束。 同一份 09-06 的 note 里还有这句:
The token, visibility, and visible-text rules have one home in
dsh-llm, so a record reader and the accumulator's packing rules cannot drift apart.
「打包规则」和「读取规则」被放进了同一个归属,这防止了它们互相漂移。
DSH 的设计
我能说的是这个架构层面的观察:
可插拔建立在可重建之上。但「可重建」不是一个保证,是一条纪律。
它由每一个消费者各自履行,而没有任何机制强制。当一次优化让某个消费者不再履行,必然会出现副作用,但这套纪律正是保证这套插件系统稳定运行的基础。
这不是 DSH 独有的问题。任何把「状态从日志推出来」当基础的体系,都会长成这个样子:能力分散在每个消费者手里,而它们的义务已经写在文档里,需要自己遵守。
就这一次缺口而言,结算时补一次回退解码就够------#6129 已经给出了修法。但它修的是「这个读者忘了履行纪律」。若要让时序指标活得比加载窗口久、不跟着某个 UI 折叠一起漂移,归属还得回到那份被推迟的持久化投影。
这次的遇到的bug,本身也是这个理念一次侧面证明。
排查时顺着 Agent Note 往下读,很像在和开发团队隔空对话:动机、取舍、推迟项都写在仓库里,谁都能看见。这种「取舍可被后来者读懂」的体验,大概就是我喜欢 DSH 的原因。