最近,我在跟着 Google 的 《Comprehensive Rust》 课程学 Rust。
虽然,我自认为我的 Rust 已经入门了,但是这门优秀的语言,确实值得我们深入学习,所以我比较喜欢看各路教程,来弥补我对与 Rust 的理解。
学基础的时候,我注意到两条看起来很简单的命令:
bash
cargo run以及:
bash
cargo run --release我知道,加上 --release,程序通常会跑得更快。
但这里的 release 到底是什么意思?Rust 究竟做了什么不同的处理?
于是,我写了个小实验。结果,原本要执行十亿次的循环,直接没了......
Debug 和 Release 构建
用下面的命令运行 Rust 项目时:
bash
cargo runCargo 会输出类似这样的信息:
text
Finished `dev` profile [unoptimized + debuginfo]
Running `target/debug/exercise`
其中有两个值得留意的词:
text
unoptimized + debuginfo也就是"未优化"和"包含调试信息"。默认情况下,cargo run 使用的是 Cargo 的开发构建配置(dev profile)。
开发时,我们通常更关心编译够不够快、调试信息好不好用。毕竟,写代码的过程往往就是反复走这一圈:
text
write code → compile → run → find a bug → modify code → compile again写代码、编译、运行、发现 bug、修改,再编译。如果每次构建都花很多时间做深度优化,反而会拖慢开发节奏。
换成这条命令:
bash
cargo run --release输出就变了:
text
Finished `release` profile [optimized]
Running `target/release/exercise`
这次 Cargo 使用的是 release 构建配置,编译器会更积极地做优化。
两者的区别可以这样理解:cargo run 使用 dev 配置,把编译后的程序放在 target/debug/ 下。它基本不做优化,通常编译更快,但程序运行得慢一些。
cargo run --release 则使用 release 配置,把可执行文件放在 target/release/ 下。编译器会投入更多精力优化,编译可能更久,但生成的程序通常跑得更快。
到这里都挺好理解。于是,我想测一下:到底能快多少?
做十亿次加法
我写了一个简单的程序,把 0 到 999,999,999 的整数加起来:
rust
use std::time::Instant;
fn main() {
    let start = Instant::now();
    let mut sum: u64 = 0;
    for i in 0..1_000_000_000 {
        sum = sum.wrapping_add(i);
    }
    println!("sum = {sum}");
    println!("time = {:?}", start.elapsed());
}
这里的 wrapping_add 会在整数加法溢出时按回绕规则处理。
不过,这个例子的结果没有超出范围,所以用普通加法也可以。
先运行:
bash
cargo run得到的结果是:
text
sum = 499999999500000000
time = 4.3996875s
大约 4.4 秒。
再试一下:
bash
cargo run --release结果变成了:
text
sum = 499999999500000000
time = 84.875µs
What,4.4 秒和 85 微秒?差了大约 50000 倍!
Rust 是很快,但开个编译优化,总不能让同样的十亿次加法突然快上 50000 倍吧。这里应该还有别的原因。
编译器不一定照着你的代码执行
看到这段代码:
rust
for i in 0..1_000_000_000 {
    sum = sum.wrapping_add(i);
}
我们很自然地会想,计算机应该在做这些事:
text
sum += 0
sum += 1
sum += 2
sum += 3
...
sum += 999999999
也就是老老实实循环十亿次。
但我们写下的源代码,和 CPU 最终执行的机器码,并不是一回事。Rust 源代码还要经过编译器这一层:
text
Rust source code
        ↓
     Compiler
        ↓
Optimized machine code
        ↓
       CPU
源代码经过编译器,生成优化后的机器码,再交给 CPU 执行。只要程序对外可观察的行为仍然正确,优化器就可以改写具体实现。
比如:
rust
let x = 10 * 20;这行代码不代表 CPU 必须在运行时做一次乘法。编译器完全可以生成相当于下面这行的代码:
rust
let x = 200;前面那个十亿次循环,也是类似的情况,只不过优化的幅度大得多。
看汇编
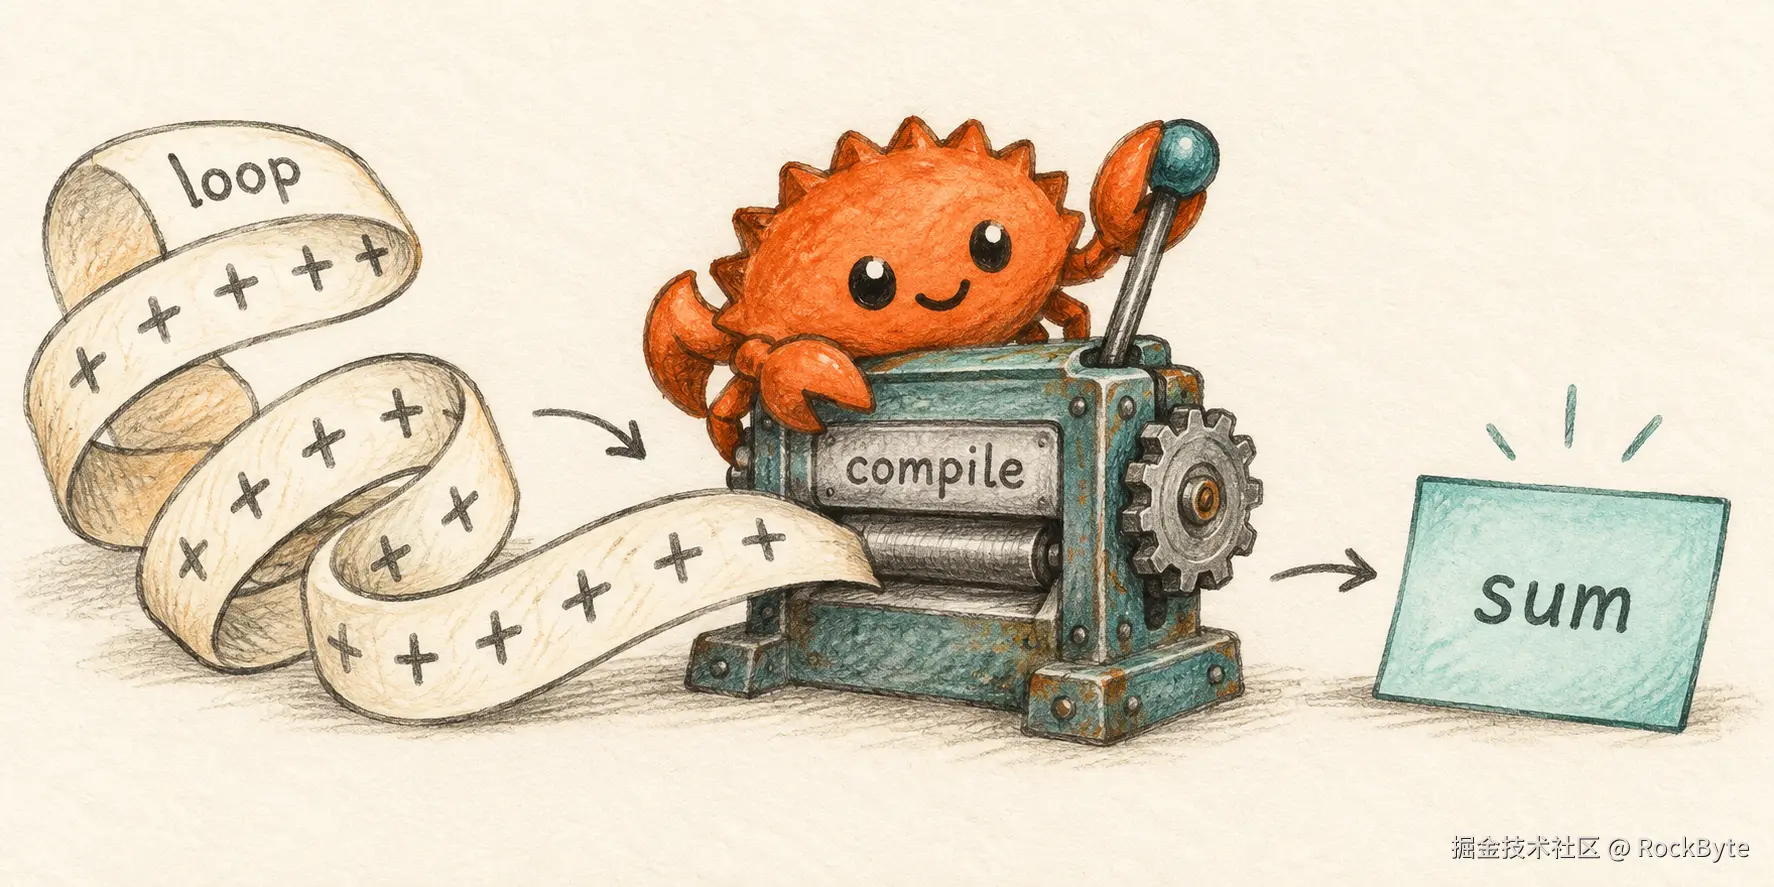
具体发生了什么,可以直接看汇编。让 Rust 生成汇编代码:
bash
cargo rustc --release -- --emit asm在我的 Apple Silicon Mac 上,这条命令会在下面的目录生成 ARM64 汇编文件:
text
target/release/deps/找到 Rust main 函数对应的汇编后,我看到了这几行:
asm
mov     x8, #39680
movk    x8, #46564, lsl #16
movk    x8, #23385, lsl #32
movk    x8, #1776, lsl #48
str     x8, [sp, #8]
循环呢?这里没有看到明显的循环结构,也没有通常反复执行循环时会出现的这套操作:
text
add
compare
branch back
也就是加法、比较,再跳回去继续执行。
也就是说,编译器做的,是把一个 64 位常量拼进 x8 寄存器。这四部分对应:
text
39680
+ (46564 << 16)
+ (23385 << 32)
+ (1776 << 48)
算出来是多少?
text
499999999500000000正好就是程序打印的那个结果。
也就是说,编译器实际上把这段代码:
rust
let mut sum: u64 = 0;
for i in 0..1_000_000_000 {
    sum = sum.wrapping_add(i);
}
变成了概念上类似这样的代码:
rust
let sum: u64 = 499_999_999_500_000_000;十亿次循环被整个消掉了。release 版本根本没去做那十亿次加法,自然也就谈不上把同样的加法执行得快了多少。
让编译器真的去做这些计算
这也是写小型性能实验时容易碰到的问题:如果一段计算的结果能提前确定,或者可以提前简化,优化器就可能把我们原本想测的计算消掉。
Rust 提供了 std::hint::black_box,可以用来应对这种情况。我把实验改了一下:
rust
use std::hint::black_box;
use std::time::Instant;
fn main() {
    let start = Instant::now();
    let n = black_box(1_000_000_000_u64);
    let mut sum = 0_u64;
    for i in 0..n {
        sum = black_box(sum.wrapping_add(i));
    }
    println!("sum = {sum}");
    println!("time = {:?}", start.elapsed());
}
可以粗略地把 black_box 理解为告诉优化器:
别对这个值做太多假设,这里的计算是有用的。
当然,它不是一个神奇的"关闭优化"开关。但它可以阻止某些优化,避免小型基准测试里想测的计算被优化掉,导致测试失去意义。
再跑一次,开发构建的结果是:
text
sum = 499999999500000000
time = 4.642401292s
release 构建的结果是:
text
sum = 499999999500000000
time = 1.788744209s
也就是:
text
dev       ≈ 4.64 s
release   ≈ 1.79 s
release 构建仍然快了大约 2.6 倍,但和之前的 50000 倍已经是两回事了。
这次,我们更接近在比较优化前后代码的执行性能。
而上一次的结果,更多体现的是优化器把测试中的计算直接消掉的能力。
构建配置到底是什么
做到这里,debug 和 release 的区别就比较清楚了:它们对应 Cargo 为不同场景准备的构建配置(build profile),每套配置包含一组编译器设置,并不是两个不同版本的 Rust。
我们接触的就是下面这两套:
text
dev profile
    │
    ├── cargo build
    ├── cargo run
    └── target/debug/
release profile
    │
    ├── cargo build --release
    ├── cargo run --release
    └── target/release/
这些配置可以在 Cargo.toml 中设置,例如:
toml
[profile.dev]
opt-level = 0
[profile.release]
opt-level = 3
opt-level 控制编译器的优化级别。开发配置更看重开发过程是否方便、顺畅;release 配置则会花更多精力,让生成的程序运行得更快。
所以,debug 不代表:
text
a version of the program that contains bugs也就是"还有 bug 的程序版本"。release 也不代表:
text
the version after all bugs have been fixed也就是"所有 bug 都修好了的版本"。它们只是用途不同的两组构建设置。